把一项来自 Cell、Nature 或 Science 等论文的神经科学分析交给 AI,只提供数据与任务要求,不展示来源论文、参考图和标准结论,它能在多大程度上复现关键结果,并给出有依据的生物学解释?
神经活动与行为如何关联,脑区之间如何协同,分子特征又如何随发育变化——这些问题使用的数据和方法各不相同,却都要求从数据、分析到结论形成一条完整的证据链。
在科研分析中,统计对象选错、关键对照缺失,或者结论没有足够的数据支持,都可能让一份看似完整的结果失去科学依据。真正需要评价的,不是智能体有没有“完成任务”,而是它给出的分析能否经得起核验。
围绕这一问题,上海人工智能实验室联合中国科学院脑科学与智能技术卓越创新中心等单位构建了面向多模态神经科学数据分析的智能体评测基准 BrainArena。
该基准在论文《SeekBrain: An Autonomous Multi-Agent System for Accelerating Neuroscience Discovery》中提出,用于评估智能体独立完成端到端神经科学数据分析的能力。
这场“神经科学会考”从 10 篇真实研究中整理出 32 项分析任务,覆盖五种常用模式生物。每项任务都配有专家撰写的分析要求和评分标准,从方法正确性、图形复现度和解释有效性三个维度检验结果,让一次分析中的方法偏差、图形失真和解释错误能够被具体识别。
论文在相同任务设置下比较了三套系统:SeekBrain(Claude Opus 4.7)、Claude Code(Claude Opus 4.7)和 Codex(GPT-5.5)。
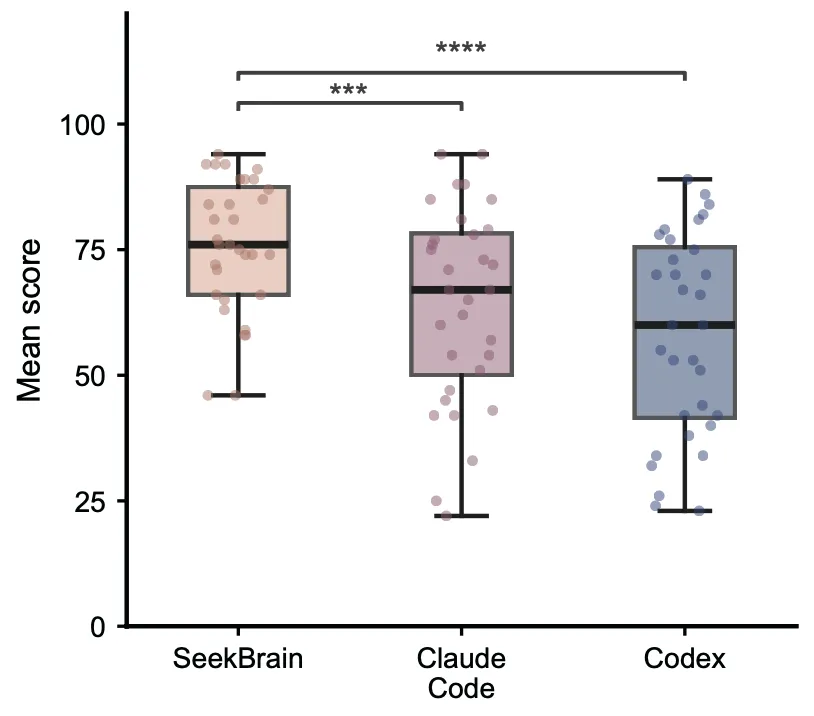
三者的平均得分分别为 75.8、64.1 和 58.1 分。结果显示,任务难度和科学解释是区分系统分析能力的关键因素,也将科研智能体的能力评价落实到一个具体问题:
它能否把数据、方法与生物学解释连接成一项科学上有效的分析?
https://arxiv.org/abs/2607.29347
https://ai4neurolab.github.io/SeekBrain-page/
https://agent-compass.mintlify.app/zh/user_guide/modules/benchmarks/brainarena
https://hub.opencompass.org.cn/dataset-detail/BrainArena
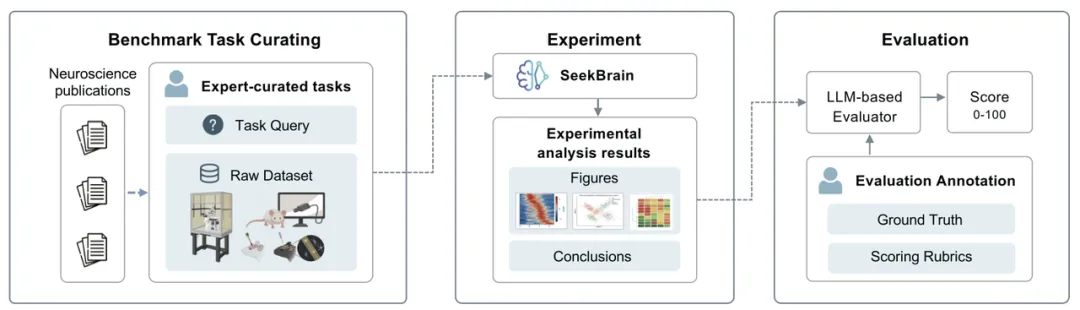
BrainArena 选取公开了数据、且关键图对应的分析能够复现的神经科学研究作为任务来源。基准共收录 10 篇研究中的 32 个任务,每个任务对应原研究的一幅关键图或图中的具体面板。
围绕这些研究结果,领域专家撰写分析任务描述,明确输入数据、总体目标与所需输出,并标注数据路径、参考图和标准科学结论。专家随后对照来源研究检查任务说明,制定对应的评分标准。
以斑马鱼结构连接网络可视化为例,任务要求智能体从单侧连接矩阵构建双侧矩阵,将左右脑区的质心与矩阵索引对应起来,按要求排除特定脑区,再把连接网络叠加到脑图谱的俯视和侧视投影上。矩阵处理、空间变换与结果解释,共同构成这道题的分析要求。
按论文报告的实验设置,被测系统获得相同的任务描述和数据路径,来源论文身份、参考图及标准科学结论对被测系统保密。
由此,原研究中的一幅图被转化为一项可执行、可检查的科学分析任务:智能体需要从给定数据出发,完成分析,并提交能够接受核验的结果。
图 1|BrainArena 的任务构建与评测流程。研究团队从神经科学研究中整理分析任务,由专家制定任务描述、参考结果与评分标准,再对智能体提交的分析产物进行评价。
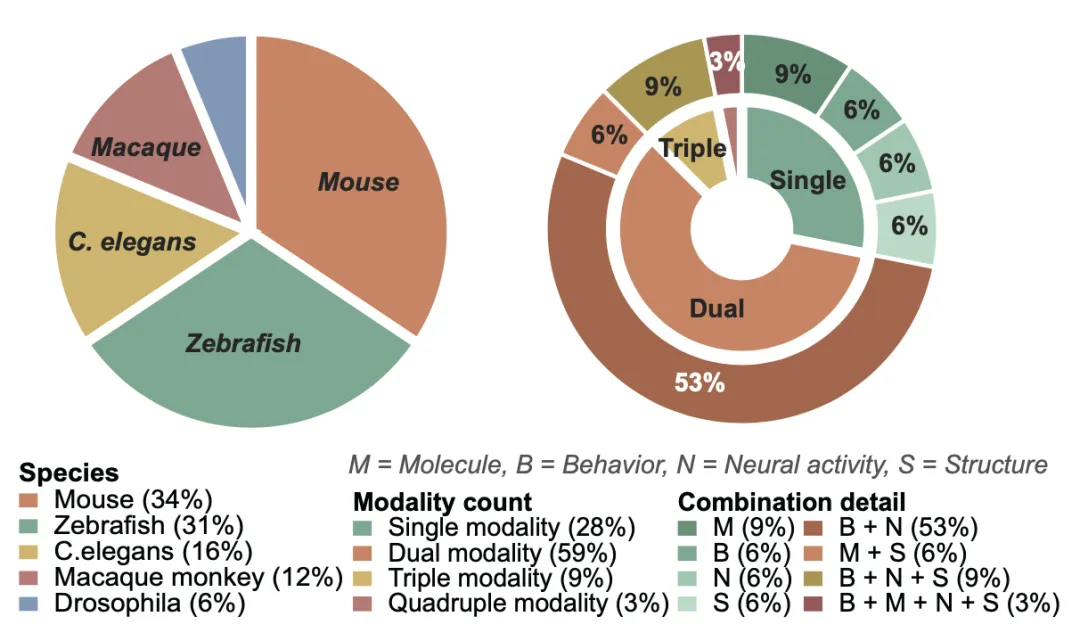
BrainArena 覆盖秀丽隐杆线虫、果蝇、斑马鱼、小鼠和猕猴五种常用模式生物,数据涉及神经活动、行为、结构与解剖、分子遗传四类模态。
多模态任务占 72%,神经活动与行为数据的联合分析是多模态任务中最常见的组合。 这要求智能体把神经信号与动物的行为状态、实验条件及其他测量结果联系起来。
在分析类型上,基准覆盖七个方向:
神经响应表征:刻画神经元的响应时间尺度、放电模式与方向调谐特征。
神经解码:从神经活动中解码行为或任务变量,例如时间偏移下的行为信息、决策中的先验信息。
群体表征分析:分析神经群体的低维嵌入、活动轨迹与刺激响应结构。
计算建模:开展贝叶斯模型比较,或拟合潜在动力学模型并比较预测表现。
统计分析:比较实验条件、分析学习曲线,以及检验神经与行为指标之间的关系。
脑网络与解剖映射:估计功能连接、绘制结构网络、识别网络社群,并将结果映射到脑区空间。
分子与发育分析:识别分子亚型、追踪发育轨迹,并开展差异表达分析。
例如,一项线虫任务要检验:当前的神经活动,能否反映几十秒前的运动速度?
智能体需要联合分析神经活动和运动记录,用此刻的神经信号还原此前的运动速度,观察这种预测能力能向过去延伸多久。
这里有一个容易忽略的问题:如果线虫一直爬得差不多快,仅凭现在的速度,也可能猜中它刚才的速度。因此,任务还要求智能体比较“使用神经活动”和“只使用当前速度”的预测结果,并加入打乱神经活动与行为对应关系的对照。
神经信号究竟提供了多少额外信息,需要通过这些比较来判断。 对照选择是否恰当,直接影响最终结论是否可信。
根据任务复杂度,BrainArena 将 32 项任务划分为 12 个简单任务和 20 个困难任务。
这种难度差别也存在于同一类数据中:同样使用神经活动与行为记录,按条件计算平均响应,与训练模型、检验它能否还原过去的行为,所需完成的分析就有明显不同。
图 2|BrainArena 的物种与模态覆盖。任务涉及五种常用模式生物,多数任务整合一种以上的数据模态,其中神经活动与行为的联合分析最为常见。
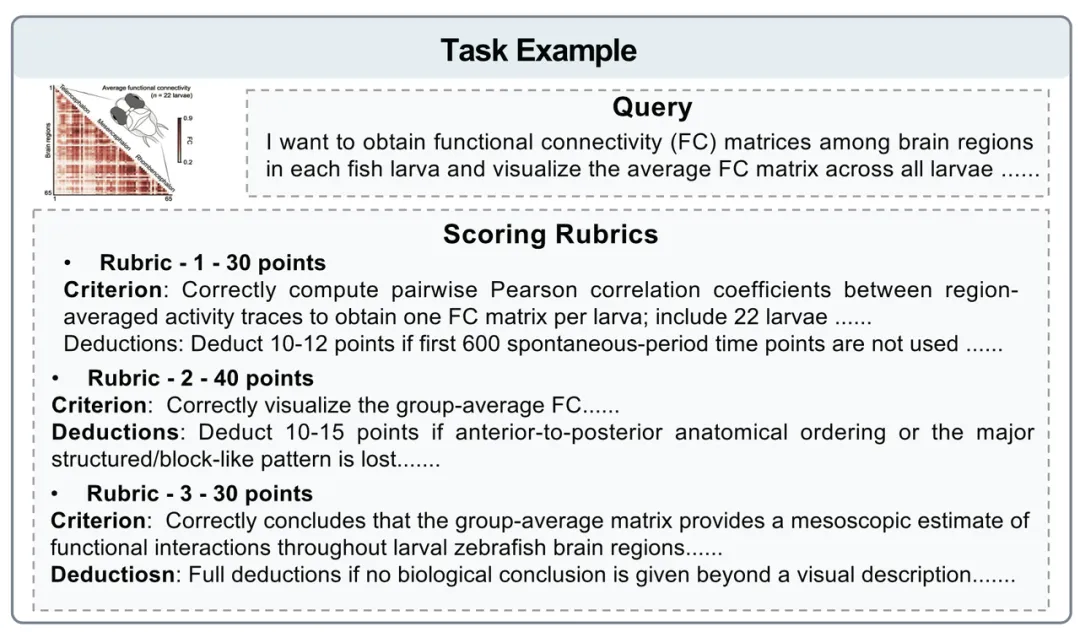
每个 BrainArena 任务配有 3—5 个评分项目,满分为 100 分。全部 32 个任务的标准包含 700 多个科学标准,将能够观察到的具体错误对应到明确的扣分规则。评分围绕三个维度展开:
方法正确性:检查分析步骤是否与原研究相符。数据处理、模型构建和统计检验,都需要满足任务对应的方法要求。
图形复现度:检查生成图形的核心模式是否与参考结果一致。这里关注的是图形承载的科学信息:空间位置是否正确,变化趋势是否恢复,关键比较是否清晰。具体标准也列出可接受的差异,例如结构网络任务允许配色、节点样式或版面细节不同,前提是解剖对齐和连接权重模式得到正确呈现。
解释有效性:检查分析结果是否得到科学上有效的解释。智能体需要说明结果的生物学含义,并保持结论与证据之间的边界。
以斑马鱼功能连接任务为例,智能体要用一张图展示不同脑区的活动关联有多强。这道题中,图形占 40 分,方法和解释各占 30 分。脑区是否按要求排列、颜色是否正确表示关联强弱,都属于图形评分的内容。
方法评分则检查计算过程:先计算每条鱼的脑区活动相关性,再对这些结果取平均。如果把所有鱼的记录混在一起计算,就会在这一项失分。
解释评分关注的是这些关联意味着什么。两个脑区的活动经常同步变化,说明它们存在功能关联。但这还不能证明它们之间有直接的神经连接,也不能证明一个脑区的变化导致了另一个脑区的变化。即使图画得正确,结论超出了数据能够支持的范围,也会被扣分。
评测时,Claude Opus 4.6依据专家制定的标准,结合参考图,对智能体提交的代码、图形和结论逐项评分。报告中的分析过程与科学解释,都需要有相应的代码和结果支持。
图 3|BrainArena 单项任务中的三层评分结构。以功能连接矩阵任务为例,评分同时检查矩阵图形与模式、相关矩阵的构建方法,以及功能相互作用的科学含义。
论文在 BrainArena 上比较了 SeekBrain、Claude Code 和 Codex 三个智能体系统。其中,SeekBrain 和 Claude Code 均基于 Claude Opus 4.7,Codex 基于 GPT-5.5。
| |
SeekBrain (Claude Opus 4.7) | |
Claude Code (Claude Opus 4.7) | |
| |
上表为 32 个任务的平均得分。三套系统的总体表现存在显著差异(Friedman 检验,P < 0.0001)。这组结果说明,在相同任务和评分要求下,不同智能体完成神经科学分析的能力仍有明显差别。
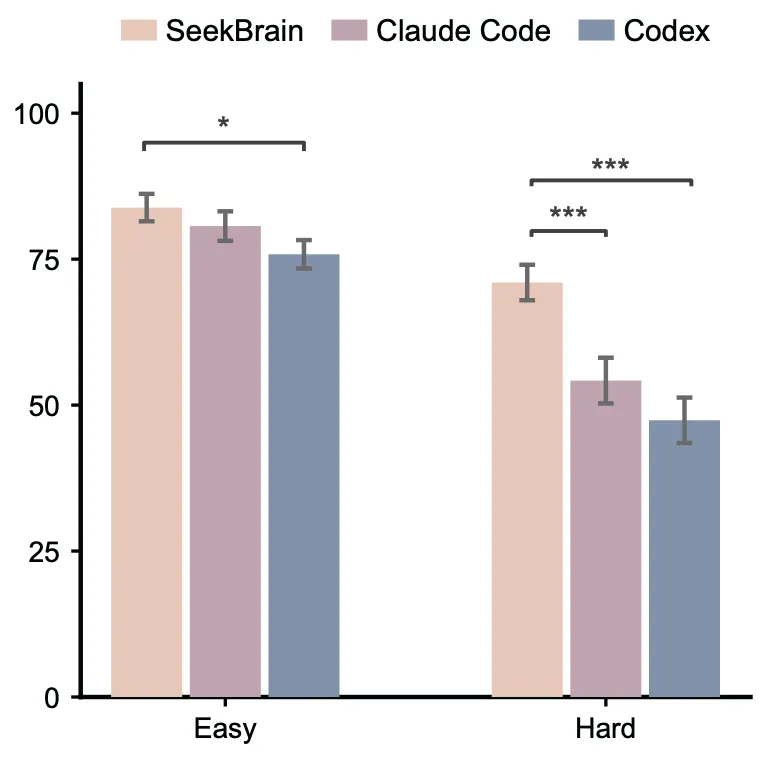
从 12 个简单任务到 20 个困难任务,三套系统均出现得分下降。以各自在简单任务上的均分为基准,SeekBrain 在困难任务上的平均得分下降约 15.3%,Claude Code 下降约 32.8%,Codex 下降约 37.5%。
这意味着,能够完成较直接的统计和绘图,并不等于能够可靠地完成多步骤分析。数据处理、模型训练和对照检验之间的衔接,仍是科研智能体需要面对的挑战。
图 5|三套系统在 12 个简单任务和 20 个困难任务上的平均得分。误差线表示均值标准误。
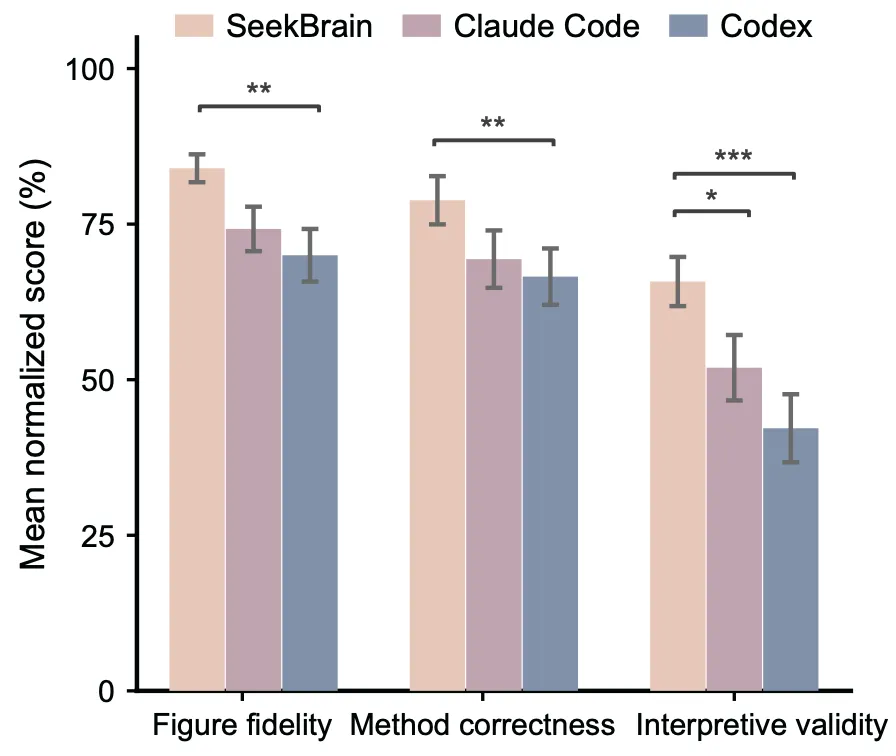
三套系统都呈现出相同的得分顺序:图形复现度最高,方法正确性其次,解释有效性最低。
以 Codex 为例,图形复现度和方法正确性分别为 70.0% 和 66.6%,解释有效性则为 42.2%。Claude Code 也呈现相同趋势:图形和方法得分分别为 74.2% 和 69.4%,解释得分为 51.9%。
科研分析的难点并不止于画出图形。智能体还需要把结果放回具体的研究问题中,说明其生物学含义,并判断哪些结论有数据支持。
图 6|三套系统在图形复现度、方法正确性和解释有效性三个评分维度上的表现。各任务的分项得分先换算为对应满分的百分比,再取平均。
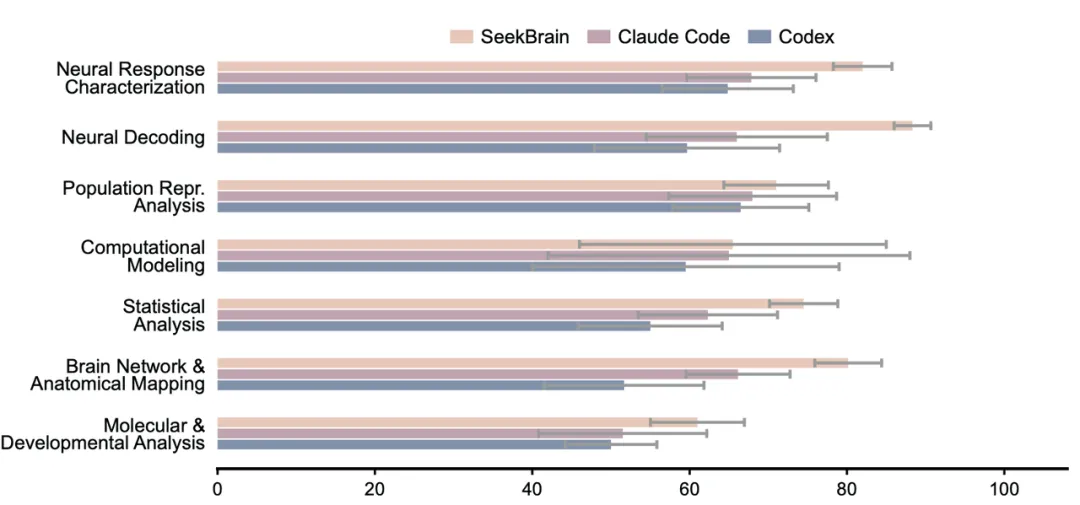
七类分析任务中,分子与发育分析是三套系统平均得分最低的一类。在神经响应表征任务上,Claude Code 和 Codex 的均分分别为 67.9 分和 64.9 分;在分子与发育分析任务上,两者的均分则分别为 51.5 分和 50.0 分。
从刻画神经响应,到识别细胞亚型、追踪发育变化或分析基因表达,任务所需的数据处理和专业方法都在变化。评测由此不只回答“智能体得了多少分”,也帮助研究者看清“哪些分析能力还需要提升”。
图 7|三套系统在七类神经科学分析任务上的平均得分。误差线表示均值标准误。
BrainArena 将科研智能体放到真实神经科学数据面前,考察它能否把领域知识转化为分析方法,并形成有依据的科学结论。
通过专家制定的任务和评分标准,它为 Humanity’s Last Exam 等通用学术推理基准,以及 SWE-bench、MLE-bench 等代码类基准,补充了神经科学研究中的实践检验。
这套基准也为后续改进提供了共同参照。模型或分析流程更新之后,开发者可以在相同任务上检查方法、图形和解释的变化,判断改进具体发生在哪些环节。
研究者则可以结合自己的分析需求,查看相关任务的表现,为进一步测试和使用智能体提供参考。
当前的 32 项任务聚焦有明确目标和参考结果的数据分析,提供了可对照的科研分析测试。更开放的研究,还涉及从数据中提出问题、调整探索路径、验证新假设。
未来的评测需要逐步覆盖这些能力,让智能体在更接近科学发现的任务中接受检验。