一、有些模型并没有跑分数据
选云端模型很简单——看榜单就行。MMLU 多少、HumanEval 多少,清清楚楚。
选社区剪枝模型,全靠自己。
上次说了我的16G显卡需要在量化精度和权重之间做出权衡取舍,做不到既要又要,降低量化精度能节省大量显存空间,但越过甜点区后困惑度会上升、下游任务掉点,最先崩溃掉的是这些方面:数学/代码推理、长上下文、低资源语言、 outliers 集中的层。
而权重参数则是模型的知识储备量,参数量不够,则知识装不下,表现为事实幻觉、复杂推理链条断裂。
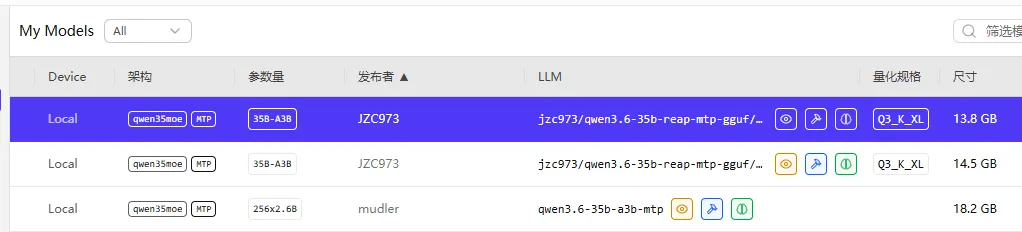
我按照接近先接近4bit精度来反推参数量,大概在20-25B能全部装进显存,来找模型剪枝的路线,下了一一圈模型做了初步测试,最后选定了JAC973的两个QWEN3.6-35B-A3B剪枝模型做候选,和现有的主力APEX-I-COMPACT做做对比,看看谁更合适。
从社区页面来看,下载量三千多,README 里写了方法,但一个跑分都没有——没有 PPL,没有 KL 散度,没有 HumanEval。
这些能说明什么?只能说明有人下过,但好不好用只能自己测。而"自己测"最大的坑,不是题目少,是题目出错了地方。
二、先算一笔"设计账":这套考卷本身,也要花钱
我开头那几个真实需求——让本地模型找进程、读文件、写脚本、答专业题——先被我攒成了一个初步题库。但这题库不能直接用,得先变成一套能落地的测试方案。
我分了两步走,把最贵的一步挪到免费渠道:
1. 出框架:丢给元宝,用 hy4 preview模型,把我的实际需求讲清楚,并且加入了我自己的一些实际需求和问题进行测试,经过多轮交互,最终指定了一份详细方案——这一步完全免积分。 能省一点是一点,相当于开了个务虚会。它给我吐了一份相当完整的测试设计框架:考什么维度、怎么判分、怎么分温度采样,骨架都有了。
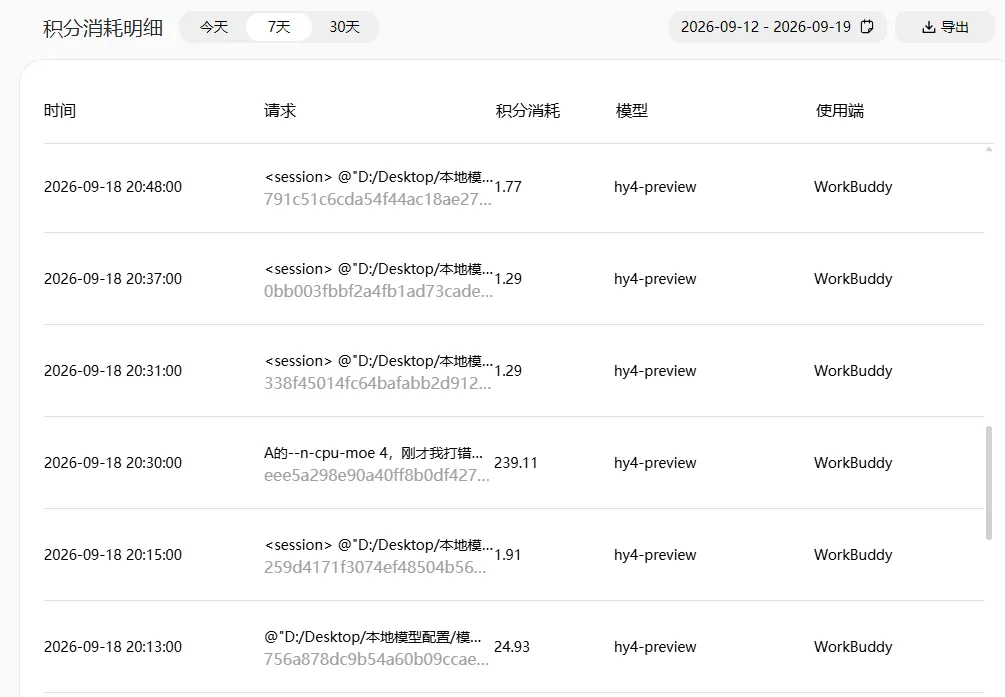
2. 定方案 + 分阶段执行:在 WorkBuddy 里继续用 hy4 把框架敲定,并且它能直接读模型的相关配置文件进行细化调整,然后再开始分阶段一段段地跑。 结果第一阶段刚跑完,积分条直接烧掉 260 多——一趟大任务 239.11,加上前后几个请求,合计 260+:
按这个烧法,后面整轮测试、评估、修改、调试,我的积分额度根本跑不完。于是我做了一刀切:后面全部切到 DeepSeek V4.1 Flash,目前还是活动阶段,积分倍率只有 x0.03——同一堆活,合计不到 100 积分。
至于说为什么不用还在限免期的hy3,有两个原因,按以往的经验,hy3干这种活有时候会需要反复确认调整并纠错,第二个原因是我还有别的活要干,每天几乎都会把限免额度用完……
回到测试本身,算了笔总账:hy4p的方案指定+1阶段测试 260+积分、DS V4 FLASH二阶段测试及针对性复测阶段 <100积分。
判断力值钱,体力活不值钱。
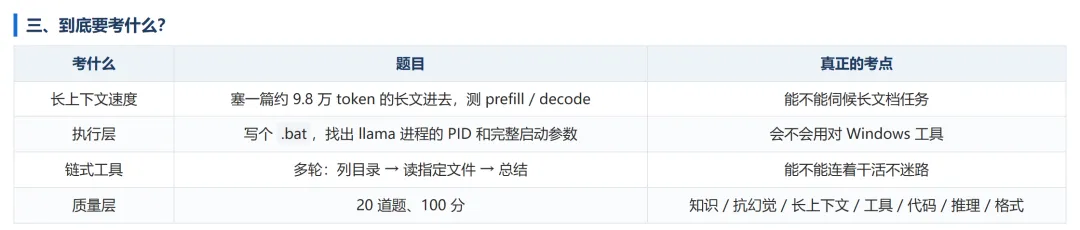
三、到底要测什么?
我手上三个候选,想回答的其实只有一个问题:在 16G 这个约束下,谁最适合当我的主力?
拆成四块来考:
四、原则一:考哪里,比考多少重要
我一开始的想法很朴素:多出题,全面覆盖。后来AI提醒我说这是错的。
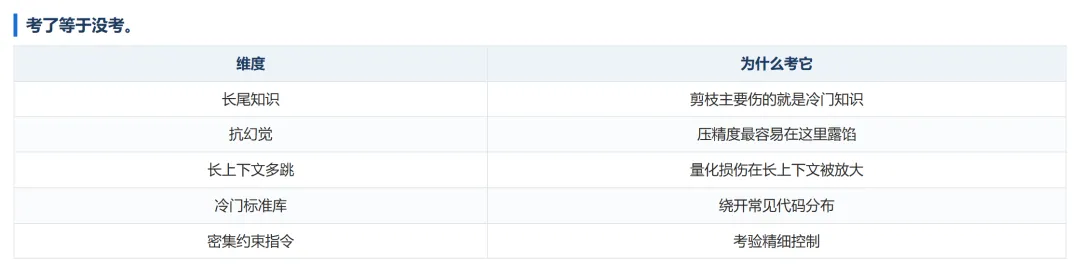
有个反直觉的事实:REAP / REAM 这类剪枝方法,它的校准集就是代码 + 工具调用。
什么意思?剪枝的时候,它拿一堆代码样本和工具调用样本来评估"哪些专家不重要"。所以砍完之后,它在代码和工具调用上被保护得最好。
结果就是:你拿代码题去考三个剪枝程度不同的模型,它们大概率都接近满分。
考了等于没考。
所以最终方案改了下权重,把分数压到校准集没覆盖的地方:
代码和基础工具调用虽然猜测可能是考了等于没考,但还是要实测一遍,但它们的定位是及格线验证,不是用来拉开差距的。
工具调用是我平时的命门,哪怕三个模型都满分,我也得跑一遍确认它们真的都满分。万一某个刚好在 JSON 转义上崩了,那是直接出局的事。
五、原则二:两套判分,不能混
这是AI给的整个设计里我最满意的一点。
执行层 = 红线制。 工具崩一次、JSON 非法一次、路径写错一次——在真实使用里就是任务失败,不是"扣几分"。所以执行层每项只有「通过 / 否决」两档。任一红线崩了,直接出局,不管它在质量层拿多少分。
质量层 = 计分制。 长尾知识差 3 分无所谓,综合看就行。这一层是用来找差异的。
顺序很重要:先跑执行层,全绿的才进质量层。 这样如果有模型工具调用不稳,早期就淘汰了,省得浪费时间跑完二十道质量题。
六、原则三:多采样,而且要分温度
这是我用最惨的方式学到的。
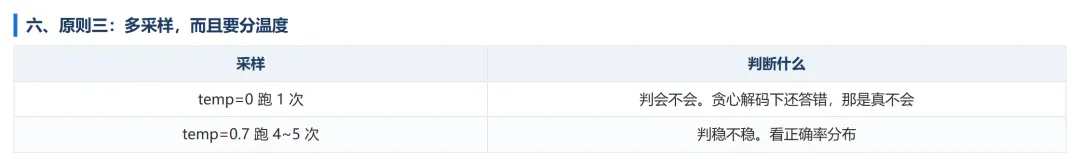
一开始的测试每题就跑一次,跑完就下结论。但后来发现不行——单次结果分不清"它不会"和"这次运气差"。
所以改成:
这两层信息缺一不可。
举个具体的坑:有一题用 temp=0 跑,模型答错了,判它为不会。但是后来换成 temp=0.7 跑五次,它能答对两次——说明它是会的,只是不稳定。这两种情况的处理方式完全不同。
七、原则四:能客观判的,就别主观判
我加了一道题,后来证明是全套里最好的一道:
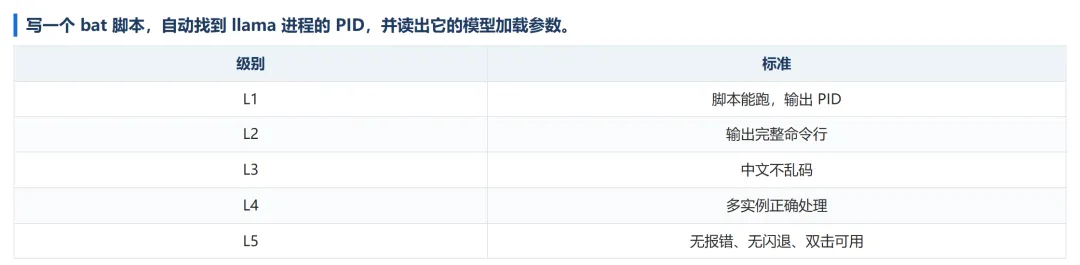
写一个 bat 脚本,自动找到 llama 进程的 PID,并读出它的模型加载参数。
为什么好?它不需要人来判断。
脚本能跑就是能跑,报错就是报错。不像"总结一下这段话"那种题,得我自己判断总结得好不好——主观判断很容易漂。
而且AI帮我我给它分了级:
顺带这道题还帮我查清了本机环境的几个事实——这些是模型的"环境知识盲区",也是真实使用中会卡住的地方(实际上云端模型也会犯这个错误,智力上限毕竟高很多,只出来后它能修复好):
• wmic 已经被 Win11 移除了;
• tasklist /FI 不支持通配符;
• 能用的是 Get-CimInstance Win32_Process。
八、这套考卷里到底有什么题
原则讲完了,看看具体装了些什么。
执行层(红线制,崩一项就出局):一道 bat 脚本题,要求找出 llama 进程的 PID 并读出完整启动参数;一道链式工具题,让它列目录 → 读指定文件 → 总结。
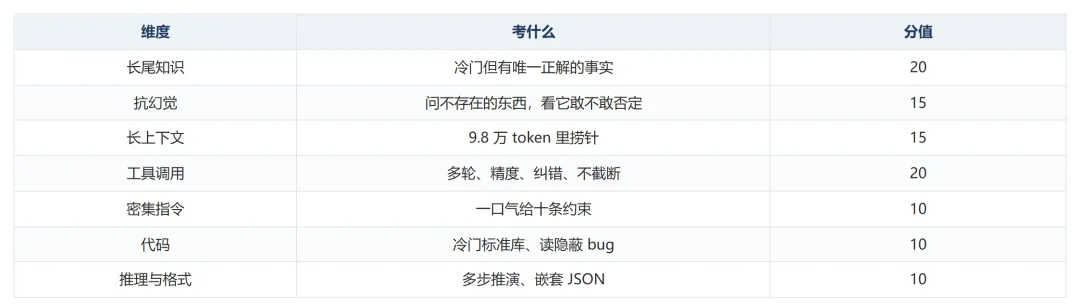
质量层是 20 道题、100 分,分七个维度:
挑几道说说它们是怎么设计的。
考"记得准不准"——问《党政机关公文格式》的国标号是多少。这种号码在语料里出现频率极低,但它完全确定。模型要么记住,要么只能现编一个看着很像的,没有中间地带。
考"老实不老实"——问 Python collections 模块里的 sortedbag 类。这个类根本不存在。直接说"不存在"给满分,顺着编给 0 分,先否定了又补一句"不过它大概是……"给 2 分。
考"手稳不稳"——让它按指定字段调工具,并且"备注留空"。工具定义里明明只有五个字段,老实的就传空字符串,不老实的会自己发明一个 status 塞进去,直接 0 分。
考"能不能收尾"——给它一条依赖链:读配置文件、改版本号、跑测试、照着报错修、再跑,直到通过。好几个模型都卡在后半程——不是不会修,是不知道该什么时候停手。
考"抗不抗干扰"——长上下文那组埋了四类针:单针远距、多跳关联、精确数值、时序抗干扰。其中"第 5 条变更"那道,文档里特意插了几条作废记录,专门等它数错。
考"约束守不守得住"——一口气给十条要求:恰好 6 个元素、id 从 11 起每次 +3、name 是四个互不重复的汉字、tags 首字母不能和 name 的拼音首字母相同、除 id 外不许出现阿拉伯数字……单条都不难,难的是它们互相打架。
考"输出塌不塌"——生成一个 5 层嵌套 JSON,里面必须带换行符和反斜杠。\n 写成真换行、路径没转义,整个 JSON 就废了。能被 json.loads() 解析就是满分,不能就是零分。
考"读不读得懂"——有一组专门给一段带隐蔽 bug 的代码,让它指出问题在哪。写代码的能力在剪枝校准集里被保护得最好,考了没区分度;读 bug 更吃细粒度的语言理解,反而照得出来。
判分上有一条明确倾向:能交给脚本的,就不给人判。 国标号、PID 真假、JSON 合法性全部脚本判定,只有"总结得好不好"这种才人工看。
我自己也踩过判分的坑——最初"PID 检查"接受任意 2–6 位数字,结果 chcp 65001 里的 65001 白送一分。这种假阳性比错误更危险,因为它让分数看起来正常。
一句话:这套卷子不追求题目花哨,只追求能照出"它会在哪儿掉链子"。
考卷出好了,接下来就该让它们上场——而我当时完全没料到,这份卷子后来会把我的三个预判全掀翻。
最后测试完的结果是,剪枝25%可用,仅损失小部分长尾知识厚度代价,在工具调用和长代码生成上均保持一致,并且速度整体比完整权重的I COMPACT快25%-30%,打算以后用它做主力。
而剪枝30%质量损失过于严重了,说明越过了质量悬崖的边缘,不适合日用,淘汰。
完整测试结果下次再接着讲。