先把生成者和裁判分开配置
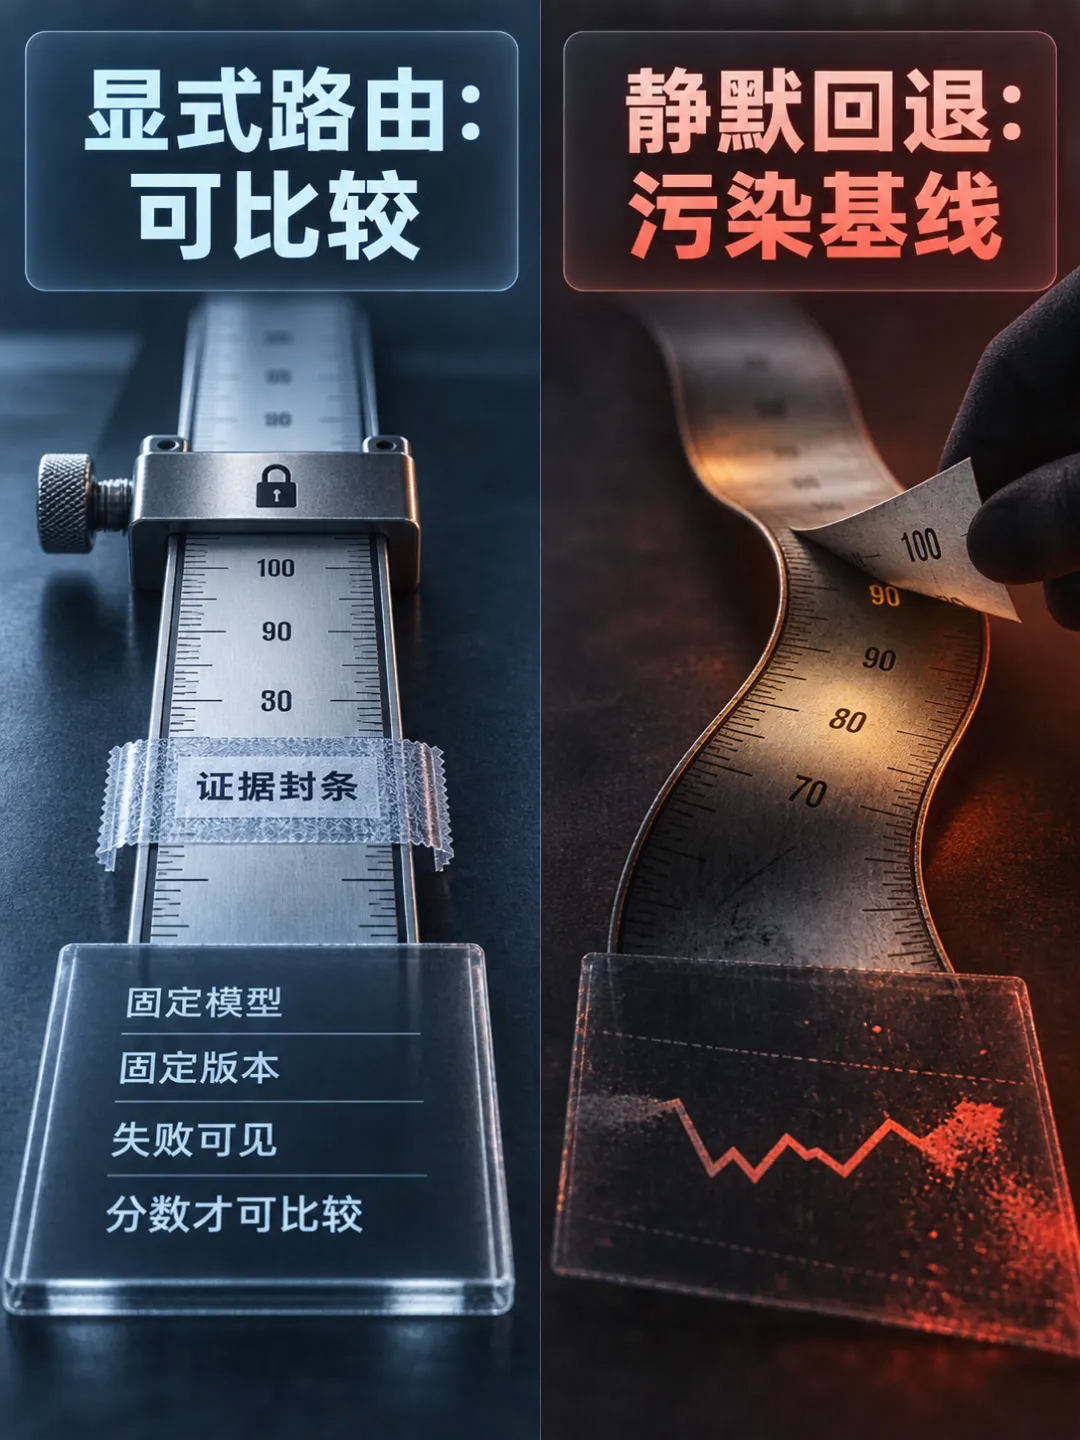
在生成式应用里,生成模型负责回答,评测模型负责依据量表打分。两者若共用一个模糊的默认 provider,任何环境变量、路由策略或网关默认值的变化,都可能让裁判悄悄换人。昨天用模型 A 打的 82 分和今天用模型 B 打的 94 分不能直接比较,即使输入数据完全相同。
AI SDK 7.0.104 的变化很具体:自定义 provider 现在可以维护 evaluationModels;registry 增加 evaluationModel 解析入口;experimental_evaluate 可以接收诸如 internal-evaluator 这样的字符串标识。配置层因此能把生成模型与评测模型分别命名、分别授权、分别记录,而不是把所有调用都塞进一个 defaultProvider。
准备阶段先列出三个固定项:生成模型 ID、评测模型 ID、评测量表版本。动作阶段把评测模型放进 evaluationModels,并在每次运行日志中写入最终解析出的 provider 与 model。验证阶段故意把字符串改成不存在的 evaluator;合格结果应是任务立即失败并明确指出 evaluationModel 解析错误,而不是仍然返回一组看似正常的分数。
这一步看似多了一次失败测试,实际是在保护后续所有比较。只有裁判身份、量表和样本版本都能追溯,分数变化才可能来自被测系统,而不是来自路由变化。
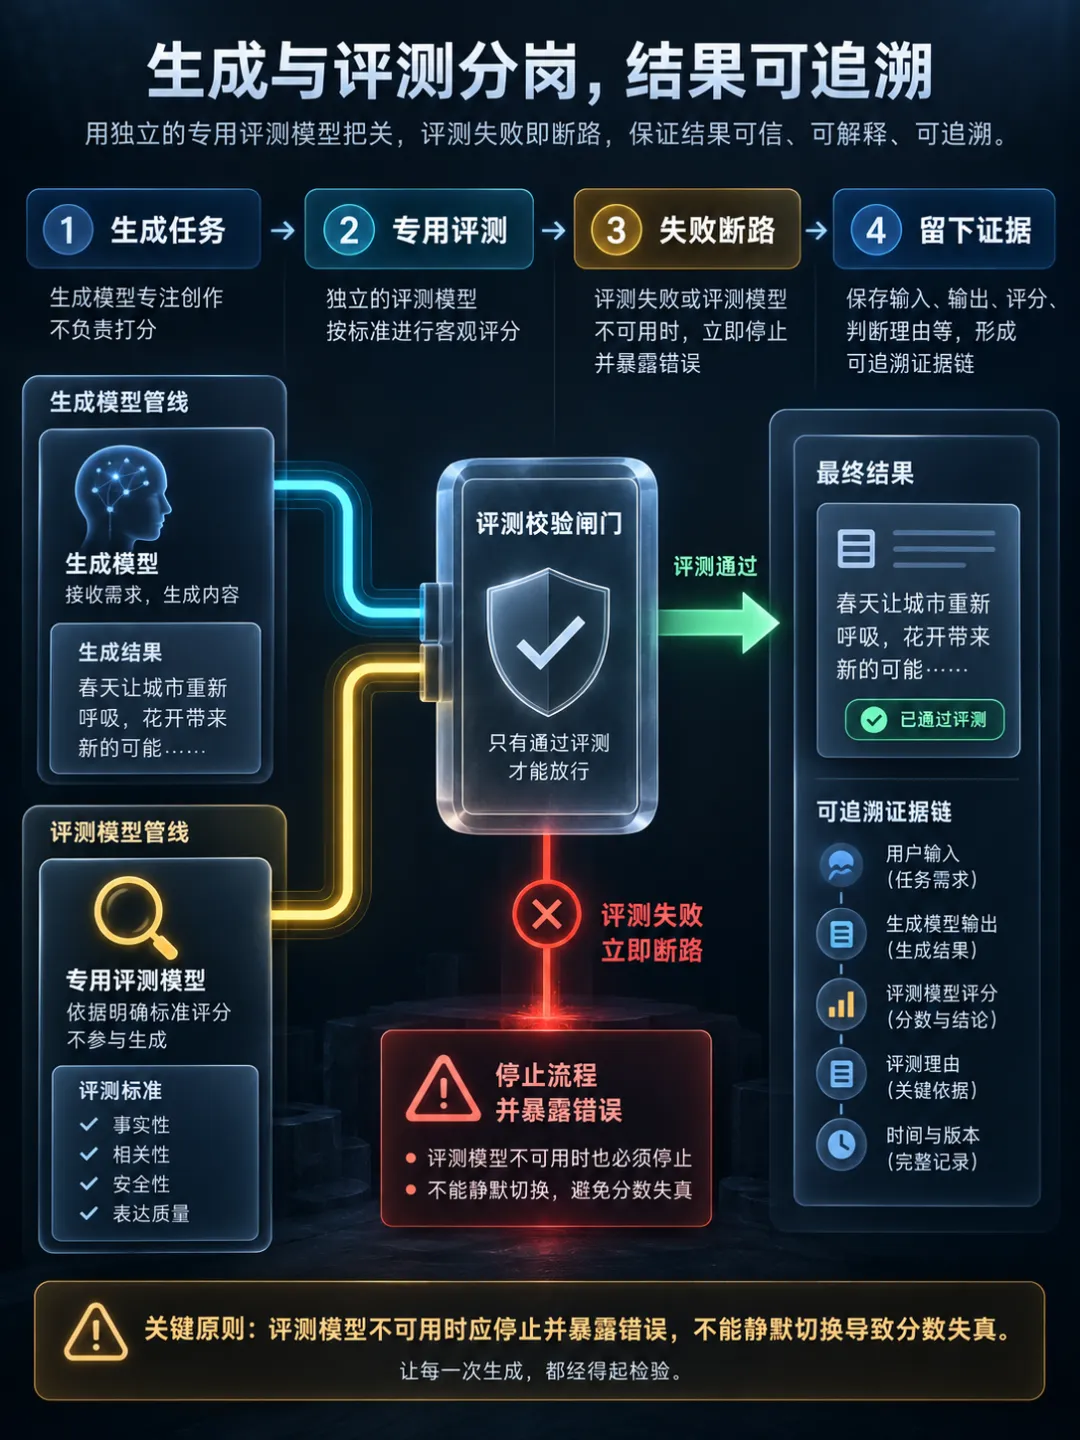
案例一:客服回答回归评测要先做断路测试
‘客服回答回归评测’的输入是 30 条固定问题、参考答案、禁止承诺清单,以及四项评分量表:事实正确、是否引用政策、是否越权承诺、能否给出下一步。被测模型生成回答后,专用 evaluator 输出每项 0 到 2 分和一条证据说明。成功标准不是平均分达到某个漂亮数字,而是 30 条全部有评测记录,评测模型 ID 与量表版本完整,禁止承诺项零漏报。
动作上先跑一轮基线,并把样本哈希、生成模型、评测模型、温度和代码提交写入 run.json。随后只修改客服提示词,再跑第二轮。两轮使用同一个 evaluationModel 字符串,脚本在启动时打印解析结果,并把最终模型名写进结果文件。这样每一条差异都能追溯到同一裁判。
断路测试故意把 evaluationModel 写成 team-eval-v9,而 registry 里只配置了 team-eval-v2。预期输出是运行在第一条样本前失败,错误明确包含 evaluationModel 或未找到的 ID;如果系统继续执行、换用网关模型或只在日志里发出警告,测试直接判不通过。
可观察输出是两份结构一致的 JSON、一个差异表和一次断路测试记录。只有 30 条样本数量一致、裁判 ID 完全相同、禁止承诺没有新增,团队才可以讨论那 12 分提升是否真实。否则应该先修评测基础设施,而不是调提示词。
案例二:代码补丁评测同时检查质量与成本
‘代码补丁双裁判评测’处理的是 12 个带测试的仓库任务。输入包含 issue、起始提交、测试命令和允许修改的目录。生成模型提交 diff 后,第一个 evaluator 判断需求覆盖和越界修改,第二个确定性检查直接运行测试、统计改动文件与退出码。通过标准是测试全绿、没有修改禁止目录、模型评分附带可定位到 diff 的理由。
准备时固定容器镜像和依赖锁文件;动作时先运行确定性测试,再把 issue、diff 与测试摘要交给 evaluationModel;验证时比对模型结论与真实退出码。如果模型说通过而测试失败,这条样本不能被平均分掩盖,必须记录为裁判冲突。
第二轮把生成模型从 A 换成 B,但评测模型、容器和量表保持不变。输出不仅有总分,还应有每个任务的生成成本、评测成本、测试耗时和冲突数。这样才能判断模型 B 的提升是否值得额外费用,而不是只看到一个脱离运行事实的主观得分。
若评测输入包含未公开代码、客户数据或安全漏洞,不能为了方便把内容路由到默认网关。应使用获批 provider、最小数据字段和保留策略;无法确认数据去向时,停止模型评测,只保留本地确定性检查。
边界与一张评测模型路由验收表
命名失败边界是‘把模型裁判当作绝对真值’。即使 evaluationModel 配置完全正确,它仍可能受提示顺序、量表歧义和自身偏好影响。涉及安全、法律、医疗或生产权限的决定,不能由单个模型分数自动放行;至少要叠加确定性测试和人工抽检。
可复制的‘评测模型路由验收表’包含:样本集版本、样本哈希、生成模型 ID、评测模型 ID、provider、量表版本、代码提交、失败策略、确定性检查、模型评分、裁判冲突、成本和人工复核人。接受标准是评测 ID 显式、未知 ID 立即失败、两轮比较的裁判与量表一致、每个分数有理由、关键样本经过确定性或人工复核。
执行分两步。第一步准备固定样本、量表和 registry;动作是运行已知 evaluator 与不存在 evaluator;验证成功路径写出真实模型身份,失败路径不产生任何分数。第二步准备两组仅有一个变量不同的实验;动作是运行同一评测链;验证样本数、模型 ID、量表版本和冲突清单一致后再解释分数。
最终应该把路由验收表和评测结果一起进版本库。缺少任何一个身份字段,都只能把结果标为不可比较;出现静默回退、未知模型仍执行或高风险冲突未复核,则整轮结果作废。
把方法留成可复用工具
评测模型路由验收表
字段:样本集版本、生成模型ID、评测模型ID、provider、量表版本、失败策略、裁判冲突、人工复核人。
- • 客服回答回归评测:30条固定客服问题比较两版提示词。;动作:用同一evaluationModel打分并故意测试不存在的模型ID。;验收:得到可追溯差异表,未知ID在评测前明确失败。。
- • 代码补丁双裁判评测:12个仓库任务同时需要质量分数和真实测试。;动作:固定容器运行测试,再用专用评测模型检查diff。;验收:输出通过率、裁判冲突、成本和可定位理由。。
执行顺序:
- 准备:固定样本、量表和registry。;动作:分别运行已知和不存在的评测模型ID。;成功标志:成功路径记录真实身份,失败路径不产生分数。。
- 准备:准备仅一个变量不同的两组实验。;动作:用同一评测链运行。;成功标志:核对样本数、模型ID、量表和冲突清单后解释分数。。
验收标准:评测ID显式;未知ID立即失败;比较轮次裁判一致;关键样本有确定性或人工复核。
边界:把模型裁判当作绝对真值。当高风险决定只依据单个模型评分,或评测数据去向未获批准。时,叠加确定性测试与人工复核;数据边界不明时停止模型评测。。
来源
- • 主来源:https://github.com/vercel/ai/releases/tag/ai%407.0.104
- • 补充来源:https://ai-sdk.dev/docs/ai-sdk-core/evaluation
