做医学影像标注,有人更在意边界的贴合程度,有人希望点一下就有响应,也有人要把一处病灶沿着连续切片追下去。这些工具分别侧重掩膜质量、轻量交互和跨切片处理。
下面把9款模型放到一起,先看它们适合做什么,再看两组公开测试:一组比较乳腺超声病灶在不利提示框下的表现,另一组观察肿瘤CT、MRI中的框偏移。场景建议结合了工具设计与这些评测,供筛选试用对象。
结果总览
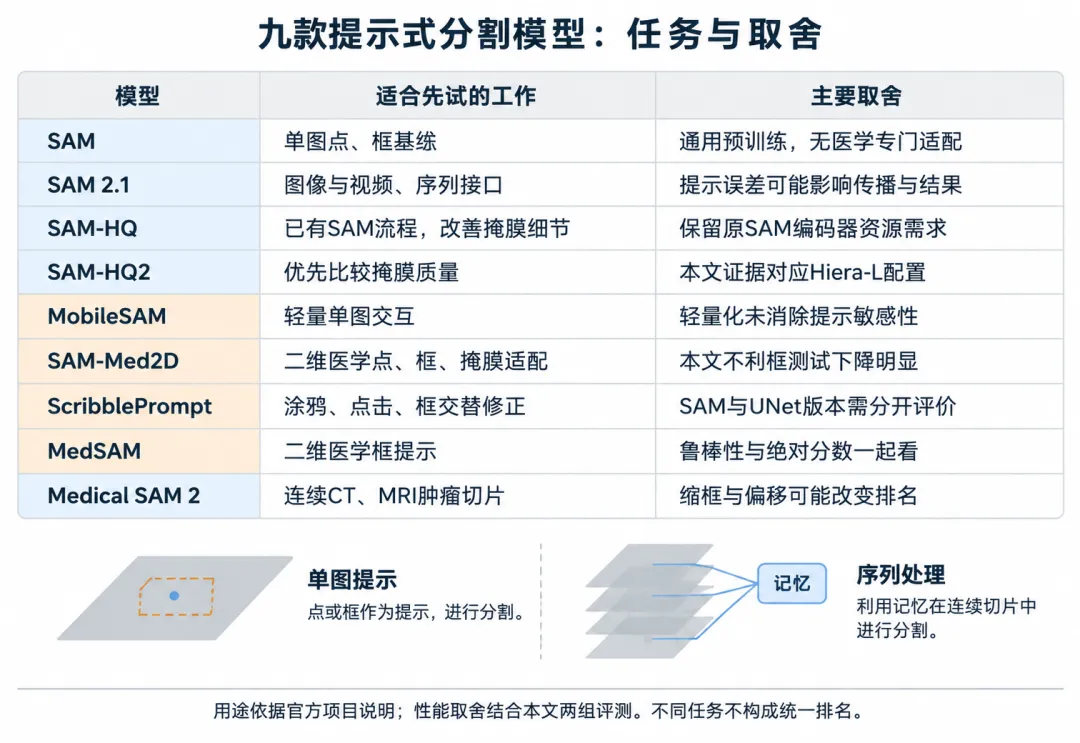
表1|场景速查。SAM-HQ2在官方项目中也写作HQ-SAM 2;ScribblePrompt有SAM与UNet两个版本,后面的框测试对应SAM版本。性能判断限于本文引用的数据和配置。
如果主要想改善单图掩膜,我会先比较SAM-HQ2、SAM-HQ和MedSAM;机器资源有限,就把MobileSAM提前。如果经常需要亲手补几笔,ScribblePrompt更贴近这种工作方式。连续切片则需要另外看SAM 2.1或Medical SAM 2的传播方式和错误累积。
01 /同一组乳腺超声病灶,八款模型差多少
BREPS研究比较了多种提示式分割模型。研究者收集真实用户画的框,再用带自然性约束的优化方法,为模型寻找更有利或更不利的提示框。
这里选取其中的BUID乳腺超声数据,包含良性和恶性病灶。每个模型既接受紧贴参考目标的基准框,也接受BREPS搜索得到的不利框。后者用于检验模型在不利提示条件下的表现,属于受约束的压力测试。
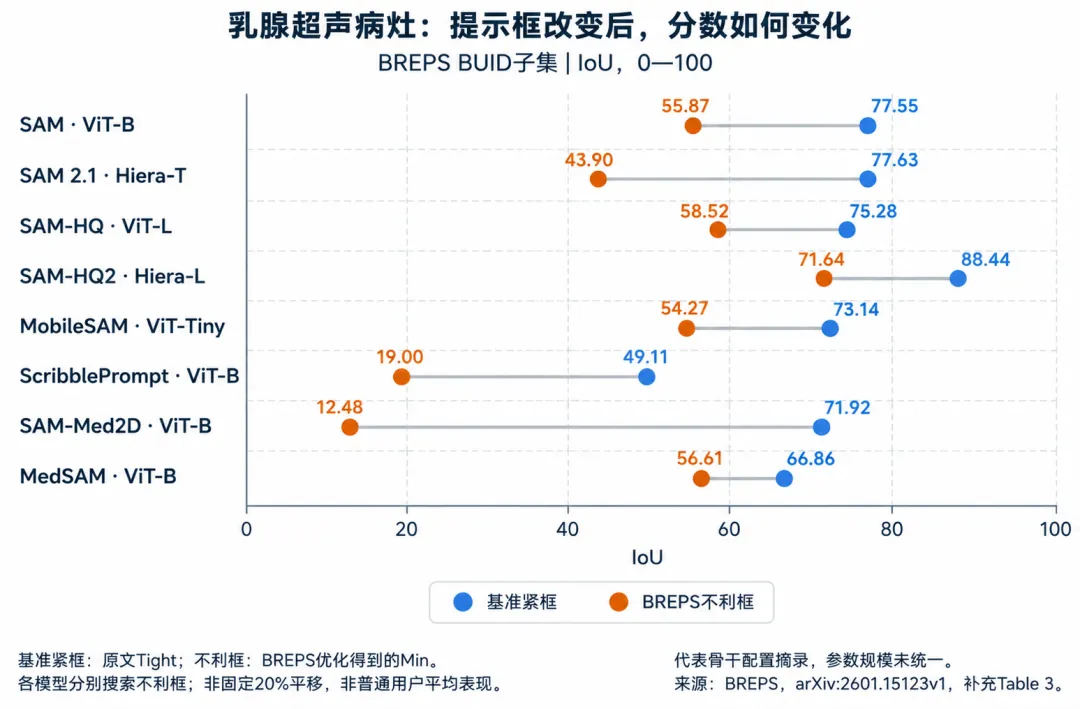
数据来源:BREPS论文补充Table 3,arXiv:2601.15123v1 。下表使用IoU,采用0—100量表;不利框由各模型按BREPS协议分别搜索。各家选取一个代表配置,骨干规模有所差异。表2|BUID结果摘录。基准紧框为原文Tight,不利框为BREPS搜索得到的Min,表示该优化过程找到的低值。结果对应表中列出的骨干与配置;完整表另列RobustSAM等模型及更多骨干版本。
优先看绝对分数,SAM-HQ2在这组配置中最突出。
基准框下为88.44,不利框下仍有71.64。若手头任务接近这类二维病灶分割,又愿意承担Hiera-L的模型规模,它值得排在试用名单前面。
优先看掉分幅度,MedSAM有另一种优势。
它从66.86降到56.61,下降10.25个IoU点,少于上表其他配置。它的不利框成绩为56.61,SAM-HQ2为71.64。下降幅度反映对框变化的敏感程度,扰动后的分数则反映该输入条件下的分割质量。
SAM和SAM 2.1的基准成绩几乎相同,分别为77.55和77.63;到了不利框条件,变成55.87和43.90。把不利框也纳入测试后,可以看到两款工具对提示误差的不同反应。
02 /这些差别,怎样对应到实际工作
SAM与SAM 2.1:先明确你需要单图,还是序列。
SAM适合做单图提示分割的参照。它的点、框接口和已有工具生态,方便检查一个新方法到底改善了什么。具体器官和病灶的适配效果,需要在对应影像上评估。
SAM 2.1增加了图像与视频的统一工作流,以及跨帧信息传播能力。需要沿连续切片处理目标时,这种接口更有用。上表采用Hiera-T配置,测试的是单图框输入,其成绩随框变化明显。做单图病灶任务时,我会比较两款模型在目标影像上的结果;使用序列传播时,则会沿切片检查目标范围是否连续、错误是否累积。
SAM-HQ与SAM-HQ2:更在意轮廓细节,可以优先比较。
这条路线的设计目标是提高掩膜质量。SAM-HQ沿用SAM编码器并改进掩膜预测,适合已经有SAM流程、想比较边界和细节改善的人;它保留了原编码器的资源需求,部署预算仍需随骨干型号安排。
SAM-HQ2延续了这条路线,并提供图像和视频接口。它在上面的BUID代表配置中同时保住了较高的基准分数与不利框分数。我会把它作为追求分割质量时的优先候选,并同时核对实际骨干。这里测试的是Hiera-L,MobileSAM采用Tiny配置,两者的计算预算需要分别估计。
MobileSAM:先满足轻量交互,再看精度够不够。
MobileSAM用较小的图像编码器替换原SAM编码器,同时沿用相近的提示接口。需要做资源受限的单图标注界面、验证交互流程,或评估CPU部署路线时,它有明确用途。
上表中,它从73.14降到54.27,提示误差仍会影响分割结果。资源允许时,我会把它与HQ路线放到同一批影像上,比较分割成绩、响应时间和需要修正的边界。
MedSAM与SAM-Med2D:医学适配,仍要分开看提示方式。
MedSAM围绕医学框提示分割展开,在本文两组实验里都表现出较小的框扰动波动。框来自不同标注者,或来自一个定位有波动的检测器时,我会把它放进对照组。它的分割成绩随病灶和权重状态变化,微调效果需要单独检查。
SAM-Med2D支持医学二维图像中的点、框和掩膜提示,更适合需要多种提示方式、准备继续适配任务的人。它在BUID基准框下的71.92高于MedSAM的66.86,不利框下则为12.48。对于框位置有波动的流程,我会先检查这个配置的提示鲁棒性,再决定是否接入。
ScribblePrompt:它解决的是“我想再改几笔”。
ScribblePrompt支持涂鸦、点击和框,还提供SAM与UNet两个版本。病灶边界有一段需要手工指出、想反复追加提示修正时,这套交互方式比只给一个框更贴近需求。
BREPS里,ViT-B版本的单次框结果为49.11和19.00,在这组配置中处于较低水平。选择ScribblePrompt时,我会分别考察SAM与UNet版本,并记录追加涂鸦或点击后能修正哪些区域、需要多少次操作。这更贴近它所服务的反复标注过程。
03 /处理肿瘤切片,还要看Medical SAM 2
第九款模型Medical SAM 2进入另一组评测。9月19日上线的Scientific Reports研究,比较了六个公开肿瘤数据集上的多种模型,并对MedSAM与Medical SAM 2单独测试了框的缩放和平移。
Medical SAM 2把切片作为序列处理,并保留跨切片信息。对需要沿一段CT或MRI追踪肿瘤范围的任务,它比纯单图接口更符合输入形式。本文采用Zhu等的Medical SAM 2,对应代码项目ImprintLab/Medical-SAM2。
在这项研究的微调框提示配置下,Medical SAM 2取得了较高的肺、肝和肾肿瘤基准成绩,同时对缩框和平移更敏感。以KiTS23肾肿瘤为例,基准Dice为86.58;扩框5%时略升至87.10,缩框20%后降至72.78,平移20%后为71.29。
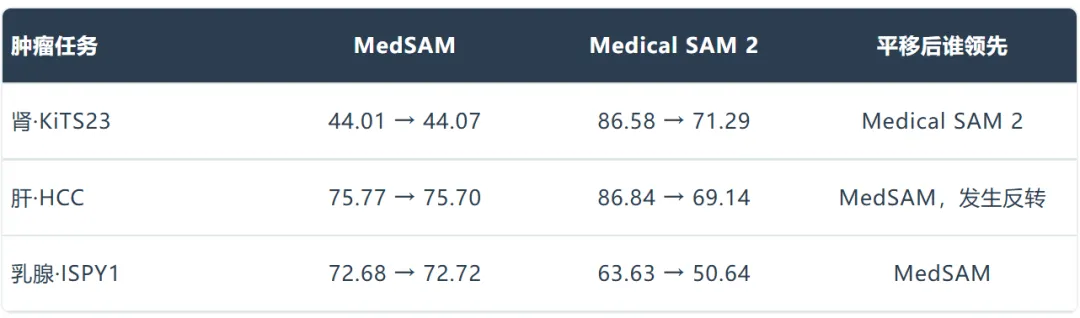
数据来源:Tortora等,论文Table 5。下表为两款模型的微调框提示设置,数字是基准框→平移20%后的Dice。该实验采用固定比例平移与Dice指标;前面的BREPS采用优化搜索与IoU指标。表3|Dice采用0—100量表。位移幅度以原框的宽或高为基准。每个数字是相应任务的汇总成绩。
肾肿瘤中,Medical SAM 2掉分以后仍然领先;肝肿瘤则发生了排名反转。它适合进入“能给出较可靠提示、又需要连续切片处理”的候选组。如果框容易漏掉目标边缘,或检测器时常定位不准,就应把这种误差一起交给模型测试。
MedSAM的权重状态也影响了结果。同一肾肿瘤任务中,论文报告的零样本成绩为83.04,这次微调配置为44.01。比较或复现时,记录具体权重与适配设置,才能把分数对应到实际使用的版本。
六个数据集上的肿瘤分割原图对照
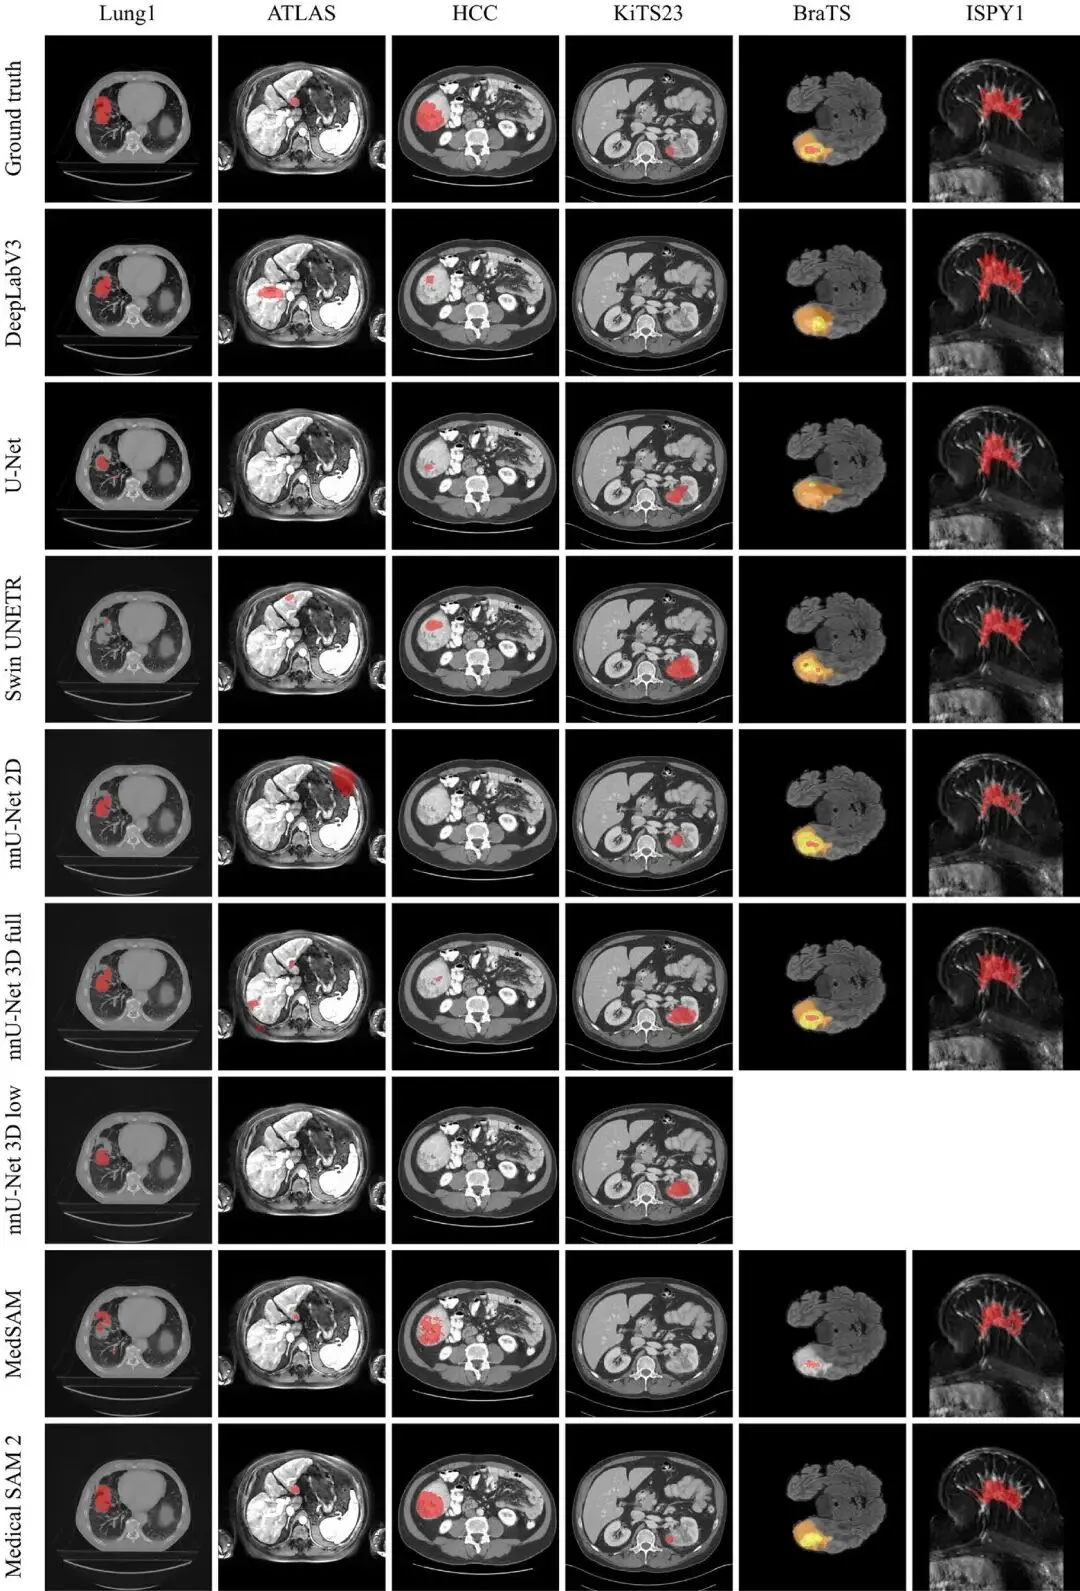
图3|第二组研究的Figure 1原图。列为六个肿瘤数据集,首行为参考标注,其余为模型预测;SAM模型展示微调框提示设置。该图展示Tortora等多癌种评测中的标准配置病例预测。Tortora等,Scientific Reports,2026,CC BY 4.0。
04 /缩小候选范围,再比较你真正要做的那一步
如果今天要为二维病灶标注选两款试用,我会先按限制条件来定。能接受较大模型、优先看掩膜质量,就比较SAM-HQ2与MedSAM;资源紧张,就把MobileSAM换进来;需要涂鸦反复修正,则让ScribblePrompt参与交互流程的比较。
有连续切片需求,再加入SAM 2.1或Medical SAM 2。需要医学二维的多种提示适配,可以考察SAM-Med2D,同时把框位置有偏差的样本纳入检查。SAM和SAM-HQ则适合保留为已有单图流程的参照,看看升级到底改变了多少边界与修正工作。
如果要做完整的三维交互标注,nnInteractive和MedSAM2也值得另设一组;如果已有人工标注、准备训练专用模型,nnU-Net是另一条路线。三维交互与专用训练分别需要对应的评测设置,可以作为后续比较的独立任务。
最后,给模型的框从哪里来,会影响这次选择。人工画框、检测器出框,以及从参考标注提取的标准框,各有相应的误差来源。我会先用实际流程里能得到的提示比较候选模型,再记录漏分、多分和人工修正量。对一款标注工具来说,这些结果比只在标准框下多几分,更接近日常要处理的工作。
参考资料
Tortora M, Mulero Ayllón E, Ruffini F, Guarrasi V, Soda P. Benchmarking foundation models for tumor segmentation across multiple cancer types. Scientific Reports,2026-09-19提前公开接受稿。