今天是2026年9月18日,星期五,北京,天气晴。
继续看本体话题,这次从评测的角度来展开。
这里看两个竞赛,一个是LLMs4OL,比的是"从原始文本中构建或扩展本体",即本体学习(ontology learning)
一个是OAEI(Ontology Alignment Evaluation Initiative),比对的是"两个已有本体之间的对应关系",即匹配(matching)。
从构成上看,LLMs4OL(本体学习)与OAEI(本体对齐)构成了当下语义网领域LLM化的两条主线:一个从文本里"长"出本体,一个在既有本体间"连"出映射,这里来做个介绍。
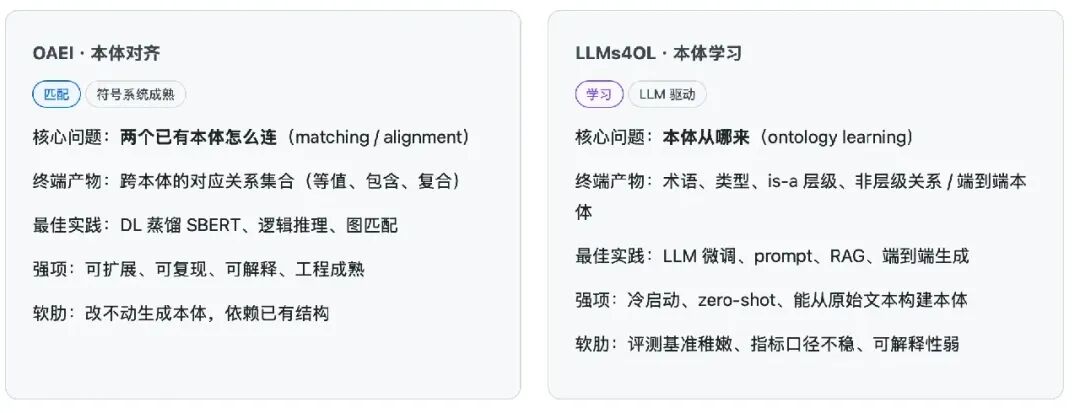
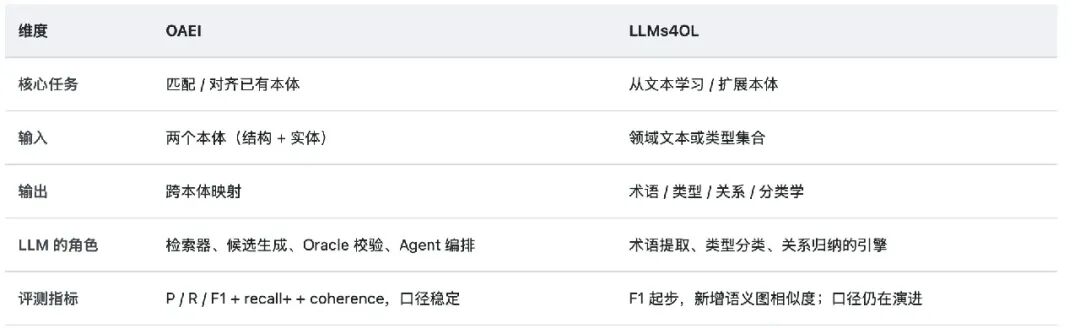
这里说个现实问题:当LLM成为本体匹配/学习的常规手段,"训练集污染"就从个别现象变成系统性评测漏洞,这个在传统任务上都有这种迹象。
做个记录,补齐下评测这块缺口。
一、本体对齐评测:OAEI
第一个是OAEI(Ontology Alignment Evaluation Initiative)从2004年延续至今,是语义网最老牌的评测组织,比对的是"两个已有本体之间的对应关系",即匹配(matching)。它所服务的本体已存在,任务是把它们的实体(类、属性、个体)互相连起来,构成跨本体的映射,地址在:https://oaei.ontologymatching.org
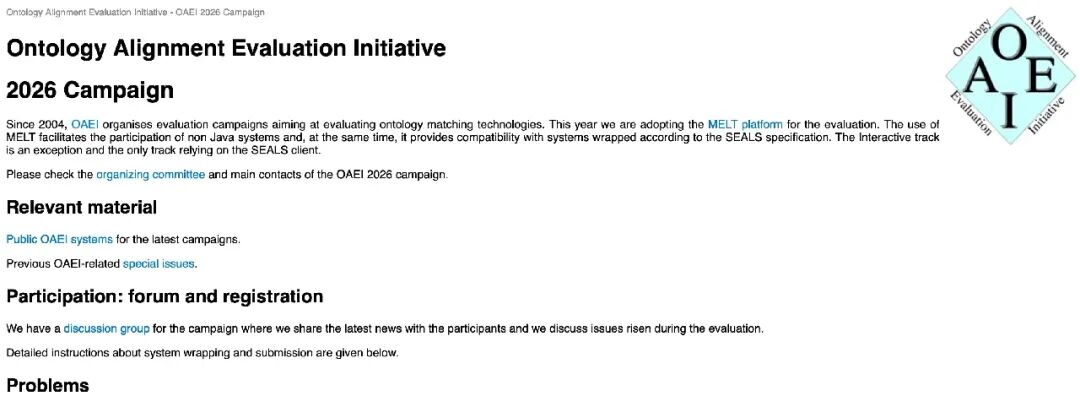
可以看下它的任务,2026的任务分为四大大类:T‑Box/模式匹配、实例+模式混合匹配、纯实例匹配(链接发现)、表格到知识图谱匹配(特殊赛道)。
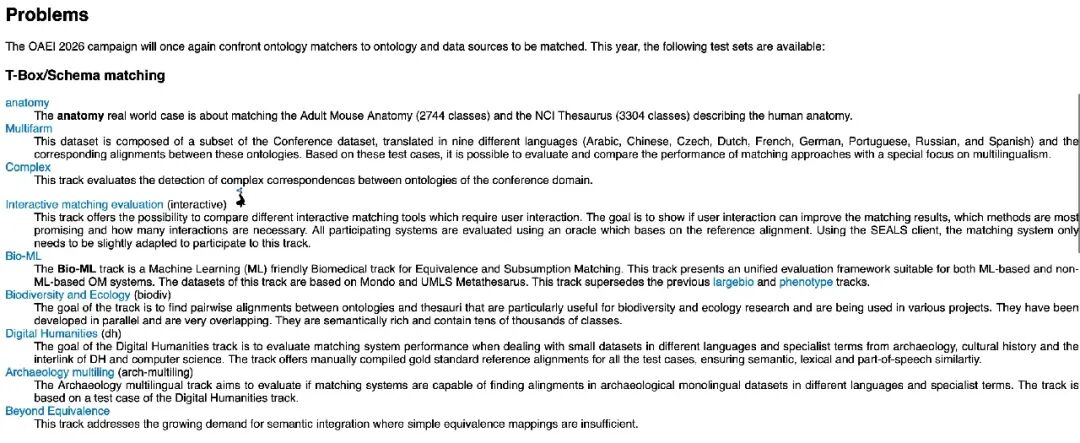
这里涉及到T‑Box:本体的模式层(类、属性、关系)和A‑Box:实例数据。
然后看方案,在传统周期里,LogMap系列(LogMap/LogMapLt/LogMapBio/LogMapKG)自2011年起几乎年年出现,靠的是可扩展的逻辑推理+结构匹配的组合路线。
AML走图结构匹配路线。BERTMap把BERT的语义表示引入等价匹配,是"预训练模型做本体匹配"的先行者。
需要注意的是,Matcha很有意思,这是一个常被误传的事实:Matcha不是LLM系统,而是描述逻辑(DL)蒸馏SBERT的方案,本质还是"语义向量+逻辑推理"的混合,一个重要规律:在数据充分、goldstandard清晰的经典赛道上,符号逻辑+语义向量的混合方案依然压过纯LLM。
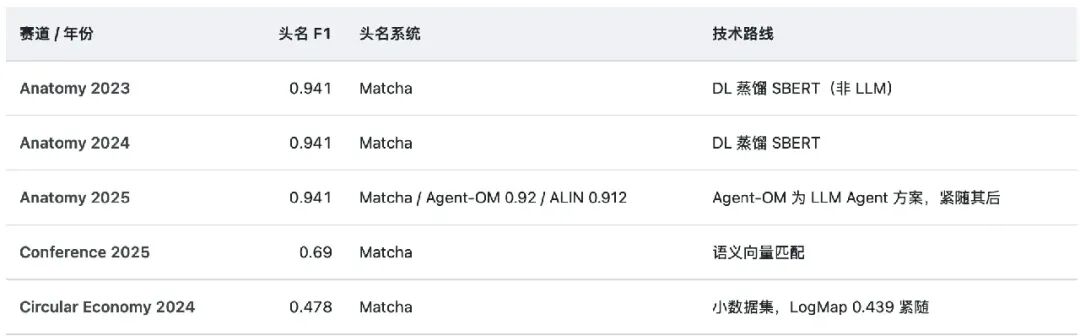
换句话说,在结构完整、数据充足的匹配任务里,把符号逻辑丢掉、指望大模型全包,目前是退步。
二、本体学习评测:LLMs4OL
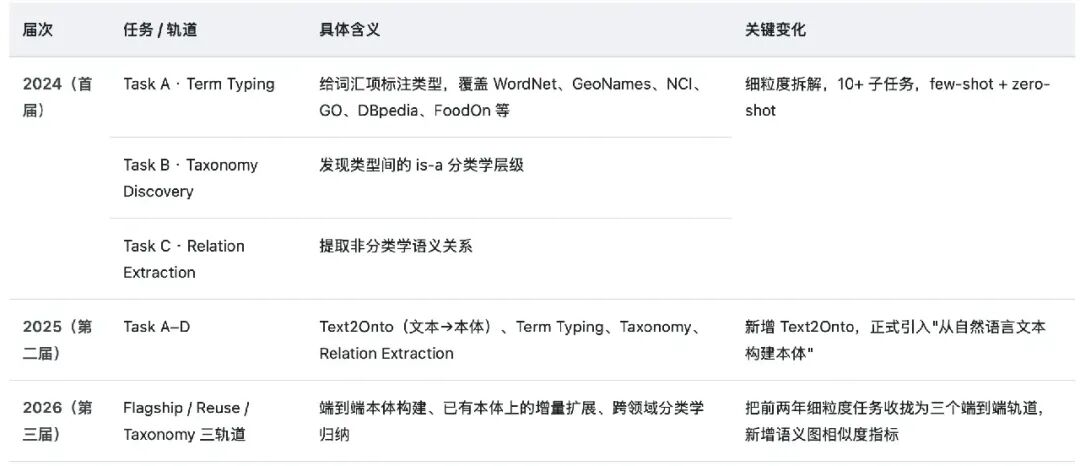
第二个是LLMs4OL(Large Language Models for Ontology Learning Challenge),2024年起步,由德国TIB牵头发起,依托ISWC举办,比的是"从原始文本中构建或扩展本体",即本体学习(ontologylearning)。
这个评测最初发表于《LLMs4OL:Large Language Models for Ontology Learning》(https://arxiv.org/abs/2307.16648),2024年正式落地为依托ISWC的挑战赛,把"本体学习"这个大命题拆成了可评测的子任务。
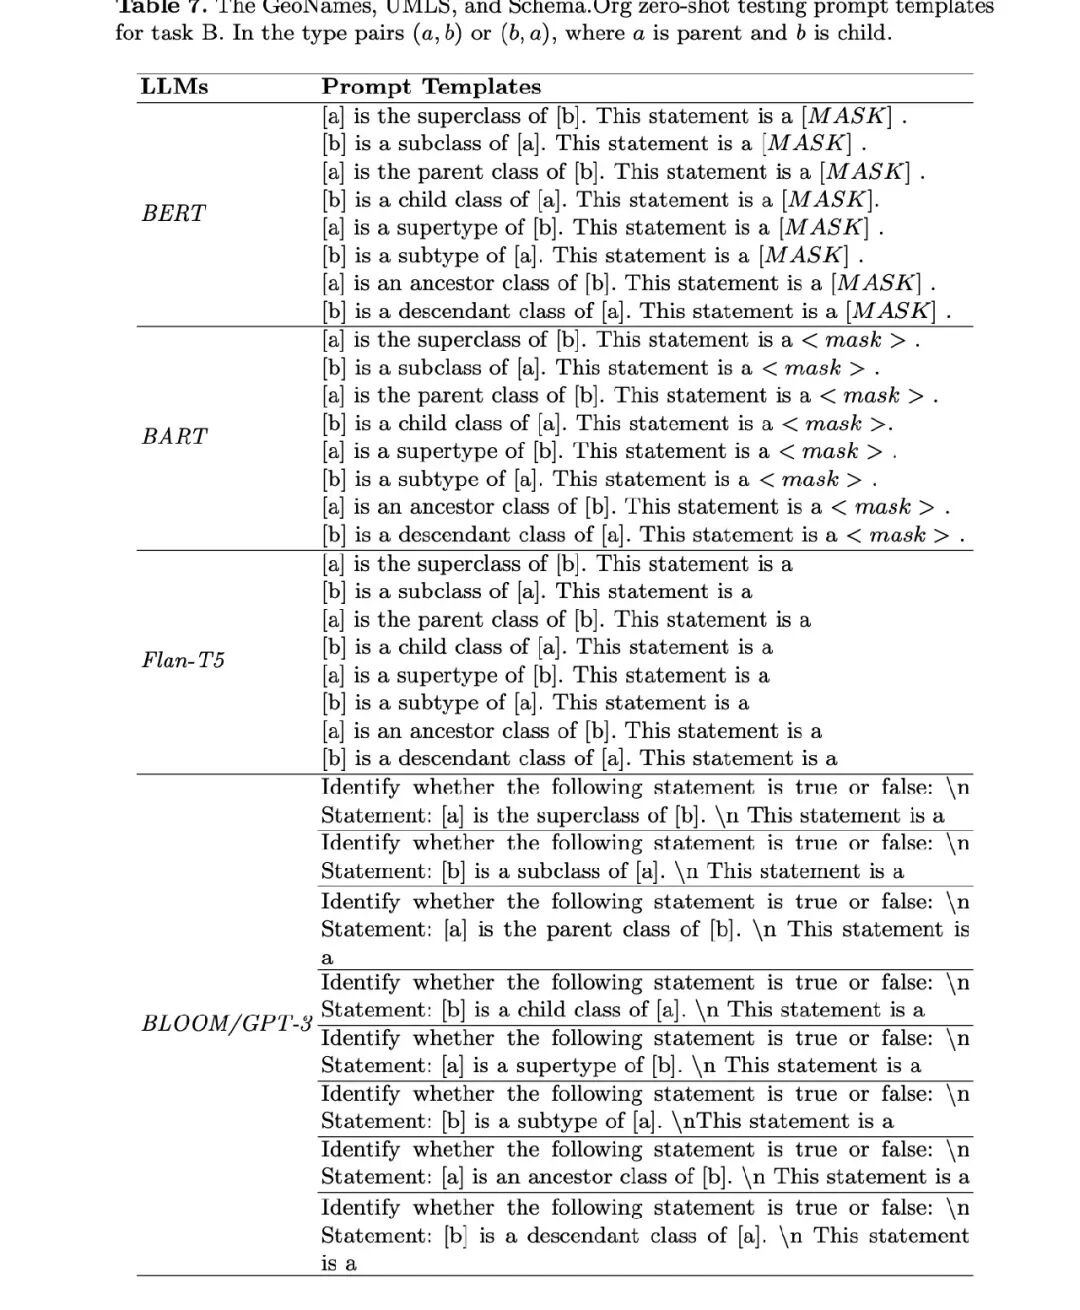
举个例子看其中的任务模板,识别上下层级:
在实现方式上,首届(2024)有14个报名者、272次提交,最终8支队伍进入论文集;代表队伍包括DSTI、Phoenixes、RWTH-DBIS、DaSeLab、SKH-NLP等,手段从微调Flan-T5到prompt-tuning、RAG都有。2025年出现SBU-NLP、Alexbek、ELLMO等队伍;2026年(第三届)出现pro-team、GenuineKnowledge_KEOL等,并出现F1与语义图相似度并用的打分方式。
参考文献
1、https://oaei.ontologymatching.org
2、https://arxiv.org/abs/2307.16648
关于我们
老刘,主页:https://liuhuanyong.github.io。
对知识图谱本体论、Agent记忆及架构、RAG知识库等技术方向感兴趣,欢迎加入社区,社区持续纳新。
加入社区方式:关注公众号,在后台菜单栏中点击会员社区加入。
