上一篇发了 0.42 这个数,后台问得最多的一句是:所以模型准确率是 42% 吗?
不是。这个数连「正确率」都不是。虚拟细胞挑战赛(VCC)的评分体系里,0 分不是零准确率,1 分也不是满分,负分是正常现象,有一项指标甚至能超过 1。这套标定是今年特意重做的,背后还有一段「指标被打穿」的前情。这一篇把榜单的读法讲透,以后你看任何虚拟细胞评测,都用得上。
一分钟速览
六个指标:PDS 认扰动、MSE 看整体、nMAE 看幅度、FID 看方向、REACH 看覆盖、JAC 看集合,三层各管一件事
两个锚点:0 分 = 把所有扰动预测成背景均值的懒惰基线;1 分 = 真实实验自己两半之间的复现水平
读数纪律:分数不能当正确率百分比;引用必须带阶段、日期、提交次数
前车之鉴:2025 年 MAE 指标失去区分度,头部队伍集中刷另外两项,组委会被迫中途改规则
最诚实的结论:主办方自己承认,模型尚未在所有指标上稳定跑赢朴素基线
01 先看考题怎么出
VCC 是 Arc Institute 发起的年度赛事,定位对标蛋白质结构预测的 CASP,英伟达、10x Genomics、Ultima Genomics 赞助。要看懂它的分数,先看考题长什么样。
2026 年的题目一句话:预测 6 个匿名细胞系里 300 个基因被 CRISPRi 敲低后的单细胞转录组。参赛者拿到的只有两样:每个细胞系的未扰动对照谱,和 300 个靶基因的名单。没有官方训练集。
更狠的是标准答案的来历。Arc 会把这场 Perturb-seq 真的做出来,测完扣着不发,赛后再跟你的预测对。你交的是预测,对面长出来的是实验。
首届 2025 年有五千多人注册、114 个国家、1200 多支队伍。冠军是 BioMap 的 xTrimoSCPerturb,综合分 0.34。今年赛程里验证阶段实时榜首在 0.3 到 0.4 区间浮动,11 月 5 日已截止提交,最终结果待公布。
02 六个指标,六个不同的问题
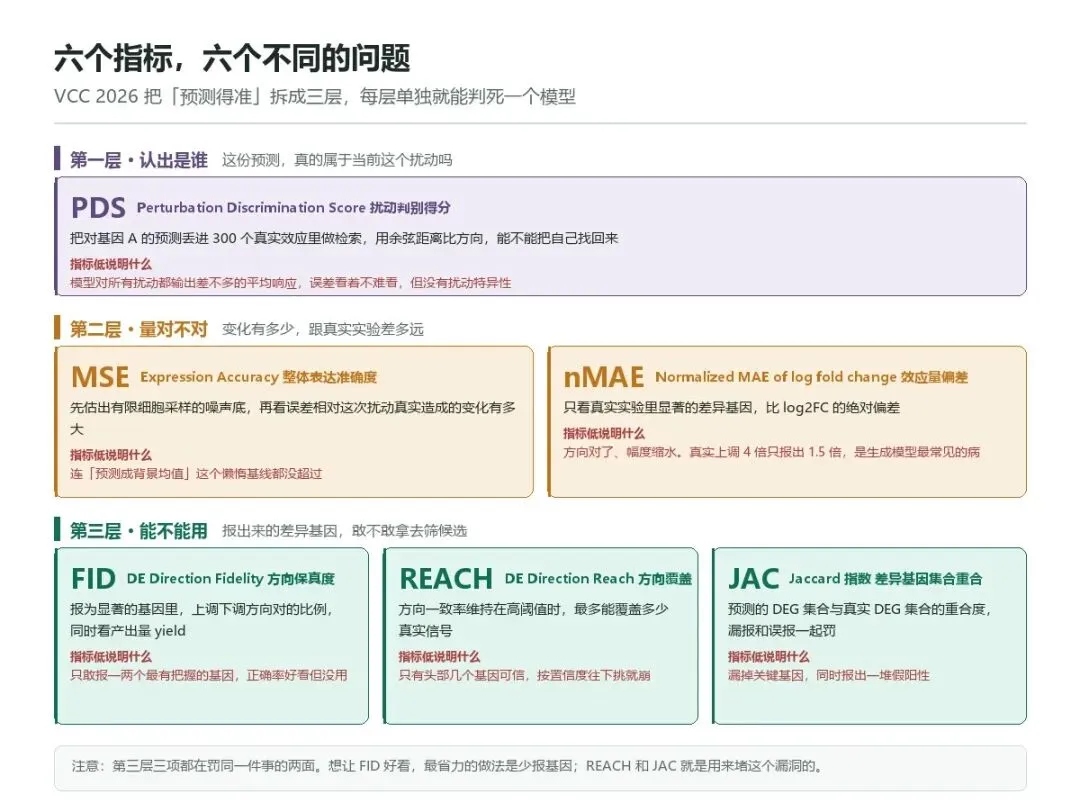
「预测得准」在虚拟细胞这里至少是三件事:认得出这份响应属于哪个扰动、变化的量级对不对、报出来的差异基因敢不敢拿去筛候选。一个数字回答不了三件事,所以今年拆成六项。
图 1 | 六个指标分三层,每层单独能判死一个模型(本号自绘)
第一层只有 PDS 一项,做的是检索:把你对基因 A 的预测丢进 300 个真实效应里,用余弦距离比方向,看它能不能把自己找回来。这一项专门抓「所有答案写得都差不多」的模型。
第二层是 MSE 和 nMAE。MSE 看整个表达谱,但不是裸算误差:先估出有限细胞采样的噪声底,再看你的误差相对这次扰动真实造成的变化有多大。nMAE 只盯真实实验里显著的差异基因,比 log2FC 的偏差,专罚「方向对了、幅度缩水」。
第三层三项都在管差异基因。FID 看方向对的比例,同时看产出量;REACH 看维持高方向一致率时能覆盖多深;JAC 用 Jaccard 指数比集合重合度,漏报和误报一起罚。
闲聊点评:这三项在堵同一个漏洞:想让方向正确率好看,最省力的办法是只报一两个最有把握的基因。单看 FID 会被钻空子,REACH 和 JAC 把这条路堵死了。
03 0 不是零分,1 不是满分
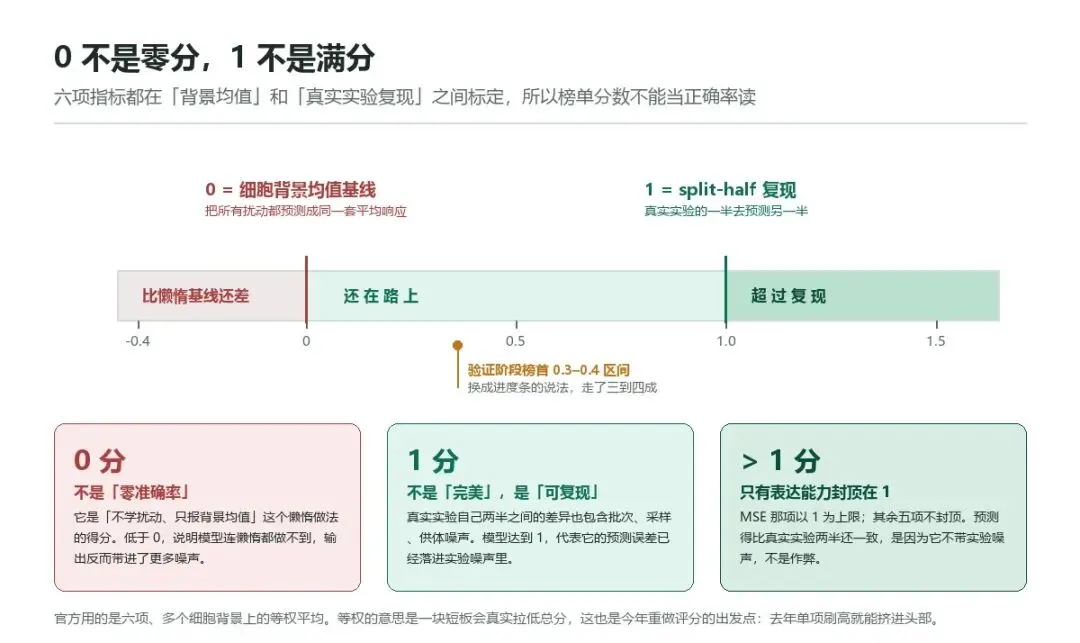
比指标本身更值得讲的是标定方式。今年每项指标都在每个细胞背景内用两个锚点缩放。
图 2 | 双锚点标定:0 是懒惰基线,1 是实验复现水平(本号自绘)
0 分对应细胞背景均值基线:不学任何扰动,对所有输入都输出同一套平均响应。听起来荒唐,但这个基线非常难缠,很多模型在部分指标上就是跑不过它。低于 0,说明输出比「无脑平均」还糟。
1 分对应 split-half 复现:把真实实验的细胞随机分两半,一半对另一半的相关水平。这是实验自身噪声的天花板。模型达到 1,代表预测误差已经落进实验噪声里。
推论有两个。表达准确度那一项封顶在 1,其余五项不封顶,因为预测得比实验两半还一致是可能的:它不带批次效应和采样噪声。负分则是常态,尤其对没调好的模型。
所以 0.42 的正确读法是:从懒惰基线出发,朝「实验可复现」的水平走了四成多。是进度,不是正确率。
04 一个指标是怎么被打穿的
为什么今年要把评分体系重做一遍?因为去年出过事。
2025 年首届用的是三项指标:DES(差异基因匹配)、PDS(扰动区分)、MAE(整体误差)。跑到中途,MAE 先失效:头部队伍的 MAE 全都超过固定锚点,按归一化规则这一项贡献为零,六项变成两项。
于是排名实际由 DES 和 PDS 决定,大家集中刷这两项。组委会中途补规则,临时增设用更多指标评定的通用奖,最后被 Altos Labs 的流匹配生成模型拿走。
首届复盘里最诚实的一句是主办方自己写的:扰动预测模型尚未在所有指标上稳定超过朴素基线。有队伍证明,一个在伪 bulk 数据上训练的简单回归模型,就能排到十五名左右。
所以今年改成六项互补指标、多细胞背景等权平均,评分工具 cell-eval2 由 Arc 和英伟达合作开发并开源。刷单项这条路,今年走不通了。
闲聊点评:这段历史值得所有做 benchmark 的人记住:指标不是中立的尺子,是被优化的对象。Goodhart 定律在细胞建模上一样灵,一项指标一旦成为目标,就不再是好的度量。
05 怎么正确引用一个分数
落到你自己写文章、审稿、看榜的时刻,三条纪律。
第一,分数必须带三个标签:哪个阶段、哪天的快照、提交了多少次。验证榜是实时的,每天都在动;最终测试又是另一套细胞系,独立评分、互不可比。看到 0.36 和 0.42 并存,不一定是有人写错,多半不是同一天、同一阶段的数。
第二,别拿总分给模型排名。总分是六项等权平均,一个 0.5 加一个负 0.1,跟两个 0.2 平均出来可能差不多,但这两个模型一个有戏、一个有病。要看就拉出六项分布。
第三,自己复现时方法学照抄官方口径:用 cell-eval2 全套六项,报每项分数,报基线(至少带背景均值基线),写明距离定义和 DE 阈值。只报一个总分的工作,审稿人现在应该直接要求补。
06 六项指标是一张诊断单
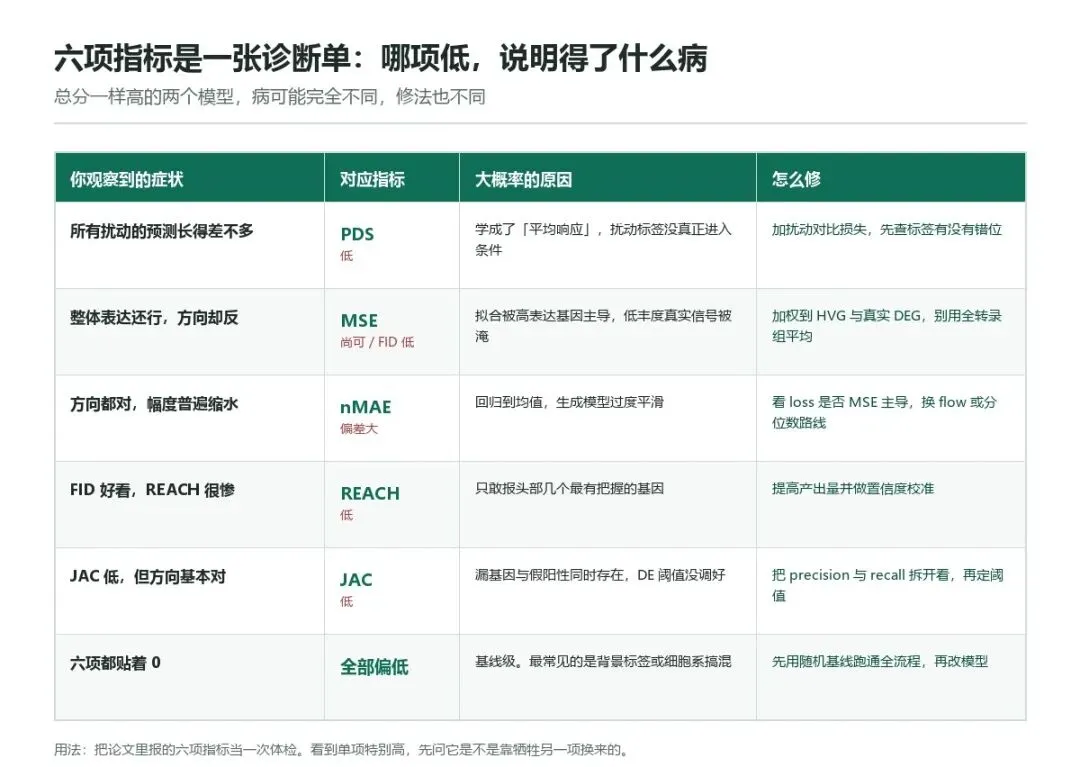
这套指标反过来用,价值更大:读别人的论文,或者诊断自己的模型,看哪项低就知道病在哪。
图 3 | 六指标诊断表:哪项低,说明什么病,怎么修(本号自绘)
举两个最常见的组合。MSE 尚可但 FID 低:模型拟合被高表达基因主导,真实信号淹在背景里,修法是把权重挪到高变基因和真实差异基因上。FID 好看但 REACH 惨:模型只敢报头部几个基因,方向正确率是靠少报换来的。
还有一条应急经验:六项全贴着 0,先别改模型。最常见的原因不是模型弱,是背景标签或细胞系搞混了,评分根本没在正确的目标上跑。官方文档专门提醒过这个坑,先用随机基线把流程走通。
07 这套指标测不到什么
最后泼一盆冷水。六项指标全围绕表达均值、差异表达和扰动区分打转,有几件事它们管不着。
细胞群体内部的异质性,指标算在 pseudobulk 层面,模型把一群细胞预测成整齐的一团,分数照样好看。跨供体、跨平台、跨实验室的泛化,今年六个细胞系都是同一套协议产出的。批次效应要是混进了训练集和测试集之间,模型可能学到的是技术差异,指标分不出来。
所以官方的原话值得再读一遍:排行榜分数更适合当一套有结构的诊断工具,别给模型贴「准确」或「不准确」的标签。真正可靠的虚拟细胞,要在受控基准里拿分,也要在新的生物学背景和独立实验里扛得住。
回到开头那个问题。0.42 不是 42% 的准确率,是从「懒惰基线」往「实验可复现」走了四成的进度条。前三成靠把扰动认对,最难的是后六成:把量级、方向、基因集合全都对上实验。这个领域真正的比分牌,还是实验室里长出来的那批数据。
我是源序康生物,做多组学测序与生信分析(转录组 / 单细胞 / 空间组学 / 蛋白组),也代理汉信生物 LNP 转染试剂盒做基因扰动实验。如果你在挑模型、读榜单,或者想先在自己细胞上攒一批小规模 Perturb-seq 数据,后台聊聊。
本文为科普内容。指标定义与赛事信息引自 Virtual Cell Challenge 官方(virtualcellchallenge.org)、Cell 2026 官方公告、Arc Institute 2025 年度总结与 cell-eval2 开源仓库,2025 年规则调整与获奖信息来自官方复盘及公开报道,具体规则与数值以官方页面为准。文中配图为本号自绘,图 2 中榜首区间为赛程快照参考,非最终成绩。本文不构成任何投资或医疗建议,转载请注明。