我给检索加了个 docId 过滤,topK 设 5,返回只有 1 条。不是过滤条件写错了,是这个库先检索后过滤——topK 那 5 条里,本来就只有 1 条属于这份文档。
一五个维度,先列清楚再选
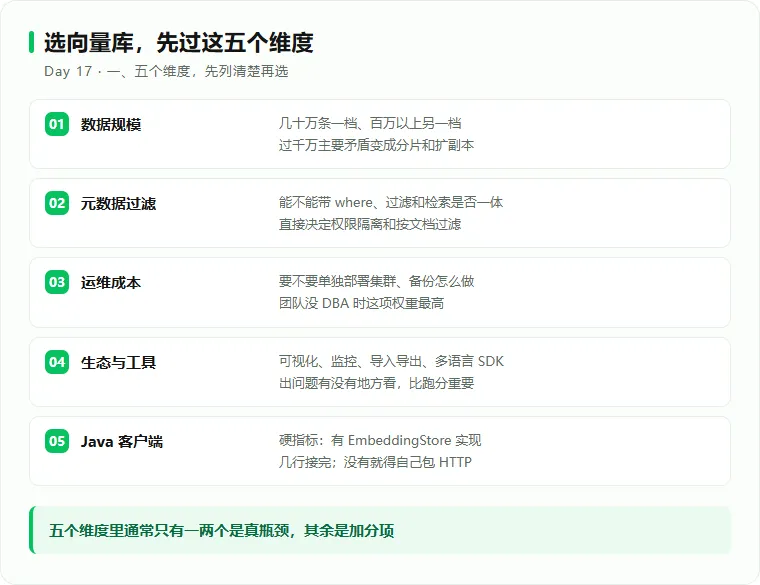
选向量库最怕上来就问“哪个强”。先把自己的约束摆出来,五个维度一个个过:
数据规模。几十万条以内是一档,百万以上是另一档。过了千万,索引怎么分片、怎么扩副本就变成主要矛盾,功能反而是次要的。
元数据过滤能力。能不能带 where 条件、过滤和检索是不是一体、支持哪些操作符。这一项直接决定你能不能做权限隔离和按文档过滤。
运维成本。要不要单独部署集群、有没有 Helm、备份怎么做、出事有没有人懂。团队没 DBA 时这项权重最高。
生态与工具。可视化、监控、导入导出、多语言 SDK 齐不齐。出问题有没有地方看,比跑分重要。
Java 客户端成熟度。这条是硬指标。LangChain4j 有 EmbeddingStore 实现的,几行代码接完;没有的,得自己包 HTTP,还要处理重试、超时、批量。
五个维度里,通常只有一两个是真正的瓶颈。剩下的是加分项,不是决策项。
二Milvus 和 PgVector 的分界线
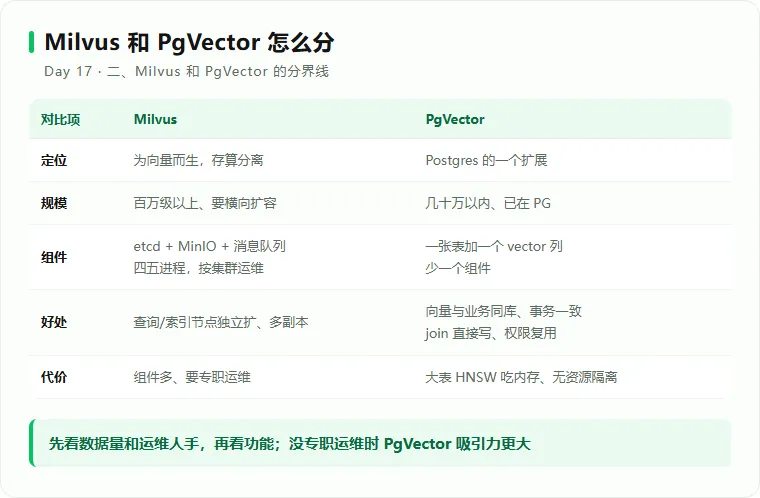
Milvus 是为向量而生的。存算分离,collection / partition / segment 分层,索引可选 HNSW、IVF、DiskANN,查询节点和索引节点能独立扩。百万级以上、要多副本、要横向扩容,选它没错。
代价是组件多。etcd 存元数据、MinIO 存索引文件、消息队列做写入缓冲,一套四五个进程。单机 docker-compose 能验证,但生产要按集群运维。
PgVector 是 Postgres 的一个扩展。一张表加一个 vector 列,建一个 HNSW 或 IVFFlat 索引,就完事了。已经在 Postgres 上、数据量几十万以内、不想再多一个组件,选它。好处实在:向量和业务数据同库,事务一致,join 直接写,备份沿用现有方案,权限复用行级安全。
代价也要认:HNSW 索引在大表上吃内存,写入会放大;并发一高,它和业务查询抢同一份资源。它不是不能扛,是没有隔离。
我的判断口径:先看数据量和运维人手,再看功能。团队没有专职运维,PgVector 的吸引力远大于 Milvus——少一个组件,就少一类半夜告警。
var store = PgVectorEmbeddingStore.builder() .host("10.0.0.12").port(5432) .database("knowledge") .user("app").password(pwd) .table("pdf_chunk_vec") .dimension(1024) .createTable(true) .build();
注意 dimension 必须和模型输出对齐,改模型就得改这一行并重建表,否则插入直接报维度不匹配。
三HNSW 到底在做什么
HNSW 的全名是分层可导航小世界图。拆成三层理解:
分层
。整个索引是一叠图,最上层节点最少、边最长,用来快速跳到目标区域;越往下节点越密,最底层包含全部节点,用来精确找邻居。查询从最上层的入口点开始,贪心地走向当前最近的邻居,走不动了就下沉一层,继续贪心,直到第 0 层。
这个结构和跳表一个思路:上层给对数级跳转,底层给精度。所以它不需要聚类、不需要训练,插入即生效,实时增删天然支持。
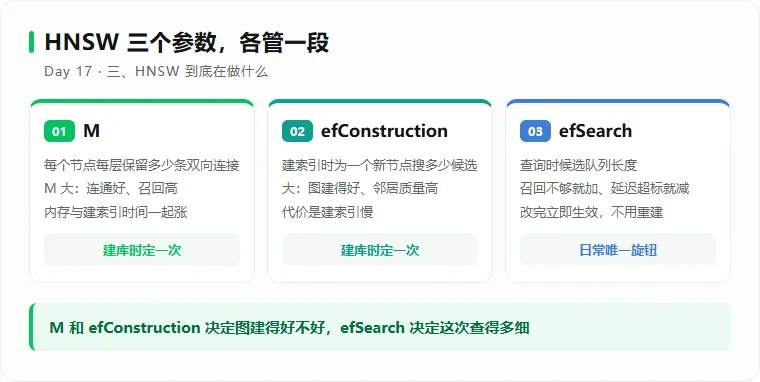
M
。每个节点在每层保留多少条双向连接。M 大,图的连通性好,绕远路的情况少,召回高;代价是内存占用和建索引时间一起涨。
efConstruction
。建索引时,为一个新节点搜多少个候选邻居。大,选出来的邻居质量高,图建得好,但建索引慢。
还有一个运行时的 efSearch,查询时候选队列的长度。它才是日常调优最该动的旋钮——召回不够就加,延迟超标就减,改完立即生效,不用重建索引。
一句话记住分工:M 和 efConstruction 决定图建得好不好,efSearch 决定这次查得多细。
面试常追问为什么不用 IVF:IVF 要先聚类、要先训练,数据分布变了得重训,增量插入还得处理归属漂移。HNSW 插入即生效,代价是内存吃得多、删多了会留空洞。
四元数据过滤是性能陷阱
开头那个坑,根源是过滤和检索的先后顺序:
先检索后过滤
。先 ANN 取 topK,再按条件筛。实现最简单,也是很多老版本的默认行为。topK 是 10,过滤完可能剩 0 条,只能把 topK 放大到 50、100 去兜,延迟涨,召回还不稳。
先过滤再检索
。先用 where 把候选集缩小,再在子集上做 ANN。快,但如果筛完只剩几百条,图结构被切碎,邻居关系失真,效果打折。选择性高的字段(比如 docId,每个值下面几万条)适合这种。
单阶段过滤
。把过滤条件下推进图遍历过程,边走边判。效果好,但依赖库的实现,不是所有版本都支持。
工程上的做法是四步:先查文档确认这个库默认走哪种策略;再按字段选择性分类,高选择性的走前置过滤,低选择性的(比如状态只有两个值)直接后过滤;然后给 topK 留冗余,5 要 50,用延迟换召回;最后必须实测——同一条 query,开过滤和关过滤各跑一遍,看召回和 P99 的差。
不要凭直觉判断哪个快。不同库、不同版本、不同字段分布,结论完全相反。
五面试速记
百万级以上、要独立扩缩容选 Milvus;已在 Postgres、几十万条以内、想少一个组件选 PgVector,先看规模和运维人手再看功能。
分层图,上层稀疏负责快速跳转、底层稠密负责精确搜索,从顶层贪心下降到底层;M 控连接数、efConstruction 控建索引广度,都是越大越准越慢。
这个不能报数,它由维度、M、efSearch 和机器规格共同决定——正确答法是说明 efSearch 是召回与延迟的直接旋钮,必须压测取值。
先检索后过滤可能筛完不剩几条导致召回暴跌,先过滤再检索又可能切碎图结构,策略因库而异,必须按字段选择性实测。
用固定评测集扫 efSearch,画召回与延迟的曲线取拐点;M 和 efConstruction 建库时定一次,efSearch 留到运行时调。
六Java 存量映射
选向量库就是选存储引擎,和当年纠结 MySQL 还是 MongoDB 是同一道题:先看数据量,再看团队会不会运维,最后才看特性表。HNSW 相当于给向量建的 B+ 树,只不过它不保证精确,用召回率换延迟。元数据过滤就是 where 条件下推——能不能下推、下推在哪一层,直接决定执行计划好坏。
七一句话带走
向量库没有最好的,只有和你当前数据量、运维人手最匹配的那个。
明日预告:纯向量检索一定漏召回,明天说为什么必须上混合检索。
AI 应用开发面试
关注公众号「种子AI编程学习」,查看完整 30 天合集与配套代码。