前两年测试组最常碰到的情况是这样的:产品把一个「智能助手」接进了下单或客服流程,提测单上写着「走一遍主流程」。测试打开对话框,问两句,回复通顺,接口也没有 500,于是按通过处理。过了一周,线上出现用户看到「已下单成功」,后台却没有订单。
回头看日志,问题并不在传统接口回归漏了某条用例,而在于那一段由模型参与的行为,没有被当成真正的被测对象:它可能编造了结果,可能调错了工具,也可能中途失败后仍标记「已完成」。
这就是 AI 评测要接住的工作。它不是只测 Agent,也不是去做模型训练。它测的是系统里「由模型参与决策或生成」的那一段行为:输出是否符合约定,过程是否可复查,同一版本下是否可复现,改动之后是否可回归。
交付物和传统测试是对齐的。评测题相当于用例,评分规则相当于断言,一次运行记录相当于执行结果,失败聚类和回归题相当于缺陷与回归用例。放行结论仍由人依据证据做出。模型、提示词、知识库、工具接口都只是被测对象或依赖,不是评测本身。
一、先分清评测对象
项目里常见至少五类,经常同时存在,不能共用一套断言。
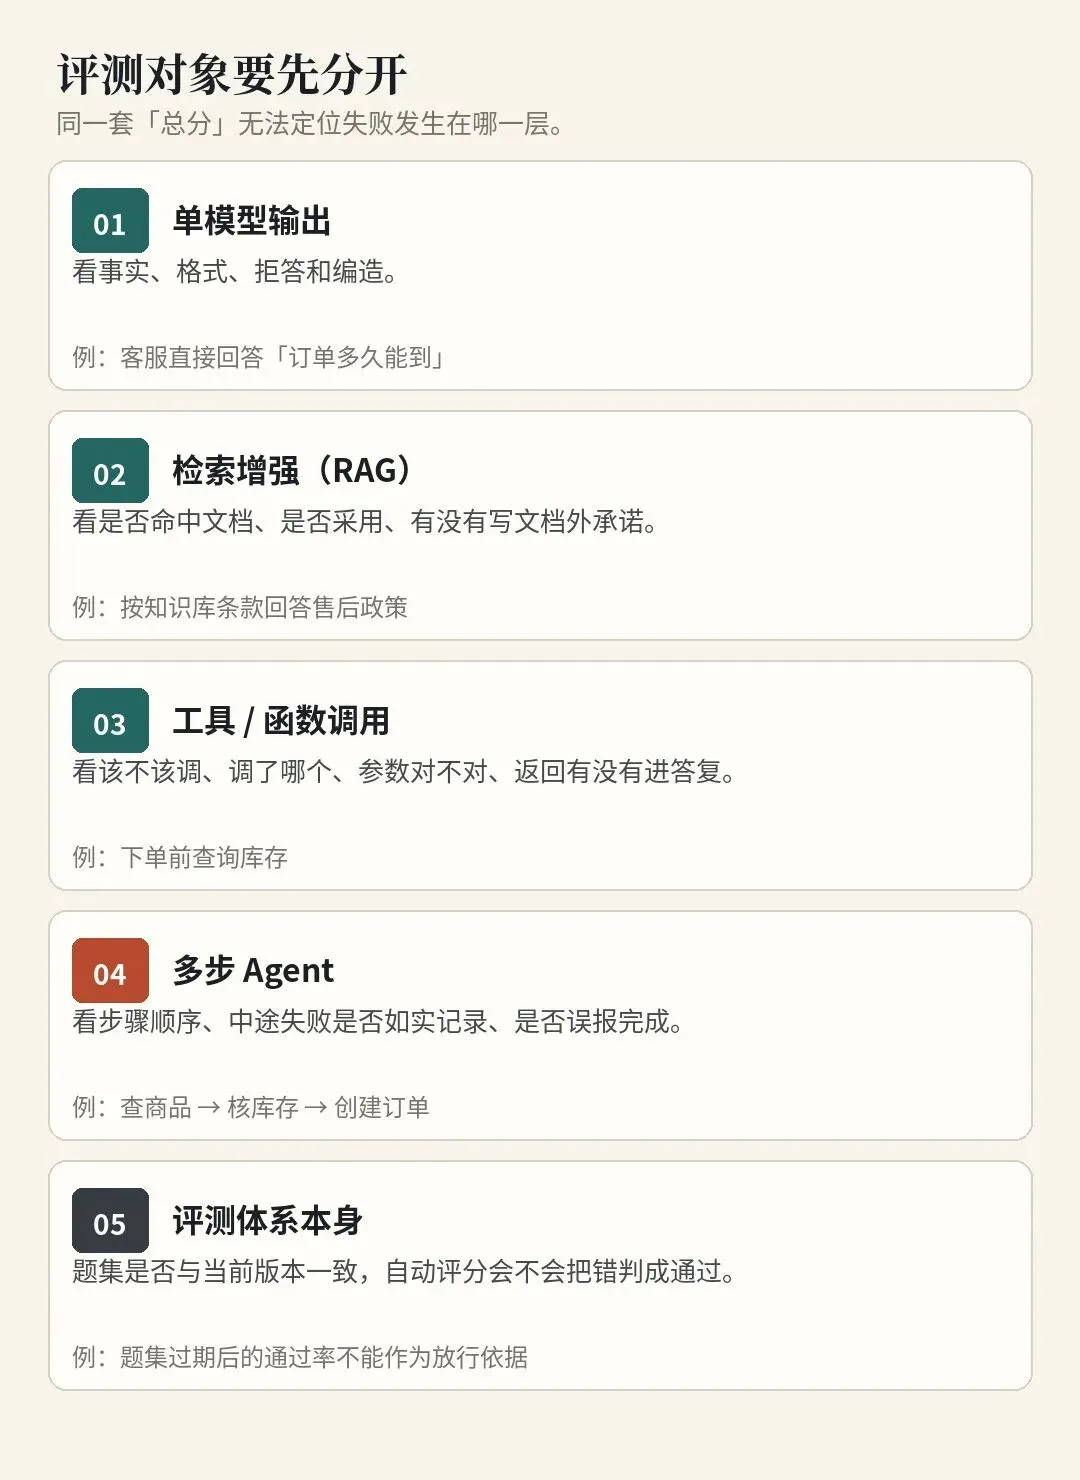
单模型输出。 例如客服直接回答「订单多久能到」,或助手根据需求草稿生成用例。主要看事实是否正确、格式是否可解析、该拒答时有没有拒、有没有编造不存在的规则。
检索增强(RAG)。 例如必须依据知识库或文档回答售后政策。除了看回答本身,还要看检索有没有命中该条款、回答有没有采用检索结果、有没有写出文档里没有的承诺。文档里写「七天无理由,已激活不支持」,模型却答复「都可以退」,这类失败在对话上看着很流畅,按传统功能测试也未必能抓住。
工具或函数调用。 例如下单前查询库存。要看该不该调、调了哪个接口、参数是否正确、接口返回有没有进入最终答复。只看最后一句「有货」不够。库存接口返回无货,对用户却说可以发货,问题出在调用结果没有被采用,而不是页面按钮坏了。
多步 Agent。 例如「下单」包含查商品、核库存、创建订单、回写单号。除了单次调用是否正确,还要看步骤顺序、中途失败有没有如实记录、是否在未完成时标记「已完成」。开篇那个「成功了但没有订单」的现场,多半要在这一层查。
评测体系本身。 题集是否与当前版本一致、自动评分是否把错误判成通过、人工抽检是否稳定。题集过期后得出的通过率,不能作为放行依据。
一个「智能下单助手」里,对用户的自然语言回复、查库存的工具调用、多步创建订单,需要分开设计题目和断言。
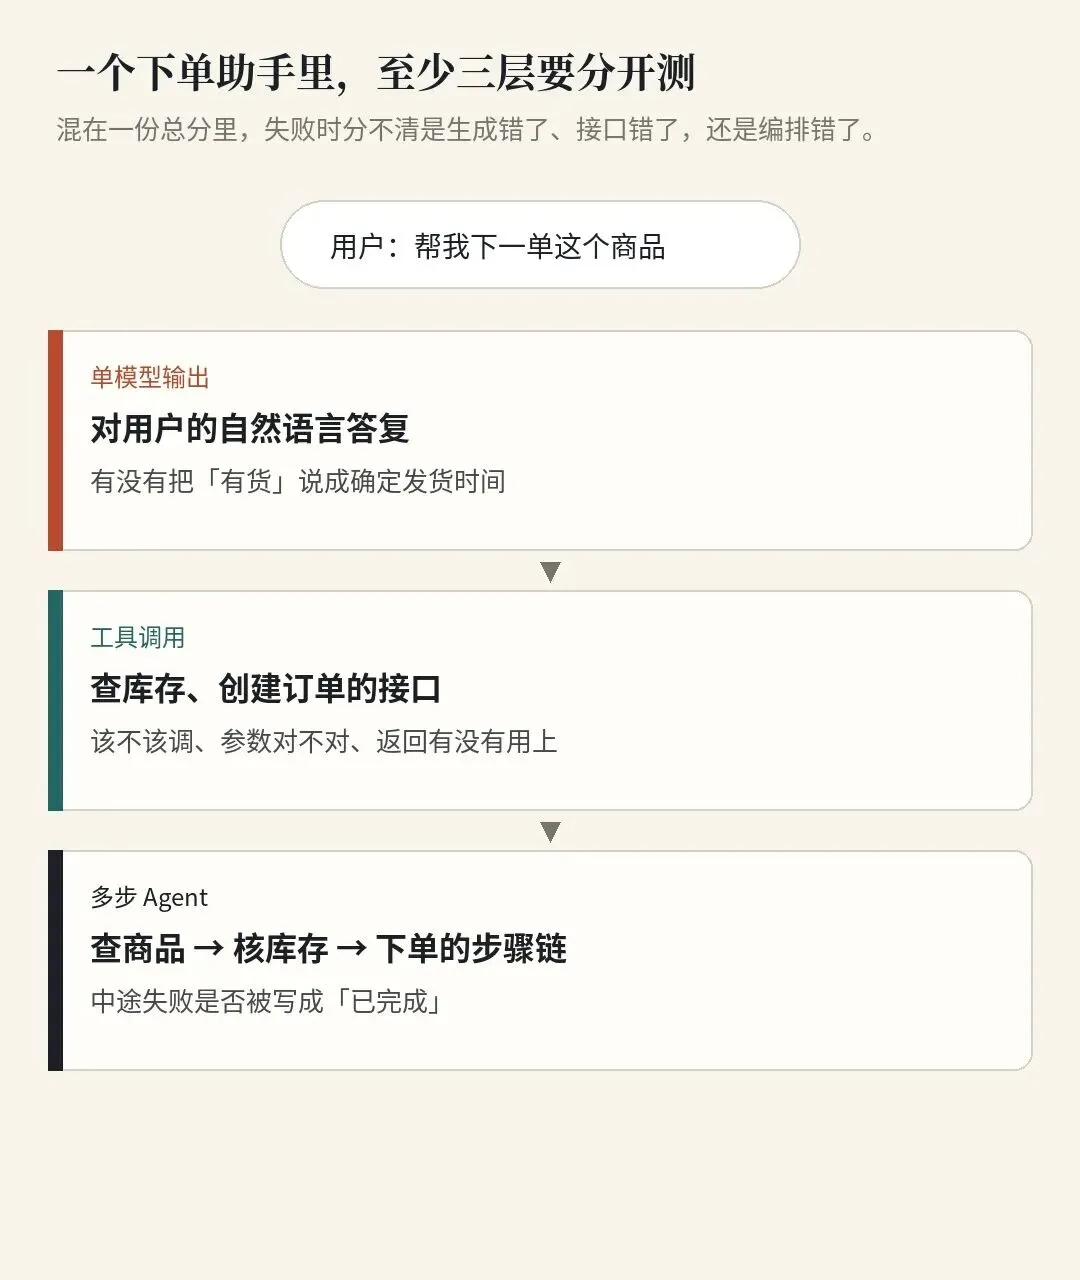
混在一起只打一个总分,失败时定位不到是生成错了、接口错了,还是编排错了。后面几篇会按对象分别写怎么建题和怎么判,这里先把边界划清。
二、测试经验往哪迁
测试工程师做这件事,用的仍是设计用例、写断言、管回归、控制放行的方法,改的是对象和观察点。
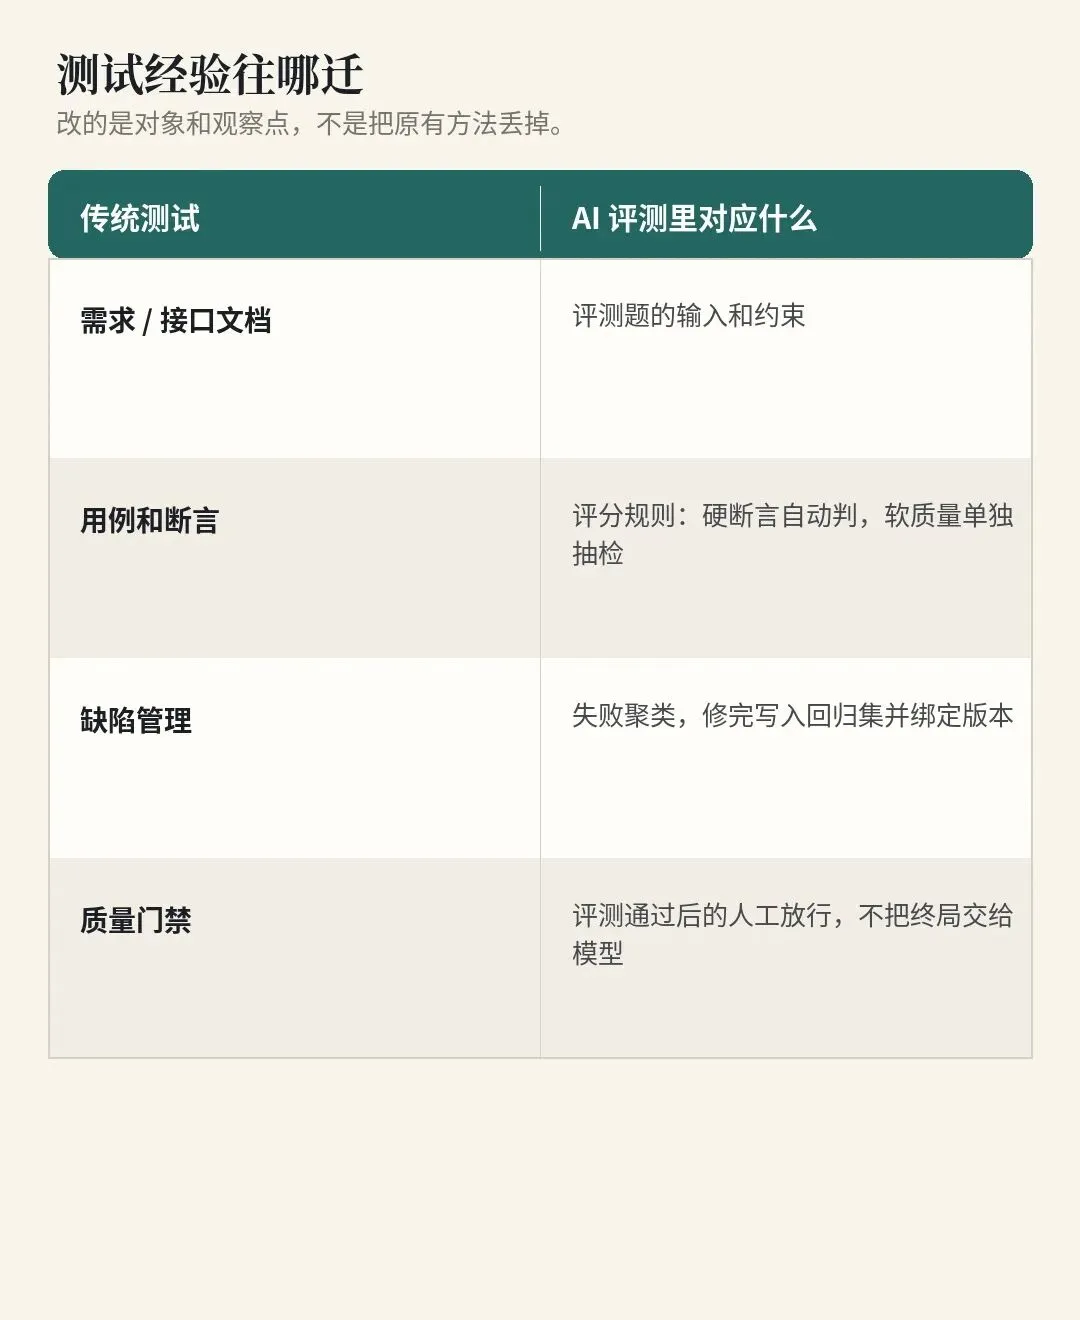
需求与接口文档,对应评测题的输入和约束。以前根据验收标准写步骤和期望;现在根据产品约定、接口契约、知识库条文写输入、上下文和期望。
用例与断言,对应评分规则。能自动判定的写成硬断言,例如是否调用指定接口、返回码、是否包含订单号、是否出现禁止承诺。难以唯一打分的,例如表述是否完整,单独做抽样细则,不和硬断言混成一个「总体感觉分」。
缺陷管理,对应失败聚类和回归集。一条失败要归到类型:事实错误、漏检文档、工具参数错误、误报完成等。同一类型要能复现,修完后写成回归题,绑定模型、提示词、知识库和工具版本。修了但没入库的问题,下次升级仍会漏。
质量门禁,对应评测通过后的人工放行。上线、加严级别的结论、需求范围是否变化,不交给模型自行判定。这和「产出未经评审不得进入正式交付」是同一条工作纪律。
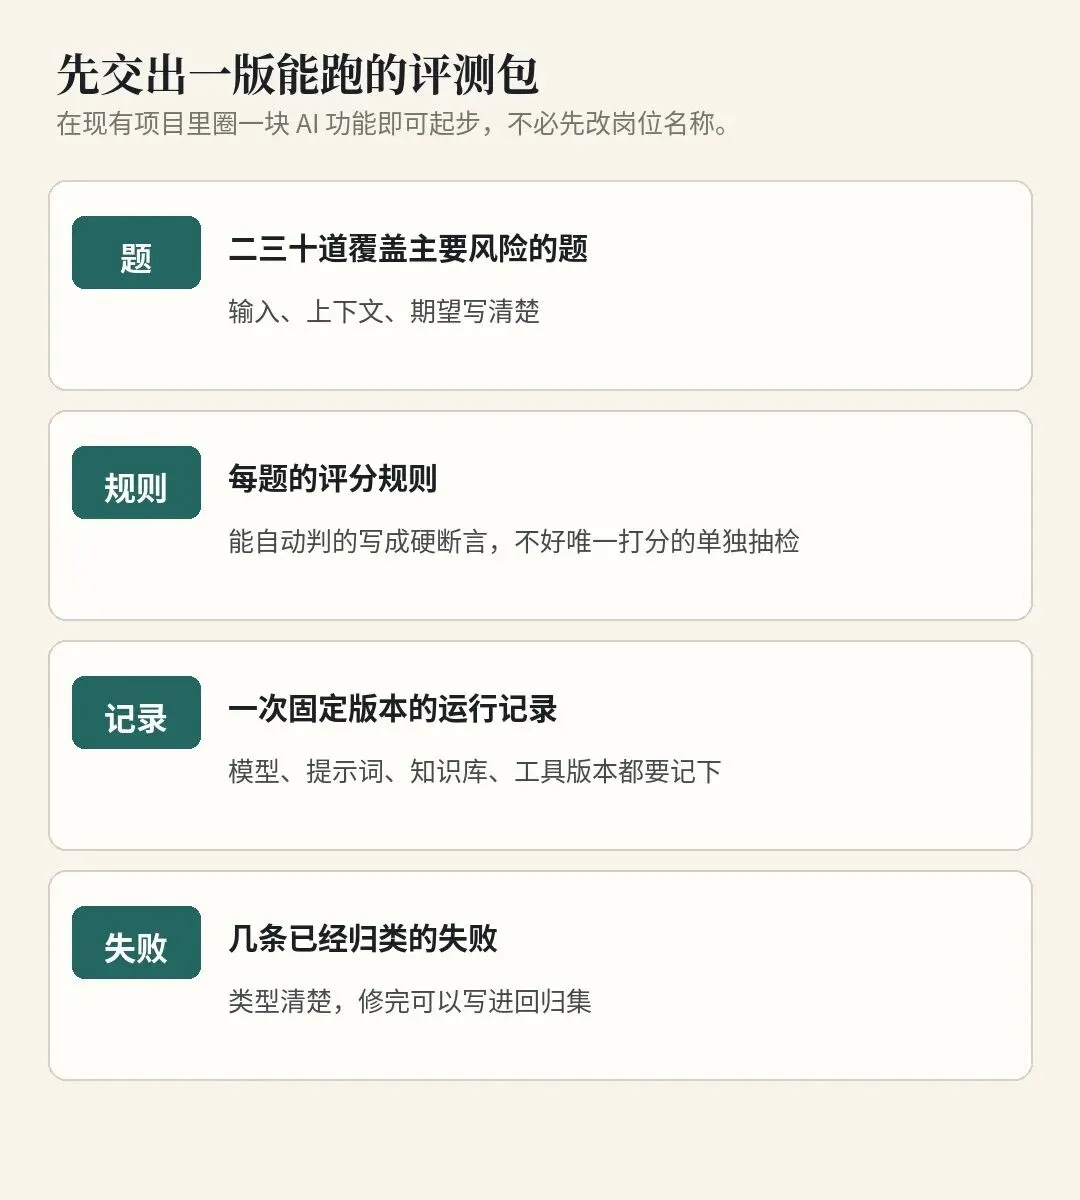
起步不必等岗位名称变更。在现有项目里圈一块已上线或即将上线的 AI 功能,先交出一版可运行的评测包:二三十道覆盖主要风险的题、每题的期望和评分规则、一次固定版本的运行记录、几条已归类的失败。有了这包,后面才谈扩集和建门禁。
三、工作落在哪几类机会上
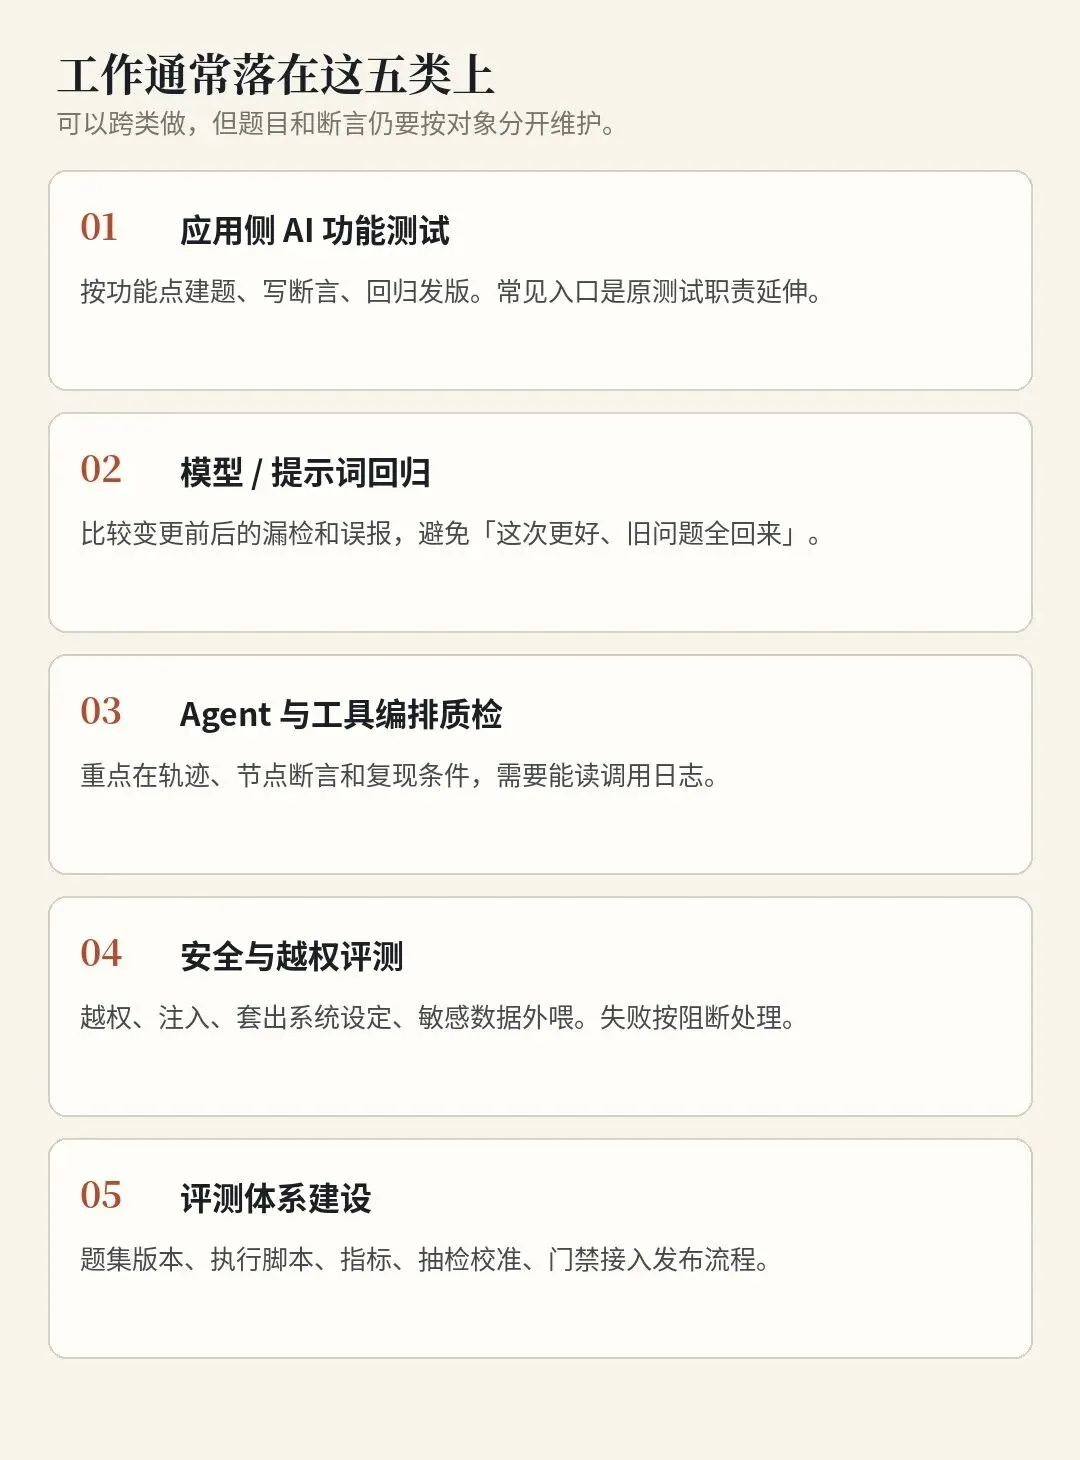
应用侧 AI 功能测试。 业务系统里已经接入问答、摘要、导购、工单分类等。工作是按功能点建题、写断言、回归发版。进入方式通常是原测试职责延伸,先把本模块的 AI 出口测住。
模型或提示词回归。 提示词、模型版本、解码参数常变。工作是维护回归集,比较变更前后的漏检和误报,阻止「这一次看起来更好、旧问题全回来」的发布。适合已经有稳定题集的团队。
Agent 与工具编排质检。 链路含多步调用和状态。工作重点在轨迹、节点断言和复现条件,处理中断却报成功、路径不稳定这类问题。需要能读调用日志,不需要先做训练。
安全与越权评测。 越权查询、提示词注入、套出系统设定、对外部模型喂入敏感数据。这类失败按阻断处理,不按「体验不好」扣分。测试对权限和数据分级更熟,这块容易接手。
评测体系建设。 题集版本、执行脚本、指标统计、抽检校准、门禁接入发布流程。当题量上来、多人同时改提示词时,没有这套体系,两次运行的结论会对不上。
同一人可以跨这几类,但题目、断言和门禁仍要按对象分开维护,不要做成一份「通用评分表」打天下。
四、开场就会卡住的几个问题
对象没分开。一份报告里只给总分,失败无法归属。处理是先画对象清单,再为每类规定必查项;总分只作汇总,不作定位依据。
用「对话一下感觉还行」代替执行。无法回归,也无法比较两次发版。处理是从第一周就留下运行记录:版本、题号、通过或失败、失败类型。
把评测理解成「会写提示词」或「会训模型」。提示词和模型是被测或被调对象。评测要解决的是题怎么写、对错怎么判、改动后怎么回归、什么情况下不能发版。
下一篇,按对象定风险、按步骤建集,用具体题目和失败单写怎么做。
