✦做题四成,教书八成:这篇论文给决策模型换了个岗位✦
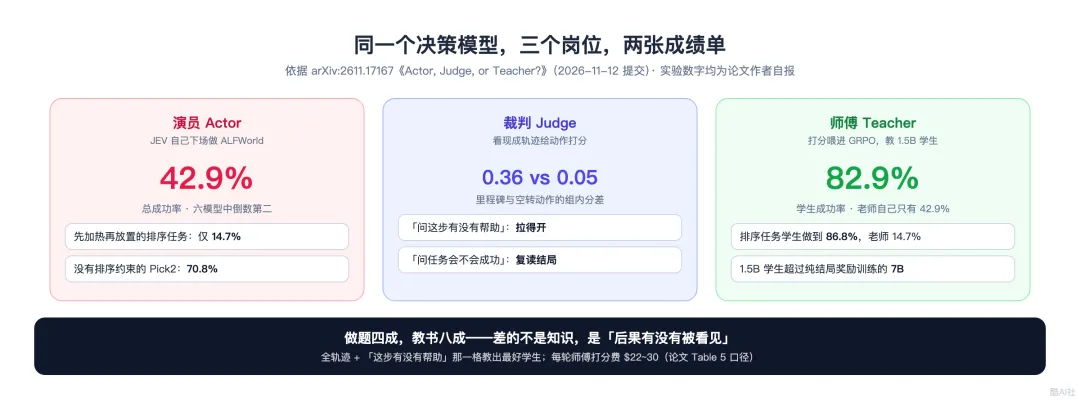
TypeSafe 的决策模型 JEV 在 ALFWorld 上做成 42.9% 的任务。ALFWorld 是个家务文字环境,agent 要靠 go to、take、heat 这类指令完成「把一个加热过的杯子放到柜子上」这样的目标。在论文把六个模型摆上同一张考台的演员岗位后,JEV 排倒数第二,垫底的是拿提示词问同样问题的 GPT-6 Luna,34.3%。
故事讲到这,就又是一篇「快而便宜的小模型在长程任务上不行」,连标题都起不出花样。浙大一个与百度合作的团队(arXiv 2611.17167,11 月 12 日提交,通讯作者 Shen Yongliang,前三位作者并列一作)把同一个 JEV 请去坐了另外两个位子:看现成轨迹打分的裁判,和把打分喂进强化学习当训练信号的师傅。坐师傅位子的那个 JEV,教出来的 1.5B 学生在同一个环境里做成 82.9%,接近它自己下场表演那 42.9% 的两倍。
同一个模型、同一份参数,换个岗位,分数换了一倍。论文真正在问的其实是一句话:过去只用「演得好不好」这一把尺子量决策模型,而这把尺子只覆盖三个格子中的一个。
一个模型三个岗位,问法和可见范围各两档
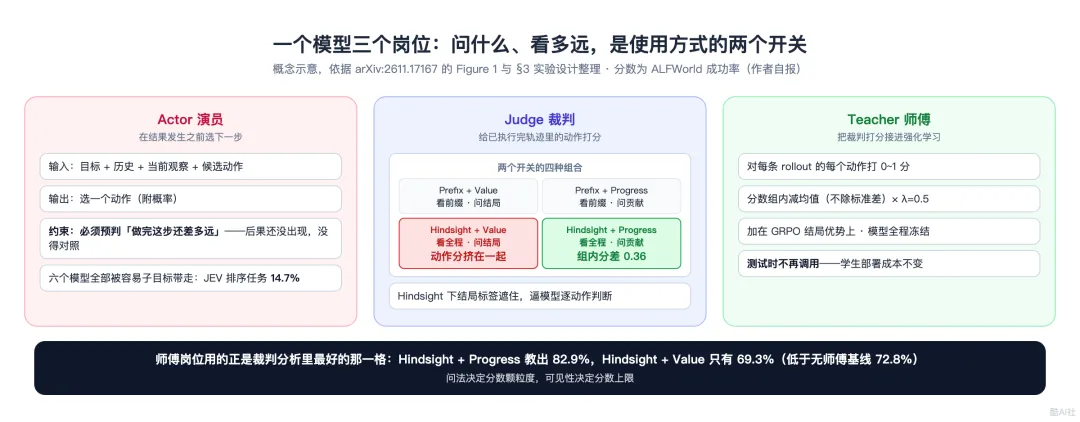
先把「决策模型」说清楚。论文的定义:输入是一个问题加一段上下文,输出是带类型的——选择题返回选中的选项和每个选项的概率,判断题返回一个 0 到 1 的分数,不生成自由文本。JEV、Perplexity 的 Decider v1.2、OpenAI 的 GPT Decisions 都按专用决策模型入场;把同样的问题用 JSON 提示词或者首 token 概率读出法丢给通用大模型(Qwen3.8-27B 和 GPT-6 Luna 各算两种,Luna 只测提示词一路),凑成六个被测模型。Decider v1.2 权重公开、从 Qwen3.8-27B 全量微调而来;JEV 和 GPT Decisions 闭源,连底座怎么改的都未披露。
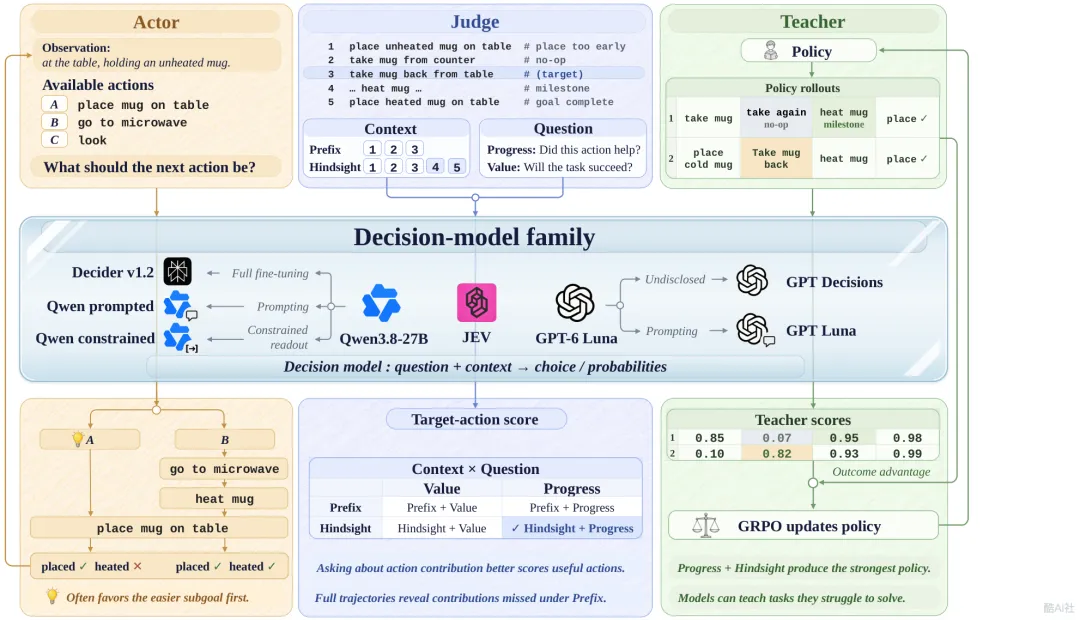
三个岗位是同一个模型的三种用法。演员:给目标、历史、当前观察和候选动作,选下一步,这是它一直被考的那一格。裁判:给一条已执行完的轨迹里某个动作打分,这里有两个开关——可见范围是只到该动作为止的前缀(Prefix),还是整条轨迹(Hindsight,结局标签遮住);问题是「执行这个动作之后任务成功的概率有多大」(Value),还是「这个动作对完成目标有没有实质贡献」(Progress)。两两组合四格。师傅:把裁判那套打分用在正在训练的策略的 rollout 上,分数组内中心化之后加进 GRPO 的优势项,师傅全程冻结,测试时不再调用。
代码仓里能直接读到裁判的问题模板原文。Progress 的正文一共三句,后两句是为打分划的边界:「后来的失败不抹掉先前的有效推进,后来的成功也不把绕过的弯路说成有效。」这两行后来被证明是整个实验的承重点。
演员岗位:六个模型全被「顺手一步」带走
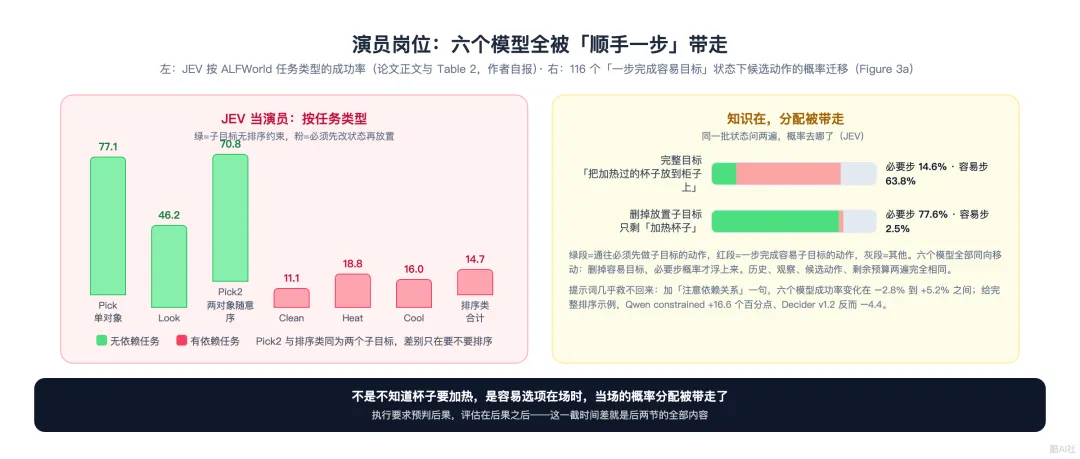
ALFWorld 的任务按两个子目标之间要不要排序,分成两组。「把两支铅笔放进抽屉」(Pick2),先后随意;「把杯子加热后放到柜子上」(Heat),必须先加热再放置(Clean 和 Cool 同构)。六个模型在两组之间的落差都是断崖。JEV 在没有排序约束的 Pick2 上做成 70.8%,在有排序约束的任务上只剩 14.7%;总榜最强的演员 Decider v1.2(全体 63.6%)在 Heat 一类上也只有 18.8%。
失败的形态很固定:agent 已经手里拿着杯子站在柜子边上,放下去就完成一个子目标,加热那个子目标还悬着——很多轨迹里它就是直接放了。
这是不知道,还是知道了也做不对?论文的区分办法是在这些「一步就能完成容易目标」的现场(66 个任务里的 116 个状态),同一个模型问两遍:第一遍用完整任务「把加热过的杯子放到柜子上」,第二遍删掉放置子目标、只留「加热杯子」。两遍的历史、观察、候选动作、剩余预算完全相同。JEV 在完整任务下把 63.8% 的概率给了「放杯子」这种容易步骤,给「加热」这条必要路线的只有 14.6%;把容易目标从问题里拿掉,同一状态的两边变成 2.5% 和 77.6%。六个模型全部同向移动。换句话说,它知道杯子必须加热,只是在目标里同时摆着容易选项的时候,当场的概率分配被带走了。
提示词层面几乎无解。在任务后面加一句「注意任务要求之间可能存在依赖」,六个模型的成功率变化在 −2.8% 到 +5.2% 之间。给一个完整的排序示例(杯子既没加热也没放置时应当先加热)就起伏大了:Qwen constrained 从 41.7% 到 58.3%,Qwen prompted 从 46.6% 到 58.6%,GPT Decisions 从 20.8% 到 32.1%,JEV 从 19.0% 到 24.1%,GPT Luna 几乎不动,Decider v1.2 从 89.7% 降到 85.3%。同一招有的模型吃、有的模型反弹,靠指令修不出一条稳定通道。
差别在时间点上。下场执行要求模型在后果出现之前预判「做完这一步,任务还差得远」;打分的时候,后果已经写在那儿了。后面两个岗位的所有结果,都从这一句长出来。
裁判岗位:问什么,决定分数的颗粒度
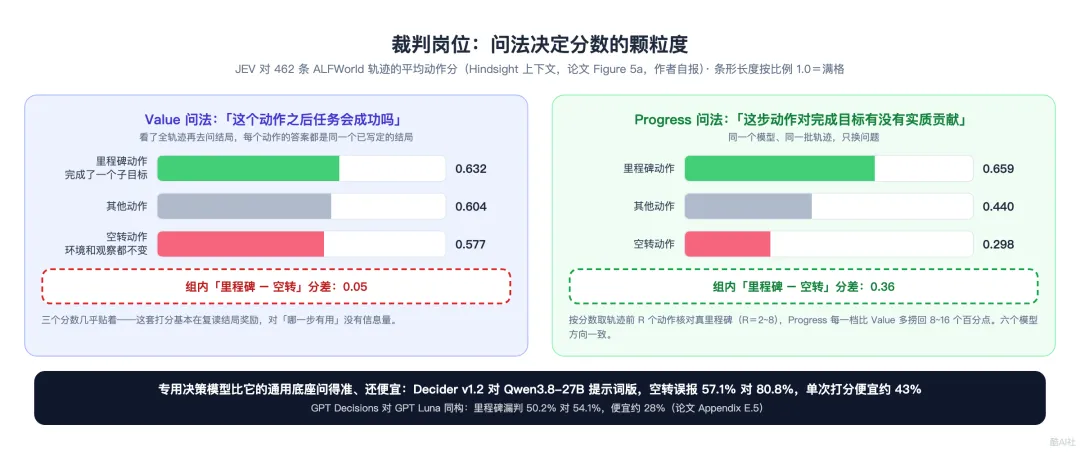
从演员岗位跑出 462 条轨迹(每条至少含一个「里程碑动作」——真正完成了一个子目标的步骤,和一个「空转动作」——环境和观察都不发生变化的步骤),同一个动作分别用两种问法打分。JEV 对三类动作的平均分:Value 问法下,里程碑、其他、空转是 0.632、0.604、0.577,几乎分不开;Progress 问法下变成 0.659、0.440、0.298。同一条轨迹里,里程碑减空转的分差,Progress 给到 0.36,Value 只有 0.05。六个模型方向一致。
Value 分不开不是模型笨。看完整条轨迹再去问「这个动作之后任务会不会成功」,每个动作的答案都是同一个——那个已经写定的结局。一个复刻了结局奖励的分数,对「哪一步有用」当然没有信息量。这不是细节,是问法本身把信号粒度定死了:问结局,得到结局的复读;问贡献,才得到贡献的排序。按分数取每条轨迹的前 R 个动作看命中多少真里程碑(R 从 2 到 8),Progress 每一档都比 Value 多捞回 8 到 16 个百分点。
另一组配对比较回答了「专门微调一个决策模型值不值」:Decider v1.2 与它的底座 Qwen3.8-27B 用同一个问法,Decider 漏掉的里程碑动作少一些(36.5% 对 49.6%),把空转误判为有用的也更少(57.1% 对 80.8%),单次打分便宜约 43%;GPT Decisions 对 GPT Luna 同构,50.2% 对 54.1%、61.1% 对 78.4%,便宜约 28%。这是决策模型第一次在「不是自己下场做题」的岗位上拿到量化正分——按演员岗位排名,这两个专用模型都排不进前列。
裁判岗位再看一眼:看到多远,就值多少分
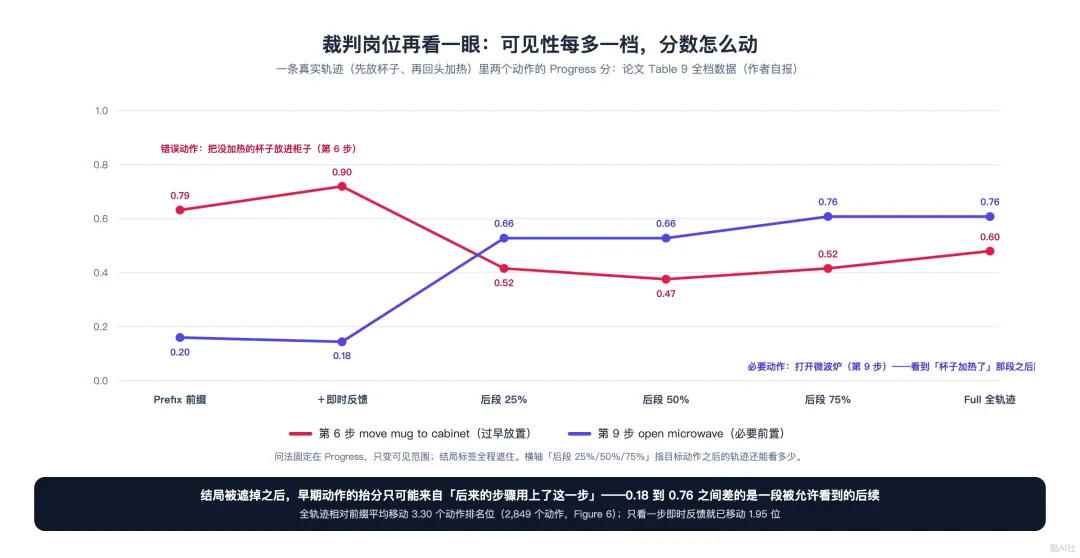
问法固定在 Progress,把可见范围从短到长逐档加回去,量同一批动作排名的移动量。167 条轨迹、2,849 个动作:只多给一步「执行后的即时反馈」,平均排名移动 1.95 位;给到整条轨迹,移动 3.30 位。
论文 Table 9 把这条漂移落在一条真实轨迹上——一个先放杯子再回头的任务里两个动作,六个档位从 Prefix 到 Full 的分数:
第 6 步就是演员岗位上那个经典错误,裁判在前缀下给了 0.79 的不低分;再给一步即时反馈(杯子确实进柜子了),涨到 0.90——一步「执行成功」的局部后果,在裁判那里会被读成好棋。后面每多揭示一段轨迹,它才往下掉。反方向是第 9 步「打开微波炉」:前缀只值 0.20,即时反馈后 0.18,等看到「杯子用微波炉加热了」那一段,跳到 0.66,全轨迹 0.76。同一步动作,0.18 和 0.76 之间的距离是一段被允许看多少的后续。
Progress 模板里那两句免责声明在这里承重:结局已经被遮掉了,把早期动作抬分的不是「任务最后成了」,而是「后来的步骤用上了这一步」。Value 问法下这个反转不存在——前面那 0.05 和 0.36 的差距就是它的影子。
到这里,演员岗位的 14.7% 和裁判岗位的眼明手快就不矛盾了。同一份知识,执行要在后果出现前预判,评估在后果出现后对照,差的只是时间线上那一截可见性。
师傅岗位:分数教出的学生,超过了老师的示范
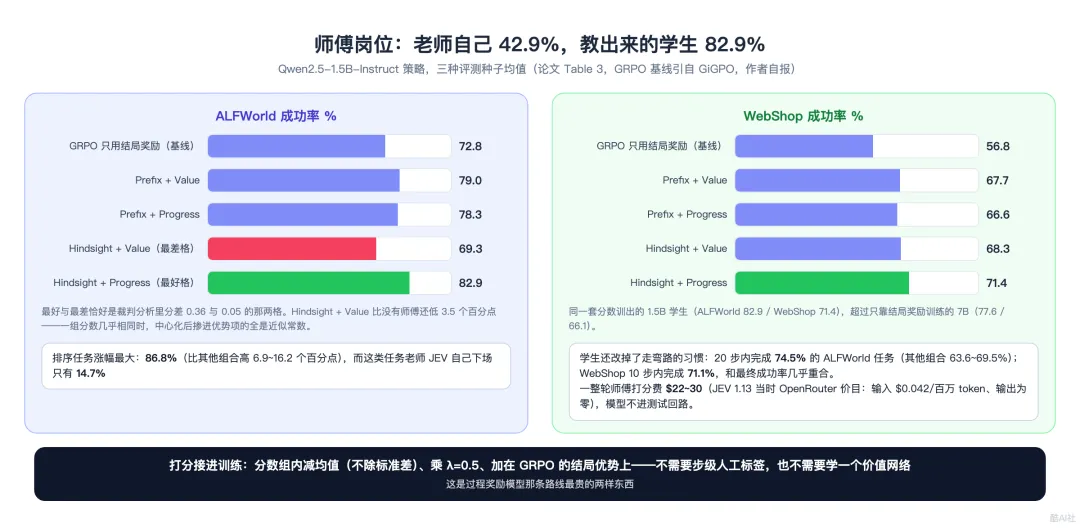
师傅岗位就是把裁判打分接进强化学习。Qwen2.5-1.5B-Instruct 当策略,每个任务采 8 条 rollout,跑完之后 JEV 给轨迹里每个已执行动作打一个 0~1 分;分数在同任务组内减去均值(注意:不除以标准差——一组分数全都差不多的时候,调整量就该接近零),乘 λ=0.5 加在 GRPO 的结果优势上。师傅冻结、不进测试回路,也不需要任何步级人工标签——这正是过程奖励模型那条路线最贵的东西。
结果矩阵(三种评测种子均值,GRPO 基线引自 GiGPO 论文的公开结果):
最好的一格,恰好是裁判分析里区分度最大的那一格(组内分差 0.36),最坏的一格恰好是分差 0.05 那一格。表里有三个数字值得单独说。
第一,Hindsight + Value 在 ALFWorld 上是 69.3,比什么都不加、纯用结局奖励的 72.8 还低。看了全轨迹但问错了问题,比没有师傅更糟——分数在组里几乎一个样,中心化之后给结果优势掺进去的全是近似常数。问法不是实施细节,它占机制的一半。
第二,涨幅集中在有排序约束的任务上:86.8%,比其他所有组合高 6.9 到 16.2 个百分点。老师 JEV 自己下场做这类任务只有 14.7%。学生涨得最狠的部分,正是老师演示最差的练习。同样用这套分数训练的 1.5B(ALFWorld 82.9 / WebShop 71.4),超过了只靠结局奖励训练的 7B(77.6 / 66.1)。
第三,师傅还改变了学生的动作分布:20 步之内完成 74.5% 的 ALFWorld 任务(其他组合 63.6~69.5%),WebShop 上 10 步内完成 71.1%、和它的最终成功率几乎重合。少走了那些「先放杯子再回头加热」的弯路。
成本账在论文 Table 5:150 个训练步、每步 16 个任务、每任务 8 条 rollout,JEV 1.13 按当时 OpenRouter 挂牌价输入 22 到 30(四个配置分别是 30.07/24.50/22.21/26.83)。这个价目是论文 11 月 12 日的记录,今天 OpenRouter 的在架表里已经没有可调用条目,引用时只能按论文口径。
管线本体,不用 GPU 也能过一遍
代码仓 ZJU-REAL/decision-agents 只有 42 颗星,一共 9 条提交:11 月 12 日晚(北京时间 22:01)Initial release,此后全是在补项目页和链接,11 月 14 日中午挂上论文榜地址。核心是 decision_model 这个 44 个文件、5,864 行的 Python 包,其余是从 verl-agent 继承的框架和 GiGPO 基线。
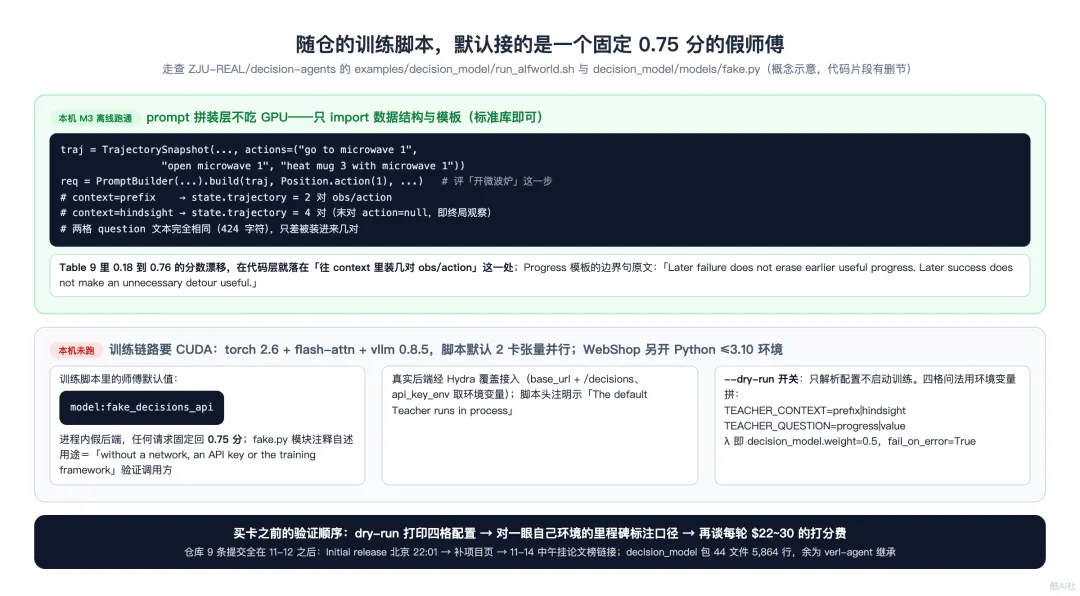
完整复现要 CUDA:README 写明 torch 2.6 加 flash-attn 加 vllm 0.8.5,WebShop 还得单开一个 Python 不高于 3.10 的环境,训练脚本默认两张卡做张量并行。这台 M3 没有 CUDA,训练链路没跑。
但 prompt 拼装那一段不吃 GPU。本机零依赖走查了一遍:拿仓库自己的数据结构造一条三步轨迹(走到微波炉、开微波炉、加热杯子),对「开微波炉」这一步分别拼 Prefix 和 Hindsight 的 Progress 请求——两格的 question 文本完全一致(424 个字符),差别只在 context 往里装了几对观察和动作:前缀给 2 对,全轨迹给 4 对,最后一对的 action 是 null(终局观察)。Table 9 里 0.18 到 0.76 的漂移,在代码层就落在这一步可见性上。
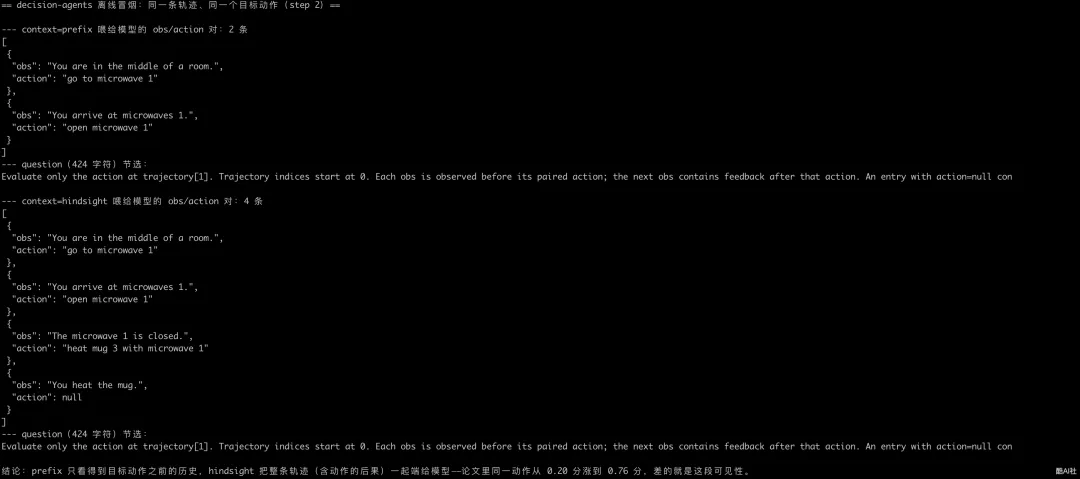
随仓的训练脚本里还藏着一个细节:默认师傅后端是 fake_decisions_api,一个进程内的模拟打分器,对任何请求固定回 0.75;脚本注释明写「默认师傅在进程内跑,真实后端通过配置覆盖」,另带一个 --dry-run 开关,只解析配置不训练。作者留下来的是一条协议层可以离线验证的管线:先确认四格问法和可见性真按论文那样拼进请求,再决定要不要为它配卡、配 key。这比「论文加代码」更进一步,是「论文加一份可以在自己机器上对账的接口」。
和十月那篇行为学诊断,各从一端钉住同一个位置
10 月中旬读过一篇讲决策模型失败诊断的论文(arXiv:2610.18579《Reading Right, Acting Wrong》),它的结论是:配对测量下,多数失败不在「读」这一层——状态描述读对了,动作照样错,错在执行侧。浙大这篇从相反方向补上了后半句:同一个模型,让它看到完整轨迹、问它对目标的贡献,它把当初做错的那步的功劳记对了(组内分差 0.36)。错的从来不是世界的模型,是「后果还没发生就得先下注」这个约束本身。两篇文章从两端量出的,是坐标轴上的同一个点:后果的时间。
对怎么衡量决策模型,这篇的直接含义写在它的第五条经验里:一个模型适不适合当师傅,应该先看它在现成轨迹上打分的质量,而不是看它下场表演的成绩。决策模型的排行榜从这一刻开始要拆成三行——演员排名、裁判排名、师傅排名——三行不必一致。JEV 按演员排名在这张考台上倒数第二,论文里师傅岗位最大的正分用的正是它。
接下来能做的四件事
手里有决策模型接口(GPT Decisions、Decider,或者国产开源复现路线)的话,第一件事不是接进 agent 选动作。拿手头现成的轨迹——哪怕线上系统已经跑完的日志——每个动作按两种问法各打一遍分:「任务会不会成功」和「这一步对目标有没有帮助」。然后看真正完成子目标的动作和环境观察都没变的动作之间,分数差有多大。差接近零,说明这个模型只会复读结局,接进训练也是 69.3 那一格;差明显拉开,才有资格当师傅。
第二件事,打分的时候把整条轨迹给它,把结局标签藏掉。前缀打分不是不能做,是在线过滤本来就该另说——论文自己把这点划进局限。第三件事,真要接进 RL,先跑一次 --dry-run,把四格配置拼出来的请求打出来看一眼,再对一遍自己环境里里程碑动作的标注口径,最后才谈那 22~30 美元一轮的打分费。第四件事,这套结论的边界也要一起带走:两个文本环境、每集不超过 30 步、JEV 和 GPT Decisions 闭源(哪些训练选择造就了好裁判,论文承认无从知道);文中所有数字都是作者自报,HF 论文榜 11 月 13 日收了 30 个赞,还没有第三方复现。我本机验证过它的管线怎么拼请求,没验证过它训练出来的分数。
要不要把这条师傅管线接进自己的训练,第一步不用买卡:clone 下来跑一次 dry-run,看看四格问法是怎么变成一个请求的,答案就能自己量了。
