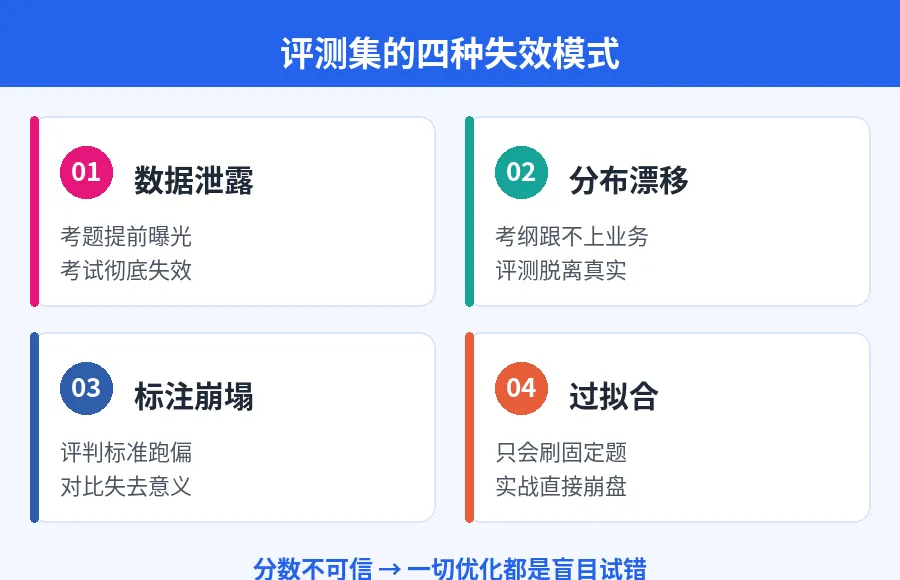
评测分数一路上涨,线上体验毫无改善,甚至越迭代越差,绝大多数团队第一反应是怪模型、怪检索、怪 Prompt。但行业真相是:90% 的无效迭代,问题不在模型,而在评测集已经悄悄失效。评测是 AI 研发迭代的唯一标尺,标尺歪了,所有优化都是盲目试错。
本文目录
01|数据泄露失效:考题泄密,考试彻底失效02|分布漂移失效:考纲过时,评测脱离真实业务03|标注崩塌失效:标尺跑偏,对比彻底失效04|过拟合失效:小题库刷分,模型变成应试选手05|纠正三个致命误区
模式 01数据泄露失效:考题泄密,考试彻底失效所有评测失效里最高频、最隐蔽、最害人的模式
简单一句话解释:评测集题目,模型提前见过。
无论是公开预训练数据、研发日常调优、SFT 微调素材,还是知识库收录、历史样本复用——只要评测样本进入过模型的学习、调优或检索范围,就会形成泄露。三类最常见的泄露场景:
正常评测逻辑:未知题目 → 考察真实泛化能力 → 分数可信泄露后逻辑:已记忆题目 → 靠记忆作答而非靠能力作答 → 分数全部虚高
| | |
|---|
| C-Eval、MMLU、GSM8K 等通用评测集,早已被所有主流大模型预训练收录 | |
| 为快速见效,反复拿同一套评测集改 Prompt、调检索、试参数 | |
| 评测样本源于业务问答,知识库更新后自动收录评测题目 | |
真实例子:某团队把线上 FAQ 直接搬进评测集,知识库更新时自动收录了这批 FAQ。评测时检索直接命中原文,RAG 问答拿到 96 分;上线后用户却大量抱怨答非所问——题目原文就躺在知识库里,模型只是「抄」了一遍,根本没考到理解能力。
落地解法
- 三套数据物理隔离。训练集、微调集、评测集分目录、分权限管理,评测集设为只读,调优人员不可写入;每轮建模前跑一次样本级交集检查,发现重复立即下线。
- 自建业务私有评测集。从线上真实 Query 按场景分层抽样 200-500 条,保留多轮、口语化、歧义等真实形态,脱敏后入库;公开数据集只做参考,不做主测。
- 迭代前泄露扫描。用 embedding 相似度把评测集与训练、微调、知识库数据互查,相似度超阈值(如 0.9)的样本当轮替换;把扫描做成发布流程卡点,不扫描不迭代。
- 核心样本定期轮换。按季度灰度替换 20-30% 核心样本;新旧题库先并行跑一轮,确认分数无异常跳变再正式切换,旧题归档备查。
模式 02分布漂移失效:考纲过时,评测脱离真实业务如果泄露是「题目泄密」,漂移就是「考纲彻底过时」
业务永远在变:用户提问习惯变了、场景复杂度变了、业务政策变了、知识库内容变了、Agent 任务流程变了。但你的评测集,半年、一年从未更新。
| |
|---|
| |
| |
| 数据分布、难度分布、场景分布彻底错位,评测再也无法代表真实线上表现 |
| |
|---|
| |
| 线上多轮、口语化、歧义提问变多,评测集全是标准干净题目 |
| Agent 已从单步任务进化为多分支复杂任务,评测集依旧全是简单任务 |
真实例子:某智能客服的评测集两年没更新,题库全是「查订单、退换货」这类标准问法。今年用户开始问「帮我写投诉信」「对比两款保险方案」——这些真实高频问题在评测集里一道都没有。结果线上失败率涨了 3 倍,评测分数却纹丝不动:评测考的还是去年的业务。
落地解法
- 建立代谢机制。每月从线上日志抽样,把 10-15% 真实 Query 灌入题库,同步淘汰长期无区分度的题目;新增题进「新增场景集」,不动基线题,保证跨版本可比。
- 分布对齐巡检。每月对比评测集与线上数据的主题分布、提问长度、失败率,偏差最大的维度优先补题;巡检结果落成看板,结论归档、责任到人。
- 三层题库分层管理。基础通用集(回归用,保持稳定)+ 新增场景集(月更)+ 长尾疑难集(季度扩充);三层分数分开看,避免平均分掩盖局部退化。
- 业务版本强同步。业务大版本上线前,评测集必须先完成更新;把「评测集更新完成」写进上线 checklist,作为不可跳过的卡点。
模式 03标注崩塌失效:标尺跑偏,对比彻底失效前两种是数据问题,这是标准问题——最隐蔽、最容易被忽略的致死模式
很多团队默认:只要评测样本不变,分数就可以跨版本对比。
这是严重的工程误区。主观评测、LLM 打分、人工打分,没有绝对标准答案,只有相对标准。标准一旦偏移,分数波动和模型能力无关,只和「打分松紧」有关。
真实例子:同一条客服回答,老标注员按旧口径打 3 分(没说清赔付时限),新人按宽松口径打 5 分。标注团队轮换一个月后,同一版本模型「凭空」涨了 8 分——模型什么都没变,只是标尺松了。等回过神来,前三个版本的迭代对比已经全部作废。
落地解法
- 标注规范 100% 书面化。每个维度写清定义、打分锚点(1/3/5 分各配正反例)、边界 case 的裁决规则;规范进版本管理,任何改动留痕并同步全员。
- 黄金样本先校准再开测。维护 50-100 条标准答案已达成共识的黄金样本,每批标注前先盲标黄金集;一致率低于 95% 不开测,先重训再上岗。
- 核心样本双人交叉。核心样本两人独立打分,分歧超过 1 分强制第三人仲裁;仲裁结论回写进规范,形成规则闭环。
- 一致性定期抽检。每周随机抽 5% 已标样本复标,计算标注一致率;不达标者重训,连续不达标升级专项复盘。
模式 04过拟合失效:小题库刷分,模型变成应试选手中小 AI 团队最高发的陷阱
研发所有迭代、调优、Prompt 改版,全部围绕几十条固定样本反复打磨。最终结果:模型在专属题库满分,在真实业务直接崩盘。
这就是评测集过拟合:模型没有学到通用业务能力,只学到「适配这几十道题的套路」。
| |
|---|
| |
| |
| Prompt 完全适配固定题库,换真实 Case 效果断崖下滑 |
真实例子:某团队的 80 条评测题全部以「请详细说明……」开头,三轮 Prompt 调优后题库 98 分。真实用户的问法千奇百怪、长短不一,灰度首日解决率只有 61%——模型没学会业务能力,只学会了「请详细说明」开头的这几十道题的套路。
落地解法
- 题库扩到数百级。评测集扩到 300 条以上,按难度、场景分层配比;先扩覆盖宽度,再补深度,避免在单场景里堆题。
- 禁止定向刷分。调优、Prompt 改版一律不得引用评测集原文;写进研发规范,并在代码评审里加检查项。
- 盲测隐秘样本对照。从线上抽 50-100 条组成盲测集,不进日常看板,每个版本只跑一次;盲测分与日常分差值超过 10% 即触发虚高预警。
- 3-5 版本强制换血。固定样本迭代 3-5 个版本后,强制替换 30% 并增量扩充;旧题退役归档,留作跨版本回归复测。
| |
|---|
| 错。脏数据越多,误导越强。质量优先级:新鲜、贴合业务、精准 > 体量 |
| 错。固定样本挡不住泄露、漂移、标注偏移,静态题库必然逐步死亡 |
| 这是最大的认知错误。评测集是持续运维的核心技术资产,和代码、知识库同等重要 |
AI 工程迭代里,好看的分数一文不值,可信的分数才值钱。所有模型优化、知识库升级、Agent 能力迭代的前提,不是算法多强、架构多新,而是:你的评测体系,依然活着、依然公正、依然对齐真实业务。
绝大多数团队 AI 迭代低效、投入无回报、越优化越乱,本质不是技术不行,而是评测集早已失效,全程盲目试错。搭建一套可代谢、可巡检、可追溯、可置信的评测体系,是所有 AI 落地提效的第一步,也是最关键的一步。