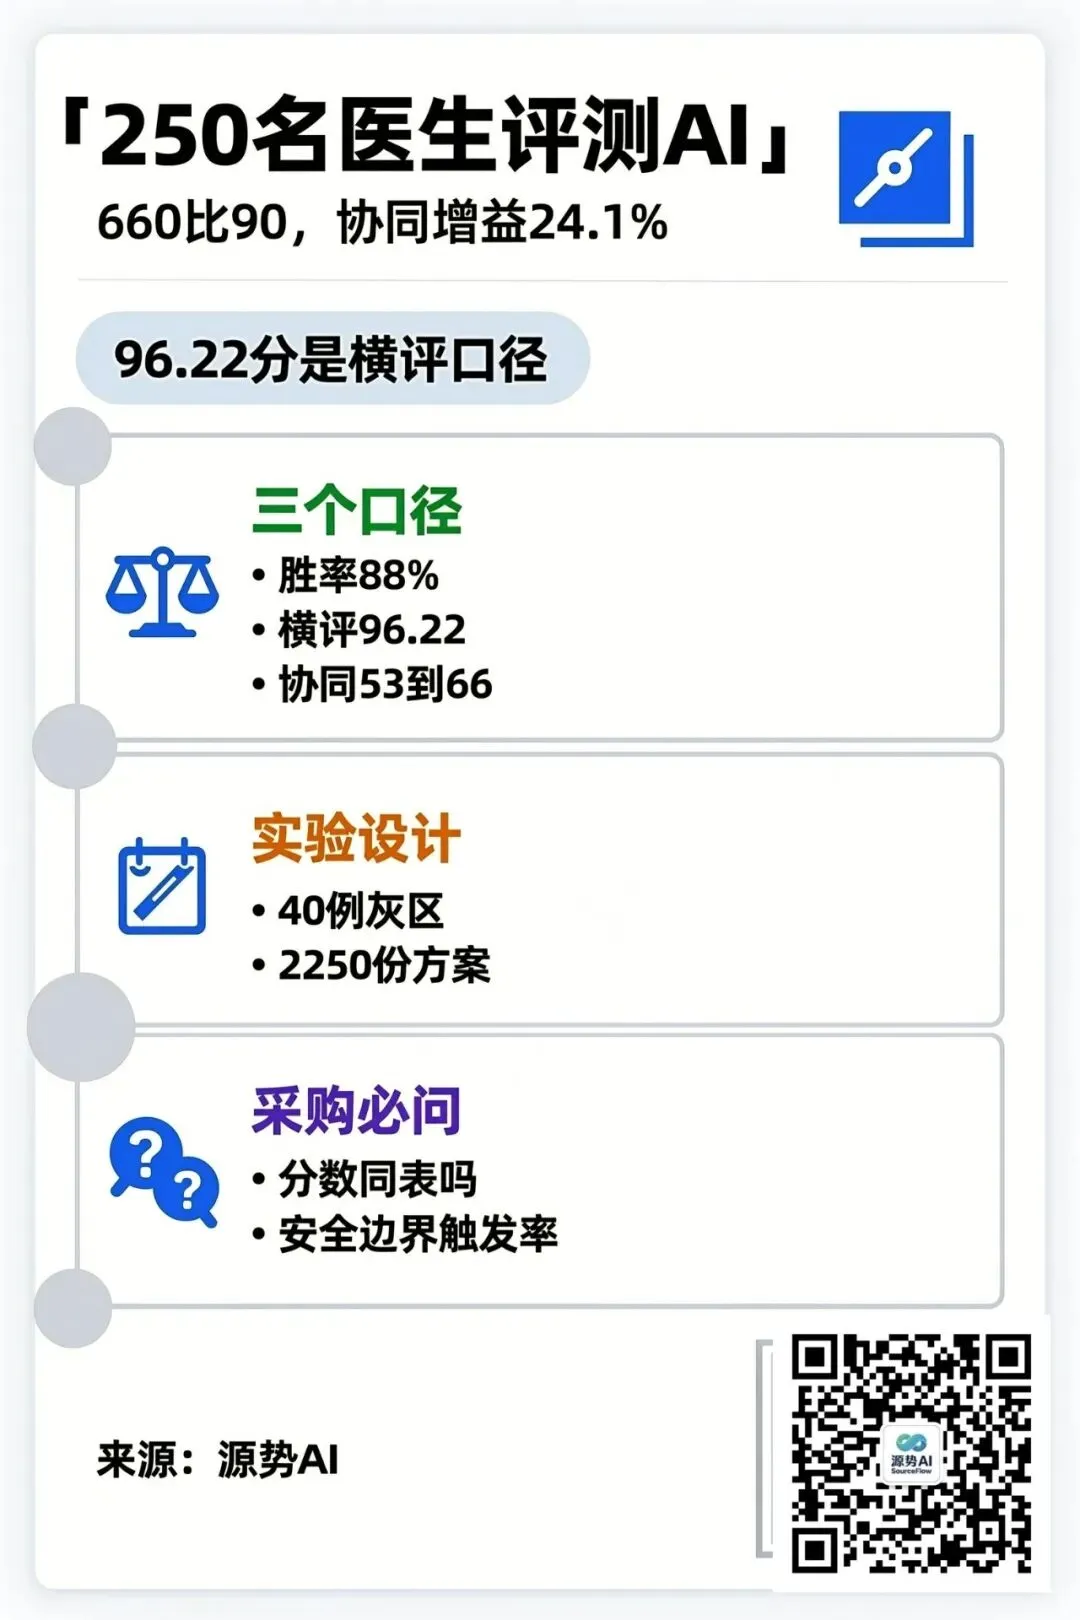
11 月 13 日,医疗 AI 公司"未来医生"公布一项肺癌诊疗实证研究:围绕 40 例复杂肺癌病例,在统一标准评估下,其医疗大模型 MedGPT 对医生取得 88 比 12 的胜率;250 名来自三甲医院的医生参与,覆盖 27 个省级地区、98 个标准化中心(来源:量子位,2026-11-13)。
报道给出的数字不少:660 比 90、96.22 分、53.40 升到 66.27、88 比 12。几个数看起来在说同一件事,其实口径不同。这篇把这几个数字分开算一遍,再看这对医院采购意味着什么。
一、三个分数,不是一把尺
先列出报道里的三组数:
模型横评:MedGPT 综合 96.22 分,GPT-5.4 为 71.38,Claude Opus 4.7 为 61.81,Gemini 3.1 Pro 为 54.62。这是同一批病例、同条件、模型之间的比较。
个案胜率:250 名医生在无辅助条件下提交 750 份诊疗方案,MedGPT 在其中 660 次的评分高于医生,即 88% 比 12%。
人机协同:医生总体得分从 53.40 提升到 66.27,相对增幅 24.1%。
三组数的分母都不同:模型横评的分母是模型个数与病例数,个案胜率的分母是 750 份方案,协同增益的分母是同一批医生的前后对照。
这里有一个必须提出的疑问:MedGPT 单独得分 96.22,而医生借助 MedGPT 之后只有 66.27。 如果两者是同一评分体系,那意味着"人 + AI"明显低于"AI 单独"。报道没有说明这两个分数是否同表、是否同批病例,这一点需要向发布方确认,不能自行推断。
按公开信息能确定的部分:96.22 与 61.81 这类数字来自模型横评环节,66.27 来自医生前后对照环节。两个环节的评分基准很可能不同,直接相减会得出错误结论。
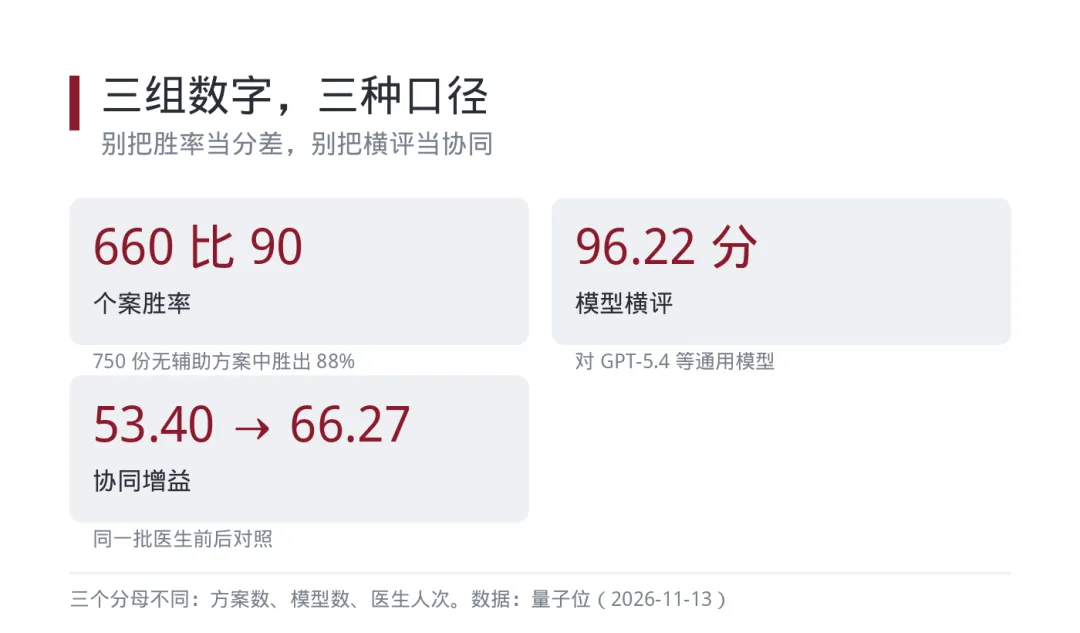
图注:660 比 90 是个案胜率,96.22 是模型横评得分,53.40 到 66.27 是医生自身前后对照。三者回答的是不同问题:AI 比人强多少、AI 比别的模型强多少、AI 能让人变强多少。数据来源:量子位(2026-11-13)披露的评测结构。
二、88 比 12 是胜率,不是差距
660 比 90 这个数字的含义,要回到实验设计。
每位医生在三种条件下各完成 3 个不同病例:无辅助、检索参考、MedGPT 支持。250 名医生乘以 3 例,得到 750 份无辅助方案。AI 与这 750 份方案逐一比较,赢了 660 次,胜率 88%。
这个设计有两处值得注意。
一是"三个不同病例"意味着每位医生只在自己没见过的病例上被评一次,对照组是横向的医生群体,不是同一个人的前后。这能减少偏好偏差,但也意味着高水平医生与普通医生的表现被混在一起看。
二是 88% 是胜率,不是分差。胜率 88% 可能对应平均分差 10 分,也可能对应 30 分,报道未给出分差的分布。
还有个细节:MedGPT 的标准化输出平均比医生短四成以上(来源:量子位,2026-11-13)。在"信息完整度"这类评分维度里,更短的方案能拿高分,说明评分规则偏向关键决策点,而不是篇幅。这一点对后续复制评测很关键。
三、协同增益 24.1%,是这类研究最有用的数字
把 53.40 抬到 66.27,是这次研究里最贴近临床实际的数字。它回答的是"医生用上 AI 之后能好多少"这个问题;"AI 自己有多强"是另一个问题。
24.1% 的相对增幅,与行业里其他观察方向一致:真正起作用的变量是医生能不能把 AI 的输出接进自己的决策流程,模型分数在这一步不起决定作用。华西医院与润达、华为共建的医疗智能体,走的是"AI 答题、专家判卷、判完沉淀回知识库"的路子,上线后基层诊疗同质化率提升 58%(来源:中国信通院《企业级智能体技术与应用研究报告(2026年)》,转引自源势AI《医疗AI想上岗,先过了审再说话》,2026-09-09)。
两个数字说的其实是一件:AI 在医疗里的价值主要体现为拉平差距。 顶级医生用 AI 提升有限,基层医生用 AI 提升明显——这也是主管部门愿意为医疗 AI 开口子的现实理由。
使用面也已经铺开。临床实践中使用 AI 的医生占比,从 2023 年的约 35% 升到 81%;国内医疗大模型累计发布量从 61 个涨到 311 个(来源:艾瑞咨询《2026年中国医疗大模型行业研究报告》,2026-08)。这意味着接下来的竞争点不再是"医院有没有 AI",而是"人机协同后的分数是多少"。这份研究给出了一个可比的起点:66.27 分。
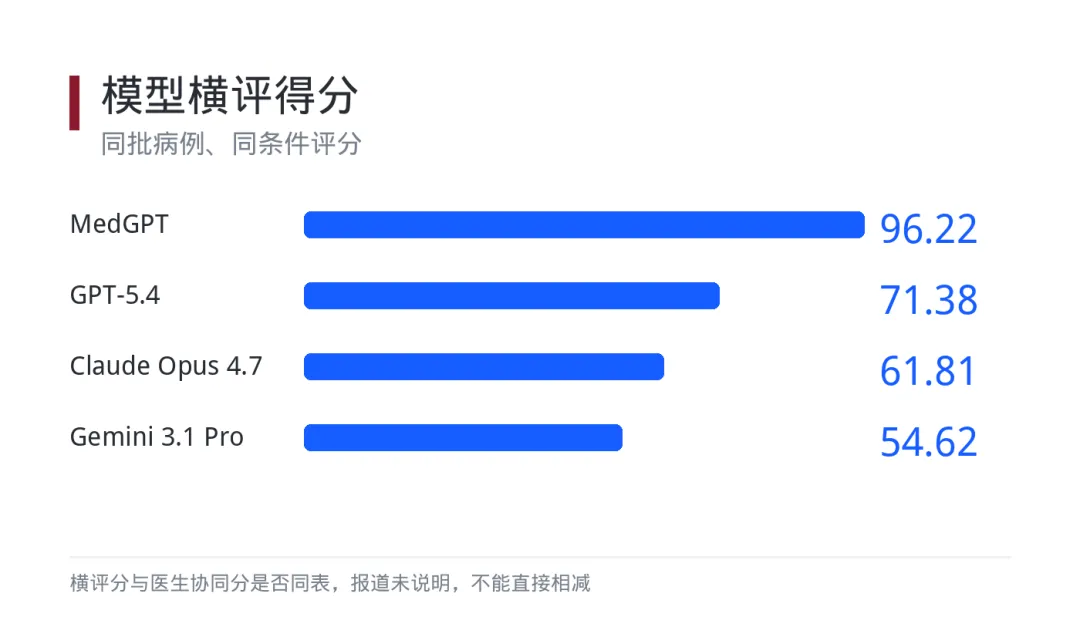
图注:模型横评比较的是"谁的答案更接近标准答案",协同增益比较的是"同一批医生用了 AI 之后分数变化多少"。采购决策应该看后者,因为临床流程里最终签字的是医生。数据来源:量子位(2026-11-13)披露的横评得分。
四、评分规则比模型更值得看
这次研究在设计上做了一件容易被忽略的事:先定规则,再看结果。
20 名多学科专家经过三轮,形成 240 条病例评价规则,逐例明确需要处理的临床问题、治疗前必要信息、可选治疗路径。其中 40 条锚定治疗资格与治疗强度的安全边界,触及即判负。
"触及即判负"这五个字是整份研究里最硬的设计。它意味着模型或医生提出一个超出安全边界的方案,其他维度得分再高也没用。医疗 AI 的失败通常不是"答得不够好",是"答得危险"——这套规则把危险项单列了。
对采购方的启发是:评测报告里最该逐条读的是负面清单。 一份只报平均分、不报安全边界触发率的评测,不足以支撑采购决策。
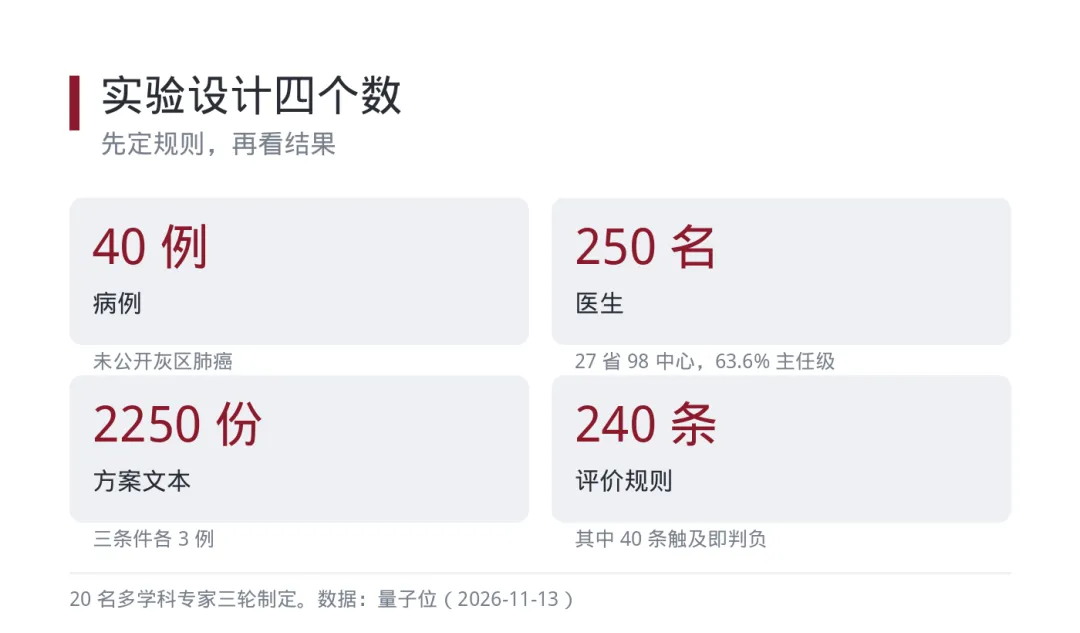
图注:40 例灰区病例、250 名医生、2250 份方案文本、240 条评价规则——前三个数决定研究规模,最后一个决定结论可信度。240 条规则里有 40 条是安全边界,触及即判负。数据来源:量子位(2026-11-13)。
五、医院采购该问的五个问题
第一,评测病例来源。40 例未公开病例是不是灰区病例?如果换成典型病例,AI 与人的差距会大幅收窄——灰区病例恰恰是 AI 最能发挥的场景。
第二,对照组构成。250 名医生里有 159 位主任或副主任医师,占 63.6%。对照组越强,胜率的含金量越高;换成基层医生对照,同样的胜率说明不了同等水平。
第三,分数是否同表。模型横评分与医生协同分是不是同一评分基准,必须问清。不同表的分数不能互相比较。
第四,错误类型分布。高分不等于没有危险输出,要看 40 条安全边界的触发率。
第五,上线后的复核机制。评测是一次性的,临床是持续的。方案里有没有留出"AI 建议可回溯、可人工复核"的环节,决定了这套系统能不能长期留在诊室里。
源势AI观点
医疗 AI 的评测正在从"比准确率"转向"比流程"。这次研究值得肯定的地方在方法论:把一个临床上没有唯一答案的问题拆成 240 条可评分规则,并给安全边界设了一票否决。88 比 12 只是这套方法的产出。这是把"临床判断"工程化的必经之路。
需要保持警惕的是数字的传播方式。96.22 与 66.27 放在同一张图里,很容易被读成"AI 比人机协同更强,所以要替代医生"。这个推论既不成立,也不符合研究者的本意——同一批医生用了 AI 之后分数提升了 24.1%,这才是产品价值所在。
对医院和医疗 IT 采购方,一句话总结:看协同增益,看安全边界触发率,看错误类型;不要只看模型横评分。 一个能在灰区病例上给出多条候选路径、并写清每条路径准入与退出条件的系统,比一个只给单一最优解的模型更适合进临床。
话题标签:#医疗AI #临床评测 #人机协同
源势AI · 企业级 AI 基础设施服务商
AI 能力的连接器,企业增长的源动力
AI Infra:算力、模型与 Token 的统一调度治理
Agent Infra:智能体的编排、安全与规模化落地
共享统一网关 · 身份 · 计量 · 审计
官网 www.srcflow.cn | 邮箱 business@srcflow.cn
关注我们 · 获取更多 AI 前沿洞察
