摘要:单棵树只能画台阶,一百棵树能把正弦曲线追到误差 0.34。这篇从零写一个 GBDT,把残差、负梯度、学习率、对数损失这几个概念全用代码跑出来,顺便回答一个老问题:为什么三十棵深度 3 的小树,能打赢一棵深度 10 的大树。
前阵子帮朋友的公司面人,我出了一道 GBDT 的题。
面试里问 GBDT,十个候选人九个能背出"拟合负梯度"。
再往下问一句:为什么负梯度就等于残差?换成分类任务,残差还能用吗?
能答上来的,不到两个。
这事挺典型。GBDT 的概念不难,难在"为什么这么设计"。你把这三个字拆开看:Gradient Boosting Decision Tree,梯度、提升、决策树。每个词都对应一个具体的设计决策,串起来才讲得通。
这篇我打算用最笨的办法讲:一行一行把 GBDT 写出来,然后在数据上跑,看它怎么一轮一轮把误差磨掉。
👇 先从一个反直觉的现象开始。
01 为什么小树反而更强
先做个对比。
一棵深度 10 的树,能把训练集拟合到几乎零误差。它的叶子多,规则细,每个叶子可能只装了几条样本。
但这样的树拿去做预测,往往不如三十棵深度 3 的树加起来。
原因在偏差和方差。
深度 10 的树,偏差极低,方差极高。训练集里的一点噪声,都会被它当成规律记下来。换个样本,叶子里的均值就变了,预测跟着抖。
深度 3 的树,偏差高一些,方差低。它只能切八片,表达不了太复杂的形状,但也记不住噪声。
单棵用不行,那就多棵。问题是怎么把多棵加起来还有意义?
随机森林的办法是并行:每棵树独立看一部分样本和特征,最后投票。它降的是方差。
GBDT 的办法是串行:每棵树专门修正前面所有树犯的错。它降的是偏差。
一句话区分:随机森林是"一群专家各看各的,投票";GBDT 是"一个学生做题,老师专挑错题讲"。
这里有个反例值得记住。
前几年有个团队为了让模型更准,把树深度从 4 调到 12,树的数量从 200 加到 800。训练集 AUC 干到 0.93,测试集只有 0.71,比原来的浅层模型还差。
他们以为是数据不够,又去补了三年的样本。结果训练集 0.94,测试集 0.72。
问题不在数据量,在模型复杂度。深度 12 的树有四千多个叶子,平均每个叶子装不到 30 条样本,这已经是在记样本了。
后来把深度调回 4,只留 300 棵树,测试集回到 0.78。
02 GBDT 到底在学什么
假设你要预测一个人的年收入。
第一版模型很简单:所有人都预测平均值,10 万。这一步的误差,就是每个人的实际收入减去 10 万。
第二版模型不看收入了,它看"误差"。它要回答的问题是:什么样的人,实际收入比 10 万高?高多少?
比如它学到"硕士学历的人,比平均高 3 万"。于是第二版预测变成 10 万加 3 万。
剩下的误差还有。第三版继续学:在"硕士且在一线城市"这群人里,还差多少?
一轮一轮下去,误差越来越小。
这就是 Boosting 的直觉:不要求每棵树都对,只要求每棵树把当前的错补一点。
写成公式就是加法模型。最终预测是所有树的输出加起来,乘上学习率,加上初始值。
而"每棵树学什么",严格来说学的不是残差,是损失函数的负梯度。
对平方损失,负梯度正好等于残差,所以两个说法在这个场景下是一回事。换成别的损失,就不一样了。
这是理解 GBDT 最关键的一步:残差只是负梯度的特例。
03 为什么负梯度正好等于残差
这一步值得动手算一遍,算完就再也不会忘。
平方损失长这样:L 等于二分之一乘以预测减真实值的平方。
对预测值 F 求导,导数就是 F 减 y。
梯度下降的意思是,沿着导数反方向走一小步。所以"应该往哪个方向修正",就是 y 减 F。
而 y 减 F,正好就是残差的定义。
所以对平方损失来说,"拟合负梯度"和"拟合残差"是同一件事,只是换了个说法。
换成对数损失,就不一样了。
对数损失对 F 求导,导数等于预测概率减真实标签。它长得像残差,但残的是概率空间,不是标签空间。
一个正样本,当前预测概率 0.3,那么梯度是 0.3 减 1,等于负 0.7。模型会把这个人的分数往上推。
一个负样本,预测概率 0.3,梯度是 0.3 减 0,等于正的 0.3。模型往下推。
注意,两个样本的预测都是 0.3,但推力方向完全相反,大小也不同。这就是对数损失和平方损失的区别:它是按"当前预测错得有多离谱"来分配力度的。
预测 0.5 的样本,推力 0.5;预测 0.9 的正样本,推力只有 0.1,因为已经差不多了。
这种"错得越多推得越狠"的性质,正是分类任务需要的。
04 先把一棵回归树写出来
树的本质是一串 if-else。
每个内部节点选一个特征、一个阈值,把样本劈成两半。劈到叶子,就输出一个值。
回归树的输出值是叶子里的均值。选切点的标准是:劈完之后,两边的平方误差之和最小。
下面这段代码实现了回归树和 GBDT 的主体。为了看清过程,用一维数据。
# -*- coding: utf-8 -*-"""从零实现 GBDT 回归:一棵树拟合残差,一百棵树叠起来。"""import numpy as nprng = np.random.default_rng(7)n = 800x = np.sort(rng.uniform(0, 10, n))y = np.sin(x) + 0.25 * x + rng.normal(0, 0.35, n)class RegTree: """最小二乘回归树,每次选让 SSE 下降最多的切点""" def __init__(self, depth=3, min_leaf=20): self.depth, self.min_leaf = depth, min_leaf def fit(self, x, y): self.x, self.y = x, y self.root = self._build(np.arange(len(x)), 0) return self def _build(self, idx, d): if d >= self.depth or len(idx) < 2 * self.min_leaf: return ("leaf", self.y[idx].mean()) best = None for t in np.quantile(self.x[idx], np.linspace(0.1, 0.9, 19)): left = idx[self.x[idx] <= t] right = idx[self.x[idx] > t] if len(left) < self.min_leaf or len(right) < self.min_leaf: continue sse = ((self.y[left] - self.y[left].mean()) ** 2).sum() + \ ((self.y[right] - self.y[right].mean()) ** 2).sum() if best is None or sse < best[0]: best = (sse, t, left, right) if best is None: return ("leaf", self.y[idx].mean()) _, t, left, right = best return ("node", t, self._build(left, d + 1), self._build(right, d + 1)) def predict(self, x): return np.array([self._one(self.root, v) for v in x]) def _one(self, node, v): while node[0] == "node": node = node[2] if v <= node[1] else node[3] return node[1]def gbdt(x, y, lr=0.1, rounds=100, depth=3): f = np.full(len(y), y.mean()) trees = [] for _ in range(rounds): r = y - f # 残差就是平方损失的负梯度 t = RegTree(depth).fit(x, r) f += lr * t.predict(x) trees.append(t) return f, treesdef rmse(a, b): return float(np.sqrt(((a - b) ** 2).mean()))if __name__ == "__main__": print(f"数据 {n} 条,目标函数 y = sin(x) + 0.25x + 噪声") print(f"用均值猜:RMSE {rmse(y, np.full(n, y.mean())):.3f}") for k in (1, 5, 10, 30, 100): pred, _ = gbdt(x, y, lr=0.1, rounds=k) print(f" {k:>3} 棵树 RMSE {rmse(y, pred):.3f}") pred, trees = gbdt(x, y, lr=0.1, rounds=100) print(f"\n100 棵树之后的残差标准差:{np.std(y - pred):.3f}(原始 {np.std(y):.3f})")代码不长,但几个点值得说。
第一,切点用分位数撒了 19 个候选,没有暴力遍历所有可能值。真实工程里也是这么做的,几百万条数据不可能每个值都试一遍。
第二,r = y - f 这一行就是全部的秘密。拟合目标不是 y,是残差。
第三,每棵树都很浅,深度 3,最多 8 个叶子。它只负责补一小块。
跑出来的结果:
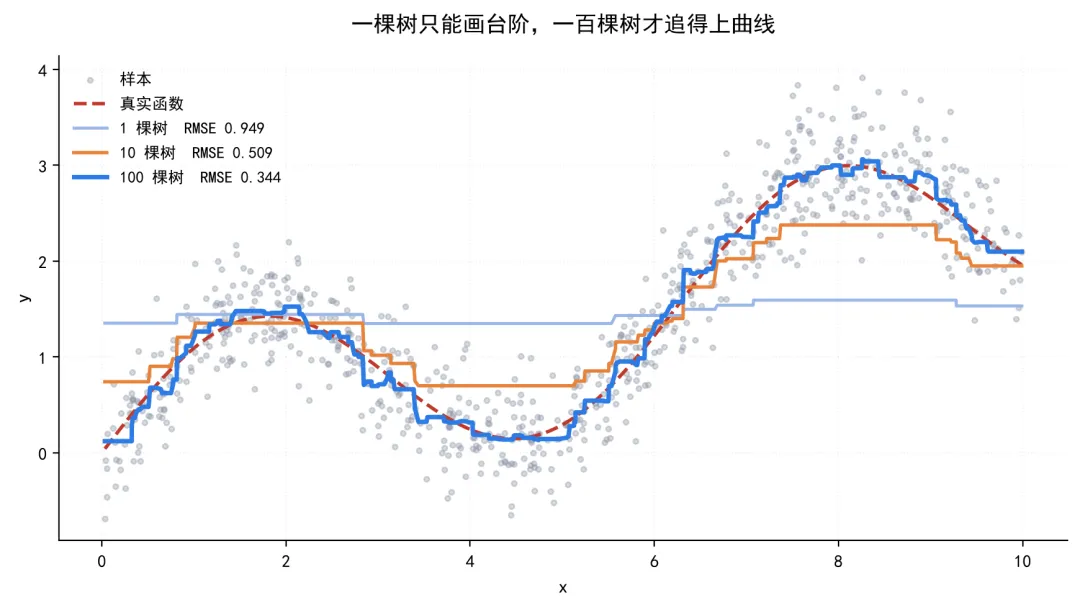
数据 800 条,目标函数 y = sin(x) + 0.25x + 噪声用均值猜:RMSE 1.036 1 棵树 RMSE 0.949 5 棵树 RMSE 0.690 10 棵树 RMSE 0.509 30 棵树 RMSE 0.358 100 棵树 RMSE 0.344100 棵树之后的残差标准差:0.344(原始 1.036)注意两个数。原始数据的标准差是 1.036,一百棵树之后残差标准差 0.344。
而我加进去的噪声,标准差正好是 0.35。
也就是说,模型已经把能学的都学到了,剩下的 0.344 全是噪声,再练也降不下去。
这张图能看清叠加的过程。
浅蓝色是一条树,它是阶梯状的,只有 8 个台阶,形状勉强对但很粗。
橙色是十棵树,台阶变细了,已经能看出正弦的走势,但在波峰处明显偏低。
深蓝色是一百棵,几乎贴着真实函数(红色虚线)走。
这就是 Boosting 的视觉解释:每棵树贡献一小段修正,累加起来逼近真实形状。
05 学习率:慢就是快
上面代码里有个参数 lr,学习率,我设的是 0.1。
它的作用是把每棵树的输出打个折。树说"这里应该加 3",模型只加 0.3。
为什么打折?因为每棵树都是在当前残差上拟合的,它一定会过拟合一点。全额加上去,错误也被放大。
打折之后,需要更多轮才能收敛,但每一轮都更稳。
这个参数和树的数量是一对,必须一起调。
# -*- coding: utf-8 -*-"""学习率和树数量怎么配:四档学习率,各跑 200 棵树。"""import numpy as npfrom block1 import RegTree, rmserng = np.random.default_rng(2026)n = 1200x = rng.uniform(0, 10, n)y = np.sin(x) + 0.25 * x + rng.normal(0, 0.35, n)idx = rng.permutation(n)tr, te = idx[:900], idx[900:]print("学习率 最优树数 最优测试RMSE 第200棵测试RMSE")for lr in (0.05, 0.1, 0.3, 1.0): f_tr = np.full(len(tr), y[tr].mean()) f_te = np.full(len(te), y[tr].mean()) curve = [] for m in range(200): r = y[tr] - f_tr t = RegTree(depth=3).fit(x[tr], r) f_tr += lr * t.predict(x[tr]) f_te += lr * t.predict(x[te]) curve.append(rmse(y[te], f_te)) best = int(np.argmin(curve)) + 1 print(f"{lr:5.2f} {best:>7} {min(curve):>11.3f} {curve[-1]:>12.3f}")输出:
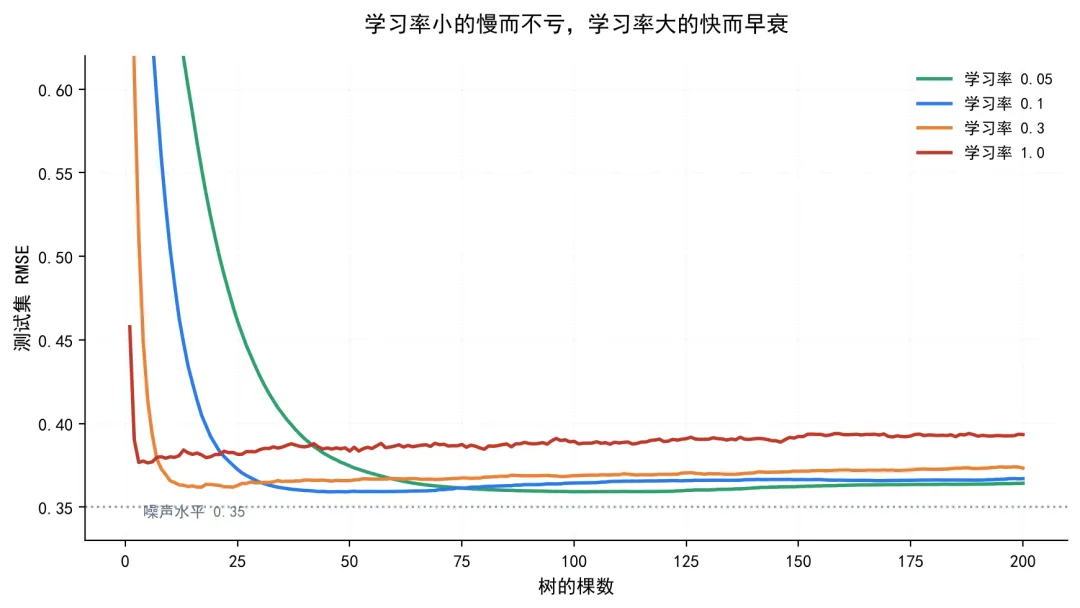
学习率 最优树数 最优测试RMSE 第200棵测试RMSE 0.05 100 0.359 0.364 0.10 49 0.359 0.367 0.30 24 0.362 0.373 1.00 5 0.376 0.393这张表信息量很大。
学习率 0.05,要 100 棵树才到最优,最优 RMSE 0.359。学习率 1.0,5 棵树就到最优了,但最优只有 0.376,而且跑到 200 棵时涨到 0.393,明显过拟合。
也就是说,学习率小,最终效果略好,代价是训练慢。
学习率大,收敛快,但精度差,且更容易在后期变差。
工程上的经验是:学习率取 0.05 到 0.1,树的数量用早停法定。
早停怎么做?留一个验证集,每加一棵树算一次验证集指标,连续 N 轮不提升就停。N 一般取 30 到 50。
图上看得很清楚:学习率 0.3 和 1.0 的曲线,在第 30 棵之后基本是平的,甚至微微上翘。这时候再加树,只是在拟合噪声。
早停的实现有个细节容易错:不能每加一棵树就判断一次,否则曲线抖一下就触发停止。
正确做法是记录历史最优值,同时记一个计数器。每次验证指标比历史最优好,计数器清零并更新最优;否则计数器加一。计数器达到阈值才真停。
还有一个更隐蔽的坑:早停用的验证集,不能跟最终评估用的是同一份。
有些团队只有一份验证集,既用来早停,又用来报指标。这样报出来的指标是偏乐观的,因为模型已经在这份数据上做过选择。
三个数据集,训练、验证、测试,各干各的事。数据量实在不够,至少保证早停和最终评估分开。
还有个现象值得一提。四条曲线最后都收敛到 0.35 附近,也就是噪声水平。这说明在合适的参数下,GBDT 不会把噪声学进去太多,它的上限就是数据本身的信息量。
06 从回归到分类:残差不能用了
上面都是回归。换到分类,问题来了。
分类的标签是 0 和 1。残差是 0 减 0.3 等于负 0.3,这个数没有意义,因为它不是"差多少",而是"差在哪个方向"。
所以分类必须换损失函数,通常用对数损失,也就是逻辑回归那个损失。
换了损失,负梯度就不等于残差了。
对数损失对 F 的负梯度是 y 减 p,p 是当前预测的违约概率。这个形式看着像残差,但它残的是"概率",不是标签。
还有一处更关键:叶子输出值不能再用均值了。
回归里叶子输出均值,是因为平方损失的最优解就是均值。对数损失下,最优解是"梯度和除以二阶导之和",也就是牛顿法的一步。
所以完整的 GBDT 分类,每个叶子要算两个量:一阶导的和、二阶导的和,然后相除。
这就是 XGBoost 里那个 gain 公式的来源。它不是拍脑袋想出来的,是二阶泰勒展开的结果。
下面这段代码用四个特征做二分类,从头实现一遍。
# -*- coding: utf-8 -*-"""GBDT 做二分类:用对数损失的梯度,叶子值用牛顿步长。"""import numpy as nprng = np.random.default_rng(3)n = 4000income = rng.normal(12000, 4000, n).clip(2000, 60000)dti = rng.beta(2.2, 3.0, n) * 1.2delinq = np.clip(rng.poisson(0.5, n), 0, 6)inq = np.clip(rng.poisson(1.8, n), 0, 12)z = (-3.1 - 0.00004 * income + 2.6 * dti + 0.55 * delinq + 0.12 * inq + 0.8 * (dti > 0.55) - 0.6 * (income > 20000))y = (rng.random(n) < 1 / (1 + np.exp(-z))).astype(float)X = np.column_stack([income / 10000, dti, delinq, inq])names = ["收入", "负债收入比", "历史逾期", "查询次数"]print(f"样本 {n},坏账率 {y.mean()*100:.2f}%")def build(X, g, h, idx, depth, min_leaf, cols): """返回树节点;gain 用二阶泰勒展开""" if depth == 0 or len(idx) < 2 * min_leaf: return ("leaf", -g[idx].sum() / (h[idx].sum() + 1e-6)) G, H = g[idx].sum(), h[idx].sum() best = None for c in cols: for t in np.quantile(X[idx, c], np.linspace(0.2, 0.8, 9)): l = idx[X[idx, c] <= t] r = idx[X[idx, c] > t] if len(l) < min_leaf or len(r) < min_leaf: continue gain = (g[l].sum() ** 2 / (h[l].sum() + 1e-6) + g[r].sum() ** 2 / (h[r].sum() + 1e-6) - G ** 2 / (H + 1e-6)) if best is None or gain > best[0]: best = (gain, c, t, l, r) if best is None: return ("leaf", -G / (H + 1e-6)) _, c, t, l, r = best return ("node", c, t, build(X, g, h, l, depth - 1, min_leaf, cols), build(X, g, h, r, depth - 1, min_leaf, cols))def apply(node, X, i=0): while node[0] == "node": node = node[3] if X[i, node[1]] <= node[2] else node[4] return node[1]def fit_gbdt(X, y, rounds=100, lr=0.1, depth=3, min_leaf=40): p0 = y.mean() F = np.full(len(y), np.log(p0 / (1 - p0))) for _ in range(rounds): p = 1 / (1 + np.exp(-np.clip(F, -30, 30))) g, h = p - y, p * (1 - p) # 一阶导、二阶导 cols = rng.choice(X.shape[1], max(1, int(X.shape[1] * 0.8)), replace=False) tree = build(X, g, h, np.arange(len(y)), depth, min_leaf, cols) F += lr * np.array([apply(tree, X, i) for i in range(len(y))]) return Fdef auc(y, s): order = np.argsort(s) rank = np.empty(len(s)) rank[order] = np.arange(1, len(s) + 1) pos = y == 1 return (rank[pos].sum() - pos.sum() * (pos.sum() + 1) / 2) / (pos.sum() * (~pos).sum())if __name__ == "__main__": for k in (1, 10, 100): F = fit_gbdt(X, y, rounds=k) print(f"{k:>3} 棵树 AUC {auc(y, F):.4f}") F = fit_gbdt(X, y, rounds=100) print(f"\n集成后分数范围 {F.min():.2f} ~ {F.max():.2f}," f"对应违约概率 {1/(1+np.exp(-F.min())):.3f} ~ {1/(1+np.exp(-F.max())):.3f}")输出:
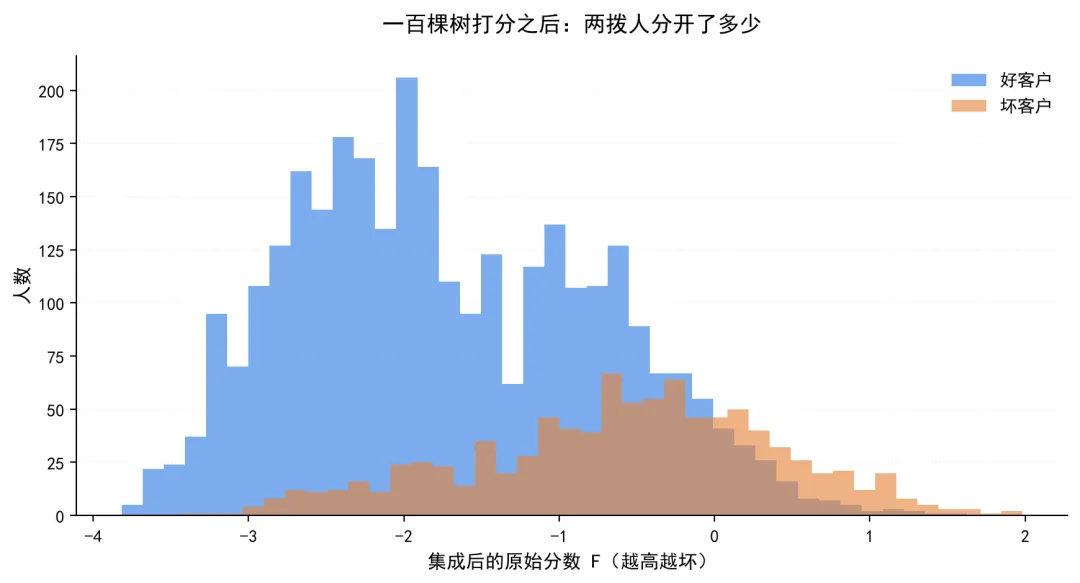
样本 4000,坏账率 23.65% 1 棵树 AUC 0.7415 10 棵树 AUC 0.7661100 棵树 AUC 0.7879集成后分数范围 -4.03 ~ 1.97,对应违约概率 0.017 ~ 0.878三件事值得说。
第一,单棵树的 AUC 就有 0.74。树模型天生擅长找非线性和交互,一棵树就能吃掉大部分信号。
第二,从 1 棵到 100 棵,AUC 从 0.7415 涨到 0.7879,涨了 4.6 个点。这个提升幅度在真实项目里很典型:GBDT 相对单棵树,通常能提 3 到 6 个点。
第三,分数分布那张图,好客户集中在左边,坏客户往右拖了一条长尾。中间有一大块重叠区,那就是模型分不清的部分。风控的所有策略,本质上都是在这个重叠区里做取舍。
07 和随机森林到底差在哪
这两个模型经常被放在一起比,其实定位完全不同。
随机森林是 Bagging。每棵树用自助采样的一份数据,特征也随机抽一部分。树与树之间独立,可以并行训练。最后平均或投票。
它的核心作用是降方差。单棵树容易受样本扰动,平均一百棵就稳了。
GBDT 是 Boosting。每棵树依赖前面的结果,必须串行。它的核心作用是降偏差。
所以适用场景不一样。
数据噪声大、单棵树严重过拟合的时候,随机森林更省心,几乎不用调参。
追求极致精度、愿意花时间调参的时候,GBDT 通常更强。这也是为什么 Kaggle 上的表格赛题,GBDT 系(XGBoost、LightGBM、CatBoost)长期霸榜。
还有一点常被忽略:GBDT 对异常值更敏感。因为它在拟合残差,一个极端的 y 会产生一个巨大的残差,后面的树都会去追这个点。随机森林里,这个点只影响一部分树,还被平均掉了。
08 实践里真正要调的参数
理论讲完,说说调参。
树的数量和学习率是一对,前面说过了。经验是学习率固定 0.05 到 0.1,用早停定树数。
树的深度。风控场景常用 3 到 5。太深容易过拟合,也不利于解释。营销场景可以到 6 到 8,因为要抓更细的交互。
叶子最小样本数。这个参数比深度更直接影响过拟合。我一般设成总样本的 0.5% 到 1%,比如 10 万条数据设 500 到 1000。
行采样和列采样。每棵树随机用 70% 到 80% 的样本和特征。这两个参数能显著提升泛化,还能加速训练。
正则项。XGBoost 里的 lambda 和 alpha,控制叶子输出的惩罚。数据量小的时候调大一点,能明显抑制过拟合。
调参顺序我一般是这样:先定学习率和树数(早停),再调深度和叶子最小样本,最后微调采样比例和正则。
不要一上来就网格搜索所有参数,那是浪费时间。每个参数的作用方向搞清楚,手动调几轮就差不多了。
还有一个容易被忽略的点:早停用的那份验证集,必须按时间切,不能随机抽。
随机抽的话,验证集和训练集是同一段时间的同一批客户,模型在这上面表现好,只说明它记住了这批人的特征分布。真实上线面对的是下一批客户,早停点在随机验证集上选出来的树数,通常偏多,过拟合就藏在这多出来的几十棵树里。
按时间切也有代价,样本变少,指标更抖。所以我的做法是留最后两到三个月做验证,宁可抖一点,也要它真实。
09 特征重要性到底在说什么
模型跑完,业务第一个问题永远是:哪个变量最重要。
GBDT 能给出答案,但答案有三种口径,含义完全不同。
第一种,分裂次数。这个特征在所有树里被用来切了多少次。简单,但偏向取值多的连续变量,因为连续变量可切的位置多。
第二种,增益。每次用这个特征切分,带来的损失下降累加起来。这个更合理,因为它衡量的是"切了之后模型好了多少"。
第三种,置换重要性。把这一列随机打乱,看模型指标掉多少。掉得越多,说明这个特征越重要。
三种口径排出来的顺序,经常不一样。我一般看第二种和第三种,两个都高才算真的重要。
更麻烦的是共线性。
假设"月收入"和"年收入"同时在模型里,它们几乎等价。树会随机选其中一个切分,结果两个的重要性都被摊薄,各占一半。你看到的是"两个都不重要",实际是"两个都很重要,但重复了"。
处理办法是先把高度相关的变量合并,或者只留一个。
还有一个常见误解:重要性高不等于业务上重要。
有些特征重要性很高,但它是个代理变量。比如"手机号归属地"可能只是间接代表了客群结构。这类特征在模型里有效,但业务没法据此做动作,也不能写进策略。
我的建议是:重要性用来排排查顺序,不用来写结论。真正要下结论,还得做单变量分析加业务访谈。
10 几个容易踩的坑
第一个,特征泄漏。
GBDT 特别擅长利用泄漏的特征。你只要不小心把一个"未来信息"放进去,它会立刻抓住,AUC 能冲到 0.95,然后上线就废。这类事故我见过不止一次,尤其是把"逾期天数"这种贷后变量误当成贷前特征。
第二个,类别特征直接喂进去。
不做编码直接扔给树,树会按数值大小切,把"北京、上海、广州"当成 1、2、3 排序,切出毫无意义的规则。要么做目标编码,要么用 LightGBM 那种原生支持类别特征的实现。
第三个,拿 GBDT 做评分卡。
GBDT 的分数不单调,也不可加。你没法跟审批人说"这个客户因为年龄扣了 15 分"。真要做评分卡,还是得回到逻辑回归加 WOE。
第四个,忽视跨期验证。
随机划分训练测试集,AUC 0.85,上线三个月掉到 0.72。表格数据的分布漂移比图像文本严重得多,时间外采样验证是必须的,不能只做随机划分。
第五个,只调参不做特征工程。
见过一些团队,把调参当成主要工作,网格搜索跑了三天,AUC 从 0.782 调到 0.786,很高兴。
同一时间,另一个团队加了一个"近三个月查询次数"的特征,AUC 直接到 0.81。
树模型对特征质量极其敏感。特征里没有的信息,参数调破了也变不出来。调参的收益通常在千分位,好特征的收益在百分位。
第六个,把特征重要性当成因果。
GBDT 的特征重要性只说明"这个特征被用来切分了,且带来了增益",不说明它导致了结果。两个高度相关的特征,重要性会随机分给其中一个,看起来像是一个有用一个没用,其实是共线的。
11 一个真实项目里的选择
去年接触过一个消费贷的申请评分项目,样本 8 万条,坏账率 4.2%。
他们原来用的是逻辑回归加 WOE,KS 0.38。业务想要更高,问能不能上 GBDT。
我先跑了一版 LightGBM,深度 4,500 棵树,学习率 0.05,KS 到 0.46。提升很明显。
但问题来了:模型过不了合规。
合规的要求是"每个客户的拒绝理由要能说清楚"。逻辑回归能给出"因为负债收入比超过 0.6,扣 20 分",GBDT 给不出来。
我们试了几种折中方案。
第一种,用 GBDT 做特征筛选,把重要性高的变量挑出来,再进逻辑回归。KS 回到 0.41,比原来高 3 个点,可解释性保住了。
第二种,用 GBDT 的叶子编号做特征,再套一个逻辑回归。这在业内叫 GBDT 加 LR,KS 0.43,解释性打了折扣但还能接受。
第三种,双模型并行。GBDT 跑在后台做监控和额度建议,逻辑回归跑在前台做审批决策。KS 前台还是 0.38,但后台能提前发现异常客群。
最后落地的是第一种加第三种。
这个案例想说的是:模型选型不是比谁的 AUC 高,是在精度、解释性、合规成本之间找平衡点。GBDT 在纯精度上几乎总是赢,但它赢的那几个点,有时候换不来上线许可。
写在最后
三句话。
第一,GBDT 的本质是加法模型加前向分步。每棵树学的是当前损失的负梯度,平方损失下它恰好等于残差。
第二,学习率和树数必须一起看。学习率小最终更准但更慢,早停是最实用的定树数方法。
第三,分类任务不能用残差,要用对数损失的梯度加牛顿叶子值。这一步是很多人背概念时跳过的地方,也是 XGBoost 那些公式的真正来源。
如果你想动手,建议先把我上面那三十行回归树跑一遍,把深度改成 1、2、5,看拟合曲线怎么变。比看十篇文章都管用。
觉得有用点个赞,转给正在调参的同学。
本文内容为本人学习共享,仅供参考。