文献来源: Srivastava et al. Pyrite: Building and Benchmarking Protein-Ligand Pose Ranking Agents. arXiv:2611.14511v1,2026 年 11 月 10 日。
作者: Megha Srivastava、Michael H. Lim、Allison M. Keys、Pranav Murugan、Nate Gruver
研究机构: Stanford University、Genesis Molecular AI
发表信息: arXiv 预印版,2026 年 11 月 10 日
导读
随着 AlphaFold 3、Boltz 等蛋白–配体共折叠模型的发展,研究人员能够生成越来越多具有合理几何结构的候选结合构象。然而,如何从这些候选中准确识别接近实验晶体结构的结合姿态,仍然是制约结构预测实际应用的重要问题。Stanford University 与 Genesis Molecular AI 的研究人员提出 Pyrite,构建包含 1,500 对候选构象的排序基准,并设计两种基于大语言模型的 Agent:PyriteReasoner 直接进行化学推理,PyriteFeaturizer 则通过自动生成特征工程代码训练轻量级分类器。实验表明,传统物理评分和专家经验在高质量候选构象中均存在明显局限,而结合结构化分子信息、自动特征发现及强化学习的模型,最高取得 74% 的成对排序准确率。
一、为什么生成了正确构象,却仍然选不出来?
分子对接通常包含两个相互关联的任务:首先通过构象搜索生成可能的蛋白–配体结合姿态,然后使用评分函数识别最接近真实结合模式的候选。过去的研究主要关注如何提高构象生成能力,包括改善蛋白–配体相互作用建模、引入等变神经网络,以及通过扩散模型扩大构象搜索范围。
随着共折叠模型的发展,构象生成的研究重点开始发生变化。模型可能已经生成了接近实验晶体结构的姿态,但置信度评分、物理能量函数或者人工检查仍然无法准确找到它。特别是当多个候选都具有合理的氢键、疏水接触和分子几何时,简单的能量最小化准则未必能够区分它们。
这涉及一个容易被忽略的区别:能量评分较优,并不必然意味着构象更接近实验晶体结构。 MM-GBSA 等方法试图估计特定模型条件下的结合能量,而构象排序基准通常依据实验参考结构的 RMSD 判断正确性。两者存在联系,却并非完全相同的优化目标。
Pyrite 将研究问题聚焦为:给定同一蛋白–配体体系的两个候选构象 A 和 B,在不知道真实结合姿态的情况下,能否利用结构、化学和物理信息判断哪个更接近晶体结构?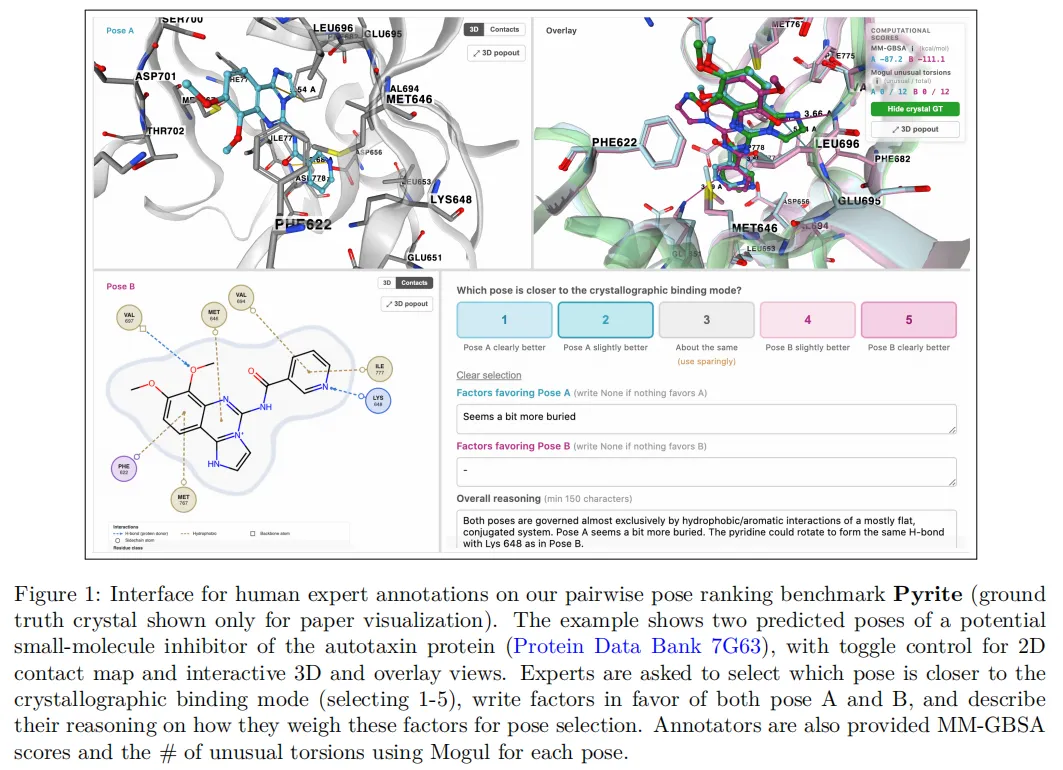
作者进一步提出一个值得研究的假设:传统物理打分未必缺少有用信息,问题可能在于不同评分信号相互冲突,而且它们在不同蛋白家族、构象质量区间中的可靠性并不一致。因此,需要一种能够理解上下文、组合多个信号并学习条件化判断规则的排序方法。
二、Pyrite 基准:专门研究高质量候选之间的排序困难
Pyrite 的一个核心贡献是构建了更有挑战性的成对排序数据。作者首先利用内部共折叠模型及多样性采样策略,对超过 50,000 个 PDB 结构相关体系生成候选构象,每个体系最多采样 120 个姿态。随后根据 MM-GBSA 评分保留前 25 个构象,并从中构建候选对。
这一选择非常关键。与直接比较一个明显发生严重碰撞的构象和一个合理构象不同,经过初步能量筛选后,候选往往都具有一定的几何与相互作用合理性。此时排序模型需要识别更加细微的差异,例如配体官能团方向、局部接触网络、口袋匹配程度和扭转几何。
作者进一步利用晶体参考结构建立三种质量类别。GOOD 要求 RMSD 小于 1 Å、lDDT-PLI 不低于 0.85、参考相互作用召回率不低于 0.90;MAYBE 主要对应 RMSD 为 1–2 Å、lDDT-PLI 为 0.5–0.85 的姿态;BAD 则对应 RMSD 为 2–4 Å、lDDT-PLI 低于 0.5 且相互作用召回率低于 0.5 的姿态。
其中,GOOD–MAYBE 被定义为困难样本,GOOD–BAD 为相对容易的样本。作者还通过实验电子密度支持、构象差异、蛋白结构对齐、金属离子缺失及配体类药性等条件进行过滤,避免将参考结构不可靠或无法公平比较的样本纳入基准。
最终,Pyrite 包含 1,500 对候选构象、285 个不同复合物结构和 1,799 个独立候选姿态。作者以 2021 年 9 月 30 日为时间切分点,区分 pre-AF3 与 post-AF3 数据,并在后者上评估 Agent。
这一设计提高了任务难度,但也决定了结果的适用范围:Pyrite 衡量的是经过特定共折叠生成器和 MM-GBSA 预筛选后的成对排序能力,不能直接等同于一般分子对接任务中的 Top-1 成功率。
三、核心方法:让 LLM 理解结构、发现特征并学习排序规则
3.1 PyriteRep:将三维分子结构转化为可推理的化学信息
直接向语言模型输入大量三维坐标,通常不能保证模型能够准确理解分子几何。坐标是连续空间中的数值,而语言模型主要通过离散 token 学习信息关系。如果没有显式的距离计算、结构识别和相互作用解析,大量坐标很难直接转化为可靠的化学判断。
为此,作者提出 PyriteRep,将分子几何、蛋白–配体相互作用和物理化学评分整理为结构化文本表示。论文将其描述为包含 29 项特征的表示体系,分为与姿态无关的信息和随姿态变化的信息。
前者包含蛋白名称、家族、UniProt 功能描述,以及配体原子、化学键、形式电荷、SMILES 和 IUPAC 名称。这些信息为 LLM 提供分子身份、官能团和靶标生物学背景。
后者描述候选姿态的具体几何与相互作用,包括回转半径、非球形度、最大空间跨度、分子内部近距离接触、残基接触数、氢键、盐桥、芳香堆积、扭转应变、Mogul 扭转异常指标、PoseBusters 有效性以及 MM-GBSA 评分等。
例如,回转半径由配体重原子坐标计算:
其中, 为配体重原子数, 为原子坐标, 为几何中心。回转半径可以描述构象的空间展开程度,但不能单独判断构象是否正确,因为真实结合构象也可能具有较大的伸展程度。
更重要的是,作者在 PyriteRep 基础上增加了成对比较信息,包括两种姿态共享或独有的相互作用、官能团位移、局部几何差异及关键评分变化。这使语言模型能够直接关注两个构象之间的化学差异,而不必自行从数百个坐标数值中寻找变化。
3.2 PyriteReasoner:利用结构化信息直接进行化学推理
PyriteReasoner 是一类直接决策 Agent。其输入为两个候选构象的 PyriteRep 描述,输出为对两者相对质量的分析以及最终选择。
模型需要综合判断多个因素。例如,一个候选可能具有更低的 MM-GBSA 能量,但另一个候选具有更合理的扭转构象、更充分的极性相互作用,或者更符合特定蛋白家族的结合特点。Agent 需要根据这些信息评估证据,而非固定选择某个评分最低的构象。
作者使用 Opus 4.8、Sonnet 5、GPT-5.6-sol 和 Qwen3.8-27B 比较不同语言模型,并设置五种输入方案:原始坐标、坐标加相互作用、完整 PyriteRep、去除原始坐标的 PyriteRep,以及加入相似配体检索示例的上下文学习。
实验发现,仅输入原子坐标时,大语言模型的准确率通常接近随机水平;显式提供相互作用后有所改善,而完整 PyriteRep 能带来更明显的提升。特别值得注意的是,移除原始三维坐标并不一定降低准确率,说明经过计算化学工具预处理的结构化描述,比未经解析的坐标更容易被当前语言模型有效利用。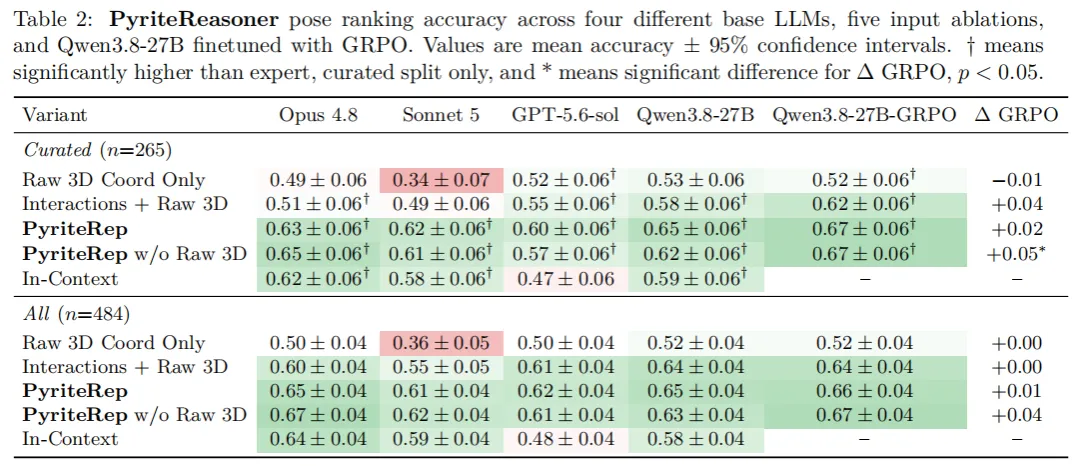
3.3 PyriteFeaturizer:让 LLM 生成特征,而不是直接决定答案
PyriteFeaturizer 是论文中更值得关注的设计。
作者认为,LLM 擅长利用上下文提出化学判断规则,但直接要求它输出最终答案,可能引入不稳定的主观推理。相比之下,可以让 LLM 将这些规则转化为能够实际执行的特征工程程序,再由传统机器学习模型完成统计学习。
具体而言,PyriteFeaturizer 生成 Python 函数,从 PyriteRep 中提取数值特征,并利用这些特征训练逻辑回归分类器。其决策形式可以概括为:
其中, 为两个候选的比较特征, 和 是由标注样本学习的参数, 为 Sigmoid 函数。
这一框架的核心在于,LLM 可以自主设计超出预定义描述符的新特征。例如,将两个候选之间的 MM-GBSA 差异经过 tanh 变换,以限制极端能量值的影响;根据蛋白家族设计不同的相互作用权重;或者组合扭转应变、接触数量与口袋类型,形成条件化的评分特征。
作者进一步设计了三种特征发现模式。Code Only 只允许 LLM 生成计算特征的 Python 代码;Protein LLM Subcall 允许程序调用 Qwen3.5-9B 提取蛋白家族、催化环境等上下文信息;Pose LLM Subcall 则进一步允许语言模型分别分析两个构象,例如判断氢键网络是否合理、极性基团是否得到满足、是否存在空间冲突,以及配体是否充分填充结合口袋。
因此,最终预测仍由逻辑回归完成,LLM 负责构建具有化学意义的输入特征。相比直接使用复杂语言模型进行每次判断,这种设计使特征定义可以显式检查,也能够通过消融实验分析各类信息的贡献。
3.4 GRPO:用真实排序表现优化 Agent 的行为
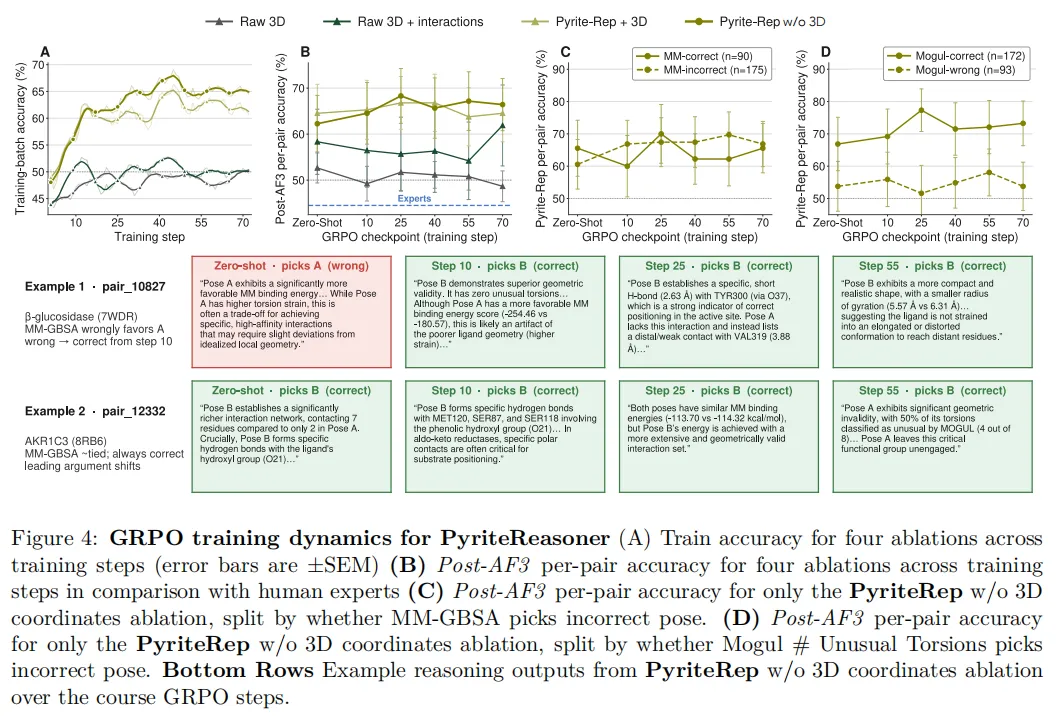
为了提高开放权重模型的能力,作者使用 Group Relative Policy Optimization(GRPO)微调 Qwen3.8-27B。
两种 Agent 的奖励设计存在明显区别。对于 PyriteReasoner,如果输出格式无法解析,奖励为 0;格式正确但排序错误,奖励为 1;排序正确,奖励为 2。模型通过这种反馈学习哪些化学判断更有助于最终选择。
对于 PyriteFeaturizer,奖励直接来源于生成代码的实际预测效果:程序必须成功执行、在规定时间内完成,并产生非恒定特征;随后使用训练池中按结构分组的五折交叉验证准确率作为奖励。执行失败、超过 20 秒或只生成常数特征的程序获得零奖励。
这种设计建立了一条明确的优化链路:LLM 提出特征规则,代码执行验证规则,分类器检验预测价值,强化学习再优化特征生成策略。
论文附录显示,两种 Agent 均采用 LoRA 微调,rank 为 16、alpha 为 32,约训练 7,970 万个参数,使用 8 张 H200 GPU。PyriteReasoner 训练 72 步,PyriteFeaturizer 训练 100 步,并针对长代码输出设置长度惩罚。这里的强化学习主要改善化学信息的解释和特征构造能力,并未直接训练一个新的三维构象生成网络。
四、实验结果:物理评分、专家经验与 Agent 究竟差在哪里?
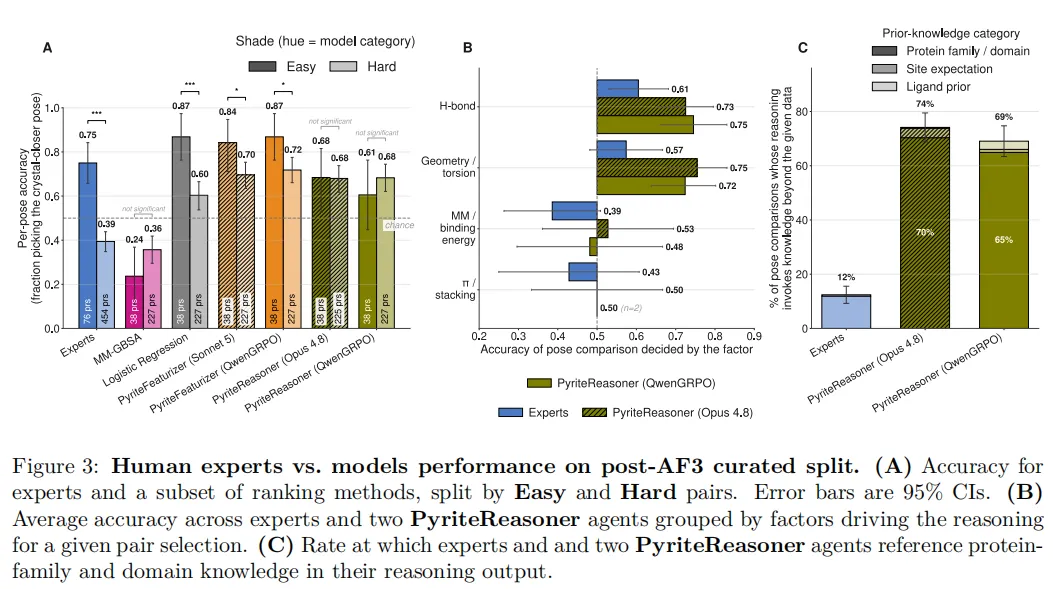
作者首先考察单一评分函数和人类专家的表现。五位具有丰富计算机辅助药物设计经验的化学专家参与标注,每对构象由两位专家判断,整体标注者一致率达到 77%。
然而,在 post-AF3 curated 测试集上,将无法明确选择的回答计为错误时,专家准确率为 45%;只统计明确选择的回答,准确率提高到 57%。这说明专家并非完全无法识别正确姿态,但在这些具有细微差异的候选之间,判断仍然存在较大不确定性。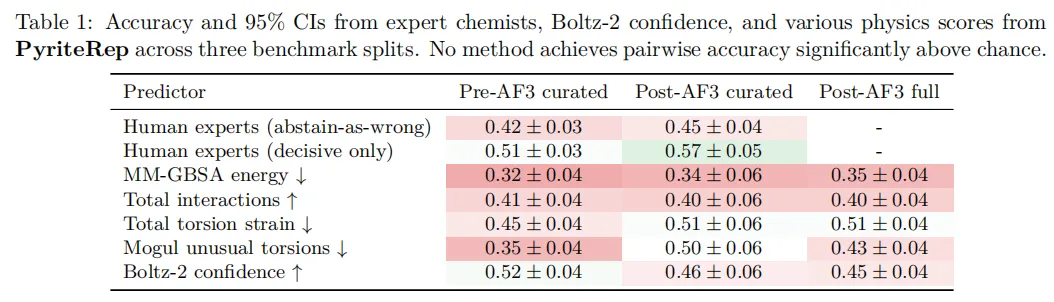
更值得关注的是 MM-GBSA。按照能量越低越优的传统规则,MM-GBSA 在 post-AF3 完整测试集上的准确率仅为 35%。作者认为,原因可能在于候选已经通过 MM-GBSA 进行严格预筛选,剩余构象都具有较有利的能量评分,从而削弱甚至反转了能量与晶体相似性的统计关系。
主要结果如下:
表中 PyriteReasoner 采用相应测试集上的最佳 GRPO 输入方案,PyriteFeaturizer 采用 Pose LLM Subcall 配置。
这组结果揭示了三个重要现象。首先,结构化特征显著提高语言模型的判断能力,说明有效的化学表征仍然是分子科学 Agent 的重要前提。其次,普通逻辑回归已经具有较强竞争力,说明预计算物理化学特征本身包含可学习的预测信息,复杂网络并非取得有效排序的必要条件。
第三,LLM 引导的特征发现进一步提高了性能。最优 PyriteFeaturizer 在 curated 集上取得 74% 的准确率,相比普通逻辑回归提高 10 个百分点;在完整测试集上达到 71%,相比普通逻辑回归提高 11 个百分点。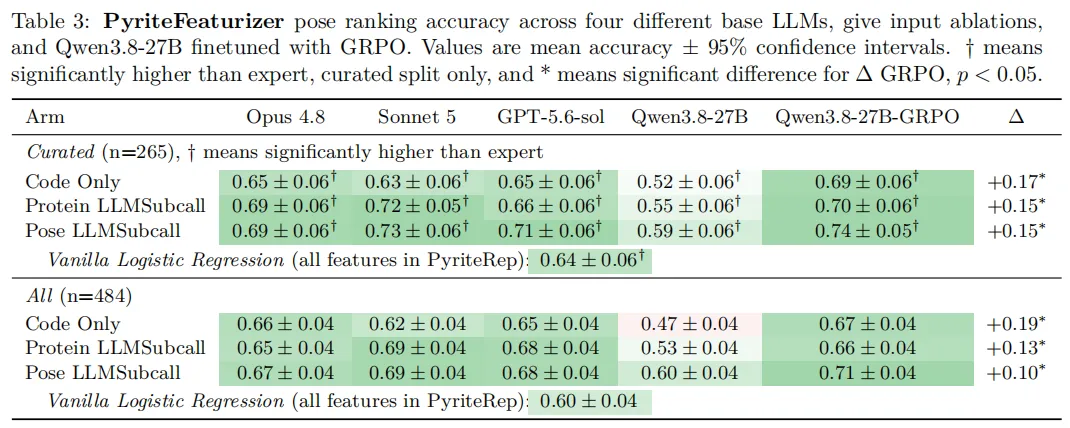
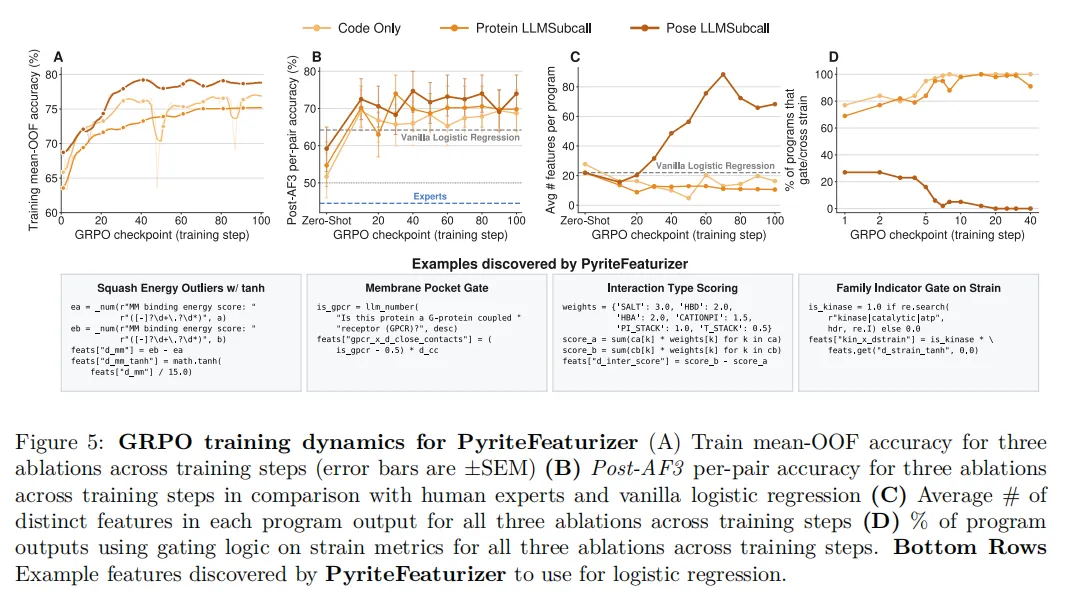
作者还研究了直接反转 MM-GBSA 排序方向的简单基线。该规则在完整测试集上达到 64.7%,说明部分性能提升可能来自识别这一特殊数据区间中的反向统计规律。不过,强化学习后的 PyriteReasoner 达到约 67.4%,且与反转规则的逐样本选择一致率仅为 51.4%,表明它并非简单复制反向 MM-GBSA 判断。对于最高达到 71% 的特征发现模型,仍需要更多跨生成器实验判断提升能否稳定泛化。
五、这项工作真正值得借鉴的是什么?
Pyrite 最重要的方法论启发,是重新审视物理打分与机器学习的关系。传统评分函数提供能量、应变和相互作用等信息,但这些信息是否能够预测接近晶体结构的程度,取决于候选构象分布、蛋白环境和数据筛选方式。物理项可以作为模型输入,却未必应被固定解释为对所有候选都单调有效的排序规则。
第二个启发是将语言模型的化学知识转化为显式数值特征。相比直接要求 LLM 给出正确构象,自动特征发现能够把蛋白家族知识、相互作用判断与传统物理指标组合起来,再利用标注数据估计其真实预测价值。这种方式为建立可分析、可校准的 AI+Physics 评分体系提供了参考。
第三个启发来自强化学习的奖励设计。PyriteFeaturizer 没有依赖代码是否写得复杂、解释是否符合化学直觉来评价 Agent,而是通过按结构分组的交叉验证准确率进行反馈。这使强化学习目标与实际排序任务建立直接联系,也为其他计算化学 Agent 的工具使用与规则发现提供了可迁移的思路。
六、局限性:74% 的排序准确率意味着什么?
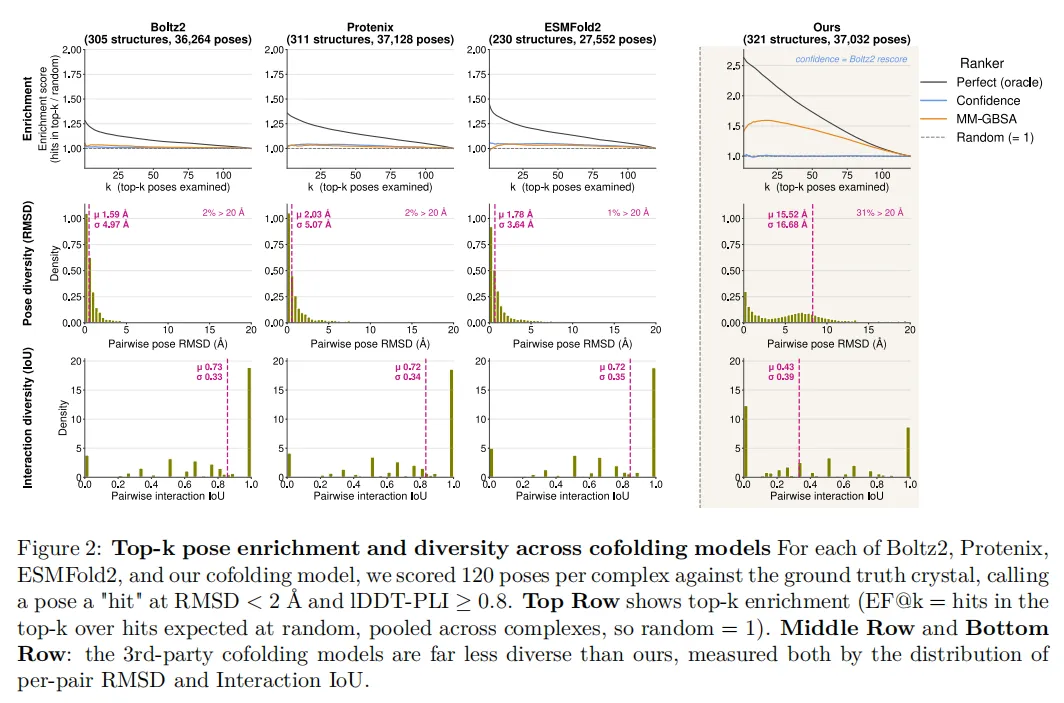
首先,Pyrite 的构象来自专有共折叠模型及其多样性采样流程。虽然作者展示了该方法相较部分公开模型生成的姿态更加多样,但关键生成机制并未充分公开。因此,当前结果不能证明相同的排序策略能够直接迁移至 Vina、Glide、DiffDock 或其他构象生成器。
其次,数据集构建涉及 MM-GBSA 预筛选、晶体结构指标和电子密度支持条件。严格的过滤提高了参考标签的可信度,却也改变了样本分布。MM-GBSA 在该基准上的反向相关现象不能直接推导出物理能量评分在一般分子对接任务中无效;它更可能反映特定预筛选条件下,剩余评分信号与晶体相似度之间的关系发生变化。
第三,人类专家与 Agent 的输入并不完全对等。专家主要获得三维可视化、二维相互作用图以及有限的物理评分,而模型可以使用更加丰富的 PyriteRep 特征;此外,专家允许表达不确定性,但主要准确率将弃权计为错误。因此,论文展示的是不同信息条件下的实际表现差异,尚不足以严格证明 LLM 的化学推理能力全面超过专家。
第四,论文采用时间切分,但时间切分不等同于严格的蛋白家族和配体骨架留出。相似蛋白、相似化学系列及语言模型预训练时可能接触过的结构知识,仍可能影响评估。多个构象对还可能共享同一复合物,因此,独立复现需要明确按样本还是按结构汇总准确率,并采用适当的分组统计检验。
最后,成对排序能力与实际多候选排序仍存在距离。即使两两比较达到 74% 准确率,也不能保证在包含几十甚至上百个候选的真实任务中稳定识别 Top-1 构象。排序一致性、推理开销、不同生成器之间的可迁移性,以及最终对虚拟筛选和实验命中率的影响,仍需要进一步验证。
七、未来意义:从构象评分走向可学习的化学决策系统
Pyrite 的研究价值并不局限于利用 LLM 改进分子对接排序。它展示了一种更普遍的科学计算思路:将传统计算工具的定量输出、结构化分子知识和数据驱动的决策模型整合起来,使模型学习在不同环境下如何使用物理信息,而非始终依赖固定经验规则。
从药物发现的实际需求来看,未来更值得探索的是将这一框架拓展至跨靶标、跨骨架和跨构象生成器的统一排序,并进一步纳入更明确的物理有效性约束、相互作用方向性、溶剂环境和构象不确定性。若能证明自动发现的特征在严格分布外测试中仍然有效,便有机会将 Agent 从辅助分析工具发展为可复用的计算化学评分组件。
总体而言,Pyrite 已经证明结构化分子信息、自动特征工程与强化学习可以在特定困难构象排序基准上形成有效互补。至于这种优势能否转化为真实药物发现流程中稳定、可靠的构象选择能力,仍需要更广泛的独立验证。