相信各位在学习agent开发时对RAG这项技术早就越有耳闻,但对于一些人来说(就是我)其中的各个策略细节以及几种范式的原理、边界认识还不够清晰。为了防止面对各种名词一脸懵逼的情况再次发生,我把几个最常见的策略和范式按照自己的理解梳理并实现了一遍,让它们跑同一批语料、同一批问题、同一套评测指标,并根据真实的评测结果写下这篇文章,希望能给各位带来一些思考与启发,帮助大家查漏补缺,促进共同进步。
模型不知道的东西分两类。一类是没学过,比如上个月刚发生的事;一类是学不到,比如你公司的报销制度、你自己的笔记、上周改过的那份产品文档。前一类通常等模型更新,或者接一个实时搜索;后一类只能从外部找资料。
RAG 处理的就是后一类。流程很朴素,资料先存好,提问的时候取相关的几段,跟问题一起交给模型,让模型照着这几段回答。更准确地说,RAG 是一组给 LLM 和 Agent 补信息缺口的技术。为了达到这个目的,有时候是经典向量检索,有时候是 GraphRAG、LightRAG 这样的知识组织方式,有时候是 Agentic RAG,让 Agent 自己决定要不要再查一次;反过来,有些问题也不该用 RAG,grep、LLM Wiki、Memory、上下文压缩、结构化查询也都能解决同一类需求。
这个思路 2020 年由 Lewis 等人提出来,论文里把它叫检索增强生成。当时的动机和现在不太一样。那时候模型参数小,检索是为了补知识。现在的旗舰模型参数已经够多,检索更多是为了补“此刻需要,但不在参数里”的那些信息。
2025 年之后上下文窗口一路涨到1M token 量级,于是有了另一种说法,把资料整本塞进去就行,RAG 这套东西可以退休了。
这个说法在三件事上站不住。
第一件是钱。检索一次交给模型的是五段,这次实验里五段加起来通常不到一千字。把十万七千段全塞进去是一千二百万字,差了一万倍。这笔钱每次提问都要付一遍,语料越大差得越多。
第二件是等待。模型要把输入读完才能开始输出,输入越长,用户盯着屏幕的时间越久。问答场景里这个延迟是能直接感觉到的。
第三件最难察觉。模型的注意力分布在全部输入上,塞进去的无关内容越多,真正有用的那几段分到的注意力越少。答案读起来仍然流畅,只是悄悄偏了,也就是我每次说的“幻觉”。这一条比前两条都麻烦,因为它不会报错,只会答错。
综上所述,检索这一步还是得留着。接下来的问题是,为了达成更好的效果,中间都要使用哪些策略?这些策略在真实情况下效果究竟如何?值不值得加?
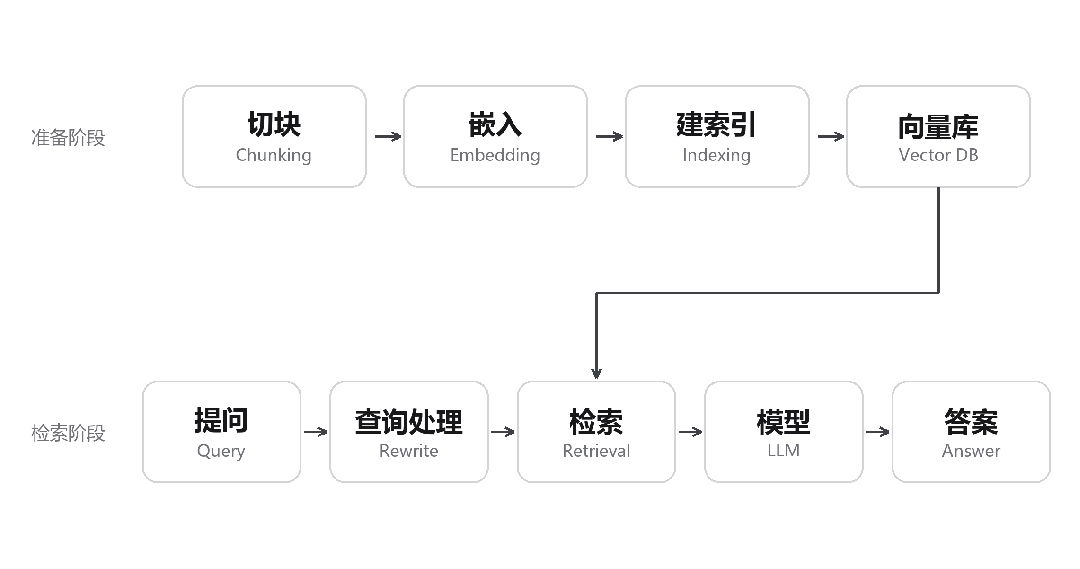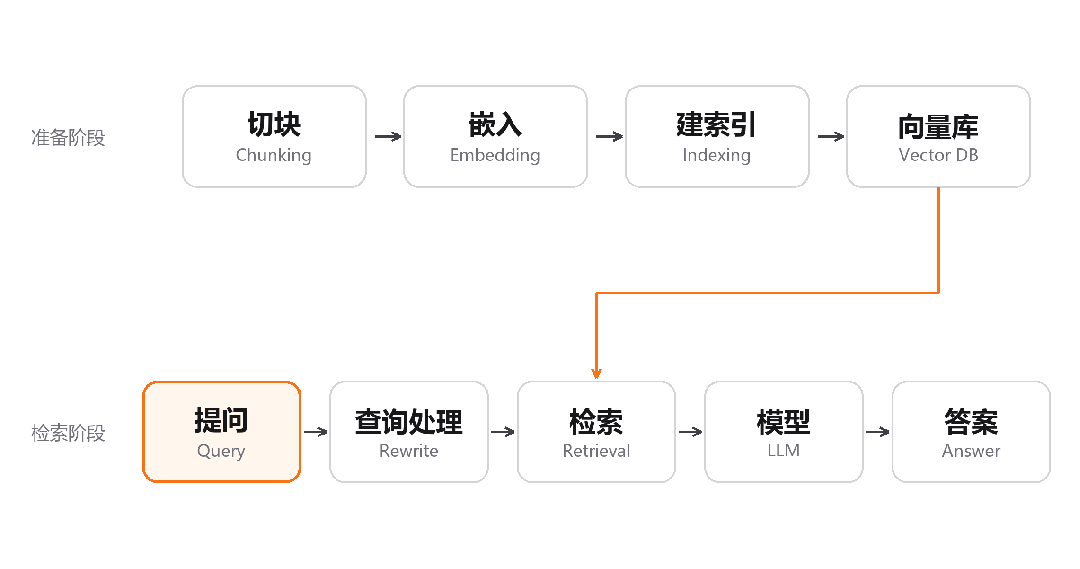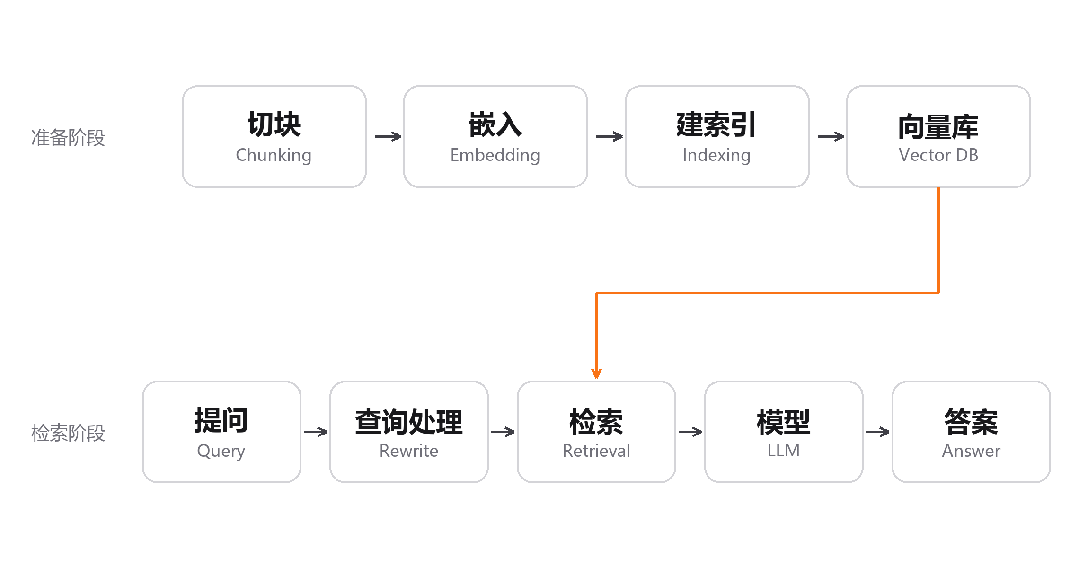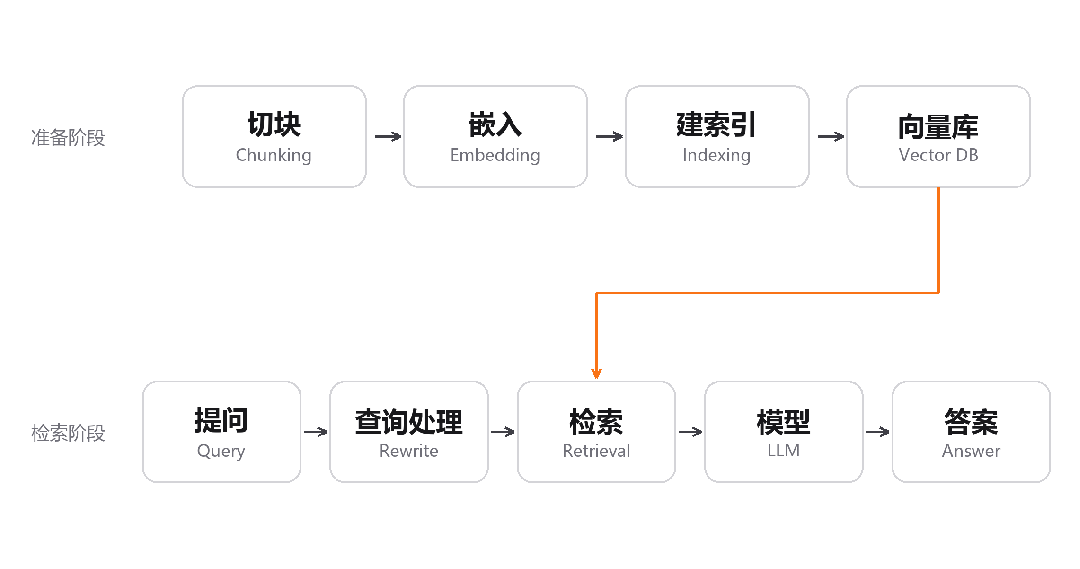
图 1 RAG全流程示意图:准备阶段把资料放进去,检索阶段把它取出来
后面讲的每个策略,位置都在这个示意图中。还有一类改动更大,换的是整条走法,那些放到最后讲。
在讲策略之前,你可能会问,我凭什么说某个策略好或不好?总不能我说什么就是什么吧。为此我搭了一套评测,用真实数据标出每个策略和范式的边界,方便你后面做选型,也让你看上去更专业。毕竟,“没有评估闭环的 RAG,只是一个看起来会检索的聊天机器人;有评估闭环的 RAG,才是可以持续优化的工程系统。”
要横向比较,前提是只让“策略”这一个变量变动——也就是我们在中学课堂上就学过的 “控制变量法”。向量索引和生成模型用同一套,提示词、温度、取前五段的预算也都尽量不动。
我把每个策略写成一个只做检索的函数。输入是问题和索引,输出是候选段落。生成、裁判、打分全部复用同一套代码。这样差异只能归到检索上,不会混进提示词或者采样参数的影响。
想搭建自己的 RAG 评测体系,首先要确定好几件东西:语料(用什么数据、多大规模、题目从哪来)、指标(检索层看什么、生成层看什么)、样本量(你打算分辨多大的差异)。还有一个容易被忽略的口径问题,决定你的分数能不能跟别人比。
2.1 评测语料的选择
选择测试集时,要确保测试集尽可能覆盖四类问题:单跳具体问题、单跳抽象问题、多跳具体问题、多跳抽象问题。我的语料选了三份,各自回答不同的问题。
第一份是 MMarco 中文版,十万七千条网页段落,题目取自真实的 Bing 搜索词,一开始取了六十道,后来补到三百道。选它的理由很具体,query 和文档来源不同,一边是搜索日志,一边是网页正文,词汇重叠低,能拉开差距。
这一点值得多说两句,因为我在这儿栽过一次。最初用的是另一份数据,百度知道那种问答对,query 和标准答案来自同一个页面。结果 baseline 的 hit@5 直接是 1.000,检索层饱和了,七个策略的差异全部落在裁判噪声里,一个都测不出来。我查了一阵实现,最后发现是数据的问题,题目和答案出自同一页,检索这一步本来就没什么难度。
第二份是 MultiHopRAG,六百零九篇英文新闻长文,平均一万字符,切成七千六百六十九块。四十五道可答题,外加十五道在语料里根本没有答案的题。这份数据是为了测多跳和长文档,短段落那份测不了这两个。
第三份是《民法典》,九百零三条,按条切块,平均八十三字。三十七道题,每道题的构造方式都一样,提问用 A 的措辞,答案只在 B 里。这份专门用来测块与块之间的引用关系。
我选的这三份语料各有偏向,读数字时得知道。MMarco 的题目来自真实搜索日志,最接近线上流量,但语料只有十万段,比真实任务容易。MultiHopRAG 是英文新闻,长文档和多跳都有了,可它跟中文业务的分布差得远。民法典那份最特殊,题目是按 A 的情境、B 的答案构造的,天然偏向关系型方案。任何一条结论,我都尽量在两份以上的数据上看同向。只有一份数据支持的结论,我会写明。
最后说一下口径,也就是这批数字是在什么范围里算出来的。用什么数据、语料多大、多少道题,都算口径的一部分。口径不同,分数不能直接进行比较。我用的MMarco 这份其实是 C-MTEB 子集,十万七千段,真实 MS MARCO 有八百八十万段。民法典数据集只提供九百零三条,全文是一千二百六十条。所以本文所有绝对分数都不能对标公开榜单,只用于组内比较。
| | | |
|---|
| | | |
| 609 篇长文,7,669 块,45 + 15 题 | | |
| | | |
数据来源
MMarco huggingface.co/datasets/C-MTEB/MMarcoRetrieval
MultiHopRAG huggingface.co/datasets/yixuantt/MultiHopRAG
民法典 github.com/13098806890/laws-data
2.2 评测指标的选型
检索层只用两个指标,hit@1 和 hit@5。这名字来自以前搜索引擎那套传统评测,MS MARCO 这类榜单就已经用了很多年。
hit@k 的意思很朴素。把检索结果按相关度排成一列,看标准答案有没有出现在前 k 个里面。排在第一,这道题的 hit@1 记 1;排在前五,hit@5 记 1。所有题取平均,就是这组题上的 hit@k。六十道题里五十七道命中,hit@5 就是 0.95。
两个指标问的是两件事。hit@1 问第一眼准不准,用户多半只看第一条。hit@5 问有没有漏掉,因为前五条会一起交给模型,只要在里面,模型就有机会用上。后面会看到,很多策略的差别只在其中一个指标上显形,只盯一个会得出完全相反的结论。
长文档上还得多做一步映射。一篇新闻被切成几十块,答案往往散在好几块里。MultiHopRAG 每题平均二十五个标准块,按块算 Recall@5 的天花板是 5 除以 25,也就是 0.2,谁跑都是这个数。所以检索到的块要先还原成它所属的文章,去重之后再算命中。这一步不做,长文档检索的所有结论都是废的。
检索层三个指标,分工不一样
检索到了不等于答对。答案质量得单独测,我直接使用了业内常用的RAGAS,2023 年提出的一套RAG自动化评测框架,包含以下五项指标:
答案质量五项,各管一件事
| | |
|---|
忠实度 Faithfulness | 答案里的话有没有依据 拆成论断,逐条回查上下文 | |
答案相关 Answer Relevancy | 有没有答到问题上 从答案反推一个问题 | |
上下文精确 Context Precision | 检索段落里有多少有用 逐段判断与问题是否相关 | |
上下文召回 Context Recall | 该有的段落拿到没有 用参考答案反查需要哪些段落 | |
答案正确 Answer Correctness | 跟参考答案比对不对 语义相似度加论断重合度 | |
这五项没有一项是人手工打的分。做法是让另一个模型读问题和上下文,自己判断、自己给分,业内把这种做法叫LLM-as-a-Judge,用模型当裁判。这次当裁判的是 DeepSeek 的模型,提示词全程固定。
用模型当裁判便宜,也能批量跑,但也是有代价的。分数会抖,同一份材料喂两次未必一样;裁判还有自己的偏好,换一个模型,绝对分可能整体平移。所以这类分数适合组内比较,不适合跨论文对表。
前四项只要问题和上下文,不用人写标准答案;第五项才要参考答案。这也是 RAGAS 流行的原因。
问题出在答案长度上。MMarco 的参考答案平均二十八个字,MultiHopRAG 的答案多是两三个词的实体名,比如一个人名。论断抽取和反向出题这两步都是按成段文本设计的,遇到一个词就退化了。所以短答案场景我另算一个更笨的指标,看参考答案有没有出现在回答里。两套都跑,结论以这个笨指标的量级为准。
2.3 样本量与噪声
还有一件事决定多大的差距才算差距。裁判噪声实测约正负 0.03。同一份上下文喂两次裁判,上下文精确会差 0.026,十五道题里十三道完全相同,两道跳变。小于 0.03 的差距我一律当噪声。
生成层每个策略只测二十题,单指标标准差约 0.1。所以均值得配合逐题配对看方向,赢多少题、输多少题。只看均值,会被两三道题的跳动带跑。
配对的做法是把每道题的差值当成一个样本,赢记正、输记负、平记零,有放回地重抽一千次,看差值的分布有没有跨过零。跨过的当作没结论。这套算法叫 bootstrap,好处是不用假设分数服从正态分布,二十道题这种小样本也能用。这次所有标了置信区间的地方都是这么算的。
样本量这件事,我一开始完全没概念。六十道题上,hit@1 的标准误约 4.7 个百分点。三百道题上压到 2.0 个百分点。这个数字后面会救回一个策略,现在先记住它。
我将从一条什么都不加的流水线讲起,在此基础上逐步拓展各个策略及范式。切块、嵌入、建索引、检索、生成。问题进来,检索一次,取前五段,交给模型,结束。整个过程没有分支,没有回环。
这就是 naive RAG,后文中也叫 baseline。
它在数据上的位置是这样的。MMarco 六十题,hit@1 是 0.783,hit@5 是 0.950。同一份数据扩到三百题,两个数都降了,0.697 和 0.897。两份数据的难度本来就不一样。六十题那份偏容易,题目变多以后覆盖了更多难例,数字自然下来。这两组不要混着比。
MultiHopRAG 上,文档级 hit@1 是 0.600,hit@5 是 0.978。
这里有个地方值得停一下。hit@5 到了 0.978,四十五道题里只有一道没把正确答案所在的那篇文章捞进前五。可答案命中率只有 0.600。检索几乎没漏,答对只有六成。
差距就出在中间那一步。资料摆在模型面前,模型没有用上。
naive RAG 会在三个地方断。
库里根本没有相关内容,检索必然空手。这种情况换策略也没用,得回去补语料。
内容在库里,但没排进前五。这是检索层的问题,混合检索和重排解决的就是这一段。
内容排进来了,模型却没用上。它可能把五段材料平均地概括了一遍,真正的答案被稀释掉;也可能答案在第三段的最后一句,而模型只读了每段的第一句。这一类最隐蔽,因为检索指标看起来很好,你会以为是模型能力不够,转头去换更大的模型。
这次实验里,检索几乎没漏而答对只有六成,落差大部分属于第三类。
naive RAG 的优点也很实在。便宜、快、行为可预测。同样的问题问两次,拿到的资料是一样的。它的每一个失败都能定位到具体环节,这对调试很重要。所有策略都拿它当对照,后面出现的每一个百分点,都是相对它算的。
取前五段这个预算,比它看起来重要。取三段,答案常常不够,模型只能靠猜。取十段,上下文变长,读得慢,噪音也多,真正有用的那几段反而被稀释。五个左右是常见的折中。预算固定还有一个好处,策略之间的比较不会被谁给的资料多污染。后面讲引用扩展的时候会看到,它为什么代价明显,就是因为它在这个固定预算里挤掉了别的位置。
准备阶段的第一步是切。切法直接决定后面能检索到什么。
最省事的做法是定长切,数够一定字数就断开。问题很直观。假设一段退货政策这样写:
EXAMPLE
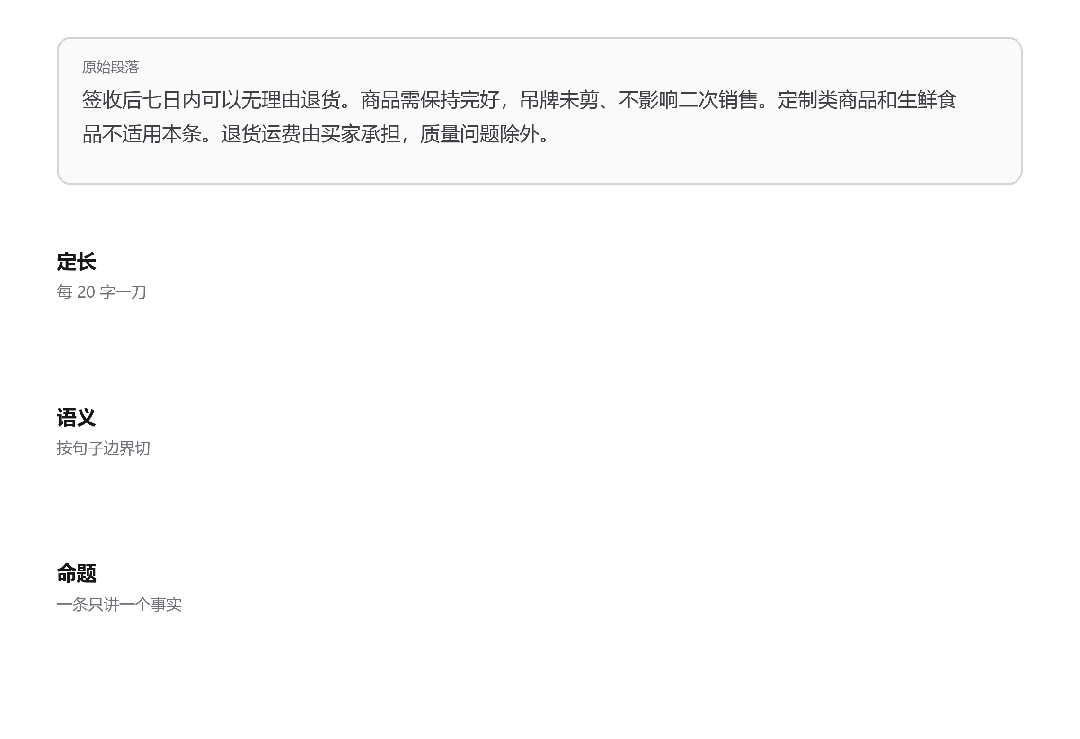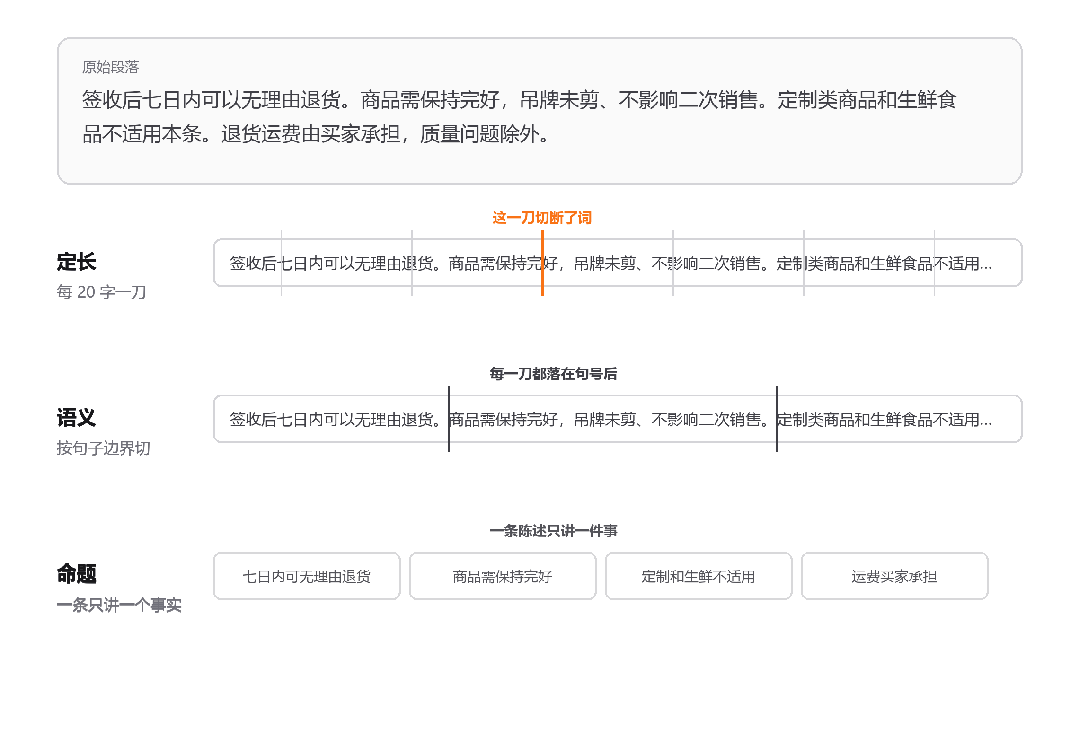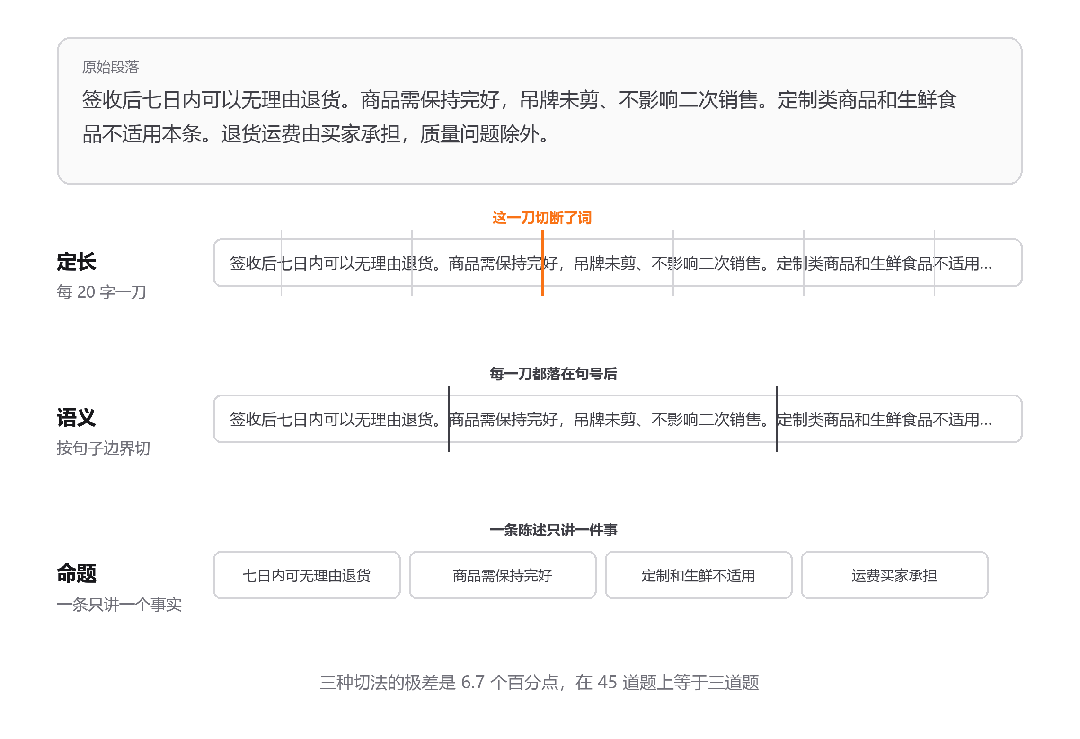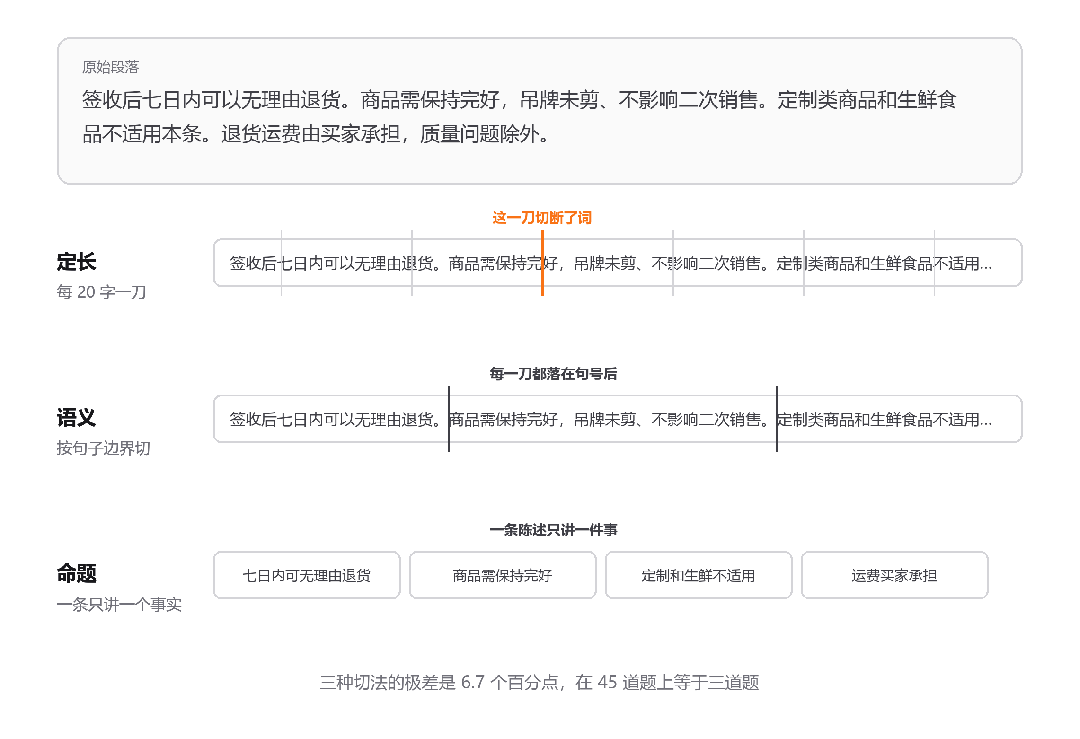
签收后七日内可以无理由退货。商品需保持完好,吊牌未剪、不影响二次销售。定制类商品和生鲜食品不适用本条。退货运费由买家承担,质量问题除外。
为了把切点看清楚,把刀改密,每二十字切一刀。第一刀就落在“完好”中间,前一块停在“商品需保持完”,后一块从“好”字开始。这样切出来的两块交给模型,模型只能靠猜。
第二种叫语义分块。先把每个句子转成向量,相邻句子的向量距离近,说明还在说同一件事,就合进一个块;距离远就断开。切点因此落在意思转换的地方,不会落在句子中间。代价是要先把每个句子都编码一遍,一篇长文几百句,这笔开销在建索引时就付掉了。
断开的那条线不是全局常数,按每篇文档自己的分布算。这次用的是相邻句子相似度的 75 分位,低于这条线就断,再用 200 字下限和 1000 字上限兜住,免得切成一堆碎句。按每篇自己的分布算,比手调一个固定阈值稳,长文和短文的尺度不一样。
第三种叫命题分块。先用 LLM 把长文拆成一条条原子陈述,每条只讲一个事实,再拿这些陈述建索引。上面那段话会被拆成四条。“七日内可无理由退货”“商品需保持完好”“定制和生鲜不适用”“运费买家承担,质量问题除外”。每条都很短,语义很单一。
图 2 同一段文字,三种切法给出的边界不一样
三种切法在四十五道多跳题上的结果,测的都是不加任何策略的检索器。
命题的 hit@1 最高,定长的 hit@5 最高,语义两头都不突出。三个数之间的极差是 6.7 个百分点,在四十五道题上等于三道题。
两种极端都能解释。块切到六十八字,一条陈述只讲一件事,向量很干净,最相关的那条容易被顶到第一。代价是一篇长文被拆成上百条,同属一个话题的其他信息散在各处,要凑齐前五名就难。定长块一块八百七十字,上下文都带着,容易把前五名填满,可块里的杂质也拉低了排在第一的概率。
粒度是个取舍。细的容易顶第一,粗的不容易漏。这不是优劣。
内容保留率那一列也值得看。命题分块只保留了 70% 的原文,因为有些句子是描述性的,抽不出事实陈述,被丢掉了。定长的 117% 是重叠造成的,同一个句子在相邻两块里各出现一次。这个数字要写出来,不然容易以为三种切法处理的是同样多的内容。
还有一个更好的组合。语义分块配重排,hit@1 是 0.778,全场最高,比定长配重排高 2.2 个百分点,比语义分块自己高 15.6 个百分点。
这个结果说明分块的收益未必体现在直接召回上。语义切法单独用的时候 hit@1 只有 0.622,比重排一配就跳了十五个点。它做的是给重排提供更好的素材,候选本身更干净,交叉编码器判断起来更容易。切块和重排是配套的,单独评价切块会低估它。
比切法更基础的一个参数是块的大小,它决定的是另一类错误。块太大,一块里塞了三四个话题,向量被平均成一个模糊的方向,跟谁都沾一点,跟谁都不精确。块太小,一句话缺主语、缺前提,单独拿出来看不懂,模型拿到也只能猜。常见的折中是几百字,再带一点重叠,让正好跨在边界的那句话在相邻两块里各出现一次。
我这次定长切用的就是一千字符加一百五重叠,重叠也是保留率超过 100% 的原因。
要为切块操心的场景只有两种。答案本身跨在边界上,或者文档结构自带语义。法条按条切、代码按函数切、表格按行切,效果比按字数切稳得多,因为作者已经把语义边界画好了。反过来,在一千字量级、事实型问答的场景里,切法不是关键变量。这组数据里三种切法的差距在噪声边缘,谁也说不上比谁强。
实践里常见的起步方案通常很朴素:递归切分 + 10%-20% overlap + 保留章节 metadata,然后用 Context Precision / Recall 看 bad case。
准备阶段还剩两件事,把切好的块变成向量,再把向量和原文存起来。这两步决定了检索的上限,也决定了很多看起来像检索问题的毛病,其实根子在这里。
5.1 嵌入
嵌入是把文本变成一串数字,通常几百到几千个。这串数字单独看没有意义,有意义的是两串放在一起比。意思接近的两句,数字串指向的方向接近;意思不相干的两句,方向几乎垂直。所以“找语义相近的段落”在数学上就是“找方向最接近的向量”,常用的度量叫余弦相似度,方向一致算 1,垂直算 0。
通用的嵌入模型在大多数场景里够用,因为它在海量文本上学过词的用法。遇到术语体系很强的领域会出问题。不要迷信“最强 embedding 模型”,要看语种、领域、文档长度、成本、延迟等指标,以及它是否真的提高了端到端答案质量。
法律里的“定金”和“订金”是两个概念,前者不退,后者能退。在通用模型的向量空间里,这两个词只差一个字,可能贴得很近,检索时互相污染。再比如医疗里的阴性/阳性、代码里的 list 和 ls,都是同一类麻烦。用户搜“订金能不能退”,系统把“定金不退”那一段取上来,答案就成了反的。
解决办法通常是换领域专用的嵌入模型,或者拿自己的语料把通用模型再训一遍。前者的成本是重新建一次索引,后者还要一批标注数据。
因为我准备的三份语料里没有真正的垂直领域文本,给不出数字,所以这一部分的策略我就没测,只能给判断。如果你的资料术语密集,比如合同、病历、代码,值得单独试一版领域嵌入。如果语料是新闻、百科、产品文档这种通用表达,换领域模型的收益通常撑不起这份成本。怎么判断要不要上领域模型呢?拿二十个只有行内人分得清的近义词去搜,看前五段是不是你想要的那几段。
5.2 索引
索引这一步把向量和原文一起存进数据库。我这次实验的规模只有十万段,向量直接放内存里做矩阵乘法就够,没引入专门的向量库。再往上走,项目小的时候 SQLite 配 sqlite-vec 插件够用,数据量大了换 PostgreSQL 配 pgvector,好处是能跟业务数据放一起,做权限过滤少一次跨库调用。
除了向量和文本,通常还要存一些结构化字段,标明内容的日期、来源、类型,这类字段我们通常叫做metadata。检索时按这些字段过滤,能挡掉一大批本来就不该出现的结果。比如法条检索限定现行有效版本,客服检索限定产品型号等等。metadata 不是装饰品,它决定了后面能不能做权限过滤、章节过滤、时间过滤、引用溯源。很多“RAG 答错”的根因不是模型差,而是文档入口就把正文、页码、标题层级或者表格语义这类字段弄丢了。
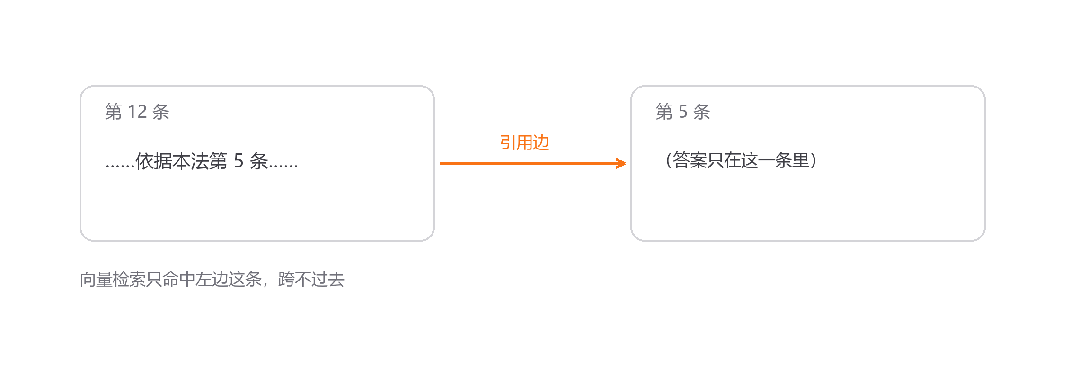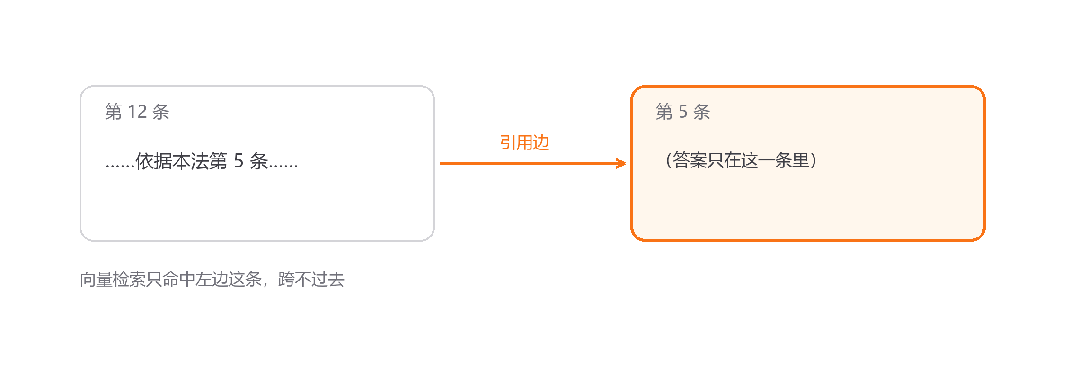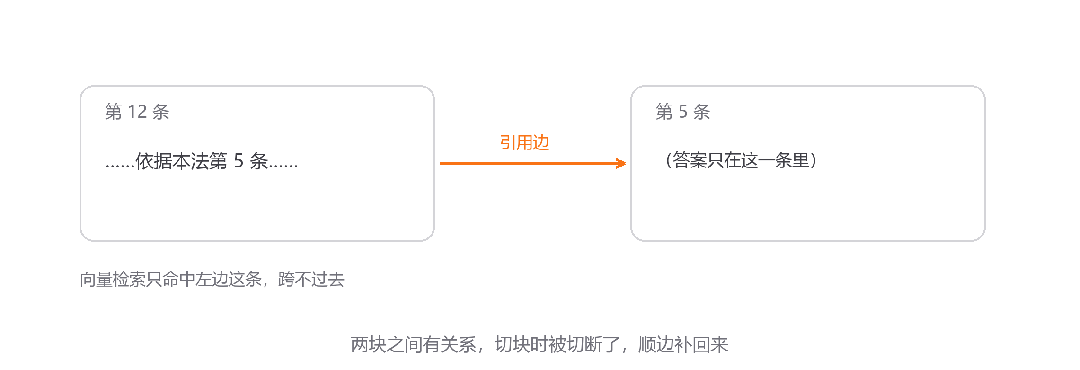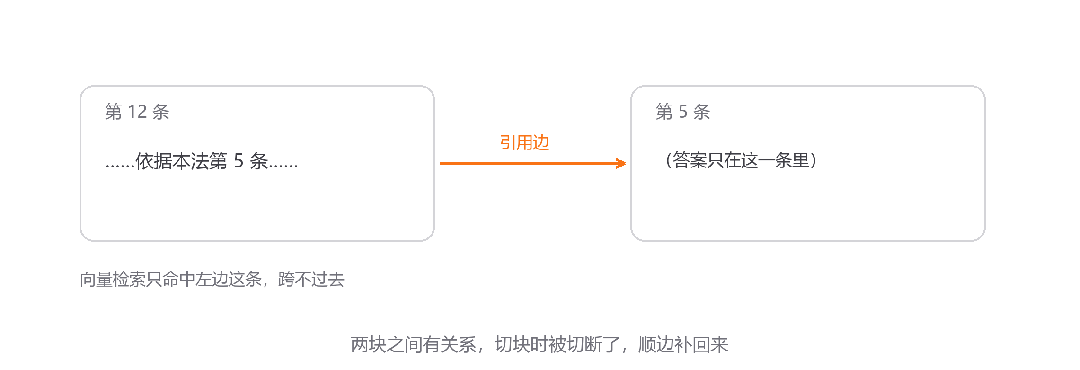
普通方式建索引这一步还会丢掉一样东西,即块与块之间的关系。比如,原文里的第 12 条写着“依据本法第 X 条”,切块之后 X 落在另一个块里,数据库不知道这两块有关系。取到第 12 条的时候,那个 X 不会跟着放入上下文中,造成检索信息遗漏,效果不佳。
这是准备阶段的最后一个缺口。补它的方案放到后面第八节的Graph RAG范式来讲,因为那已经不是简单地改零件了。
前面提到的几个策略都在“资料和索引”那一侧进行优化,接下来这一节的两个在“问题”这一侧。一句话问得不好,检索就跟着不好。
我先给结论吧:我的测试里,在干净、完整的 query 上,这两个都掉分。它们只在一种情况下值得加,就是用户说的是半句话,而前文能把那半句补回来。
6.1 查询改写
用户的问题和文档的措辞经常对不上。用户问“我这种情况能不能退”,文档写的是“七日无理由退货的适用条件”。两句话意思相通,字面几乎不重叠,向量能救一部分,救不了全部。
改写的做法是让模型先换几种说法再搜。最常见的是补全,把“这个”换成它指的东西;也可以拆开,把一个比较题拆成两个问题分别搜;或者放宽,把过窄的表述换成更常见的说法。几路结果按名次合起来,重新排一次。
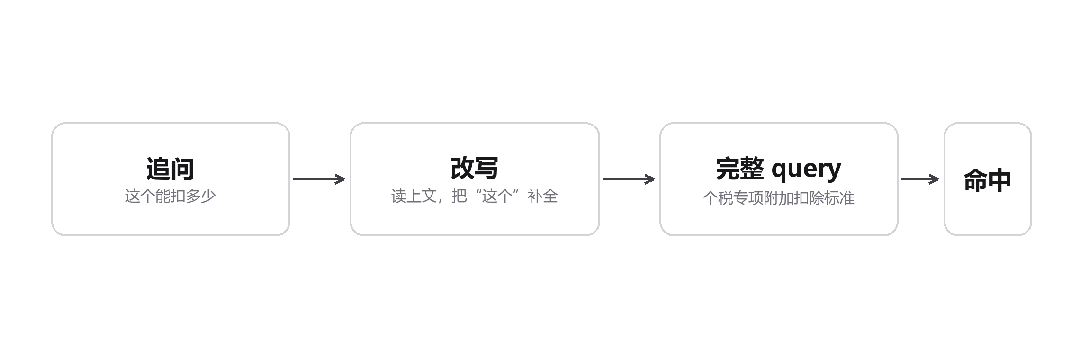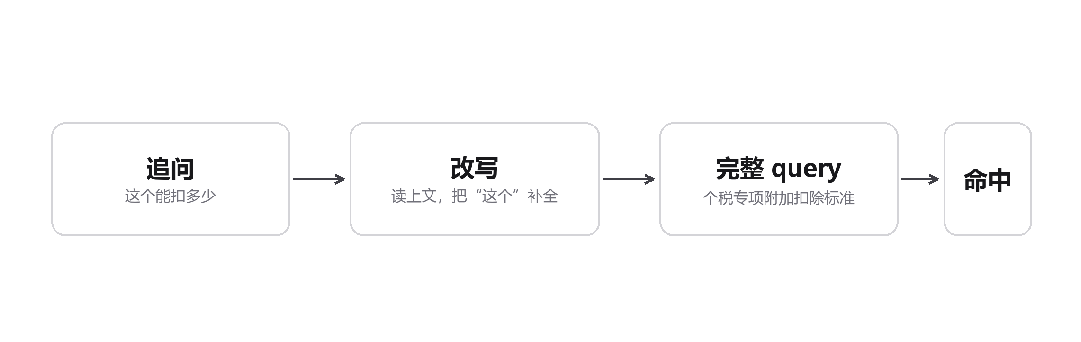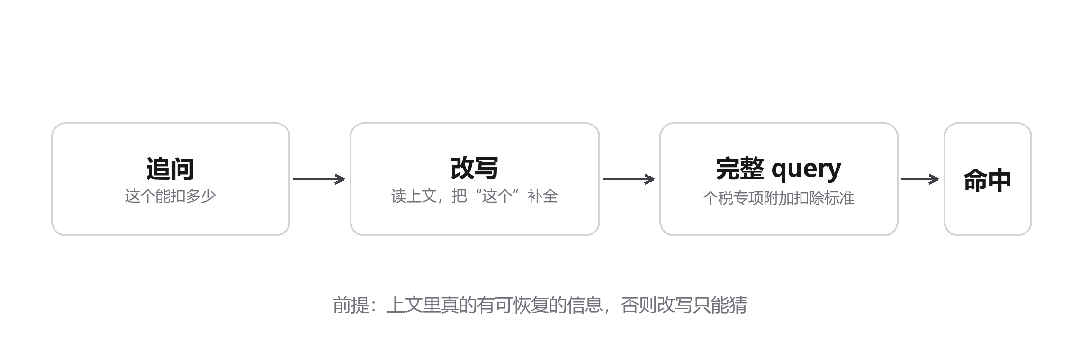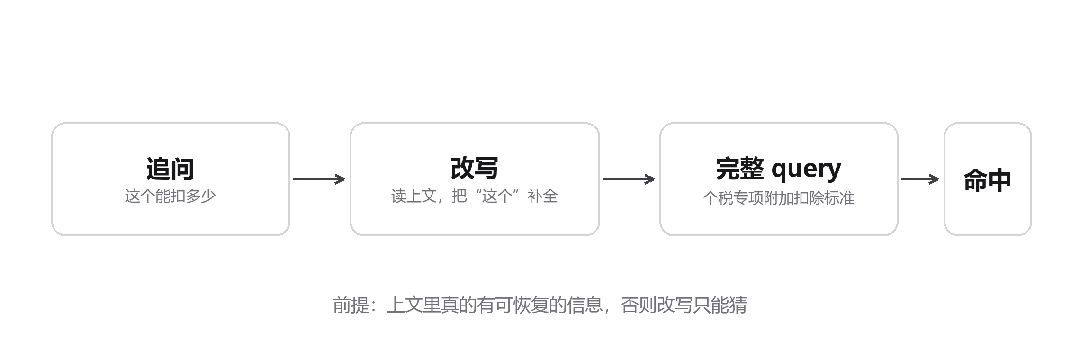
图 3 改写把“这个”补成实体;上文里没有可恢复的信息时,它只能猜
实测是掉分的。六十道题上比 baseline 低十五个百分点,扩到三百题,置信区间整段落在零以下。抽样波动解释不了这个差距。
原因不复杂。向量检索在这批数据上本来就排得不错,改写等于在已经排对的顺序上再推一把,推的方向稍偏,原来对的就沉下去了。
但换一个条件,结论反过来。把两百条真实 query 改写成口语追问,用代词指代关键实体,比如把“个人所得税专项附加扣除标准”说成“这个能扣多少”。这时 hit@1 从 0.725 掉到 0.420,因为关键实体没了。
在这个状态下再上改写。不给上文,只回到 0.425,等于没救;把原 query 一起提供过去,回到 0.690,收回二十七个点,基本恢复到原来的水平。
所以改写有没有用,取决于上文里有没有可恢复的信息。信息彻底缺失的时候,它只能猜。判据也很直接,去日志里数“指代型追问”占多少,占比高才值得加。
6.2 HyDE
HyDE 更绕一点。它让模型先写一段假设的答案,再拿这段答案去向量库里检索。本质是把“问题-文档匹配”转换成“文档-文档匹配”。理由是答案的措辞比问题更接近文档,问句是疑问语气,文档是陈述语气,中间隔着一层。假设答案把这个隔层抹掉,用答案当鱼饵,更容易钓到对的段落。
图 4 HyDE 先编一段假设答案,再拿它去搜
实测更差。六十题上和改写撞在同一个分数,多跳那组 hit@1 掉二十四个点,四十五道题里弄丢五道、只救回一道。
原因在编这个动作本身。新闻里那些具体的人名、金额、时间,模型本来就不熟,编出来的“答案”方向一偏,检索就整条跑偏。问题问得越具体,它编错的概率越高。
它成立是有前提的,query 和文档之间存在语义鸿沟,而且检索器没在这个领域训练过。这次用的是通用强模型、query 干净,鸿沟本来就不存在,所以它剩下的只有噪音。这个前提我没有单独验证,跨领域场景要另测。
所以别把它当默认开关。只有当query 和文档说的不是一套话时,它才有发挥空间。
把这两个策略放一起看,它们做的是同一件事,在向量之外再叠一层信号。向量已经把大部分题排对的时候,叠得越多,压得越狠。这也是为什么它们和混合检索会在同一个分数上撞车。
事实证明,查询增强不是越多越好。多查询会扩大覆盖面,也会放大 rerank 成本;HyDE 对开放式问题有帮助,但如果 LLM 写出的假设答案偏了,检索方向也会偏。Expand, Rerank, and Retrieve: Query Reranking for Open-Domain Question Answering. (https://arxiv.org/abs/2305.17080)这篇文章提醒我们:查询扩展本身也需要被重排,不是贪婪生成出来的第一个扩展就最好。比较好的做法是按问题做一层类型路由:事实型问题先走 BM25 + Dense,模糊开放问题再走 HyDE,强业务约束问题先做 metadata filter。
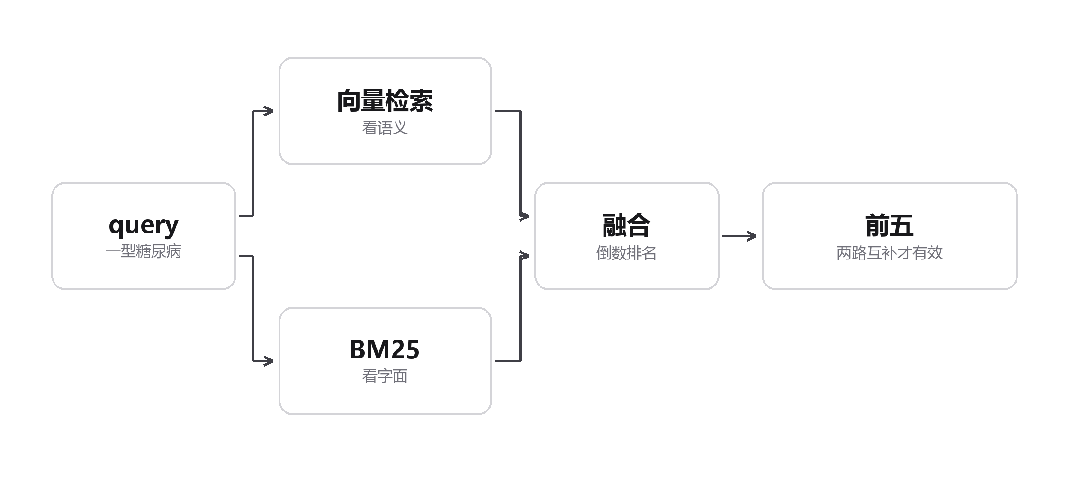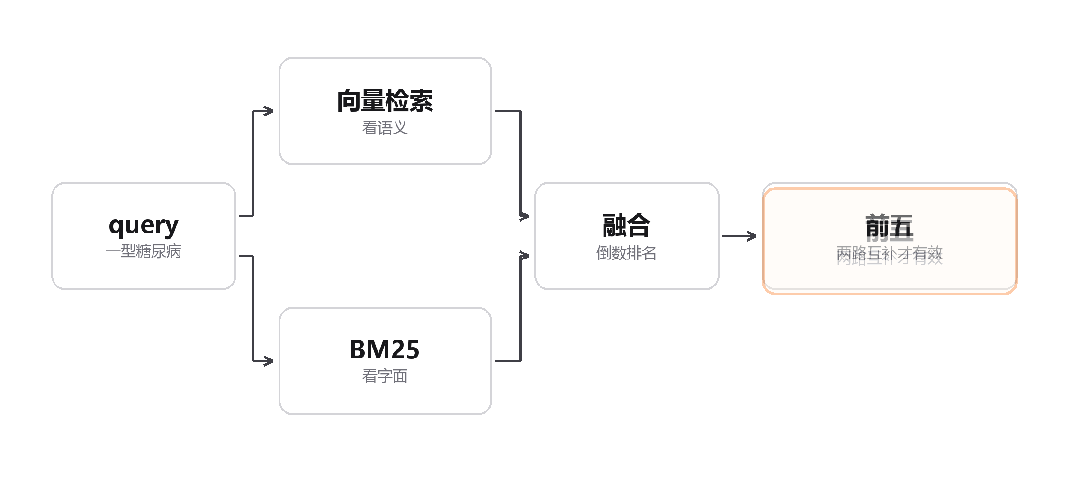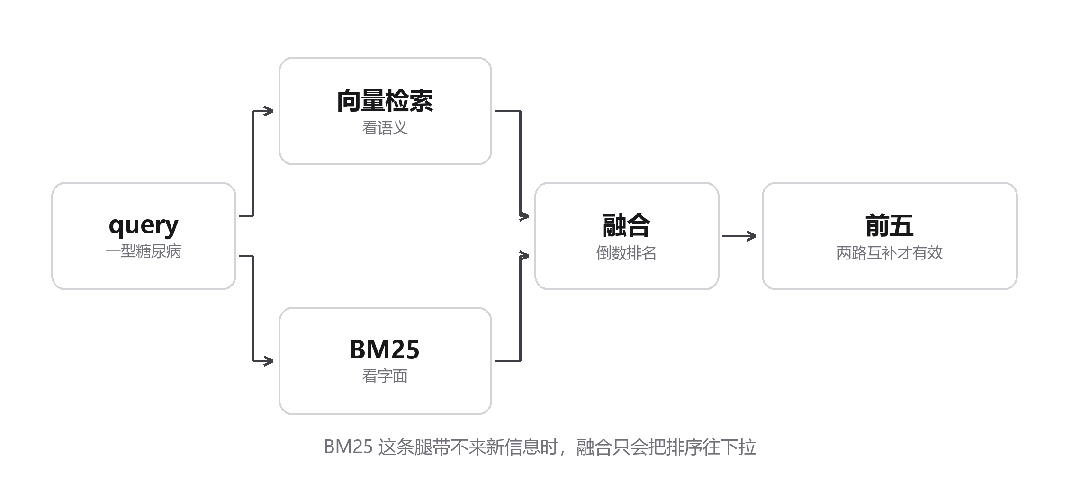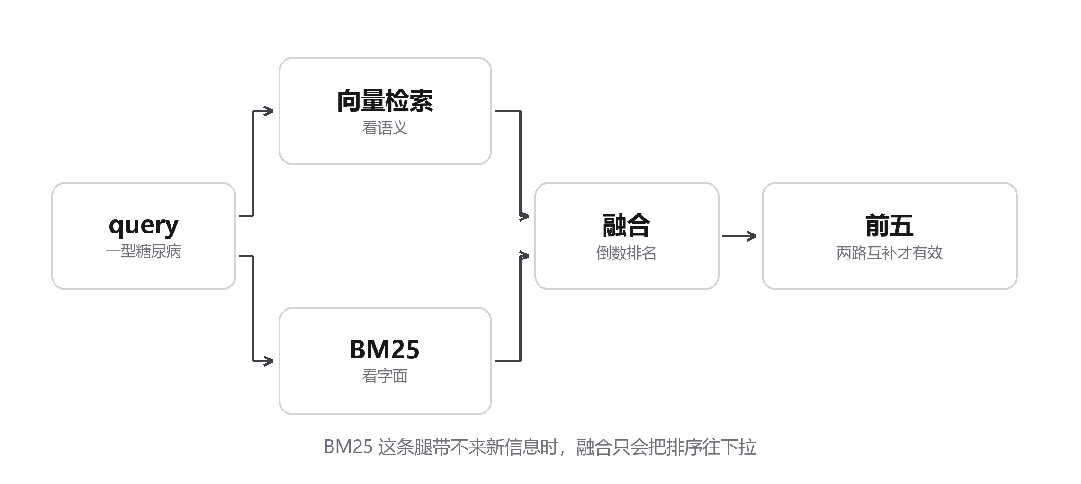
检索层在行业内通常使用混合检索,经过两路召回后用rerank模型进行重排。对于性能要求极高、强调低延迟的场景,则会使用 RRF(Reciprocal Rank Fusion,倒数排名融合)。
7.1 混合检索 = 向量检索 + BM25
向量检索(代表稠密检索)有一个天生的盲区。它只比意思,不比字面。一型糖尿病和二型糖尿病在语义上几乎是邻居,向量分不出差别,可这两种病在医学上差得很远。用户搜前者,系统把后者的段落递上来,答案就错了。
BM25 (代表稠密检索)补的就是这个盲区。它不看语义,只数词。一个词在这段文字里出现得越多,这段越可能和它有关;一个词在整个库里越常见,它越不值钱。“的”“是”“可以”到处都是,等于没有信息;一型糖尿病只在少数段落出现,命中一次就很说明问题。
混合检索就是两路都跑,再把两路结果进行去重、合并和初步排序。排序的办法很简单,按名次。某一段在向量那一路排第三,在 BM25 那一路排第十,两边的名次折算成分数加起来,重新排一次。
图 5 向量看语义,BM25 看字面,两路合起来排序
听起来挺完美,但我实测发现不完全是这样。
中文那份语料上,BM25 单独跑只有向量的七成,两路按各种权重混,最好的结果也没超过纯向量。原因在分词。中文要先切词,切完 BM25 命中的多是“可以”“什么”这种到处都有的词,等于往排序里掺噪音。
换到英文新闻,结论反了。BM25 的相对强度跟中文差不多,可混合之后比纯向量高了八九个百分点。差别在 query 的形态,英文那批题里有大量专名和编号,BM25 命中就是真命中。
所以判据不在“要不要混合”,而在你的 query 里有没有一批只能靠字面认出来的东西。合同号、零件号、法条号、人名,有就值得试,没有效果就不一定有明显提升。当然,这组只有四十五道题,八点九个百分点只能当方向性证据。
7.2 重排
要理解重排,得先看清向量检索是怎么工作的。
它走的是各算各的。建索引的时候,每段文字被压成一串数字存起来;用户提问的时候,问题也被压成一串数字。两边从头到尾没有见过面,系统只是比这两串数字的方向像不像。
快是真快,十万段也能毫秒返回。代价是模型只判断得出“整体意思像不像”,判断不了“这段到底能不能回答这个问题”。
举个例子吧。用户问:猫可以吃巧克力吗?
检索捞出来两篇:
文档 1:巧克力成分介绍(关键词 “巧克力” 命中,向量也有点像,检索排第 1) 文档 2:猫狗禁食食物清单(真正能回答问题,检索排第 4)
Rerank 读了之后:文档 2 相关性分远高于文档 1,直接把文档 2 排到第一名。
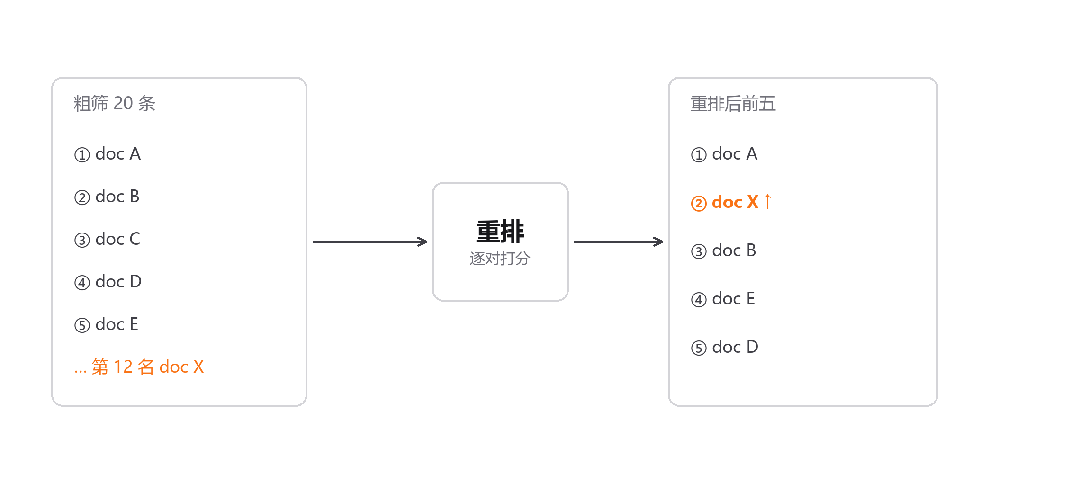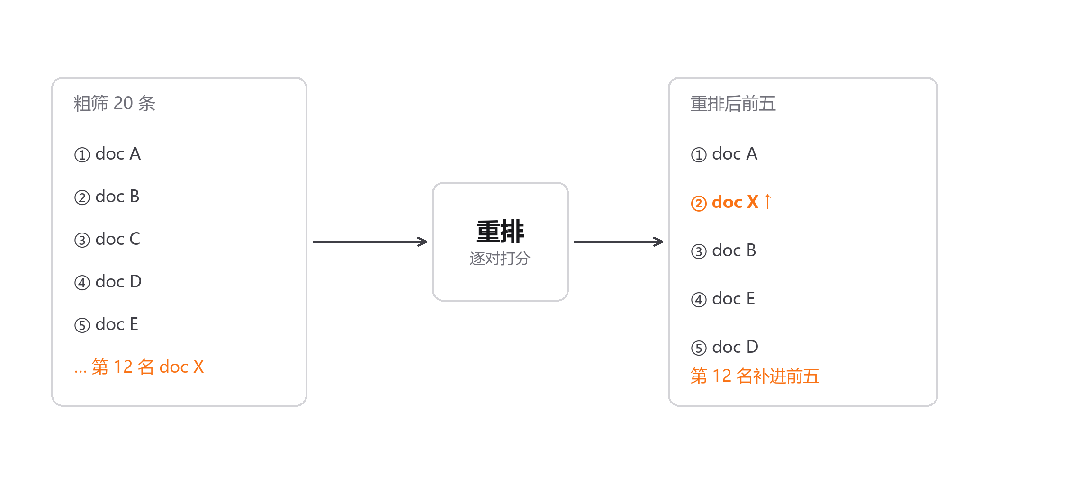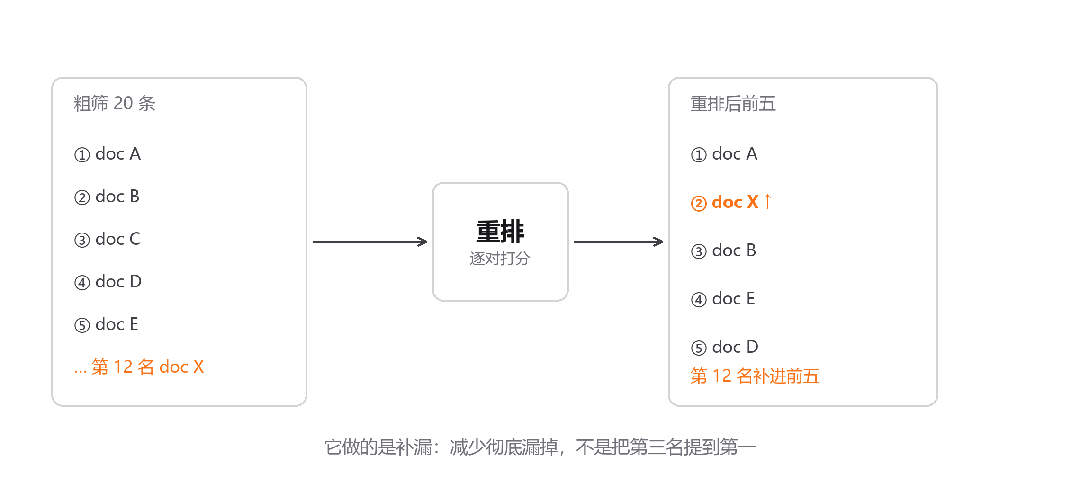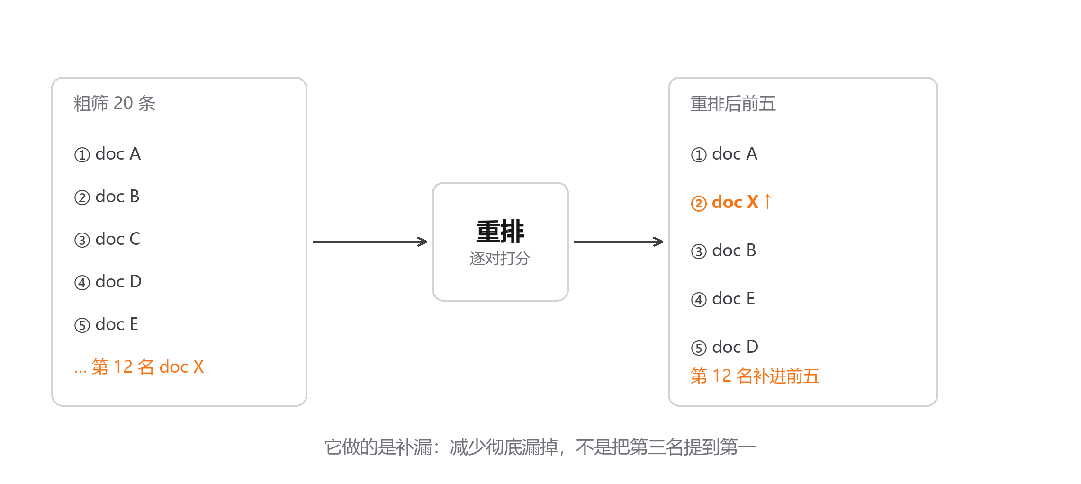
重排做的就是这件事。它不预先算向量,而是把问题和一段候选拼成一段话,一起送进模型,让模型读完直接给一个分数。
图 6 重排把第 12 名补进前五
打个比方,向量检索像筛简历,看关键词和经历像不像;重排像面试,把人和岗位放到一起聊一次。面试当然更准,可一个人聊一次,二十个候选就是二十次,所以只能放在粗筛之后。先让向量从十万段里挑出二十段,再让重排在二十段里排序,留前五。它的开销只跟候选数有关,跟语料规模无关。
它最擅长读的是限定条件。“只统计 2023 年之后”“排除外包”“按季度而不是按月”,这类附加要求在向量那里会被平均掉(因为每个词的权重有差别),在重排这里能读出来。
数据也支持这一点。六十道题里原本有三道的答案掉在五名以外,重排把它们捞了回来,hit@5 从 0.950 变成 1.000。已经排对的题名次没怎么动,平均甚至退了一点点。
所以它做的还有补漏,减少彻底漏掉,不是单纯把第三名提到第一。
值得一提的是,我将评测样本加到三百题,才看见它在第一名上的收益,hit@1 从 0.697 到 0.743。六十题看不见,是因为这个提升只有 4.6 个百分点,而六十题本身的误差就有 4.7 个百分点,信号和噪声一样大。
多跳长文档上收益更明显,hit@1 涨了十五个百分点,答案命中率也跟着涨了七个百分点。
检索层和答案层同时变好,这批策略里只有它做到。如果你的 RAG 只能加一个策略,加重排。
7.3 RRF(Reciprocal Rank Fusion,倒数排名融合)
RRF 就是把好几份不同检索结果列表,按「名次」打分,名次越靠前分越高,最后把分数加起来重排,不关心相似度具体多少,只关心排第几。
RRF 不直接比较 BM25 分数和向量相似度,而是只依据候选文档在两路结果中的排名位置进行融合,因此不受两种分数量纲不同的影响。其特点是计算简单、速度快、延迟低,所以通常用在性能高要求、强调低延迟的场景。
值得说明的是,RRF和重排并不是非此即彼的关系,有一种说法是在真实工程里经典搭配: BM25 + 向量检索 → RRF 融合 → 取 Top20 → Rerank 精排 → 取 Top3~5 给大模型。
这部分我接触的实在不多,没有相关实践,因此本文就不再胡说八道了,感兴趣的可以自己实操试试。
前面七节都在同一条流水线上换零件。切得更合理、嵌入更贴合领域、问题改写得更准、检索排得更对。
这些改动有天花板。当答案根本不在候选里,或者一个问题要分几步才查得清,换零件解决不了,得换走法。下面四种走法,各自在解决一个前面解决不了的问题。
基础 RAG 是一条直线
前面跑的那条流水线,换一个角度看,本身也是一种范式。问题进来,检索一次,取前几条,交给模型回答。没有分支,没有回环。
它的好处是便宜、快、行为可预测。缺点是三个断点全在一条直线上,任何一个断了都没有补救。库里没有相关内容,它不会去别处找。第一次没搜到,它不会换词再搜。
怎么区分三个断点,有顺序可循。先看 hit@5。答案所在的那一段压根不在前五,问题在检索,往后加混合检索或重排。hit@5 很高而答案命中率低,问题在生成,去查提示词、段落顺序、上下文长度。中间还有一种,hit@5 不低但 hit@1 明显更低,说明检索到了却没排好,那是重排的活。三个数字一摆,该动哪一段基本就清楚了。很多人跳过这一步直接换模型,钱花了,问题还在。
大部分业务场景落在这条直线上就够了。baseline 在所有实验里都不难看,原因也在这里。它的 hit@1 是 0.783,换任何策略都至少要花一次额外调用才可能超过,而大多数策略连这个都做不到。
Graph RAG 把关系捡回来
第五节的最后留了一个缺口。切块会把块与块之间的关系切掉。合同第 12 条写着“依据本法第 X 条”,这个 X 在别的块里,向量检索不会因为一句话里有引用关系就顺手把 X 取出来。
Graph RAG 的做法是先把关系存成一张图。节点是实体,比如条文、公司、人;边是关系,比如引用、XX属于XX关系、投资。检索时先定位命中的节点,再顺着边把相邻节点一起找出来放入上下文。
图有两个来源。一是让 LLM 读文档抽实体和关系,通用但贵,质量也不稳。二是用规则抽,法律条文里的“依据本法第 X 条”“本合同第 X 条”,格式固定,正则就能拿到,成本接近零。
抽出来的图是局部图,只覆盖你自己的文档。WikiData 那种预先建好的全局图是另一种东西,拿它增强检索的方案叫 KG-RAG,思路相近,图的来源不同。
图 7 顺着引用边,把答案那一条捞回上下文
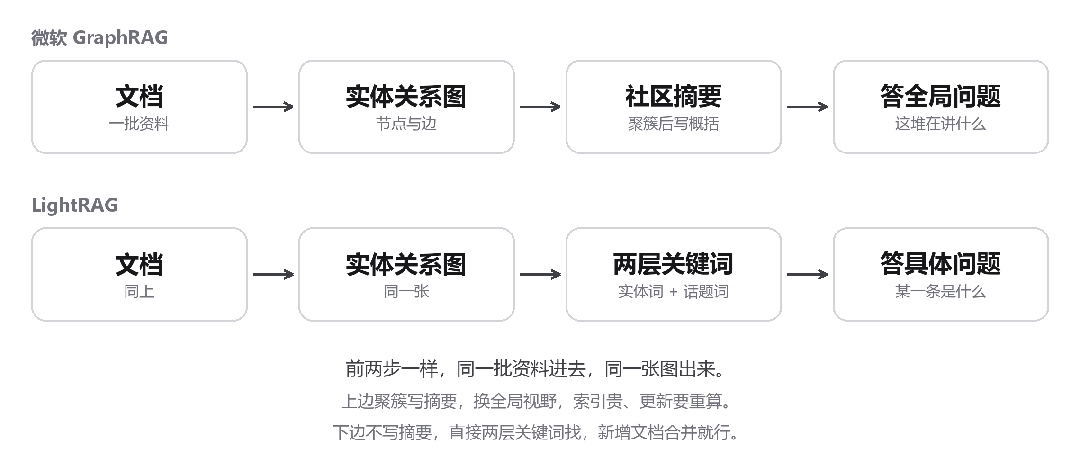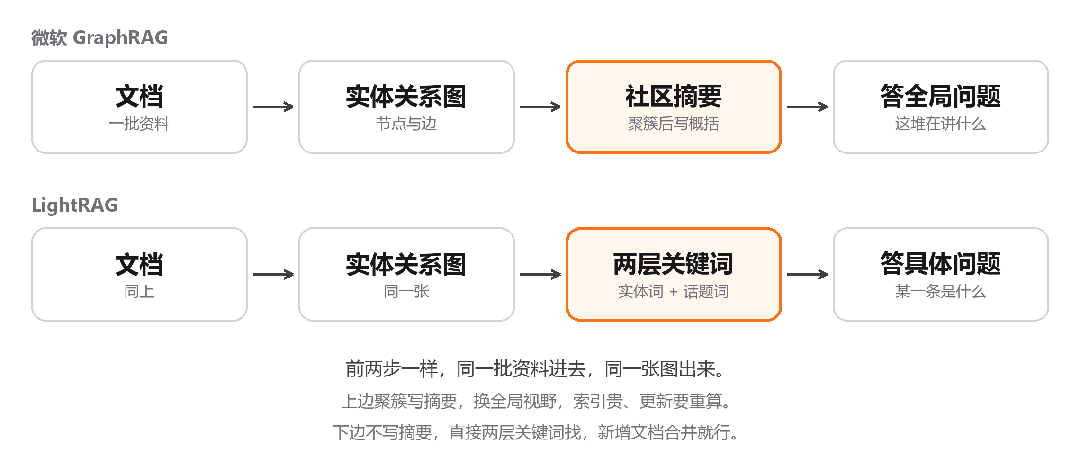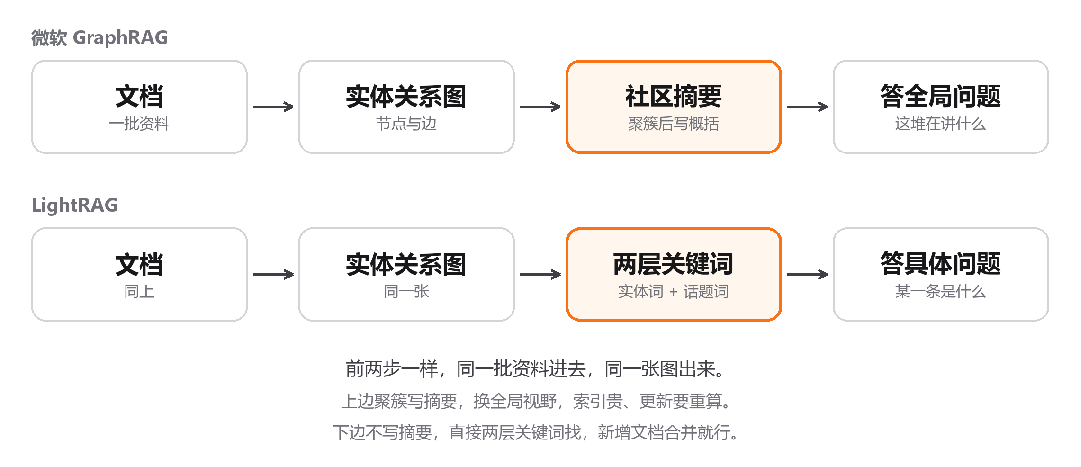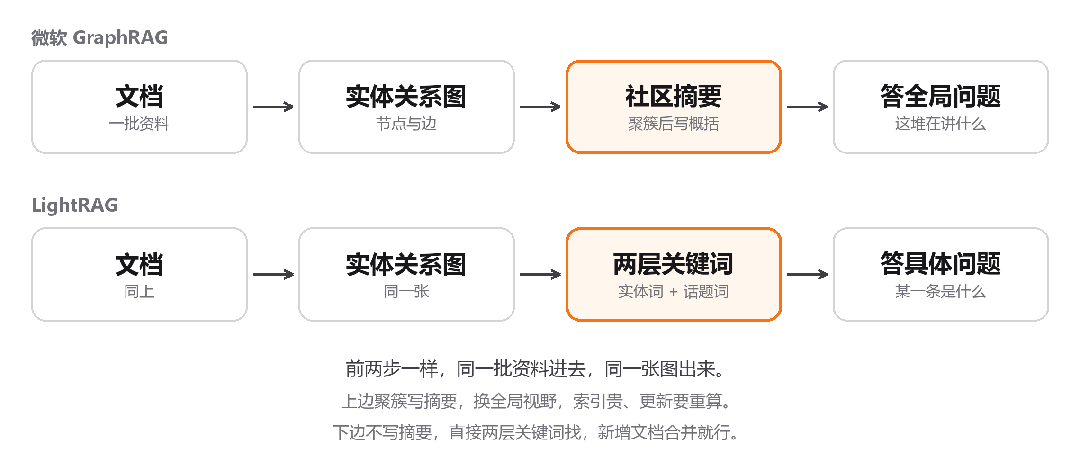
Graph RAG 有两半。一半是顺着实体邻域找,也就是上面这条路径;另一半是把关系密切的实体聚成社区,给每个社区写一段概括,用来回答“这堆文档整体在讲什么”。
顾及成本的考量,本文只测了前一半,边还是用正则抽的。所以后面提到的那些数字衡量的是纯图检索的下限,不代表完整 Graph RAG 的上限。
另有一个更轻的版本叫 LightRAG,把社区摘要整个去掉,改成拿具体实体和抽象话题两组关键词分别检索,换来的是新增文档时往下合并就行,不用重建。这一范式我没有进行评测,感兴趣的读者可以自己评测试试效果如何,也欢迎在评论区分享你的成果和见解。
引用边扩展的收益是有条件的,我用两组实验把边界测出来了。
第一组是 MultiHopRAG 的多跳新闻题。用实体图代替向量做检索,输得很惨。hit@5 只有 0.533,向量检索是 0.978,差了四十五个百分点。
原因在问句形态。那批题长这样,“据 The Verge 和 TechCrunch 报道,那位面临欺诈审判的加密货币人士是谁”。The Verge 确实出现在问句里,可它几乎出现在每一篇相关报道里,做检索信号反而是噪音。真正的判据是“面临欺诈审判的加密货币人士”这段语义,纯实体图抓不住。
第二组换到民法典,结论反过来。
在被引用的那一条上,召回从 0.514 跳到 1.000。
中间有一行数据最说明问题。在引用方已经进了向量前两名的三十道题里,普通检索仍有十八道拿不到被引用的那一条,占六成。上下文里明明摆着“依据本法第 X 条”这句话,那个 X 不在里面。模型看得见指路牌,走不到路那头。
加上扩展之后,答案覆盖度从 0.741 到 0.824,十二道题更好,三道更差,二十二道持平。
代价也得说清楚。每题平均多插入 1.41 条条文,其中 23% 属于噪音,跟目标条文无关。前五名这么紧的预算里,这个代价不小。所以扩展只能跟着显式引用走,不能把相邻块一股脑拉进来。
两组结论放在一起不矛盾,它们回答的是两个问题。用实体图替代向量做通用检索,这次是惨败。用引用边做关系补全,效果很干脆。工业界的 Graph RAG 几乎都和向量检索混着用,原因大概在这里,单独用图等于放弃了语义匹配这条腿。
成本分两种情况。开放域确实贵,六百多篇新闻抽五千多个实体、六千多条关系,花了一块三毛七,五分钟。法律条文那种显式引用用正则抽,边际成本几乎是零。
增量更新也要分情况。逐文档抽出来的关系是局部的,更新一篇只需重抽那一篇。微软原版 GraphRAG 那套里面有社区检测和社区摘要,依赖全局聚类,更新一篇可能触发整体重算,那才是真正贵的地方。这两个成本经常被混在一起讲,其实不是一回事。
要不要上这一套,判据是你的文档里有没有显式关系。法条、合同、制度、论文有,用正则就能抽,收益还是从 0.514 到 1.000 这种量级。开放域新闻没有,只能让 LLM 通读,收益不稳。
还得提醒一句,这组实验的题目是构造的,天然偏向 Graph RAG 有效。它测的是机制在关系型问题上的上限,不是自然流量里的平均收益。真实业务里“需要跟随引用”的题占多大比例,得按你自己的文档统计。
Agentic RAG 把检索变成循环
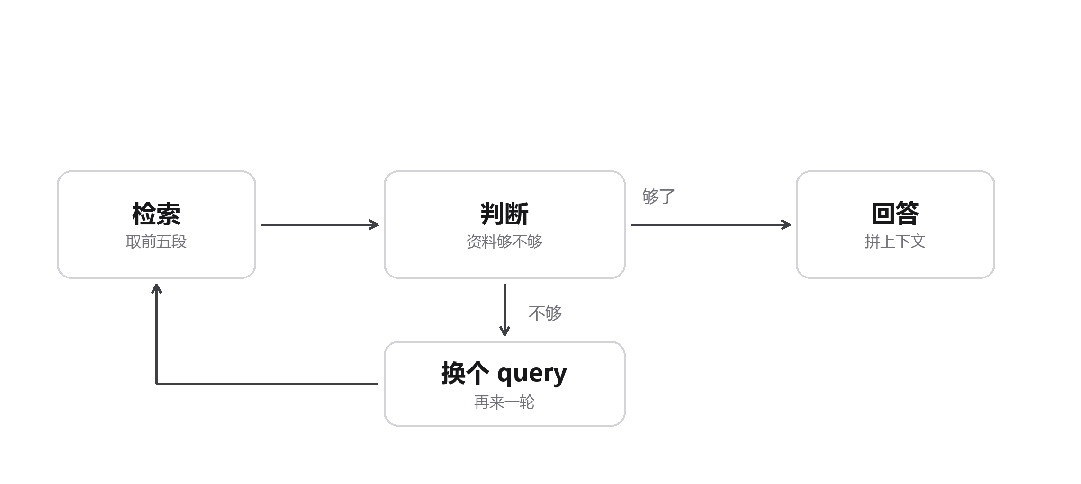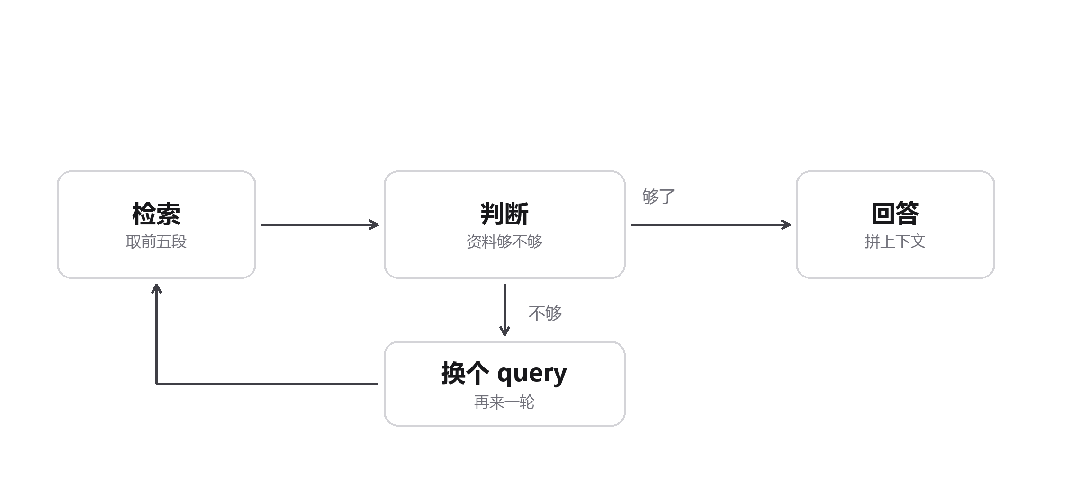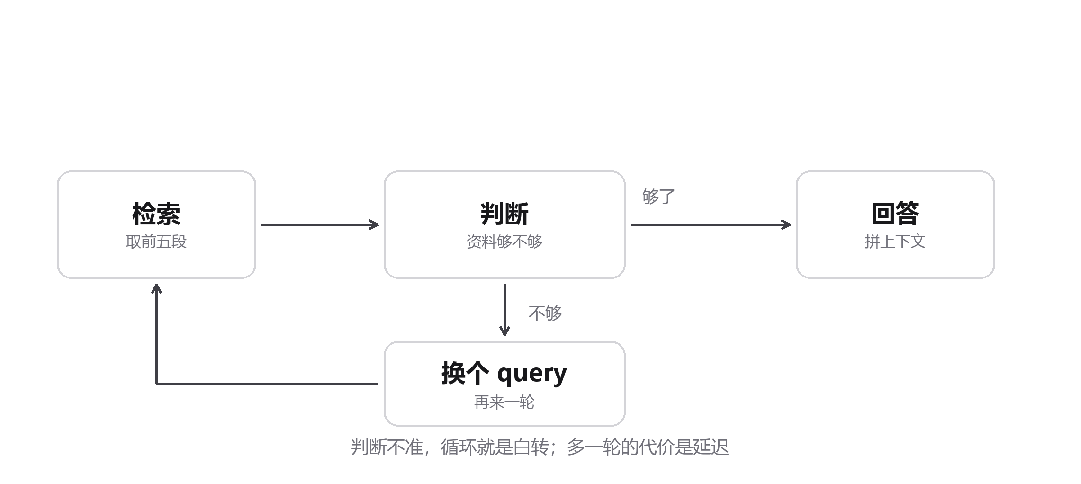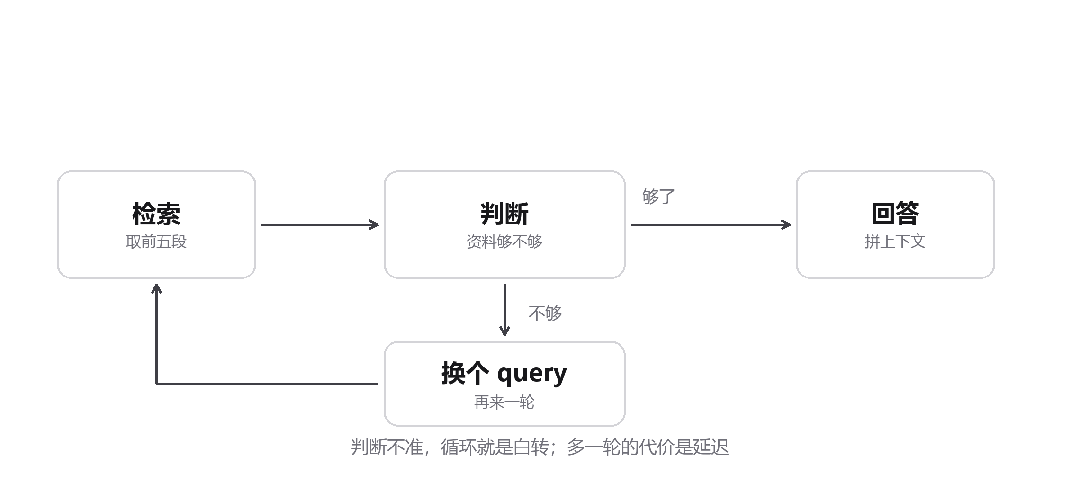
人查资料不是一次成型的。先搜一轮,看看够不够,不够就换个词再搜。Agentic RAG 就是把这件事交给模型。
做法是让模型自己判断信息够不够,不够就生成一个新查询再检索、换数据源、换query。给它的工具通常是语义检索,也可以是别的。循环几轮,直到它认为够了或答案明确不可达,再整理上下文交给生成。
图 8 不够就换个说法再搜一轮
我的实现只做两轮。先检索五段,让模型判断够不够。不够就让它给一个新查询,再检索一次。最终只返回某一轮的前五段,不累积,否则它的上下文条数会比别的策略多,比的就不是检索能力了。
结果是没起来。MMarco 上 0.767,比 baseline 低 1.6 个百分点。MultiHopRAG 上四十五道题里三十八道和 baseline 完全一样。
我怀疑是“替换”丢掉了第一跳的证据,做了个累积变体,第二轮结果跟第一轮合并。文档级三项指标一点没变,只有 NDCG 从 0.369 微升到 0.385。
显而易见,多给第二轮证据,并没有让第一跳变好。
当然,这个结果不等于 Agentic RAG 没用(其实是我自己没用)。我的实现是简化版,两轮、替换式、没有规划、没有工具选择,跟论文里那套差得远。更准确的说法是,我做的这个简化版没跑出效果。
不过有个判断可以下。这个范式的上限取决于模型的自评能力。模型看不出资料不够,后面的循环就白转。而自评这件事本身就不可靠,下面 Adaptive 那节里,路由判定同一批题跑四遍,结论都不一样。判断都判不准,循环越多,错得越远。
它的成本也很实在。每题至少多一次判断调用,需要二轮时再多一次改写和一次检索,这些步骤串行,延迟跟着涨。
此外,再检索还会带来一个副作用:重复查。多轮对话里,用户经常追问、改问、绕着同一个主题问,如果检索系统没有记忆,就会一遍遍召回同一批 chunk。工程上有两个层级的解法:轻量做法是按 session 维护 consumed_ids,每轮检索后记录已经用过的 doc/chunk,下轮过滤;同时在单次检索内按 doc 去重,避免同一篇文档的三个相似 chunk 挤满 Top-K。至于效果如何,同样需要你们自己去验证了()。Agentic RAG 这类方案特别适合多跳、跨源、信息分散的场景。企业内部最常见:合同在法务库,付款在财务库,项目状态在 Jira,客户沟通在 CRM。用户一句“这个客户为什么还没续约”,背后可能需要查历史工单、报价、合同条款、最近会议纪要。它的选型逻辑很简单:如果答案路径需要“查到 A 后才能知道去哪里查 B”,就该考虑它;如果只是固定知识库 FAQ,一次混合检索加 rerank 就够了,别把小问题装修成指挥中心,浪费精力浪费钱。Adaptive RAG 先判断要不要查
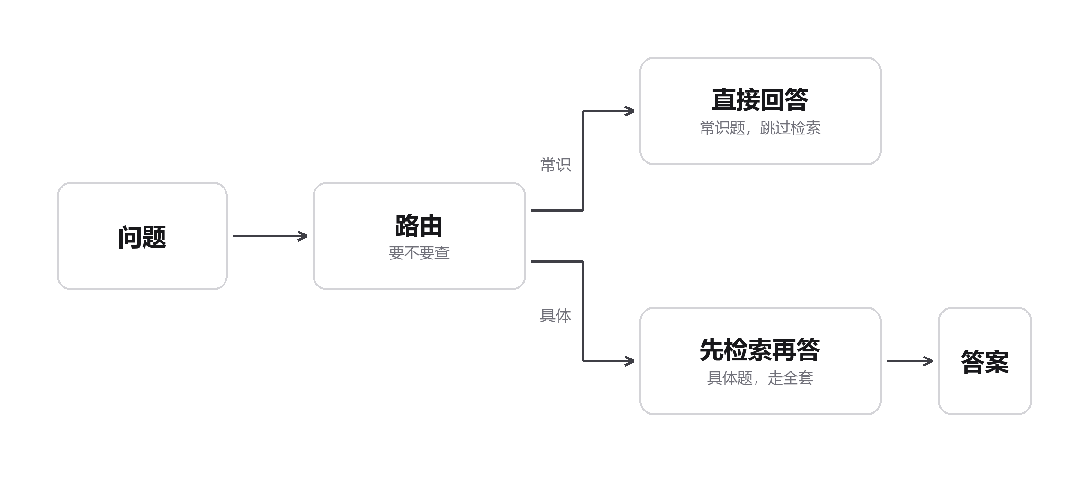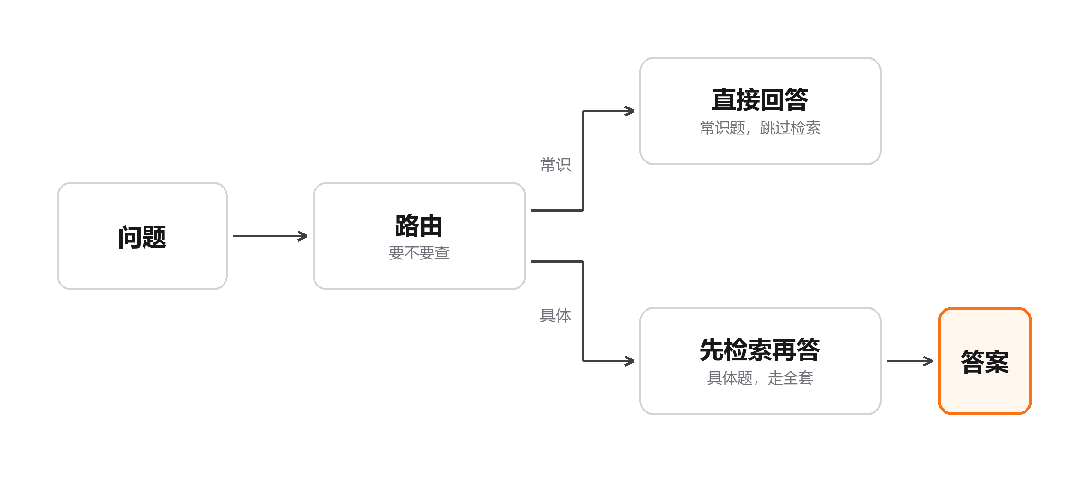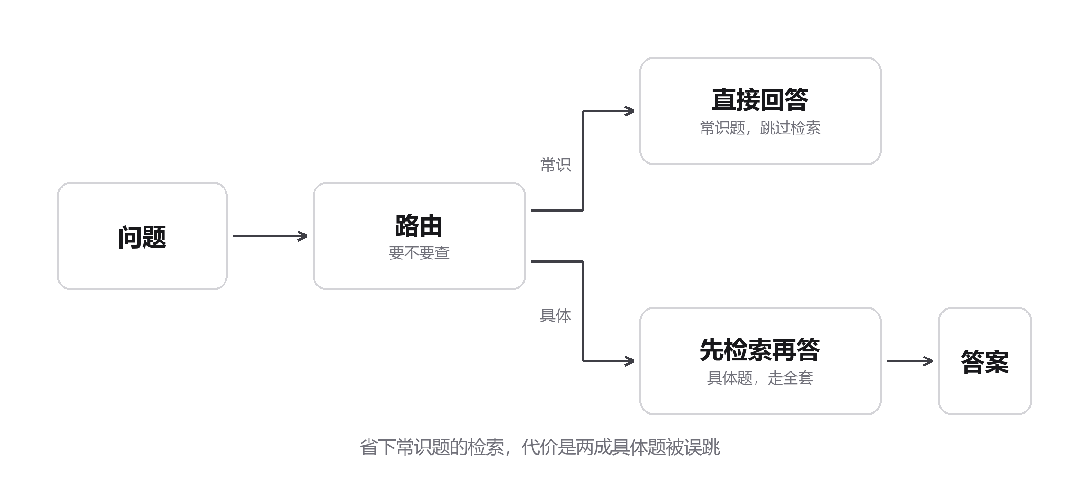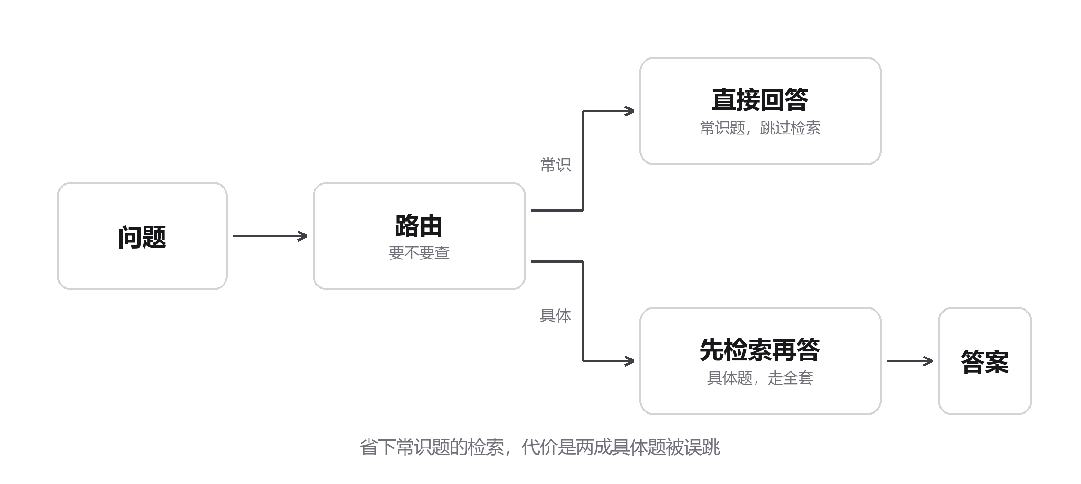
还有些问题根本不用查。“你们几点下班”“一加一等于几”,模型本来就会。给这种问题跑一遍检索,是白花钱。Adaptive RAG 在检索前面加一道判断,简单的直接答,复杂的才走完整流程。
这道判断有三种常见实现。规则匹配最快,写死关键词,覆盖面窄。小分类器要标注数据,边界情况得靠人补。用一次极短的 LLM 调用最灵活,判断标准直接写在提示词里,改起来不用重新训练。我用的是第三种。
图 9 常识题跳过检索,具体题走全套
提示词必须带例子。只写规则的时候模型会漂。我最初那版只写了“涉及具体事物一律 YES”,它把“建行可以炒石油吗”判成了不需要检索。补了几条正反例,又加上“拿不准一律 YES”的兜底,才稳住。这个兜底也有代价,它让漏检变少,误检变多,等于把风险往反方向挪了一点。
第一版测出来是灾难。二十道题里它跳过了三道,跳过之后上下文为空,上下文类的指标必然记 0,整张表看它全面落后。我一度写了“这个范式完全无效”。
后来查出来两个 bug。跳过检索之后仍然用 RAG 提示词,模型面对空资料只能回答“资料中没有相关信息”;另一个是解析,模型输出为空时被当成了不需要检索。修完再看,情况完全变了。
补一组混合分布的题,十五道常识加十五道具体,画像是这样。常识题跳过 100%,跳过时仍然答对 87%。具体题误跳 20%。
再看它真正检索的那十七道题。跳过的那三道上下文为空,不参与比较,剩下的分数是这样。
四项指标基本持平,答案正确性还略高一点。它检索到的东西并不差,问题出在它放弃的那部分题上。
这两件事在报表上长得一样,在业务上完全不同。放弃是主动省成本,检索得差是能力不够。前者要算账,后者要修东西。
还有一个数字不太好看。它的路由判定不可复现。同一批六十题跑四遍,跳过数分别是 14、9、12、10。逐题一致率 93.3%,四道题翻转。指标的抖动约正负 7%,小数点后三位的差异不能当结论。
这个范式的取舍很清楚。省掉常识题的检索成本,赌的是误跳比例。值不值取决于你的流量里常识题占多少。客服机器人里“你们几点下班”这类问题很多,它划算。专业检索工具里几乎没有这种题,它就只是在冒险,而且每次都在冒。
四种范式摆在一起,差别在它们各自想解决的那一个问题。
我最想提醒各位的一点是:RAG 不是“让模型知道更多”的唯一方式,它只是“在推理时找一小段上下文”的方式。选型从一个问题开始,模型现在缺什么。缺的东西不一样,补法完全不一样,成本也差着数量级。
9.1 先分清缺的是哪种信息
缺一段会变的事实时,用 RAG。制度条款、产品参数、上周的会议结论都属于这一类。它们不在参数里,也不该在参数里。
缺的是一种行为时,用微调。输出必须符合固定格式,必须按某种口径解释,必须用行业内的说法,这些属于“怎么做”的问题,跟“知道什么”是两件事。
缺的是组织方式时,用 LLM Wiki 这类预编译方案。资料本来就零散,反复被问的其实是同一批结论,每次都要重新检索拼装,说明缺的是一层整理。
缺的只是几个精确字符串时,先试 grep 和文件读取。函数名、报错、某个文件的第 42 行,这类问题的答案不需要语义理解,向量检索反而绕远。
9.2 四种 RAG 范式怎么选
绝大多数项目从基础 RAG 加重排开始。这两步的收益在两个数据集、两类指标上同向,成本也最低,重排的开销还跟语料规模无关。
文档里有显式引用、层级、归属关系的,加一步引用扩展。判据很土,把你的文档翻一遍,看有没有大量“依据第 X 条”“见附件三”“属于某项目”这种写法。有就值得,没有就别上。
问题需要跨段落拼信息、第一步该搜什么又不明显的,考虑 Agentic。先别急着实现,从日志里抽一百个问题,数一下有多少个是一次检索命中不了的。比例低于一成,多轮设计大概率白花钱。
常识类问题占比高的场景,可以上 Adaptive。它省的是检索调用,赌的是误跳比例。这个比例只能从你自己的流量里量,抄别人的没用。
还有一个更划算的动作经常被忽略,把评测搭起来。没有指标,上面这些判断全靠感觉,而感觉在检索这件事上特别不准。这次实验里我自己就判反过一次。
9.3 什么时候该微调
微调解决行为,不解决知识。
值得做的情况有三种。你有一批稳定的标注数据,几百到几千条。任务边界清楚,输入输出格式固定。或者你想用小模型替掉大模型,把成本和延迟压下来。
不值得的情况也很清楚。知识天天变,微调一次就要重训一次,还查不到出处。需要引用原文、需要给出页码的场景,微调给不了。数据只有几十条的时候,写提示词比微调有效。
有个常见误区是把微调当成灌知识。模型的参数不是数据库,灌进去的东西既不能精确召回,也不能单独删除。让它忘掉一条错的知识,比让它学会一条难得多。
9.4 什么时候该 LLM Wiki
RAG 像解释器,每次提问都从头读一遍资料。LLM Wiki 像编译器,新资料进来的时候就让模型读完、拆成概念页、和旧页面建立链接,之后查询直接读页面。
它适合稳定、反复使用、需要积累的知识。个人笔记、长期维护的项目文档、一个团队反复讨论的那几十个概念,都属于这一类。同一批资料被问过十次以后,预编译的成本就摊平了。
不适合的情况有两种。资料几千篇以上,模型的上下文装不下整个索引,要么分层,要么退回 RAG。资料变得很快,今天写的页面明天过期,维护成本会超过收益。
还有一个现实问题,编译质量取决于模型对领域的理解。它会把相似的概念合并,也会把不该合并的合并掉。真要用,得留一个人抽查概念页。
所以,“什么时候不该用 RAG”的简化判断可以这样说:当问题需要精确定位,用 grep/glob/read;当问题需要全局统计,用 query engine / semantic operator;当问题需要长期个性化,用 Memory / LLM Wiki;当问题需要持续运行,用 Continuous RAG;当问题需要可控执行,用 Workflow / Agent loop / Harness。RAG 仍然重要,但它不应该是默认答案。它适合补一段证据,不适合替代搜索工具、数据库、记忆系统、流处理系统和工程闭环。
把这几节压缩成一张表,选型的时候可以直接对着看看。
写到这里,策略和选型都讲完了。最后交代几点我个人的经验吧。
指标会决定你能看见什么。hit@1 好看,但它只关心第一名。重排这种补漏型策略在六十道题上 hit@1 完全隐身,在 hit@5 和答案命中率上才现形。如果评测只统计 hit@1,你会系统性地低估那些“不漏”的环节,转头去加那些看起来更聪明的策略。同样,只看 RAGAS 会低估短答案,只看块级召回会误判长文档。
样本量决定你能看见多大的效应。六十道题的分辨率是五个百分点左右,比这更小的提升,测多少次都是随机数。重排那 4.6 个百分点,在小样本上就是隐身的。
做agent项目选型时也不要只是简单地问“我要不要上 RAG”,而要先问三个更具体的问题:1.模型缺的是什么信息?2.这些信息是稳定的、实时的、结构化的,还是分散在文档和工具里?3.补上这些信息的最低成本方式是什么?
答案可能是向量检索,也可能是知识图谱、Agent 工具调用、文件系统搜索、Memory、Wiki,或者只是一个更清楚的业务流程。面对代码在流水线上廉价生成的ai时代,这才是工程项目里作为“人”最该做的判断。
RAG 的价值不在于“让模型多看点资料”,而在于把用户的一句话,扩展成模型完成任务真正需要的上下文。工程上真正要优化的,也不是某个单点算法,而是从问题理解、信息获取、上下文组织、回答生成到评测反馈的整条链路。
当然,受限于个人认知和成本,我的评测有许多不足之处,文章部分地方也难免会存在纰漏与错误。欢迎各位读者指正。查了许多资料写完这篇文章唯一感想就是,RAG的水很深。