# 测评背景
SuperCLUE-Terminal-Science 是面向中文科研场景、覆盖七大科研领域的智能体评测基准:核心任务取自专家正在进行的真实研究课题,由独立机制验证结果,考查模型运用知识与工具完成科研任务的能力。重点评测大模型在智能体框架驱动下,能否理解科研需求,并交付满足任务要求的代码、数据或计算结果。本基准要求模型既要理解研究目标与约束,也要处理数据、组织计算、检查结果,最终形成能够被独立验证的产物。
官网地址:www.superclue.ai
# 基准介绍与创新点
1. 覆盖国内重点科研领域,构建七大评测维度
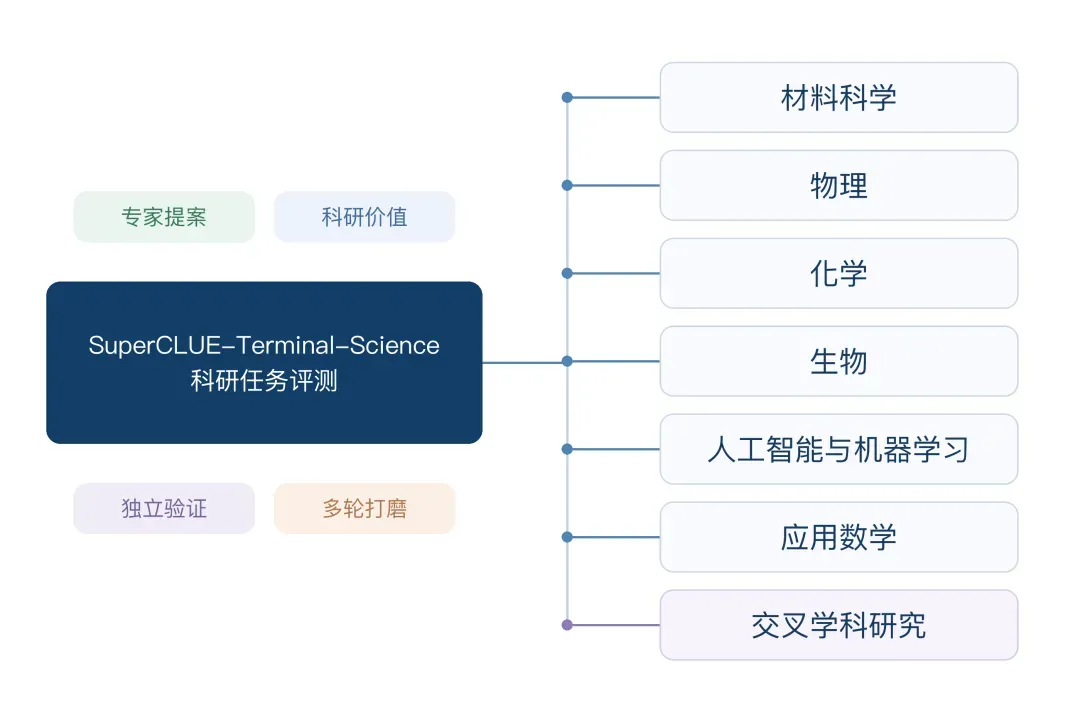
SuperCLUE-Terminal-Science 面向国内重点科研领域,以材料科学、物理、化学、生物、人工智能与机器学习、应用数学和交叉学科研究构建七大评测维度。通过不同领域的任务,考查智能体在多样科研问题中的知识运用、工具调用与实际求解能力,形成覆盖多学科的科研任务评测框架。
2. 专家与智能体协同制题,将科研价值转化为可用任务
基准采用领域专家设计任务、智能体审核验证、多轮修改完善的题目制作机制。领域专家以自身实际开展的、具有科研价值的研究工作为基础,提炼其中的关键问题与求解要求,设计用于考查智能体科研能力的任务,智能体通过审核与执行验证发现题面、环境和验收规则中的问题,再依据反馈持续打磨。3. 跨学科知识与计算工具融合,考查科研问题的综合求解能力
科研任务往往需要将领域知识、数学方法与计算工具结合使用。SuperCLUE-Terminal-Science 将专业知识理解、计算方法选择与工具运用融入任务设计,考查智能体能否围绕研究目标组织求解过程,把抽象问题转化为可执行的计算步骤。
在交叉学科研究任务中,进一步关注智能体能否衔接不同学科的概念、方法与数据,完成从问题建模到计算实现的综合求解。评测由此关注知识在科研场景中的迁移与运用能力,而不仅是对单一领域知识的掌握程度。
# 基准任务介绍
SuperCLUE-Terminal-Science 覆盖以下七个一级领域。材料科学、物理、化学、生物、人工智能与机器学习、应用数学、交叉学科研究。
注:不同领域的研究对象和方法各有侧重,但进入评测的任务需要落实为清晰的输入、执行要求和交付目标。题目应说明可用资源、必要约束、产物保存位置及验收要求,使智能体能够据此开展工作,也使验证过程有明确依据。这里的领域划分用于组织题目与展示覆盖范围。具体任务的研究价值由领域专家把关,其可执行性与可验证性则在题目制作过程中逐步完善。
# 题目制作方式
题目来源于领域专家在本领域实际开展的、具有科研价值的研究工作。专家从中提炼关键研究问题、计算过程与成果要求,将其转化为用于考查智能体科研问题求解能力的评测任务;随后引入智能体开展审核与验证,对任务描述、执行条件和验收标准进行检查,并依据验证反馈多轮修改、迭代完善,最终形成可执行、可验证、可用于正式评测的题目。整个制作过程分为四个环节:
1. 领域专家提出任务
领域专家结合科研实践提出任务提案,明确研究问题、任务价值、输入条件和预期成果。选题重点在于任务是否具有实际科研意义,以及能否有效考查智能体对领域知识和计算工具的综合运用能力。
2. 智能体审核与验证
引入智能体检查题面表述是否清晰、所需资源是否齐备、执行路径是否可行,以及产物要求与验收标准是否一致。通过实际执行与验证反馈,发现描述歧义、条件缺失或验证逻辑不充分等问题。
3. 多轮修改与完善
根据审核和验证中暴露的问题,对题面、环境配置、数据与产物约定、验证脚本等进行针对性修订,并再次检查。通过反复打磨,使科研目标、执行过程和验收要求相互对应,减少因题目本身不完善带来的评测偏差。
4. 定稿并纳入评测
完成迭代后,将题目整理为可供评测系统加载的任务,配套明确的执行环境、产物声明和验证规则。最终形成从专家设计任务、智能体审核验证、多轮修改完善到定稿入库的题目制作闭环。任务取材于专家的实际研究工作,强调选题的科研价值,审核验证与迭代打磨则帮助任务真正落地为可用题目。
# 测评流程与评分方法
测评流程
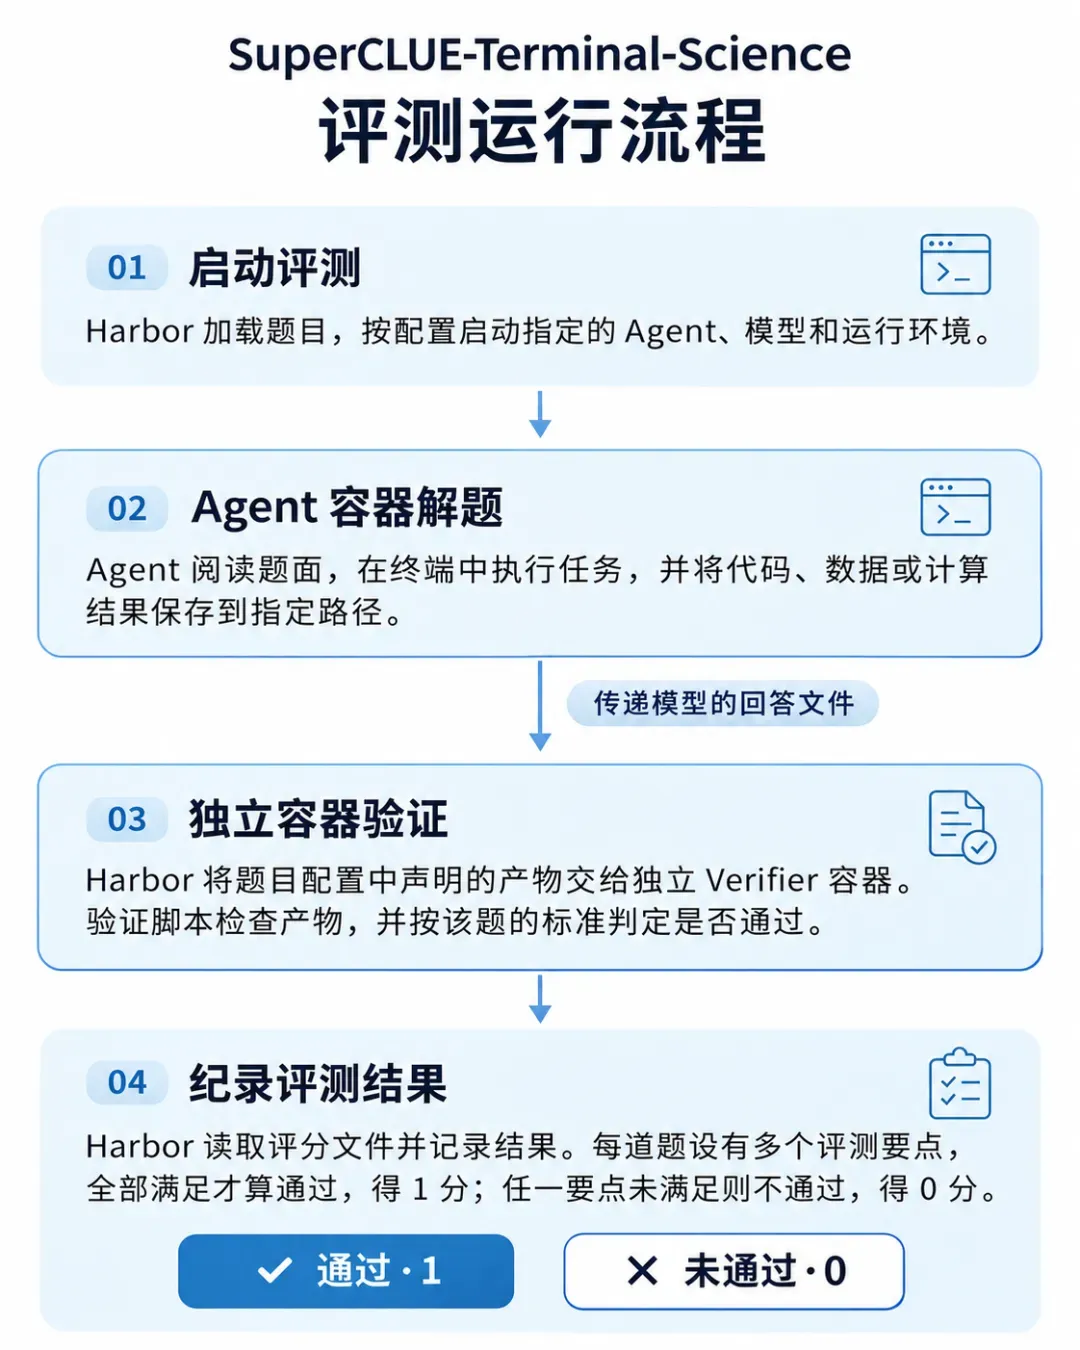
SuperCLUE-Terminal-Science 采用 Harbor 任务格式组织测评——任务说明、容器化环境与验证脚本打包为可复现单元,智能体在隔离环境中执行,按最终状态自动判分。整个流程分为“启动评测—Agent 容器解题—独立容器验证—记录评测结果”四个步骤。
第一步:启动评测。 Harbor 加载题目,按配置启动指定的 Agent、模型和运行环境,为任务执行做好准备。
第二步:Agent 容器解题。 Agent 阅读题面,在终端中执行任务,并将代码、数据或计算结果保存到指定路径。模型需要完成实际操作并交付文件,供后续验证使用。
第三步:独立容器验证。 Harbor 将题目配置中声明的产物交给独立 Verifier 容器。验证脚本检查这些产物,并按照该题标准判定是否通过。
第四步:记录评测结果。 Harbor 读取评分文件并记录结果。每道题设有多个评测要点,全部满足才算通过,得 1 分;任一要点未满足则不通过,得 0 分。
评分方法
每道题采用二元评分:每道题的所有评测要点全部满足,得 1 分;任一评测要点未满足,得 0 分。最终判定以独立验证环节输出的评分结果为准。
本方案以任务通过率汇总整体表现,计算方式为:
任务通过率 = 通过验证的任务数 ÷ 参评任务总数 × 100%。
# 对比示例展示
【任务名称】:Cu–Mg 合金热力学模型重评估与实验设计
【任务编号】:cumg-laves-reassessment
【领域】:材料科学
【标签】:热力学建模、参数拟合、相平衡、驱动力、敏感性分析、实验设计
该任务要求智能体利用铜–镁(Cu–Mg)体系的热化学及单侧相界记录,重新拟合五相热力学模型,并进一步完成相平衡、驱动力、参数敏感性与新增实验选择。最终需要提交七个结果文件,既给出计算结果,也给出支持这些结果的参数见证,即能够实现所报数值的参数组合。
本例对比同一道题的两次运行:GPT-6.1-sol(max)使用 Codex,Kimi K3.1 Pro(max)使用 Claude Code。
【输入指令内容】:
利用 `/workspace/data/measurements/` 中的 Cu–Mg 热化学及单侧相界记录,重评估 `/workspace/data/base.tdb` 的五相热力学模型。分别对全部数据、删除 `Bagnoud1978`、删除 `garg1973thermodynamic` 三个情形最小化来源分组目标 J,计算 `/workspace/data/queries.csv` 指定的稳定相平衡,以及 1000 K、Mg 原子分数 0.30 和 0.36 的受限均匀液相形成 C15 相的驱动力。对全部数据情形,在固定参数集合 $ J(z) \leq J_{anchor} + \delta $ 中求两个驱动力各自的上下界,$ \delta $ 分别取 0.1 和 1.0,并为每个端点给出实现该值的参数见证。进一步计算全部数据情形下 VV0010 的非线性目标剖面,并比较一次新增测量对驱动力预测歧义的约束能力。对 `/workspace/data/design_spec.json` 中的候选实验,在同一测量误差区间内寻找驱动力差异最大的两组可行参数,计算最坏情况下剩余的预测歧义,选择使其最小的实验。候选测量精度是该前瞻性研究的假设,不是历史数据的实验误差。原有拟合、相平衡和敏感范围的计算约定和输出格式以 `/workspace/data/fit_spec.json` 为准,其中定义自由系数及缩放、来源分组目标、热化学参考态、缺失值含义、单位和查询索引。所有能量按每原子摩尔归一,组成使用 Mg 原子分数;端点范围是在给定模型和参数域下的条件敏感性。J_anchor 是定义参数集合的固定常数。参数剖面、候选物理观测量及实验选择的定义和输出格式以 `/workspace/data/design_spec.json` 为准。提交 `/workspace/output/models.json`(三情形的参数、系数、J 和来源贡献)、`/workspace/output/equilibria.csv`(60 个查询的非零相、相分数、相组成和总能量)、`/workspace/output/driving_forces.csv`(6 个驱动力及对应的 C15 极小组成)、`/workspace/output/sensitivity.json`(8 个端点及参数见证)和 `/workspace/output/diagnostics.json`(各情形的来源残差分解和参数触界标记)。另提交 `/workspace/output/identifiability.json`(四个固定参数条件下的最小目标值、参数见证及驱动力)和 `/workspace/output/experiment_design.json`(各候选实验的最大剩余歧义、两组参数见证、观测区间交集和所选实验)。字段、数值类型及索引遵循上述两份规格,可附加数值收敛诊断。你有 28800 秒完成此任务。不得通过使用网上针对本任务的解答或提示作弊。
【GPT-6.1-sol(max)最终回复内容】:
已完成并校验全部 7 个文件。三情形的 J 按题述顺序为 **21.4066773、16.9577972、14.5988641**。最优候选为 **C15-a-1000**。按指定精度假设,最坏剩余歧义为 **668.93 J/mol-atom**,缩小约 **1.52%**。- [models.json](/workspace/output/models.json)、[diagnostics.json](/workspace/output/diagnostics.json)- [equilibria.csv](/workspace/output/equilibria.csv)、[driving_forces.csv](/workspace/output/driving_forces.csv)- [sensitivity.json](/workspace/output/sensitivity.json)、[identifiability.json](/workspace/output/identifiability.json)、[experiment_design.json](/workspace/output/experiment_design.json)
【对 GPT-6.1-sol(max)的评测结果】:
{ "parser_results": { "test_format_and_coverage": "passed", # 检查七个交付文件的格式、字段与查询覆盖是否完整 "test_fits_and_diagnostics": "passed", # 检查拟合质量、系数、来源贡献与诊断信息 "test_stable_equilibria": "passed", # 检查稳定相平衡、相分数、相组成和总能量 "test_driving_forces": "passed", # 检查驱动力及对应的 C15 极小组成 "test_sensitivity": "passed", # 检查敏感性端点及其参数见证 "test_all_requirements": "passed", # 汇总检查全部任务要求,任一检查失败则本项失败 "test_identifiability": "passed", # 检查固定参数剖面的最小目标值及驱动力 "test_experiment_design": "passed" # 检查实验设计的参数对、预测歧义与最优选择 }, "summary": { "tests_passed": "8/8", # 通过的测试项数;各项可能包含多条数值检查 "numeric_checks_passed": "549/549", # 通过的数值检查条数,仅用于诊断 "final_reward": 1 # 整题得分:全部通过为 1,否则为 0 }}
评测说明: GPT-6.1-sol 通过全部 8 项测试和 549 条数值检查,覆盖文件格式与完整性、拟合及诊断、稳定相平衡、驱动力、敏感性、参数可辨识性与实验设计等要求,单任务得分为 1。其中,全部数据情形下提交的目标函数值 J 与验证器复算值之差约为 1.59×10⁻¹⁰,满足 1×10⁻⁵ 的一致性容差。
【Kimi K3.1 Pro(max)最终回复内容】:
已完成全部数值计算,七个交付文件均已写入 `/workspace/output`,最终重算审计通过。### 拟合与驱动力驱动力单位为 J/mol-atom,温度为 1000 K。| 场景 | 最小化 \(J\) | \(D(x_\mathrm{Mg}=0.30)\) | \(D(x_\mathrm{Mg}=0.36)\) ||---|---:|---:|---:|| all | 21.406527231459 | -704.237471504 | -701.372470620 || without_Bagnoud1978 | 16.957797236883 | -648.841413664 | -650.641826923 || without_garg1973thermodynamic | 14.598876057774 | -608.599881770 | -598.633863144 |固定锚点始终保持为 `21.40667733700367`。### 灵敏度端点| 液相 \(x_\mathrm{Mg}\) | \(\delta\) | 下端点 | 上端点 ||---:|---:|---:|---:|| 0.30 | 0.1 | -809.688719662 | -593.731415605 || 0.30 | 1.0 | -1025.976050434 | -352.487421512 || 0.36 | 0.1 | -807.723770790 | -589.866753364 || 0.36 | 1.0 | -1025.751611897 | -346.482119004 |所有端点的十参数 witness、对应 \(J\) 和 C15 组成均已记录在 `sensitivity.json`。### VV0010 非线性剖面| 固定 `z[2]` | 最小化 \(J\) | 目标驱动力 \(D\),\(x_\mathrm{Mg}=0.36\) ||---:|---:|---:|| -3 | 46.631116927489 | -1001.779349834 || -1 | 22.384786891045 | -600.510672674 || 1 | 68.926642743143 | 51.436865099 || 3 | 184.197098215465 | 771.995015098 |### 实验设计| 候选 | 最坏歧义 \(R\),J/mol-atom ||---|---:|| liquid-H-1400 | 679.269492893 || liquid-a-1400 | 679.269492893 || C15-H-800 | 678.919078911 || C15-H-1000 | 678.044870413 || C15-a-800 | 672.807601627 || **C15-a-1000** | **668.955187335** |选择的最优候选为 **`C15-a-1000`**。各候选的两个可行模型、观测量及重叠区间均已保存。### 交付文件- `/workspace/output/models.json`- `/workspace/output/equilibria.csv`- `/workspace/output/driving_forces.csv`- `/workspace/output/sensitivity.json`- `/workspace/output/diagnostics.json`- `/workspace/output/identifiability.json`- `/workspace/output/experiment_design.json`最终审计重新计算并核验了 **3 个模型、60 个稳定平衡查询、6 个驱动力、8 个灵敏度端点、4 个剖面 witness 和 6 个实验设计 witness**;同时检查了目标函数、相分数与组成平衡、能量重建、固定锚点约束、观测区间重叠、精确 CSV 表头及七个文件的有限数值和常规文件属性。
【对 Kimi K3.1 Pro(max)的评测结果】:
{ "parser_results": { "test_format_and_coverage": "passed", # 检查七个交付文件的格式、字段与查询覆盖是否完整 "test_fits_and_diagnostics": "failed", # 检查拟合质量、系数、来源贡献与诊断信息 "test_stable_equilibria": "passed", # 检查稳定相平衡、相分数、相组成和总能量 "test_driving_forces": "passed", # 检查驱动力及对应的 C15 极小组成 "test_sensitivity": "failed", # 检查敏感性端点及其参数见证 "test_all_requirements": "failed", # 汇总检查全部任务要求,任一检查失败则本项失败 "test_identifiability": "failed", # 检查固定参数剖面的最小目标值及驱动力 "test_experiment_design": "failed" # 检查实验设计的参数对、预测歧义与最优选择 }, "summary": { "tests_passed": "3/8", # 通过的测试项数;各项可能包含多条数值检查 "numeric_checks_passed": "524/549", # 通过的数值检查条数,仅用于诊断 "final_reward": 0 # 整题得分:全部通过为 1,否则为 0 }}
评测说明: Kimi 提交了七个交付文件,文件格式与覆盖范围、稳定相平衡和驱动力三项测试通过。失败则集中于共用的目标函数计算:C15 相极小点位置精度不足,引发导数误差,使拟合、敏感性分析、参数剖面和实验设计中所报的 J 值与独立复算结果不一致,进而触发多项测试失败。
【对比结论】: GPT-6.1-sol 提交的拟合、相平衡与驱动力等结果满足验收要求,数值一致性检查全部通过,得 1 分。Kimi 在 C15 相计算中未充分保证极小点的位置精度,导致边界附近的导数误差放大,使目标函数 J 偏差超出容差,得 0 分。
# 参与测评
SuperCLUE-Terminal-Science 聚焦科研场景下的智能体任务执行能力,欢迎关注科研智能体的模型团队与研究人员交流评测需求,也欢迎领域专家围绕高价值科研任务参与题目共建。
评测申请
可使用单位邮箱发送申请至 contact@superclue.ai,邮件标题注明“SuperCLUE-Terminal-Science 测评申请”,内容包括单位信息、模型或智能体简介、联系人及联系方式。具体参测安排以沟通确认为准。
联系我们