国产大模型这两个月又开始价格内卷。阿里千问开源多模态MoE模型,智谱把GLM新模型的价格降到原来的十分之一,国产模型的Token单价一降再降。但热闹背后有个反常识的事实:在高强度的AI Coding场景下,国产模型的单价其实比有套餐的GPT、Claude还贵好几倍。德本咨询这份2026年通用大模型TOP30榜单,把跑在前面的模型公司排了出来。前十是这个赛道最核心的玩家。我们逐家看。
头部两强:深度求索、字节跳动
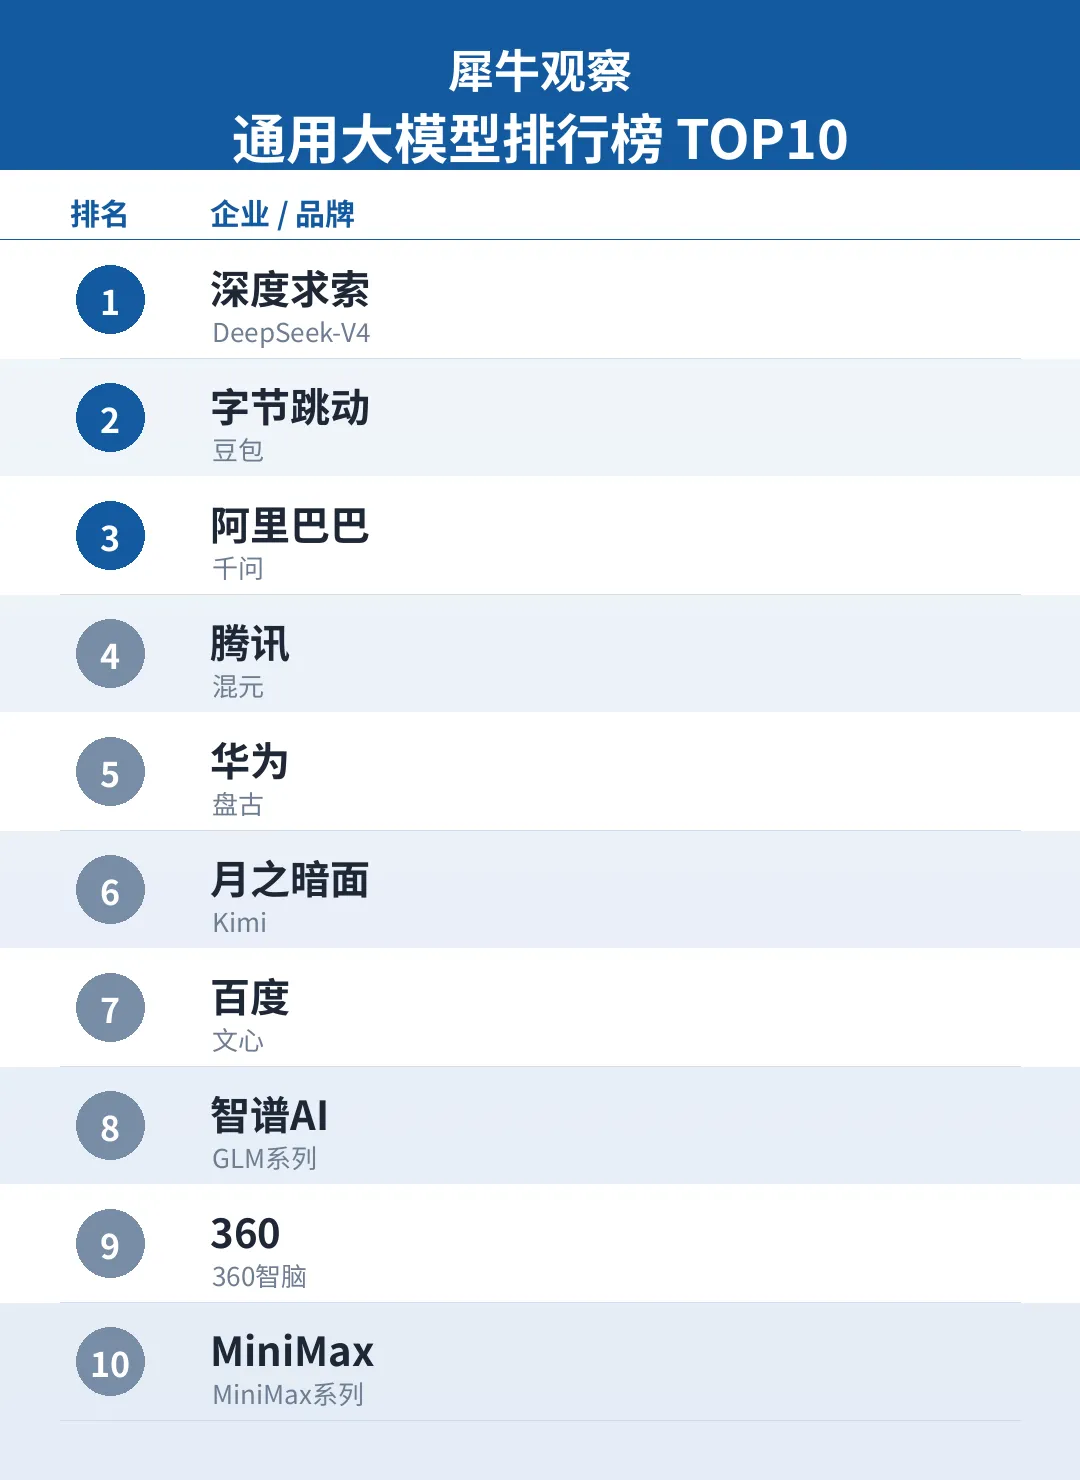
深度求索第一,字节跳动第二。
DeepSeek-V4排到榜首,靠的是开源和低成本推理这条路线,用极少的算力跑出了接近顶级的效果,震动了整个行业。字节的豆包则是C端用户量最大的国产大模型之一,背后是字节的算力、流量和工程能力,大模型业务年化收入已经做到四十亿美元。
这两家代表了两种成功路径:一个靠技术效率和开源社区,一个靠产品化和商业化变现。
关于价格,得把话说透。国产模型给人的印象是便宜,这在轻量调用场景下成立,但在高强度场景里恰恰相反。很多开发者每天消耗几十亿、上百亿Token,这种用量下,GPT的codex套餐反而是能买到的最便宜的Token,比智谱、Kimi按单价算便宜好几倍。国产模型标出来的每百万Token一元三元的低价,是按闲时和轻量调用算的,真到了高频重度使用,规模化的套餐成本优势就显出来了。这说明价格战打到最后,单纯压单价已经没有意义,谁能在同等效果下把推理成本真正降下来,谁才握有定价权。
更深一层的问题是,参数量持续膨胀之后,边际收益在递减,训练成本、推理延迟和部署难度却在指数级上升。看着模型很便宜,其实背后的训练和推理投入极其昂贵。低价更像是一种获客策略,而不是可持续的商业模式。
大厂阵营:阿里、腾讯、华为、百度
阿里巴巴第三,腾讯第四,华为第五,百度第七。
阿里的千问走开源路线,Qwen系列在开发者社区影响力很大。腾讯的混元背靠微信和游戏生态。华为的盘古立足政企和信创,跟昇腾算力栈绑定。百度的文心是国内最早布局大模型的一家,千帆平台加文心模型。
这四家的共同点是不缺算力和数据,大模型对它们来说不是全部生意,而是给原有业务加智能。它们的优势是资源厚、落地场景多。
创业公司:月之暗面、智谱AI、MiniMax、360
月之暗面第六,智谱AI第八,360第九,MiniMax第十。
月之暗面的Kimi以长文本起家,在用户心智里占了一席之地。智谱的GLM系列持续迭代,刚开源的多模态模型在网上爆火。360的360智脑走的是搜索加AI的路线。MiniMax则在视频生成和对话模型上双线布局。
这几家是独立大模型公司的代表,没有大厂的流量和算力靠山,只能靠模型本身的能力和开源社区建立口碑。
结语
通用大模型的核心是预训练和微调的成熟,基础架构基于变换器结构,在海量互联网数据上做自监督学习,相当于让模型读完了人类几千年的文本。但研发早已演变成对算力、数据和人才的综合考验,训练千亿级模型的投入,让只有极少数机构具备从头研发的资本,集中化趋势形成了技术高墙。
不过开源社区提供了另一条路。轻量化的开源模型加上微调,让很多小团队也能用上大模型能力。价格战还会继续卷,但卷到最后,真正能活下来的,要么是有极致技术效率的,要么是有庞大商业化场景的。靠低价撑着的模型公司,迟早要面对收入和成本的拷问。
还有一个值得注意的分化,是通用和专用的分野。通用大模型看着热闹,但真正赚钱的,往往是那些能扎进某个行业、解决具体问题的模型。语言、医疗、法律、编程,每个垂直场景的数据和需求都不一样,通用模型很难样样精通。未来的格局,可能不是一家通吃,而是少数几个通用底座加一批深耕行业的专用模型,各占各的地盘。对开发者和企业来说,选模型也会从追最新最大,转向选最适合自己场景和成本的那一个。模型越便宜,应用反而越容易跑起来,这才是价格战真正的正面意义。对中国的大模型产业来说,能不能在这场卷下来之后,留下一批既有技术壁垒又有商业化闭环的公司,才是真正的试金石。