系统盘怎么选?SATA DOM 与 M.2 选错就掉盘
- 更新时间 2026-11-13 10:51:22
系统盘怎么选?SATA DOM 与 M.2 选错就掉盘凌晨两点一个电话过来,说机房里那台业务机重启后卡在 No bootable device,人已经到机房门口了。这是我在同一个客户那里第三次见到同一种场面:2U 双路机,系统盘是一块没装散热片的 2242 M.2 盘,装完系统跑了三个月,某个夜里自己掉盘,重启就再也起不来。系统盘占整机成本不到 2%,可它一挂,整台机器就是一块铁。选系统盘这件事,比的是哪个形态在哪类现场不容易出事,不是谁的顺序读写更漂亮。 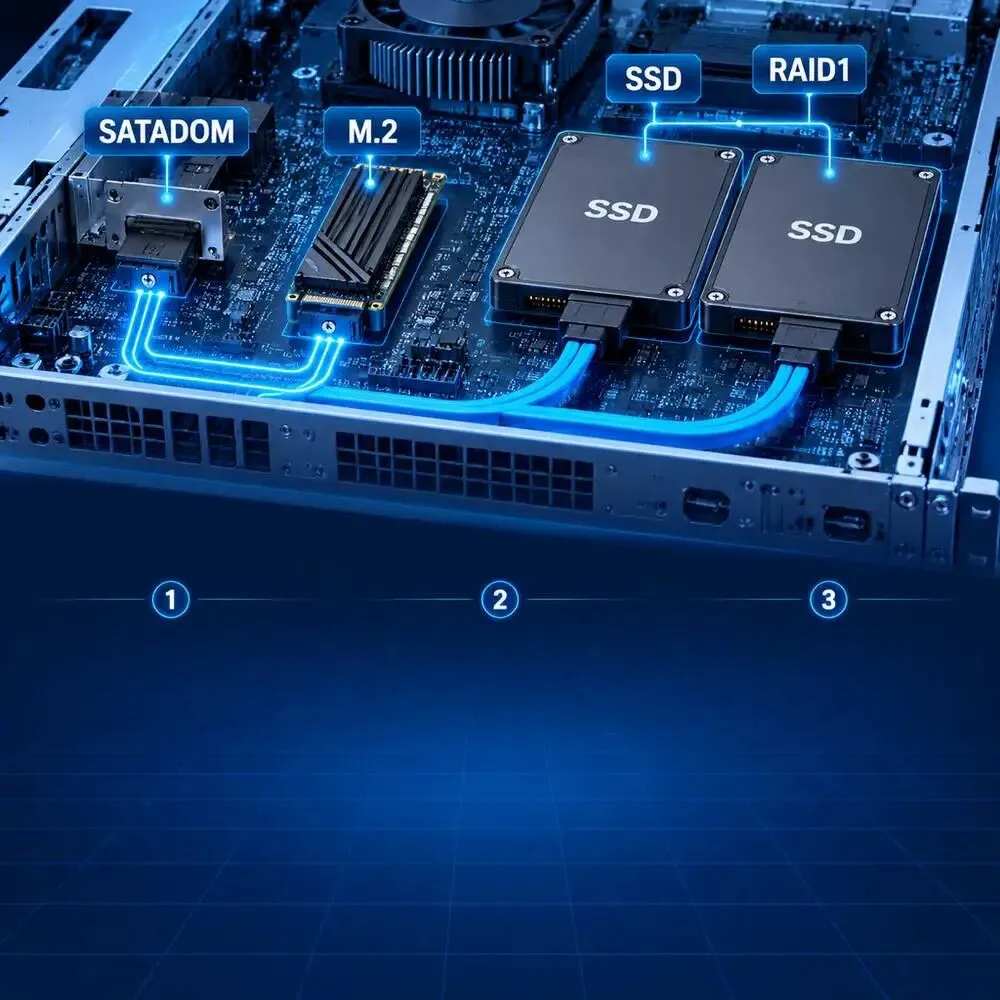
一、先分清手上这台机器用的是哪一种系统盘 很多人说系统盘,脑子里只有一种东西。机房里能当系统盘用的形态至少三种:主板 SATA 口上直插的 SATA DOM、主板 M.2 插槽上的小盘、两个盘位或两个 M.2 做 RAID1。三者成本差不多,踩坑方式完全是两套。判定现有机器是哪一种,先跑三条命令看块设备和引导方式。 lsblk -d -o NAME,SIZE,ROTA,TYPE,MODEL 每行一块盘,ROTA 为 0 是固态,MODEL 里通常带型号,SATA DOM 上常见 Innodisk、ATP、Transcend 这类工业品牌字样。 udevadm info --query=all --name=/dev/sda | grep -E "ID_MODEL|ID_BUS" 再确认这台机器是 UEFI 还是 Legacy 引导。 efibootmgr -v 有输出就是 UEFI 引导,ESP 分区一般是 512MB 的 FAT32。三条命令一跑,形态、容量、接口、引导方式全部清楚,后面谈选型才有基准,否则讨论的都是别人的机器。 二、SATA DOM 不占盘位不占通道,代价是容量和寿命 SATA DOM 直接插在主板 SATA 7pin 上,不需要线缆,不占 2.5 寸盘位,不占 PCIe 通道。机器装好之后它藏在主板上,运维基本看不见它,也就没人去碰它,这是它最大的价值。 DOM 的容量怎么定,按三块算:系统本身一般占 8GB 到 12GB,日志与临时文件按每天 200MB 到 500MB 算留 5GB,固件升级和内核残留再留 20% 余量。这样算下来 32GB 是底线,要保留三个月以上日志就得 64GB。容量压得太紧的后果不是装不上,而是三四个月后 /var 写满,sshd 起不来,人进不去机器,只能现场接显示器。 DOM 还有一点容易被忽略:它没有盘位、没有指示灯,坏了不会有人立刻发现,只能靠监控。上架时就把根分区使用率和 SMART 写进监控,超过 80% 报警,比事后救火便宜得多。而 2.5 寸 SATA SSD 虽然便宜、容量大,但要多占一个盘位、两根线,机器搬动时线缆松脱导致的掉盘,比盘本身坏更常见。 三、M.2 系统盘性能最爽,坑也最密 M.2 分 2280 和 2242 两种长度,机架机多为 2280,紧凑型主板常给 2242。协议上分两种:PCIe NVMe(Gen3 x4 约 3.5GB/s、Gen4 x4 约 7GB/s)和 SATA AHCI(550MB/s 封顶),同一个插槽不一定两种都认,看主板手册而不是看商家页面。 买回来先确认它到底是什么盘,别只看包装。 lspci | grep -i non-volatile 能列出 NVMe 控制器说明走的是 PCIe 通道;列不出来但 lsblk 里有盘,多半是 SATA 协议的 M.2。 nvme id-ctrl /dev/nvme0 -H | grep -E "mn|fr|tnvmcap" mn 是型号、fr 是固件版本、tnvmcap 是标称容量,固件版本记进交付清单,后面批量刷固件对版本才有依据。 四、双盘 RAID1 用两个盘位换一台机器睡得着 两块 SATA SSD 或两块工业级 M.2 做镜像,是最省心的做法,前提是引导区也要一起做镜像。硬 RAID 由 RAID 卡完成,对系统透明,换盘重建在卡里进行,缺点是卡本身是单点,卡坏了要用同型号卡恢复配置。软 RAID 用 mdadm,零成本,但引导链要自己接住。 五、三种形态怎么选,照这四条拍板 选型只问四件事:有没有盘位,决定 M.2 还是 DOM;有没有掉电保护,决定断电后还能不能起来;ESP 是不是双份,决定单盘坏能不能引导;固件认不认这块盘,决定装完能不能开机。四问答完,系统盘就定了,不必再纠结顺序读写谁快。 六、装完就掉盘,六步排查链照着走 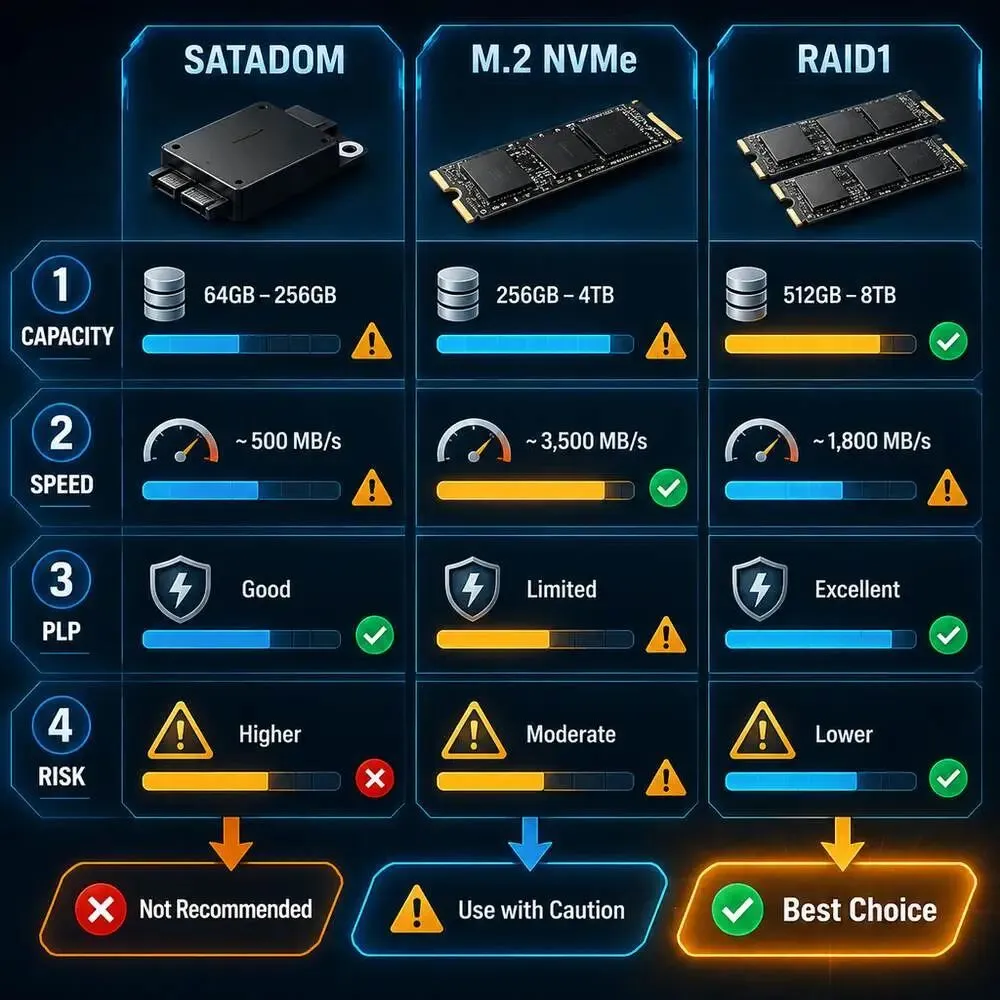
七、上架前十分钟,这十项自检做完再交付 同样的盘,交付时多花十分钟,后面能省两小时的现场救援。这份清单可以直接照抄进交付单。 这十项里,第五项和第七项是最容易被跳过的两项,也恰好是后面事故率最高的两项。空载温度高的盘,夏天一到就掉;ESP 没做双份的机器,坏一块盘就等于整机报废。 八、写在最后 系统盘真正的成本不在盘本身,而在出事后那两小时和客户的信任。三条铁律可以直接抄走:系统盘必须与业务数据分离;断电场景必须选带掉电保护的盘;单盘系统盘必须默认它随时会坏,备份和 RAID1 二选一,不能两个都没有。多数机房事故不是选错了型号,而是从来没把系统盘当回事。 你现在机器上的系统盘是哪一种,SATA DOM、M.2 还是双盘 RAID1?评论区说说踩过最惨的一次掉盘经历,我按你们遇到的型号再拆一轮细节。 #服务器 #系统盘 #运维 #固态硬盘 #装机
容量普遍 16GB、32GB、64GB,接口 SATA 6Gb/s,颗粒多为 SLC 或 pSLC,出厂按工业级长寿命设计
不少型号带掉电保护,型号后缀常见 PLP 字样,拍板前让供应商给出断电测试报告
容量小是硬伤,系统加日志很快吃满,/var/log 要单独挂盘,或限制 journal 体积
写入寿命按 TBW 算往往只有几十 TB,日志狂写的业务必须配日志盘,不能全压在 DOM 上
随机 IOPS 只有几万级,数据库目录不要和系统盘同盘
供电是最常见的一坑:SATA DOM 要 5V 供电,有的主板 SATA 口是 7pin 数据加 15pin 电源一体,插 DOM 必须用支持 DOM 供电的口,插错口的表现就是 BIOS 里压根看不到这块盘
还有一类 USB DOM 走 USB 通道,Legacy 引导兼容性好,个别平台在 UEFI 下要单独打开 USB 引导项,批量装机最容易漏这一条
消费级 NVMe 的 TBW 偏低,1TB 盘常见 600TBW 上下,且没有掉电保护,温度墙通常 70℃ 到 80℃,2U 机箱风道差的时候先降速后掉盘
老平台坑:2015 年前后的固件可能不含 NVMe 驱动,BIOS 里看不到 M.2 盘,也没法从它引导,只能刷固件或改用 SATA 协议的 M.2
VMD 坑:Intel 平台开启 VMD 后 M.2 挂在 VMD 后面,装系统时看不到盘,改回或改开模式后原有系统直接蓝屏,报 0x7B INACCESSIBLE_BOOT_DEVICE
通道坑:M.2 走 CPU 直连还是 PCH 差别很大,部分机型插满 PCIe 卡后 M.2 直接失效,选机时要把 M.2 的通道来源问清楚
位置坑:M.2 装在 riser 或背板下方,风道被挡,长期 70℃ 以上,掉盘只是时间问题,2280 盘务必配导热垫或金属散热片
建阵列:mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/sda2 /dev/sdb2
看状态:mdadm --detail /dev/md0,State 必须是 clean,出现 degraded 说明已经单盘运行,立刻换盘
引导坑:UEFI 下 ESP 只存在一块盘上时,那块盘坏了机器起不来,RAID1 只保住了数据没保住启动
正确做法:两块盘各建一个 512MB ESP 各装一份 grub,定期用 dd 同步,或直接在支持 RAID1 ESP 的固件上把 ESP 也做镜像
监控:smartd 加 mdadm 归档到监控系统,别等人打电话才知道阵列已经降级一周
单机、几十台以下、盘位紧张、预算紧:SATA DOM 32GB 或 64GB,工业级,带 PLP 更好
有盘位、要性能、边缘节点或超融合:工业级 M.2 2280 带 PLP,240GB 到 480GB,务必配散热片
机房批量、业务不能停:双 SATA SSD 480GB 做 RAID1,ESP 双份,阵列状态进监控
虚拟化宿主机、日志量大:系统盘只装系统,日志和数据全部独立盘,容量按 3 个月增长量留
第一步看盘在不在:lsblk -d -o NAME,SIZE,ROTA,TYPE,MODEL,盘不出现先查供电口和插槽协议,别急着换盘
第二步看链路有没有降速:lspci -vv 里的 LnkSta 若显示 Gen1 x1,说明接触不良或插槽共享,重插或换槽
第三步看温度与寿命:nvme smart-log /dev/nvme0 关注 temperature、percentage_used、media_errors、unsafe_shutdowns 四项
第四步看 SMART 计数:smartctl -a /dev/sda 看 Reallocated_Sector_Ct、Wear_Leveling_Count、Power_On_Hours
第五步看引导项与 ESP:efibootmgr -v 看 BootCurrent 指向哪块盘,lsblk -f 确认 ESP 落在哪
第六步看阵列状态:mdadm --detail /dev/md0,State 不是 clean 就先换盘再谈重建
一查盘型:lsblk -d -o NAME,SIZE,ROTA,TYPE,MODEL,确认系统盘型号与选型单一致
二查协议:lspci | grep -i non-volatile 与 lsblk 交叉核对,确认走 PCIe 还是 SATA
三查固件:nvme id-ctrl 或 smartctl -i 记录固件版本,写进交付单
四查链路:lspci -vv 看 LnkSta,必须是与插槽规格一致的宽度和速率
五查温度:nvme smart-log 的空载温度,2U 机箱空载超过 55℃ 就要补导热
六查引导:efibootmgr -v 确认 BootCurrent 指向系统盘,Legacy 机器用 fdisk -l 看引导标志
七查 ESP:lsblk -f 确认 ESP 存在且容量 512MB,RAID1 方案确认两块盘都有
八查阵列:mdadm --detail /dev/md0 的 State 为 clean,且两块盘都在位
九查监控:根分区使用率、SMART 关键项、阵列状态三项进监控,阈值 80%
十查备份:系统盘配置有备份或镜像,能在一小时内重建到同型号盘上
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
