同一份机器人策略,换批初始位姿或换个随机种子,成功率就能差出一截。评测分数是能力加噪声,而报出来的往往只是一个均值,噪声多大都没说。
— 具身内核 · 每日具身智能技术讲解 · 第 6 期 —
封面示意图由 AI 生成,仅作概念示意,不代表真实实验数据。
01开场 - 三个点,是能力还是运气
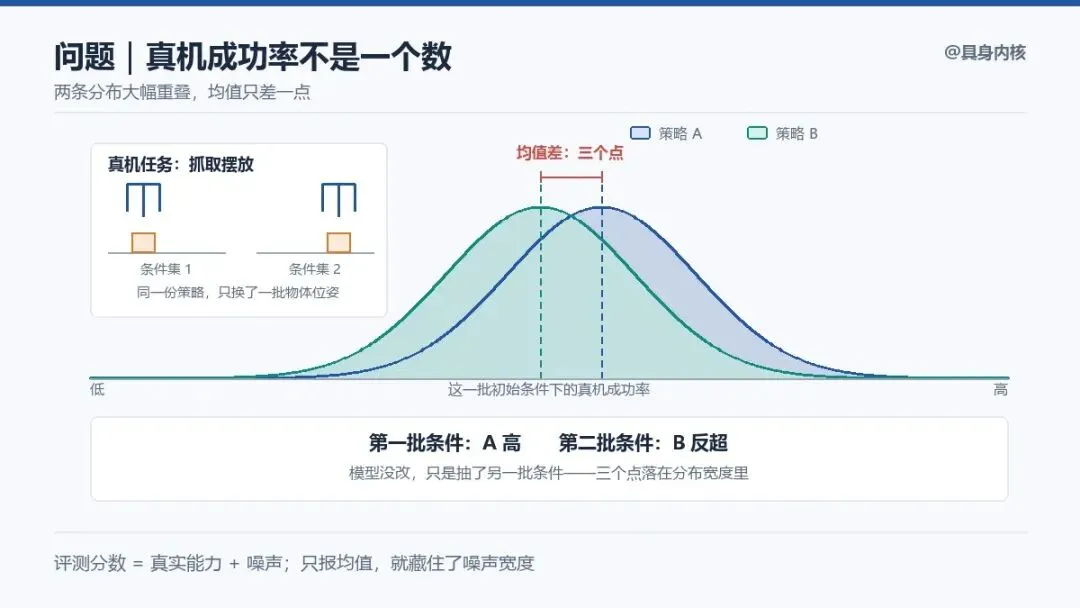
机械臂做抓取摆放,两版策略在同一批初始位姿上评测,A 比 B 高三个点,团队据此换了 A。三周后换批位姿重测,B 反超。
模型一行没改,变的只是测了哪些条件:物体摆在哪、光照怎么打、这批难不难。
那三个点于是成了悬案:它是能力差距,还是这一次抽样运气好?如果一次评测只交付一个数,它能支撑什么结论?
02技术原理 - 噪声有三层,你重复的是哪一层
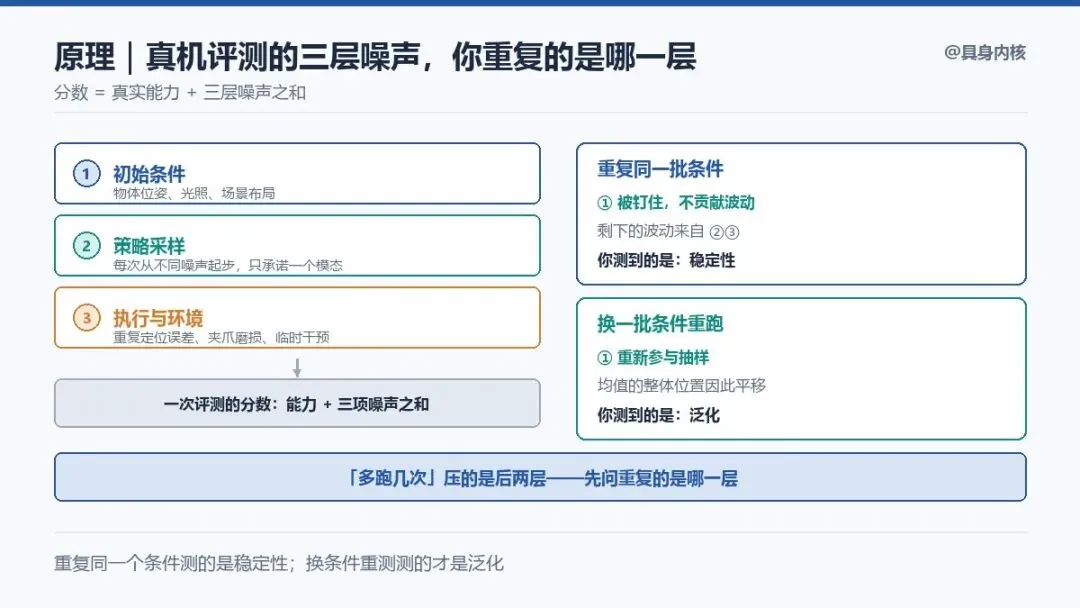
先把分数拆开:它是真实能力加评测噪声。噪声至少三层。
解法不是把评测做得更准,而是拆成可控项,用不同重复方式分别测。
第一层是初始条件。物体位姿、光照、场景布局,本身就是从分布里抽的样本。
第二层是策略自身的随机性。扩散与 flow 每次从不同噪声起步,一次 rollout 只承诺一个模态:同一观测两次执行,可能一次成功一次失败。
第三层是执行与环境。重复定位误差、夹爪磨损、线缆牵扯、人的临时干预。
三层的区别在「怎么重复」。固定同一批条件反复跑,第一层被钉住,剩下的波动来自策略采样与执行——这时你测到的是稳定性。换一批条件重抽,第一层重新参与,均值的整体位置就会平移,结论跟着翻转。
所以「多跑几次」能压掉的是后两层的抽样误差,压不掉第一层的分布宽度——而后者才是结论翻转的来源。
还有一层更隐蔽的:挑训练中表现最好的 checkpoint 报数,等于在噪声上取最大值,必然高于期望。「最好」和「最近若干轮平均」是两个口径,常常差得可观,而引用时只引前者。
03同一个 checkpoint 测两次,差多少算正常
把 n 次 rollout 的成功率看成一个比例估计:它的波动区间由 n 决定,按次数的平方根缩小——成本是线性的,精度是平方根的。
n 小的时候,这个区间可能和你想分辨的差距一样宽,此时「A 比 B 高三个点」和掷硬币没有区别。
所以动手比较之前,先测自己的噪声地板:同一份权重、同一批条件,重复测两遍,看差多少。这个数才是后面所有提升的门槛。
04工程挑战 - 把「这批条件难不难」减掉
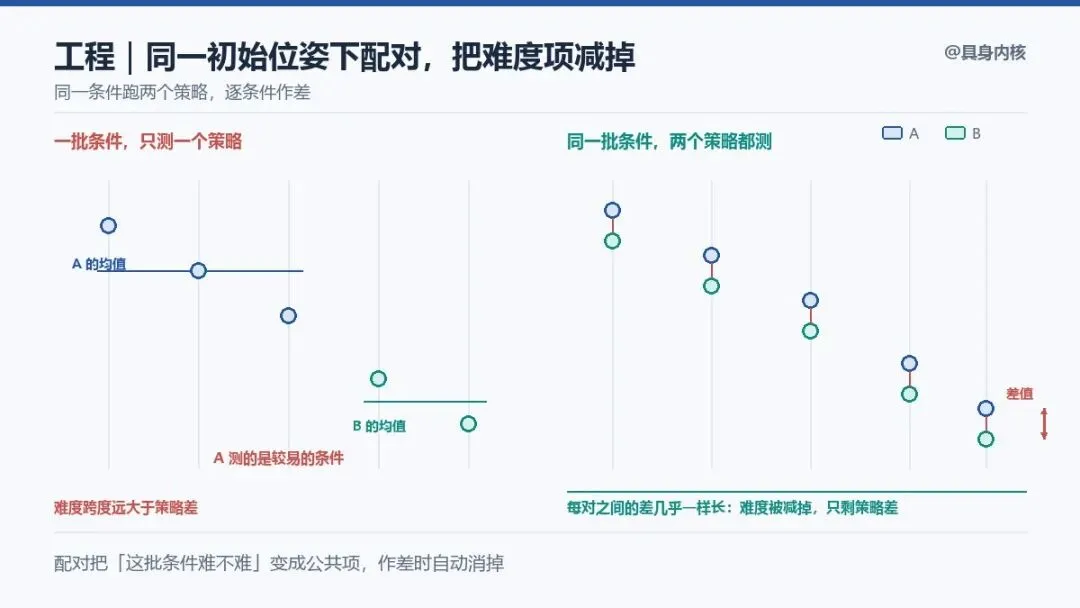
第一,用配对设计。在同一初始条件下跑两个策略,逐条件比赢输,把「这批条件难不难」这个公共项消掉。RoboArena 走的是这条路:一对比较内保持相同初始条件,跨对允许不同场景与任务,靠大量配对聚合出排序。
第二,协议写清三件事:初始条件怎么采样、每条件跑几次、报哪个口径(均值、中位数,还是最好的那次)。
第三,评测集留分布外分割:训练分布内的高分测不出泛化。
第四,成本真实。真机评测占机器时间,配对让次数翻倍,但方差降更多,通常净赚。
05结语 - 该交付的是分布,不是一个数
一句话:成功率是随机变量的一次抽样,不是策略的属性值。评测该交付的是分布和区间,不是一个数;只报均值不报离散度,等于把「这次运气好不好」藏了起来。选型本质是在评测成本与结论可靠性之间找平衡——跑多少次、配对还是独立、报均值还是报最好,全看这个结论要支撑多大的决定。