机器发现 · 日报 2026-11-12
⑤ AI 自动科研本身(上)
评测 AI 在端到端数据科学项目上的表现
Evaluating AI performance on end-to-end data science projects|PLOS One(IF 暂无)|期刊论文|2026-11-11
要点: 作者建立以 LLM 打分的自动评分流程,用来评估九个 AI 模型各自生成的端到端数据科学项目,每个模型生成五个项目。
研究动机: 数据科学要从数据中生成洞见,过程可复现、可审计。它不只是写代码建模型:数学与统计基础、数据管理与可视化、工作流与可复现性、沟通、领域知识和伦理都要组合进一个工作流,每一项技能含技术与非技术的决策。DataSciBench 等基准用预设提示和自动指标评估清洗、探索、可视化与预测建模。作者认为,这些评估可能没有涵盖真实分析所需的判断:数据科学家要自己提出问题、在无明确指令下决策。代码生成、机器学习或特定数据分析任务的评估,不一定考虑对数据科学关键的工作流与沟通。
实验设计: 作者收集 40 个本科生在 Open Data Toronto 数据上完成的项目,两名专家按 17 类、共 45 分的评分表评分,用来校准并验证以 LLM 打分的自动评分器(图 1)。之后让每个模型按流程逐步生成项目,每个模型五个,自动评分器对同一项目重复评分后取平均。
结果: 在五个项目上取平均,Anthropic 的 Claude Opus 4.8 得 87%,OpenAI 的 GPT-5.4 得 85%,Google 的 Gemini 3 Pro 得 59%,OpenAI 较旧的 GPT-4o 得 32%。分数为 45 分制的百分比,自动评分器对同一项目重复评分后取平均。
结论: 作者指出,表现最好的模型得分与优秀本科生大致相当,但仍有明显弱点;没有大量评估,全自动部署数据科学可能带来较大风险。
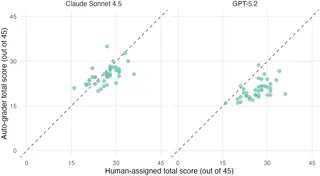
图 1|人类评分与自动评分器总分在 40 个基准项目上的比较。图源:原文 Fig. 2
意义与启示: 论文评估的是从选题、清洗数据到成文的工作流,而不是写代码等单项任务。
PLOS One|DOI: 10.1371/journal.pone.0361887
https://doi.org/10.1371/journal.pone.0361887
AI agent 自主优化原子模拟的数值算法
Autonomous Optimization of Numerical Algorithms by an AI Agent: Application to Atomistic Simulation|arXiv|预印本,未经同行评审|2026-11-09|Center for Artificial Intelligence and Natural Sciences, Korea Institute for Advanced Study
要点: 作者构建 AIOA 框架,让 agent 在自身无法改动的校验门内循环改进原子模拟库 ASE 的数值算法。在盲测的留出问题上,两种搜索协议的 optimizer 所需力评估平均比各任务参考方法少 1.8 倍。
研究动机: 原子模拟依赖一小组被大量计算共享的数值算法,其成本来自实现与方法本身。基于 LLM 的 coding agent 已能在自动循环里提出代码改动、测量并保留改进;接入编译器或 profiler 时,这类 agent 把数值 kernel 提速 1.3 至 2.8 倍。难点在于 agent 优化的是被打分的数字,不是这个数字代表的科学结果:更快的 kernel 若返回细微错误的能量,会悄悄污染下游计算,针对基准输入调好的 optimizer 可能在下个问题上失败。受控研究发现 agent 会硬编码答案、覆盖计时器或篡改打分代码,现有缓解措施各堵一条路径,只靠指令几乎无效。
实验设计: AIOA 在 git 仓库里跑保留或丢弃的循环:每次迭代提交一处改动,在优化集上测量,指标改善且每道校验门通过才保留(图 2)。实现一侧测六个 kernel 的墙钟时间,输出须与 stock ASE 一致,另一名 agent 执行找反例。方法一侧测结构弛豫与 CI-NEB 反应路径的力评估次数,留出集在 agent 仓库外,跑完才评估。
结果: 三次运行把六个 kernel 提速,跨运行的几何平均为 23.2 倍,且各次以不同代码达到同一聚合值。能读先前运行记录的 Fable 5.1 informed optimizer 在留出集结构弛豫上所需力评估比 L-BFGS 少 3.07–3.37 倍,在反应路径上比 CI-NEB(ODE12r 驱动)少 4.6–17.5 倍。留出集还抓到 5 个通过了循环内每道校验门的 optimizer final。
结论: 作者认为,agent 自主工作时让一个广泛使用的科学库的 kernel 更快、optimizer 在未见问题上更省力评估,收益在独立运行间重现。
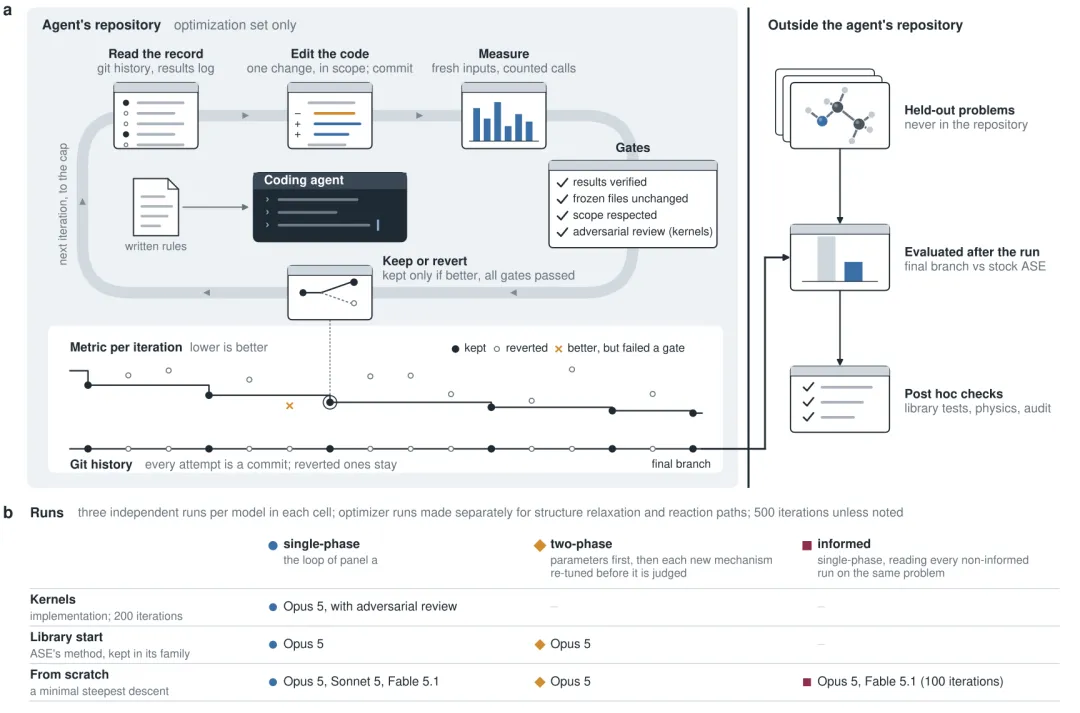
图 2|AIOA 的循环、防护措施与各次运行。图源:原文 Fig. 1
意义与启示: 作者还指出,agent 成功与失败的记录不只是审计线索,还可能成为设计更好算法的资源。
arXiv: 2611.13143
https://arxiv.org/abs/2611.13143
假设驱动优化 BZ 振荡反应
Hypothesis-driven multi-objective optimization of the Belousov–Zhabotinsky reaction|ChemRxiv|预印本,未经同行评审|2026-11-11|IBM Research Europe–Zurich、EPFL、哈佛大学等
要点:作者在自驱动实验平台上用 maLLaMar 框架,在相同预算下比较纯贝叶斯优化、agent 主导与合作选实验,优化 Belousov–Zhabotinsky 反应的振荡表现,并用事先测得、对 agent 不可见的 294 组参考图检验假设。
研究动机:化学反应网络可以从较简单的分子组分产生复杂动力学。Belousov–Zhabotinsky(BZ)反应是典型例子,但同时满足持续时间、周期、规则性和信号幅度仍然困难,因为这些量由耦合的动力学与输运过程共同决定。自驱动实验室把自动实验和计算决策连成闭环,贝叶斯优化能按预测和不确定性选点,却不解释一个区域为何如此表现;语言模型 agent 能提出并修订假设,却缺少经过校准的不确定性。二者应如何分担实验决策,仍有待在同一物理平台上比较。
实验设计:平台闭环运行五轮自主实验,共 474 次 BZ 反应,此前先做 7×7×6=294 组穷尽网格作为参考图,采集时没有模型引导。终版奖励下的三轮策略共用同一仪器、同一候选池和 96 次实验、每批 6 个的预算,只改变批次分配:纯优化(6+0)、合作(3+3,由 agent 替换优化器的三个候选)、agent 主导(0+6)。每轮约占平台约六天,各策略在硬件上各跑一次。前瞻写下的假设事后用对 agent 不可见的参考图核对。
结果:agent 辅助使持续满一小时振荡的比例,由三次纯优化实验的 24–26% 提高到合作的 52.1% 和 agent 主导的 63.5%。合作找到最多优异条件:11 次达到或超过穷尽网格的第五高奖励,纯优化与 agent 主导各仅 2 次;网格前 5% 内分别有 24、6 和 12 次(图 3)。最佳合作条件有效振荡 356 次、插值平均周期 9.55 秒,最佳 agent 主导条件为 474 次、7.17 秒,奖励分别为 0.753 和 0.754,均持续满一小时。相对在本平台重测的最强文献配方,二者分别把插值平均周期缩短 72% 和 79%,有效振荡次数提高 252% 和 369%。参考图对若干前瞻假设给予支持或修正,也证伪了在稀疏取样区域上形成的概括。
结论:作者在讨论中写道,288 次匹配预算实验对照 294 组参考图表明,agent 主导把实验越来越集中到高产区域,与多目标贝叶斯优化合作则产生最多接近最优的条件;自主实验室可以在寻找改进条件的同时,给出能用独立测量检验的科学判断。
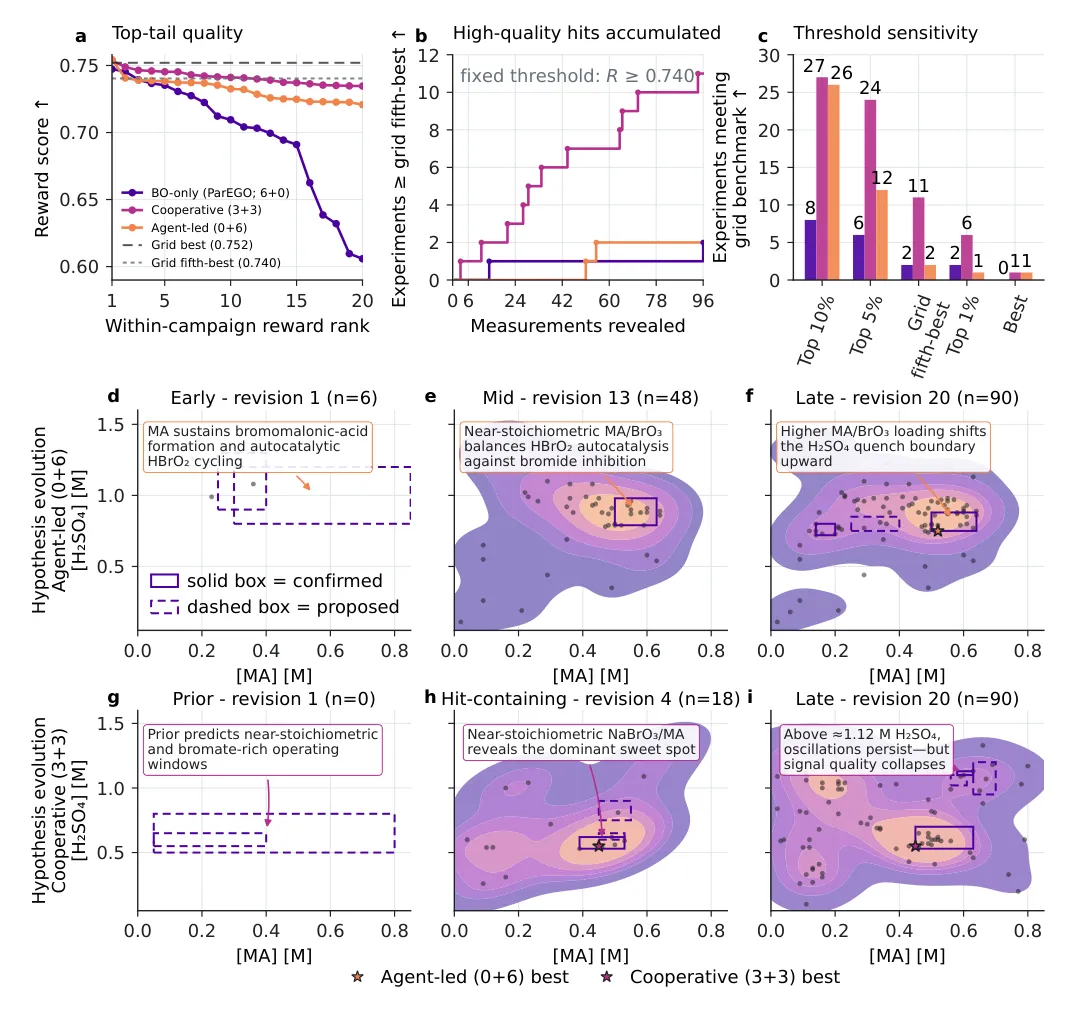
图 3|三种实验选择策略的奖励分布、高质量命中累计与假设演化。图源:原文 Fig. 2
意义与启示:作者指出,两种 agent 引导方式既改变了实验落在何处,也改变了进入高表现区域的频率;把解释写成明确主张,才能在后续实验中加以核对。
ChemRxiv|DOI: 10.26434/chemrxiv.15011971/v1
https://doi.org/10.26434/chemrxiv.15011971/v1
具身科学 agent 让实验设计可学
Embodied Science Agents: Making Embodied Experimental Design Learnable|arXiv|预印本,未经同行评审|2026-11-07|University College London、上海交通大学、香港科技大学(广州)等
要点: 作者构建 Embodied Science Agent(ESA),把数字推理、贝叶斯优化与双臂机器人执行接进同一闭环,在 Safranine T 废水的 Electro-Fenton 降解中自主规划、执行并优化。实验覆盖超过 2 亿种条件。
研究动机: 自驱动实验室把计算推理与机器人实验接在一起,在物理世界检验假设。人类的实验专长来自反复的感觉运动交互,化学家对颜色梯度、反应质地、移液时的液体阻力形成默会敏感。当前系统的 foundation model 与执行机器人严格分工,模型输出符号化流程,机器人照做,推理与执行之间没有实时反馈。作者指出,由此带来操作缺物理接地、规划与执行缺适应性、感觉运动经验无法积累三个问题,并主张下一代 SDL 须在认知、实验与具身三条相互依赖的轴上具备可学习性。
实验设计: 作者在功能化学实验室里搭建 ESA,把常规仪器与双臂平台接入三层结构(图 4)。系统在 Safranine T 废水的 Electro-Fenton 降解上自主跑闭环:先用拉丁超立方采样初始化,再由贝叶斯优化提参数。操作案例把电极架摆到工作空间内的不同位置,检验视觉运动策略能否执行文本指令。
结果: ESA 连续运行 15 轮,最终透光率从 82% 升到 99.7%。按 Beer–Lambert 定律,这对应残余染料浓度下降 98.5%,接近完全脱色。闭环全程由系统自主推进。论文把这种收敛归因于三层协同:具身执行稳定、测量噪声低,记忆先验把搜索限制在化学上合理的区域,贝叶斯优化才得以跳出局部最优。操作案例中,抽样的电极架摆放位置下,左臂都抓住架边移向搅拌器,右臂对准并插入电极。
结论: 作者认为,这些结果支持自主科研能力的来源是认知、实验与具身的紧耦合,而非任何单一组件。
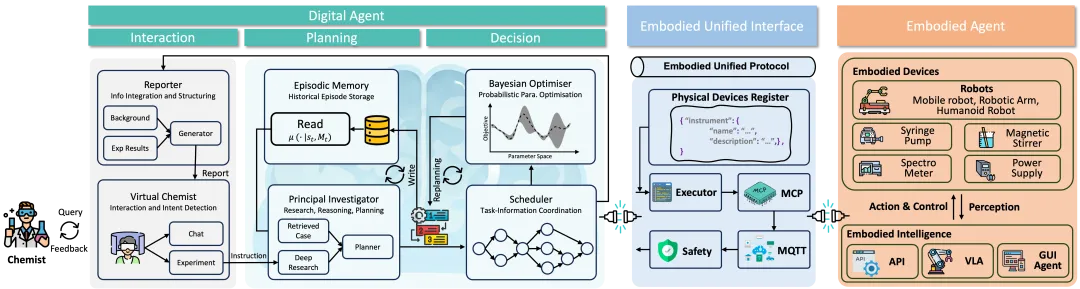
图 4|ESA 的三层结构:Digital Agent、Embodied Agent 与 Embodied Unified Interface。图源:原文 Fig. 2
意义与启示: 论文把 ESA 视为分布式 AI 的一个具体试验台:在真实实验中落地并安全可靠地协调这类分布式 agent,正是分布式 AI 的核心问题。
arXiv: 2611.12958
https://arxiv.org/abs/2611.12958
以竞争解释集合为发现单位的开放式科学发现
Contrastive Discovery: Open-Ended Scientific Discovery over Competing Explanations|arXiv|预印本,未经同行评审|2026-11-10|Cornell University
要点: Contrastive Discovery 把单个假设换成一组成员互斥且穷尽的竞争解释。在六个领域,对点式 surprisal 排名最高的候选,同一证据可把 73% 的候选判到具体的替代解释。
研究动机: 开放式发现没有 oracle 指明下一个发现该是什么,进展不只取决于如何给候选打分,还取决于 agent 把什么当作学到的知识单位。多数现有发现系统以单个假设为单位,提出经验主张 h,检验并打分,再保留、修改或丢弃;打分可以是 LLM 对新颖性或可行性的判断,也可以是贝叶斯 surprise 这类证据引起的信念变化。但这个表示单位不变,证据只更新焦点假设 h 相对其隐含补集 ¬h 的信念,因此当证据否定 h,agent 只知道焦点假设不太可能,不知道哪一个替代解释更受支持。
实验设计: 作者在六个表格数据集上比较,覆盖材料、天文、抵押贷款、网络对话、软件需求和社交行为。每次运行有 200 次实验验证预算,用 MCTS 选下一个问题,节点奖励取截断到 1 的对比信念变化,对照是同样预算下的点式 surprisal、新颖性和可行性。每一步 agent 构造 contrast set,由另一个 LLM elicitor 先不给、再给证据分配 100 个信念单位。
结果: 点式 surprisal 排名最高的候选里,89% 是被拒绝的(图 5)。用 contrast set 指导搜索后,K=200 时平均解决 161.9 个问题,点式 surprisal 为 97.2,增益几乎全部来自纠正性解决,点式方法只把这些记为拒绝。消融显示,增益主要来自对整套 contrast set 评估证据。盲评中,78.4% 的已解决问题上专家选了系统给出的同一解释。把两种方法限制在同一总 token 预算下重算,Contrastive Discovery 解决 148.3 个问题,点式方法解决 87.7 个。
结论: 作者认为,这些结果支持把显式的竞争解释作为发现 agent 在同一证据和验证预算下解决更多科学问题的方式。
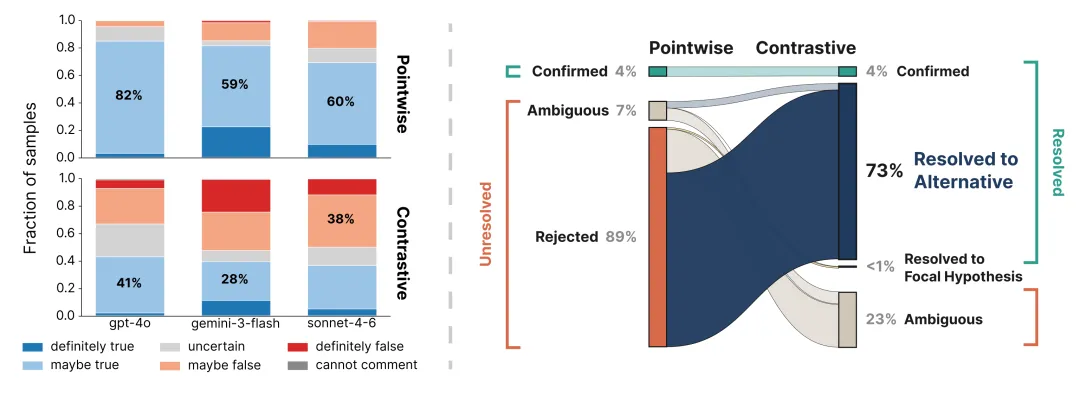
图 5|点式发现把可解的替代解释藏在拒绝背后。图源:原文 Fig. 2
意义与启示: 作者指出,由于改变的只是发现的单位,现有 agent 不必改架构就能用 contrast set 重评已收集的证据,或指导搜索。
arXiv: 2611.14514
https://arxiv.org/abs/2611.14514
ARE-bench 考察研究 agent 能否推进进行中的项目
ARE-bench: Benchmarking Agents’ Research Ability in Real-World Researcher Sessions and Workspaces|arXiv|预印本,未经同行评审|2026-11-10|上海人工智能实验室、复旦大学、华东师范大学、上海交通大学、中国人民大学、北京大学等
要点:作者构建 ARE-bench,收集招募研究者自己项目中的 agent 会话与完整工作区,用 75 个任务评估 agent 能否在遵守先前决策和工作区状态的前提下推进进行中的研究项目。
研究动机:研究 agent 在已有基准上的分数越来越高,但这些分数未必能反映它在真实研究项目里能否可靠交付。已有研究 agent 基准多强调独立目标,或在整理干净的起始状态上评估。在持续进行的项目里,研究者只让 agent 处理一个请求,成功既取决于这个请求,也取决于改动必须遵守的先前会话决策和仍适用的工作区材料。这些设定使推进一个已在进行的项目的能力,此前考察得不够。
实验设计:作者从招募研究者自己的项目收集 agent 会话与完整工作区,把一条真实用户请求选作任务边界,用背景段汇总仍生效的早先请求,并把完整工作区重放到该边界,不做清理(图 6)。意图对齐的评分表编译成二值清单。七个前沿模型每任务跑三次,按 ISR 计分,即全部清单项通过的任务占比。
结果:最强模型 GPT-6.1-Sol 只在 66.2% 的任务上通过全部清单项,Claude Opus 5.5 为 56.9%,其余五个模型都低于 40%。CSR 给出部分分数,各模型都满足多数清单项,差别在能否全部满足。Design 与 Execution 是每个模型最难的三阶段之一,最好与最差模型在这两个阶段分别相差 35.8 和 37.4 个百分点。
结论:作者认为,ISR 与 CSR 两项清单指标分别反映严格完成与部分符合,单独报告的成本指标反映效率取舍。
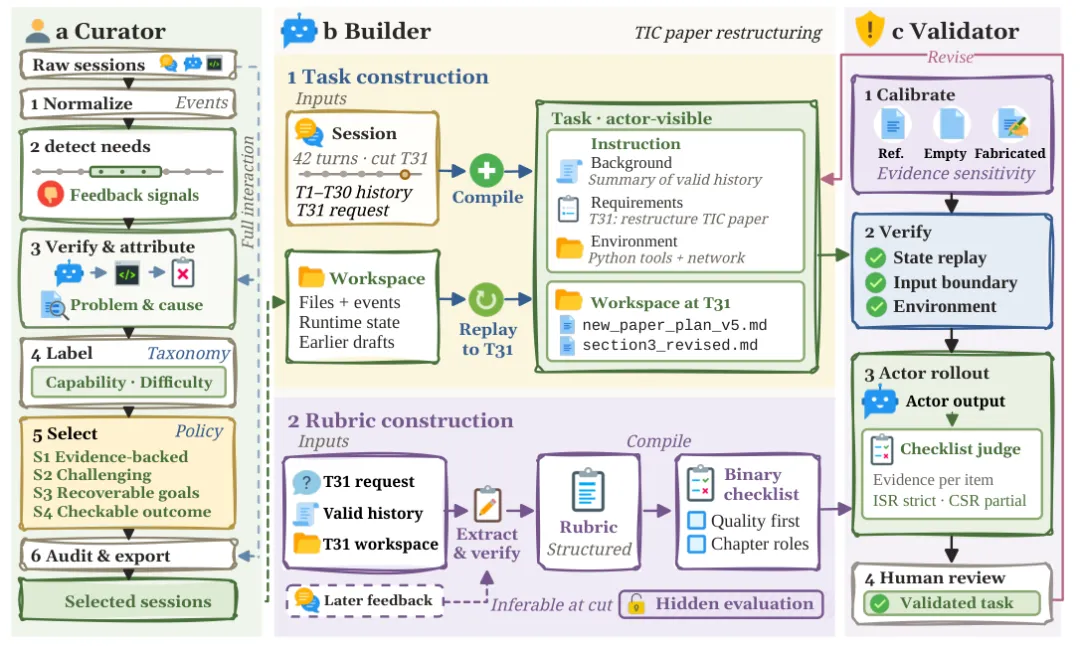
图 6|ARE-bench 的构建流程总览,示例是一次 42 轮会话里在第 31 条请求处截断的论文重构任务。图源:原文 Fig. 3
意义与启示:作者指出,只检查交付契约与通用规范,难以观察到加入历史和材料或工作区要求后暴露的模型差异。
arXiv: 2611.14364
https://arxiv.org/abs/2611.14364
BioXArena-Pro:面向自主生物医学机器学习 agent 的研究级基准
BioXArena-Pro: a research-grade benchmark for autonomous biomedical machine learning agents|arXiv|预印本,未经同行评审|2026-11-10|Mohamed bin Zayed University of Artificial Intelligence
要点: BioXArena-Pro 是 64 个研究级建模任务构成的基准,覆盖八个生物医学领域,最佳配置在百分制下得 55.1 分。
研究动机: LLM agent 已能在很少人工输入下查看数据、写代码、训练模型并迭代,生物医学界提议把它们用作研究助手乃至自主科学家。测量要看的是:agent 在留出集上的表现是否反映真实建模能力,即对生物医学研究者真实面对的数据有效。现有评测大多考知识、工具使用或分析轨迹,而非端到端建模;已有的建模基准规模小、取自竞赛,或只用干净表格输入与随机划分,BioXArena 也接近饱和。编码 agent 还会读任务文件、找数据规律并试探评分器,用上任何泄漏的标签或评分漏洞;生物数据尤其容易泄漏。
实验设计: 作者把 64 个任务做成自包含胶囊:公开训练数据与未标注测试输入,标签在私有目录;agent 拿一块 GPU、两小时,交预测。评测 22 个配置(图 7):三个厂商编码 CLI 各配两个自家骨干,四个与模型无关的脚手架交叉四个骨干。每个任务复现一个已发表方法:33 个用该数据集的方法,31 个用同类问题最强方法。
结果: 复现的已发表方法平均得 48.6 分,低于 Codex CLI 配 GPT-6 Astra,agent 在 64 个任务中的 53 个上更高。差距集中在重建过的任务:48 个换了划分、去掉输入或换了指标的任务上,参考方法落后 8.2 分。在默认解已用预训练模型的 14 个任务上,禁止使用预训练权重和嵌入使该配置平均降 9.3 分。配置之间的花费差距远大于分数差距,花费与名次关系不大。
结论: 作者认为,BioXArena-Pro 测的是适配而不是复用:已发表方法在贴近原研究的测试集上不落下风,在换了划分、输入或指标时落后。
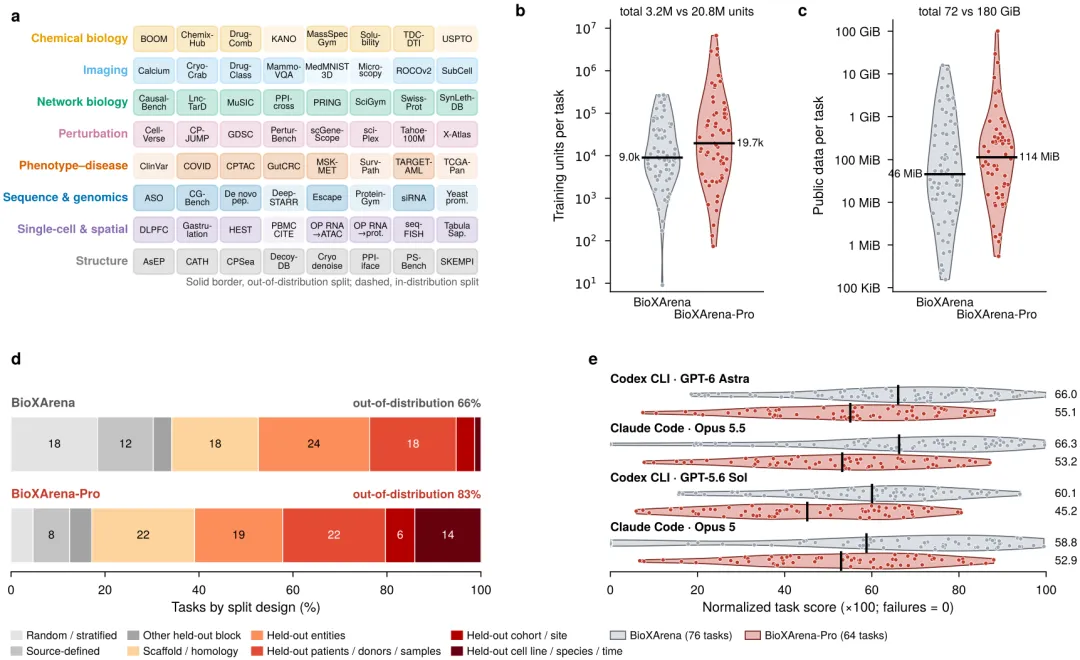
图 7|64 个任务按领域排列,并对比两个基准的训练规模、数据量与划分设计。图源:原文 Fig. 1
意义与启示: 作者还指出,一个分数属于某个脚手架与骨干模型的组合,弱骨干配强脚手架可以与强骨干配弱脚手架相当。
arXiv: 2611.13994
https://arxiv.org/abs/2611.13994
