机器发现 · 日报 2026-11-11
① 生物学与医学
评测 LLM 的 I 期肿瘤试验统计设计推荐
TrialDesignBench: Benchmarking Language Models for Phase-I Trial Design Against Clinical Knowledge|arXiv|研究论文|预印本,已被 NeurIPS 2026 World Models for High-Stakes Health(WMHS)研讨会接收(非存档,未经期刊同行评审)|2026-11-09|宾夕法尼亚大学、德克萨斯大学 MD Anderson 癌症中心
要点: 作者构建 TrialDesignBench,收录 617 项 I 期及 I 期/II 期肿瘤剂量探索试验,每项配一份经专家验证、对齐 FDA 最新监管倡议的参考设计,并评测前沿 LLM 的统计设计推荐。
研究动机: AI 已进入临床试验流程的多个环节,但统计设计,尤其是统计方法的选择,几乎没有进展。已有的患者与试验匹配、试验结果预测工具能拿历史试验的记录和标注当监督信号,这类信号基本不随监管指南改变。统计设计不能照搬历史试验:历史研究采用的设计不一定是今天会推荐的,FDA 的 Project Optimus 又把早期试验的目标从最大耐受剂量转为最优生物剂量,同时兼顾安全性与疗效,合适的统计方法随之改变。因此,绝大多数已记录的试验已不能充当符合最新指南的真值或训练数据。
实验设计: 作者从 AACT 数据库筛出 I 期与 I 期/II 期肿瘤剂量探索试验(图 1),输入分基本信息、试验属性、需推断的设计因素三层,再与专家决策树交叉成五种配置。该决策树给出参考设计,再由有经验的试验方法学家和生物统计学家复核。给决策树的配置里,模型逐节点作答,由代码走到叶节点类别。
结果: 补上设计因素后,模型平均类别准确率从 0.614 升到 0.806,这一提升在五个模型上都成立。逐节点查看时,迟发毒性(入组速度与观察窗之比)节点上的偏差比其他所有节点加起来还多。改用决策树作答、输入仍是基本信息加试验属性时,模型平均平衡准确率提高 0.240,收益集中在对类别不平衡敏感的指标上。设计因素和决策树都给时,平均平衡准确率 0.728。
结论: 作者认为,TrialDesignBench 把试验设计推荐变成可评测的任务,没有模型达到规则推导的参考标准,尚留有明显空间;缺少需推断的字段时,各项指标都下降。
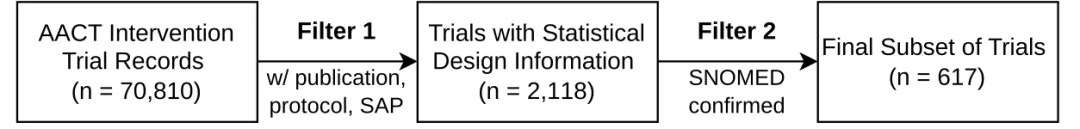
图 1|从 AACT 数据库筛选 I 期与 I 期/II 期肿瘤剂量探索试验语料的过程。图源:原文 Fig. 1
意义与启示: 作者提出,该基准可作为与 Project Optimus 对齐的可复用评测目标,并把信息提取与更高层推断的诊断分开。
arXiv: 2611.12640 https://arxiv.org/abs/2611.12640
用已发表论文搭基准,审计 AI agent 的空间转录组对齐
Publications as benchmarks: auditing AI agents on spatial transcriptomics alignment|arXiv|研究论文|预印本,未经同行评审|2026-11-09|约翰斯·霍普金斯大学
要点: 作者把两篇空间转录组对齐研究转成 121 个可审计任务,在统一评分器下重跑 13 个已发表对齐软件包和 3 个几何基线(共 16 个参考基线),并让六个 AI agent 各自完成这些任务。
研究动机: LLM 驱动的 agent 能读写代码库、装包、跑实验,但要负责任地采用,必须先可靠地评估它们。在科学任务上评估 agent 很难:agent 与工具、本地环境和互联网交互,答案或评分器可达时可能被它找到并取用。已有基准多面向代码生成与修错,用自动测试判分;科学任务定义不精确、成功维度多,真值往往含糊且获取代价高,人工造题还要为每题花专家时间。这些基准多以论文报告的静态参考值判分,不在统一评分器下重跑已发表基线与 agent,也不核查常用指标是否忠实反映真值、agent 如何得到解。
实验设计: 作者把 SABench 与 GEASO 两项对齐研究转成可审计任务。每次运行装在只读挂载的 Singularity 容器里,评分在容器外执行,事后审计轨迹查泄漏。六个前沿 LLM 经各自命令行界面以 coding agent 方式运行,另做五折交叉验证,把 agent 脚本蒸馏成不调 LLM 的 Python 程序。
结果: 在有真值坐标的 28 个任务中,最好的 agent 运行在 22 个(79%)上追平或超过所有已发表基线(图 2);按表达一致性看,跨平台配对 45 个中有 41 个追平或超过。给 agent 预装对齐包并附文献推荐后,成本平均升到 1.5 倍,准确率没有随之稳定提高。没有真值可评时,基于标签的指标比只看基因表达相似度更贴合真实坐标误差。把 agent 运行蒸馏成独立程序,该程序在随机划分下的留出任务上平均超过参考基线的 87%。
结论: 作者指出,严格环境隔离必不可少,表现最好的 agent 多靠自写紧凑的数值优化代码追平或超过专用对齐包。
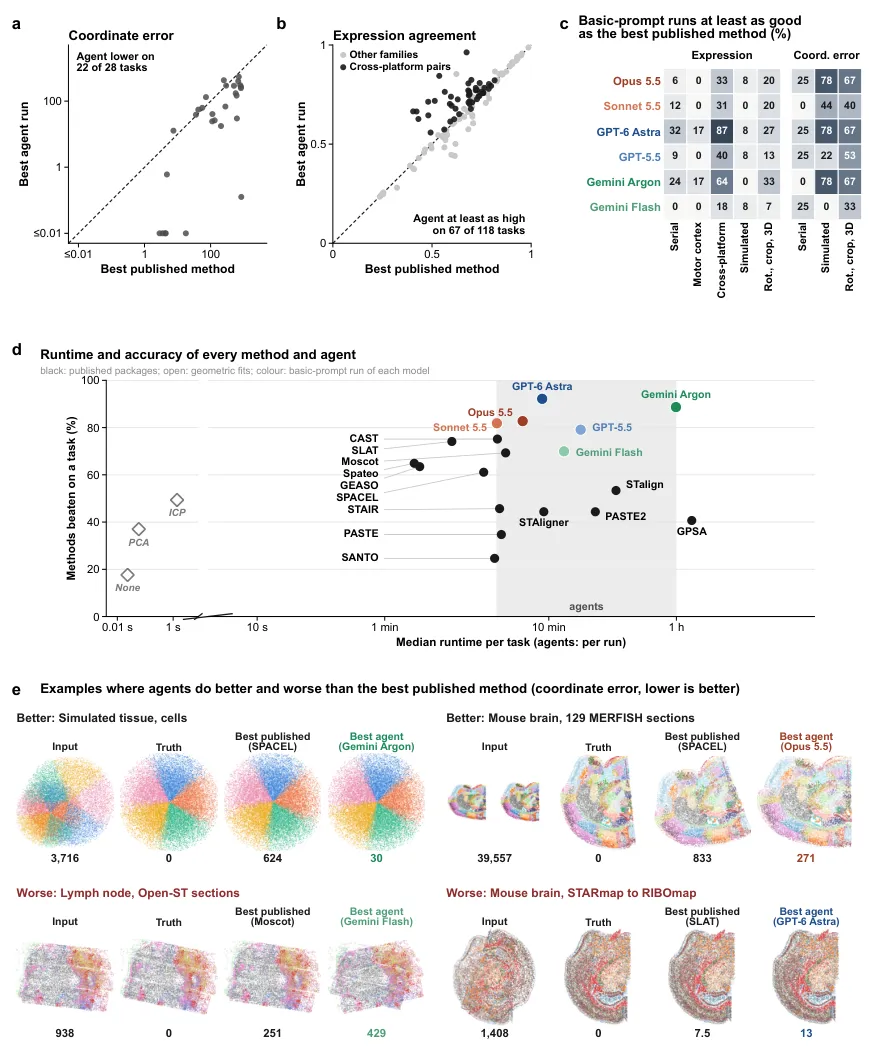
图 2|统一评分器下 AI agent 与已发表空间对齐方法的比较。图源:原文 Fig. 2
意义与启示: 作者提出,与其把 AI agent 当作人类分析师的替代,可审计基准与轨迹蒸馏可以把 agent 的探索转成更严谨、可解释、可复用的工具。
arXiv: 2611.11796 https://arxiv.org/abs/2611.11796
LLM 提出证明树,定理证明器逐条验证,弃权时才修复
Prove What You Can: Hybrid Neurosymbolic Reasoning for Logical Natural Language Inference|arXiv|研究论文|预印本,未经同行评审|2026-11-06|萨班哲大学、独立研究者
要点: Hybrid Reasoning 分三阶段:LLM 提出带原始结论的结构化证明树,定理证明器把每条推导连同其支撑前提单独验证,只在原始结论为 UNCERTAIN 时做修复;在 FOLIO 上比最强基线高 5.3 分。
研究动机: 自然语言的逻辑推理既要解释语义,也要做演绎搜索:系统要把措辞各异的前提对应到正确的语义关系,并判断假设是否由前提推出、其否定是否推出,或证据不足。LLM 是灵活的语义解释器,但多步推理常常不忠实,中间步骤可能不蕴含结论,最终答案也可能理由错误。整题形式化的方法只要一句译错,整个程序就无法执行;过程级方法给单步打分或搜索,但依赖的学习型验证器本身只是近似。
实验设计: 评测覆盖 FOLIO(182 例)、ProofWriter(225 例)、ProverQA(210 例)、PrOntoQA(200 例),共五个 LLM。LLM 先输出结构化证明树和原始结论;每条推导连同其支撑前提单独译成一阶逻辑,交 Prover9 判定,只留证明器接受的推导;原始结论为 UNCERTAIN 时,才用前提加已验证推导重证假设或其否定。与 Standard、CoT、单体 Autoformalization、Logic-LM、LINC、CLOVER 同模型同划分比较,用配对样本检验差距。
结果: 五个模型平均后,Hybrid Reasoning 在 FOLIO 和 ProverQA 这两个最难的基准上准确率都是最高,分别为 88.4 和 78.8;PrOntoQA 上五个模型全部满分。修复阶段只在原始结论为 UNCERTAIN 时触发,在全部数据集上共做出 326 次有帮助的重标、19 次有害,每个数据集的净收益都为正。修复最常在 ProverQA 触发,那里的弃权比例也最高。五个模型平均后,Hybrid 在 FOLIO 和 ProverQA 上领先每个基线的差距显著;在 ProofWriter 上,单体 Autoformalization 的平均准确率略高。
结论: 作者总结,五个 LLM 平均后,Hybrid Reasoning 在 FOLIO 和 ProverQA 上显著优于所有基线,在 ProofWriter 和 PrOntoQA 上与最好的 neurosymbolic 基线相当,修复改正的错误远多于引入的错误。
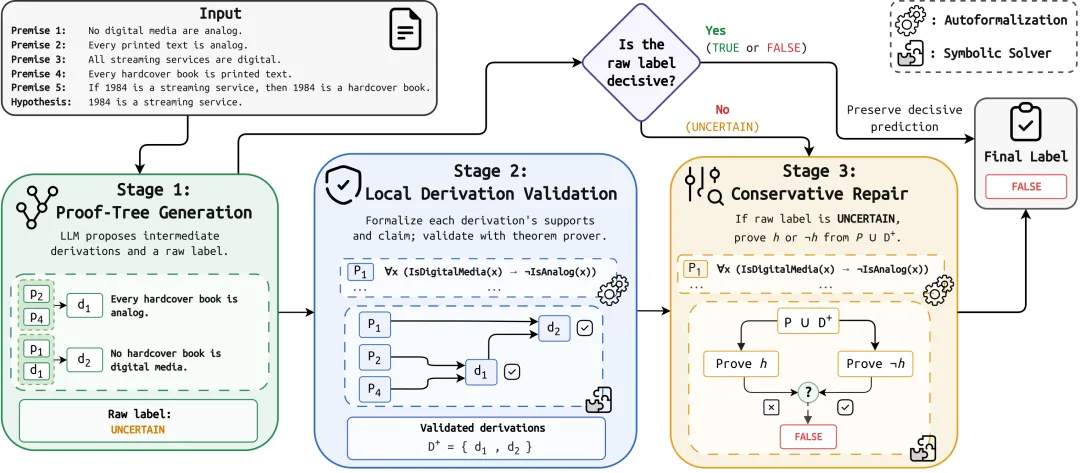
图 3|Hybrid Reasoning 三阶段流程:LLM 提出推导、证明器逐条验证、仅在 UNCERTAIN 时修复。图源:原文 Fig. 1
意义与启示: 作者认为,逐步检查模型的推理、并在模型给出确定标签时让位,证明器能增加 LLM 答对的部分,在无法整体正确形式化的问题上仍然有用。
arXiv: 2611.10319 https://arxiv.org/abs/2611.10319
为 LLM 生成的本体定义做知识系统级质检
From Fluent Text to Ontology-Compatible Definitions: A Quality-Control Agentic Workflow|arXiv|研究论文|预印本,未经同行评审|2026-11-09|南京大学等
要点: 作者把生物医学本体定义生成放进 agentic 质控流程,提出实体错误率(EER)和逻辑不一致率(LIR)两个指标,在 DO 与 Uberon 上检验。Qwen2.5-14B base 在 DO 2024 的 EER 由 67.0% 降至 37.8%。
研究动机: 生物医学本体是结构化的知识系统,类定义要支持检索、注释、策展和推理。在 DO 和 Uberon 这类大型 OBO 资源里,策展人得让文本定义与类层级、跨本体关系和逻辑约束保持一致,而每一版都会新增类,许多已有类仍缺定义。LLM 能把类名和父类上下文变成流畅的草稿定义;但 ROUGE、BLEU、BERTScore 等常规生成指标衡量的是与参考定义的文本接近程度,不是与目标知识系统的兼容性。一个定义可以流畅、接近参考,却仍提到不存在的实体、用无法解析的关系,或加入合并后使类不可满足的关系。
实验设计: 作者把定义生成放进 agentic 质控流程:抽出谓词-宾语公理并解析到目标本体实体,能落地的候选转成 ROBOT 模板交 ELK 推理。解析失败的进存在循环,重生成定义并重抽公理;能落地但使本体不可满足的进逻辑循环,固定定义只改公理,每个循环至多 5 次重试。评测用 DO、Uberon 的 2024 与 2025 增量发布及含 973 个强约束类的 Uberon-Constraint-Stress(图 4)。
结果: 实体存在循环把 base 模型的 EER 大幅拉低:Qwen2.5-14B 在 Uberon-Constraint-Stress 上由 52.3% 降到 2.5%,Llama-3.1-8B 在 DO 2024 上由 69.7% 降到 45.7%。这些同组对比中的常规文本指标通常维持原有水平。LoRA 微调提高文本指标,却不能总是消除实体错误,Uberon 上修复后仍有非零 EER。加上逻辑循环后,LIR 只在部分 Uberon 设定上下降,降幅小于 EER,也不如 EER 稳定。
结论: 作者认为,LLM 能产出有用的本体定义候选,但流畅、接近参考的定义不一定与目标知识系统兼容。
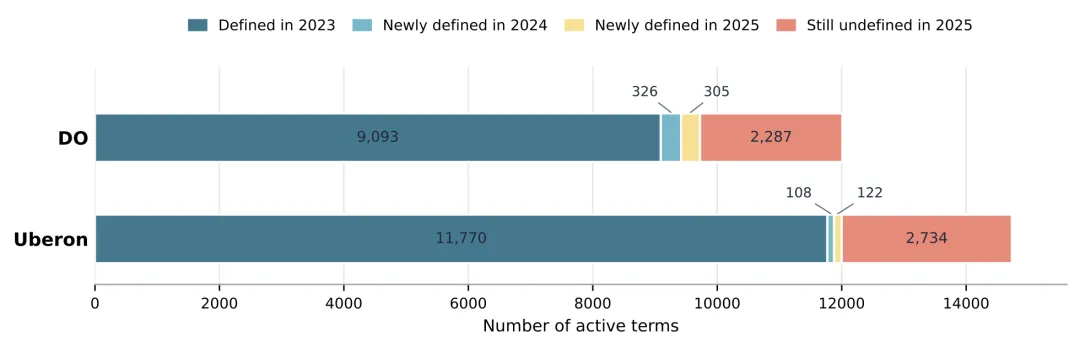
图 4|DO 与 Uberon 的定义覆盖与剩余定义缺口。图源:原文 Fig. 3
意义与启示: 作者指出,这套流程中 LLM 提出内容,外部知识系统检查决定内容可被接受、修复还是标记。
arXiv: 2611.12095 https://arxiv.org/abs/2611.12095
