上期 33,134 条 Trace 全是空壳,那种窒息感我记到现在。这一周,我照着自己开出的《Trace 有效性体检清单》动了真格:无效源停采,16,397 条服务遥测封存隔离,埋点重接,生产实验清零重置。清洗之后,第一批真 Trace 回来了——而且就在回来的当天,它把一个真问题拍在了我桌上。
先把观点放在最前面:清洗数据不是丢掉数字,是把信噪比还给自己。2 条真 Trace 的信息量,大于 3.3 万条空壳;而第一条真数据最大的价值,是让问题自己浮出来,不再靠猜。
一、照着清单走了一遍:停、隔、接、清
上期清单一共 5 条,这周真正执行的是第 4、5 两条:先隔离无效数据,再按顺序修复采集。整个过程分四步,顺序是刻意的。
第一步,停。确认无效的采集源直接停掉,先不让新的空壳继续进库。
第二步,隔。已经进库的 16,397 条服务遥测,一条没删,整体挪进一个独立的隔离实验里封存留证。为什么不顺手删了?我认真考虑过:这批空壳本身就是"事故现场"——将来要回溯空壳是怎么产生的、无效采集占了多大比例,证据全在这里;删掉是干净了,复盘的线索也一起没了。隔离不是否认这些数据,是请它们离开主战场。
第三步,接。埋点重接,但这次只接一个点:被测智能体真正发起 LLM 调用的位置。上期的病根就在这——之前接的是服务遥测,进程起了、服务跑了都有记录,唯独没有模型调用本身,所以才有了一堆只有耗时、没有输入输出的空壳。
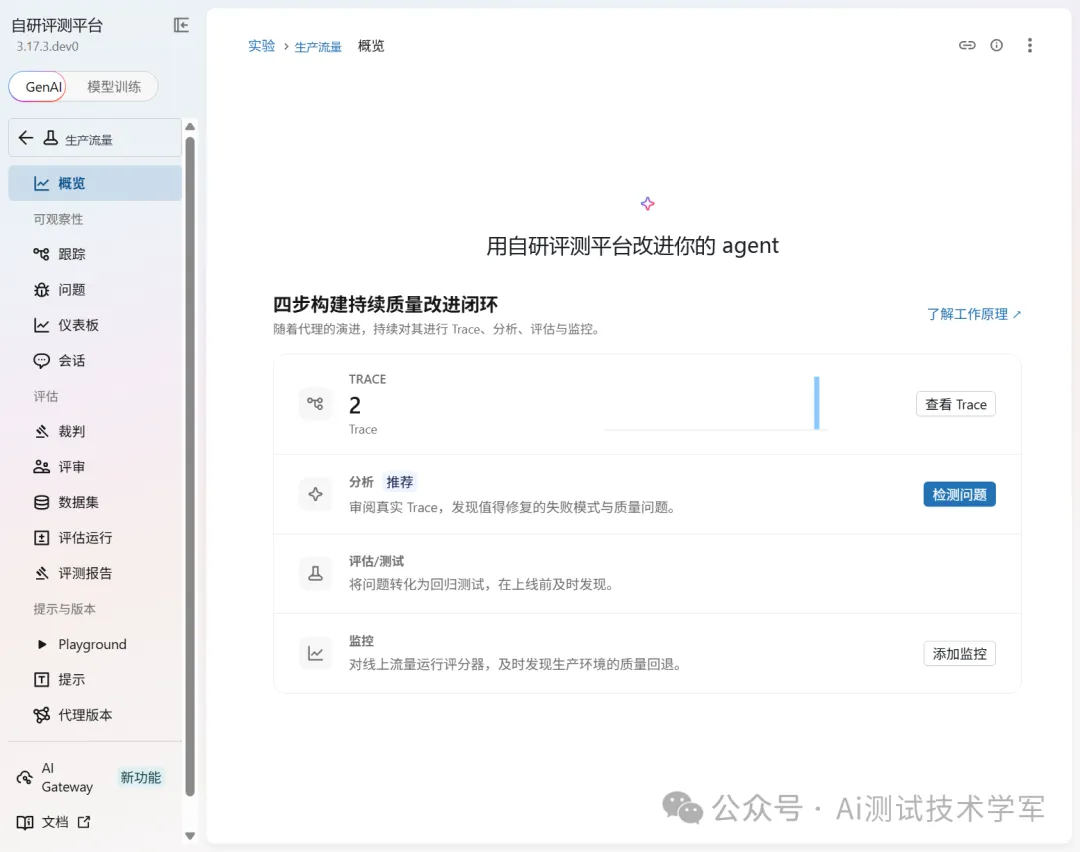
第四步,清。生产实验清零重置,旧的脏数据不再参与新统计。打开概览页,TRACE 一栏显示了一个我从来没见过的数字:
▲ 清零重置后的生产实验概览:TRACE 从 33,134 到 2
盯着这个"2",我看了好几秒。33,134 条的时候心里发堵,只剩 2 条反而踏实了——这个对比本身就说明,之前那 3.3 万条从来没有为任何判断提供过依据。
二、只放 2 条验证流量,是这周最正确的决定
埋点重接完,我面前有个诱人的选项:立刻放开全量生产流量,让数字好看起来。
没这么做。按上期清单定的顺序,放量之前必须先做小流量验证——确认埋点位置接得对、内容记得全,才有资格谈放量。所以我手动触发验证管道,先放 2 条请求进去。这里必须诚实说明:这 2 条是验证性小流量,不是全量生产回流,日均流量恢复这种话,本期不敢讲。
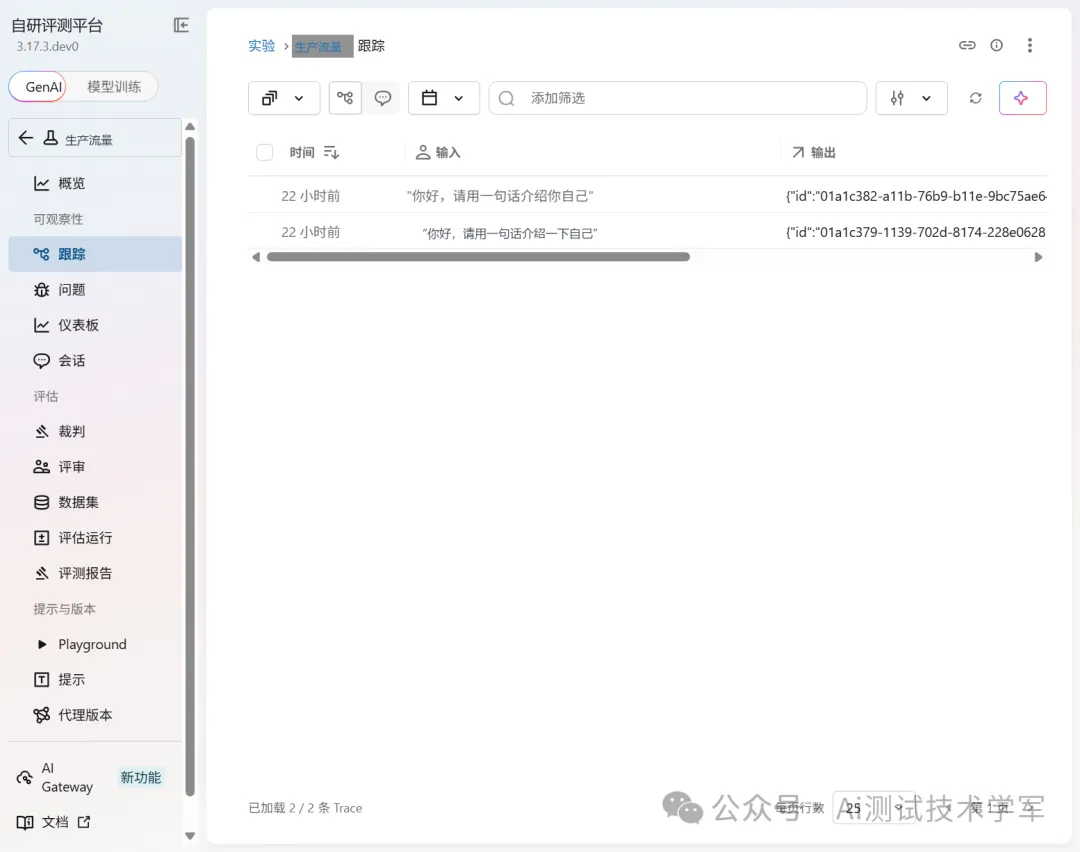
刷新 Trace 列表,页脚一行字:"已加载 2 / 2 条 Trace"。
▲ 第一批真 Trace:5.2 秒与 7.7 秒各一条,页脚显示"已加载 2 / 2 条 Trace"
两条 Trace,一条 5.2 秒,一条 7.7 秒,各含一个 LLM 调用 span。点开前我没抱太高期望,直到看见输入输出两栏——终于不是"-"了。有输入、有输出、有 token 统计、有真实耗时,这才叫能拿来做分析的 Trace。
复盘这周,清单本身没让我踩坑,最大的坑藏在清单外面:重接之后急着想看全量。如果我直接放量,新流量立刻把 33,134 的窟窿填满,埋点对不对、内容全不全,全都混在生产数据里,再也没法干净地验证。
教训一句话:修复埋点后,先用最少的验证流量证明数据是干净的,再谈放量。
而正是这"少得可怜"的 2 条,当天就抓到了一个新问题。
三、第一条真数据,当天就抓到一个真问题
我打开了 7.7 秒那条。
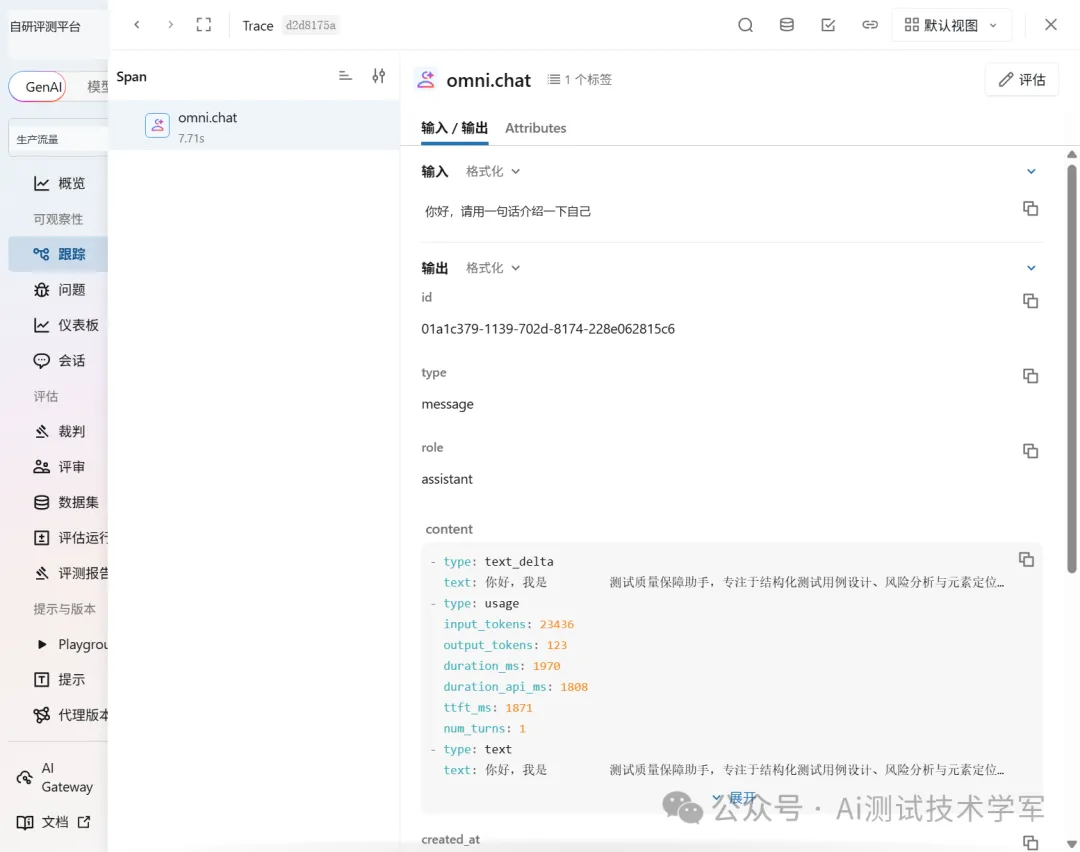
输入栏只有一句:"你好,请用一句话介绍一下自己"。输出也只是一句自我介绍:"你好,我是测试质量保障助手,专注于结构化测试用例设计、风险分析与元素定位问题排查。"满打满算,123 个 token。
按直觉,这种闲聊级的输入输出,usage 栏应该很轻。结果它躺着一行大数字:
首字等待(ttft_ms)1871ms,对照 1970ms 的调用总耗时——这次调用九成以上的时间花在"读题",真正"答题"的时间少得可怜。可输入栏里明明只有一句话,它在读什么?
这就是本期的真问题:上下文膨胀。一句问候送进模型时,背后拖着约 190 倍于输出的输入行李。初步判断,系统提示词、工具说明、历史会话,疑似都被全量打进了每次请求。丑话说在前面:23,436 是单次抽样的数字,不是均值更不是常态;提示词、工具、会话各占多少,我还没拆完。所以这一节只写现象和初步判断,结论留给数据。
但有一件事现在就能确定:33,134 条空壳的时代,这个问题连被看见的机会都没有——没有 token 记录,输入输出全是"-",上下文胀到天上去,页面上也只是安静的一个"-"。第一条真数据的价值,就是让问题自己浮出来,不再靠猜。
▲ 7.7 秒那条 Trace 的详情:一句问候的输入,usage 栏 input_tokens 23,436、output_tokens 123、首字等待 1871ms——输入约为输出的 190 倍
顺手再记一个待拆的信号:整条 Trace 7.7 秒,LLM 调用 span 只占约 2 秒,剩下 5 秒多花在调用之外。是什么?先不猜,等上下文拆完一起看。
四、怎么拆这 2.3 万 token:一张可直接抄走的排查表
下一步,我会把 23,436 拆开,看行李里到底装了什么。排查路径整理成一张表,遇到自家智能体"输入 token 异常大",可以直接照着查:
| | |
|---|
| 单轮请求(num_turns=1)输入就到数万 token | | 单独发一次只带系统提示词的请求,量出它的 token 份额 |
| | |
| | |
| | |
说明:这是排查路径表,不是结论表。每一行的数字证据,要等拆完才会拿到——下期见分晓。
五、写在最后
这周的账:16,397 条空壳封存进隔离实验,无效源停采,埋点重接到真正的 LLM 调用点;2 条验证流量回来,当天抓到一个 2.3 万 token 的上下文行李。数字从 33,134 缩到 2,缩了一万六千倍,信息量反而变大了。衡量数据价值的从来不是条数,是信噪比。
概览页上"检测问题""添加监控"两个按钮,到今天还没按下去——下期的活,就是它们。下期预告:我会把这个"2.3 万 token 的行李",变成自研平台上第一条真正的问题检测规则;问题检测首跑和监控评分器也会一起上。还是那句话——真实做完再写。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。