只看最终答案,测不出过程里的错
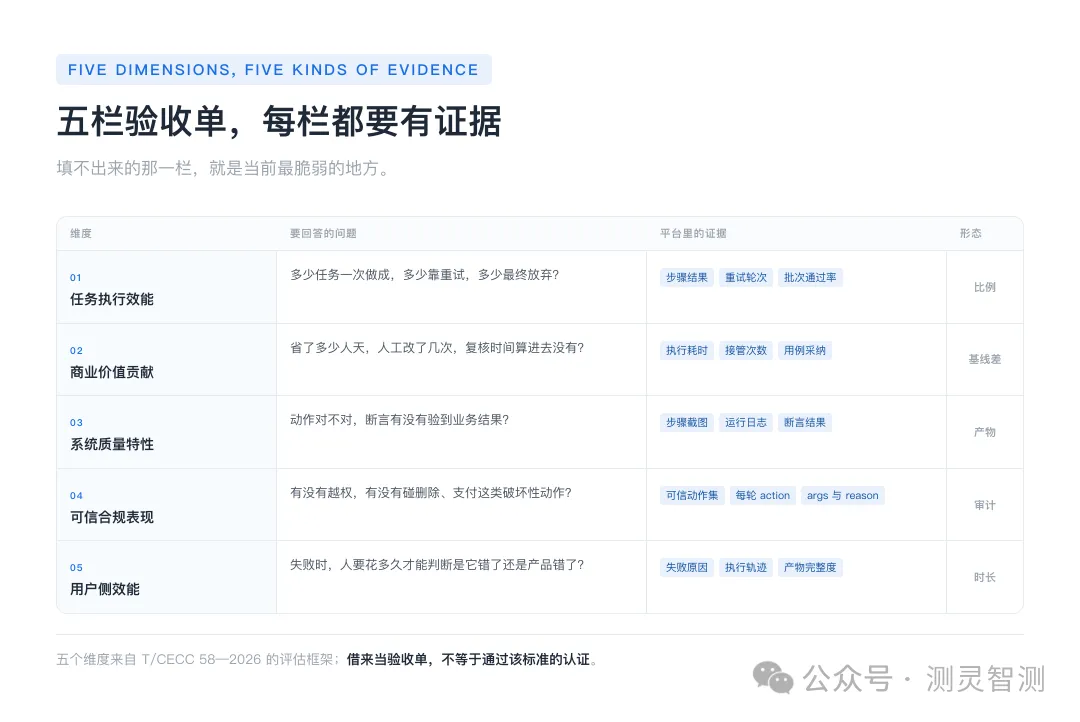
2026 年 8 月发布的 T/CECC 58—2026《企业级 AI 智能体应用效能评估规范》,把智能体的评估拆成五个维度:任务执行效能、商业价值贡献、系统质量特性、可信合规表现、用户侧效能;8 月 31 日起实施。
它不是专门给测试 Agent 写的。但这五栏,正好补上大多数团队验收测试 Agent 时缺的东西。
现在常见的验收方式是:给它十个任务,看它成功几个。成功率 80%,通过;成功率 50%,再调调提示词。
问题是,成功的那 8 个里,可能有 3 个是“点错了但碰巧页面变了”,有 2 个是“动作对了但没验证业务结果”。只看最终答案,这些都在成功率里,看不见。
一、标准看的是“怎么做到的”,不只是“做到了没有”
智能体评测和普通功能测试最大的差别,是它每一步都在做选择:先点哪里、填什么、失败了重试还是换一条路。
同一个任务,两条轨迹:
- • 轨迹 A:找到输入框 → 填入手机号 → 点击查询 → 断言列表出现订单;
- • 轨迹 B:误点搜索按钮 → 页面刷新 → 再点一次 → 碰巧出现订单 → 结束。
最终都“成功”了。但 A 可以复用,B 不能;A 明天还能跑,B 明天可能就失败。
所以验收单不能只有“结果”一栏,至少要有:任务、轨迹、判定、成本、边界。
二、五栏验收单,每栏对应什么证据
这五栏不需要都做成百分比。有些栏是“有/没有”,有些是“几次”,硬凑成一个总分,反而会掩盖问题。
三、第一栏:任务执行效能,别只报成功率
成功率要拆成三个数:
- • 重试后成功率:靠确定性重试或自适应补回来的比例;
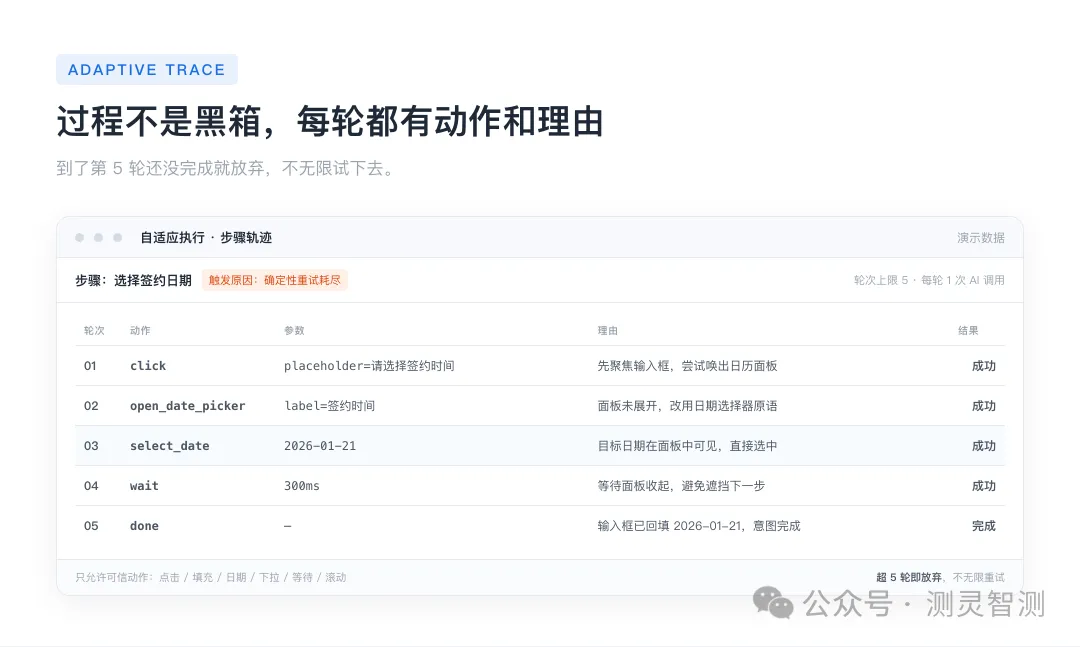
平台的自适应执行有一个硬上限:最多 5 轮,每轮 1 次 AI 调用,超限就放弃。这个上限本身就是效能证据:如果一个任务经常跑到第 4、5 轮才成功,它的“成功”成本远高于一次成功。
验收:任取一批执行,能说出一次成功、重试成功、放弃各多少,而不是只有一个总通过率。
四、第二栏:商业价值,要有人工基线
“省了 30 人天”这种话,没有基线就是空话。至少要记三个数:
- • Agent 执行一次要多久,加上人工复核要多久;
第三个最容易被忽略。一个 Agent 成功率很高,但每条结果都要人重新看一遍,它省下的只是点击时间,不是判断时间。
验收:能算出“每个任务节省的分钟数”,并且把人工复核时间算进去。
五、第三栏:系统质量,看动作,也看断言
这一栏要回答两个问题:
动作对不对。 自适应执行只允许在可信动作集里选:点击、填充、打开日期选择器、选择日期、选择下拉项、等待、滚动。它不执行任意 JS。这不是限制能力,是缩小出错半径。
断言有没有验到业务。 动作成功不等于业务成功。点击“提交”后页面没报错,不代表订单真的生成了。执行记录里要有断言结果和截图,不能只有一句“步骤通过”。
验收:抽 20 条成功用例,至少能指出每条最后验证了哪个业务结果;指不出的,算“动作成功、业务未验”。
图 1:五个维度,落到平台上就是五类能拿出来的证据
六、第四栏:可信合规,看它“没做什么”
这一栏最容易被跳过,因为它考的是“没发生的事”:
平台的做法是把动作收进可信动作集,AI 只能在里面选;每轮决策都要给出 action、参数和理由,理由会进执行记录。这样“它为什么点这里”是可回溯的,不是黑箱。
验收:随机抽 10 轮自适应决策,每轮都能看到动作、参数、理由;出现可信动作集之外的动作,算不合格。
七、第五栏:用户侧效能,看人能不能看懂
Agent 失败时,最贵的不是失败本身,是人要花多久才能判断“是它错了,还是产品错了”。
一屏合格的失败记录,至少要有:失败发生在第几步、当时页面是什么样、它尝试了什么、下一步准备做什么、为什么放弃。
平台的执行产物里有步骤截图、运行日志、录屏;自适应轨迹里有每轮的 action、args、reason。把这些摆在一起,人才能在几分钟内归因,而不是重新跑一遍。
验收:让一个没参与调试的同事看失败记录,10 分钟内说出失败原因;说不出来,说明记录不合格。
图 2:自适应执行的每轮动作、参数与理由(演示数据)
八、怎么开始用这五栏
第一步,选 20 条已经跑过的任务。 不要新造场景,用现有执行记录。验收:20 条都有完整的步骤和产物。
第二步,按五栏填一遍。 填不出来的栏,就是当前缺的证据。验收:五栏里至少三栏有数,另外两栏写清“为什么没有”。
第三步,只改一个变量。 比如只补断言,或者只收紧可信动作集,再跑同一批任务。验收:能看出哪一栏变了,其他栏没被带偏。
第四步,把验收单固化成模板。 下一批 Agent 上线,直接用同一张表,不重新发明口径。验收:两批任务的五栏能横向对比。
九、丑话说在前面
T/CECC 58—2026 是企业级智能体应用效能的评估规范,不是测试 Agent 的专用 benchmark。本文是借它的五个维度来搭验收单,不代表平台或你的团队通过了该标准的评估。
公开榜单上的成功率,也不能直接当你的验收线。榜单的任务分布、页面结构、判定标准都和生产不一样;同一个 Agent,换个系统,数字可能完全不同。
五栏验收单也不能替代人工判断。它做的是把“感觉它还行”变成“哪一栏有证据、哪一栏还空着”。空着的那一栏,才是下一步要补的。
一页纸清单
- 4. 可信合规看“没做什么”,每轮 action 和理由要能回溯;
- 6. 选 20 条现有任务先填一遍,空着的栏就是缺口。
如果你也在验收一个测试 Agent,别急着问“成功率多少”。先让它跑 20 条现有任务,把五栏填一遍。填不出来的那一栏,通常就是它最脆弱的地方。
关于怎么把 AI 用进测试流程,我们一直在做这件事。这篇如果对你有用,转给正在做 Agent 验收的同事;想看某个模块的完整操作路径,发邮件到 clzc_ai2026@qq.com。