【最强评测】30个模型在鼻咽癌「临床学徒」考核里单项能拿90分,整条诊疗路径严格通过最高只有23%
- 更新时间 2026-11-11 12:47:10
【最强评测】30个模型在鼻咽癌「临床学徒」考核里单项能拿90分,整条诊疗路径严格通过最高只有23%
会背指南、会看片子、会写方案,加起来是不是就等于会看病?香港理工大学与中山大学团队造的 NPCBench 给出的答案是:不。单项分数能到 90 分以上的模型,放到同一个病人的完整诊疗路径上,严格通过率最高只有 23%。
论文:NPCBench: A Clinical Apprenticeship Benchmark for Multimodal Care-Pathway Reasoning in Nasopharyngeal Carcinoma
机构:香港理工大学、中山大学、中山大学肿瘤防治中心、莫纳什大学
会议:NeurIPS 2026(已录用)
代码:https://github.com/pidneuralode/NPCBench
数据:https://huggingface.co/datasets/pengkaiScience/NPCBench
会背指南不等于会看病
医疗评测这几年有个很稳定的套路:把临床能力切成一块块,做成单选题、单图判读、或者静态病例小故事。这类题好打分、好比较、好排序,所以榜单越做越长。
问题出在切法上。真实的专科诊疗不是把这些小块累加。一个鼻咽癌病人来了,医生要先用指南定位治疗意图,再在病理与多序列 MRI 上确认侵犯范围与 T/N 分期,然后结合年龄、合并症、脏器功能出方案;等放疗做完、复查片子出来,还得按疗效与毒性修正原决定。整条链串起来,前一环判错后面全错。
现有基准只能告诉你「这一环错了」,不能告诉你「同一个病人的整条链有没有走通」。论文把这种落差叫作构成性差距:单项得分高,不保证同一病人的诊断与处置答案同时正确。
选鼻咽癌当切片,理由很实在:这个病种天然把多模态证据与时序决策绑在一起,影像分期直接决定治疗强度,疗效与毒性又直接触发方案修订,华南地区病例资源与 CSCO、NCCN 双指南也都齐备。
把「学徒成长」写成六级阶梯
要测串起来的能力,得先有一个「能力怎么长」的模型。论文借用临床带教的真实顺序,把能力排成 L1 到 L6 六级阶梯,再加跨级开放问诊项 O1。
1. L1 指南记忆(G-Mem):250 道专家复核题,考适应证、分期含义、推荐边界、随访与禁忌。其中 153 题同时有 CSCO 与 NCCN 支持,80 题仅 CSCO 支持,17 题仅 NCCN 支持——这一层刻意保留了指南分歧,考的是模型会不会把两套体系混着背;
2. L2 原子应用(A-App):185 道短情境题,分初次根治、复发、转移与系统治疗、毒性禁忌四组,按组宏平均给分,避免某一组题多就把总分带偏;
3. L3 多模态证据落地(Path./T-Stg./N-Stg./Seq./Struct.):病理标签、MRI 序列与解剖结构识别、侵犯状态、T 与 N 分期,T 与 N 各覆盖 400 例;
4. L4 个案规划(C-Plan):给定病例证据,考方案决策是否在指南与专家共识支持范围内;
5. L5 纵向修订(L-Rev.):305 个决策点、100 位病人,考「每一轮判断对不对」以及「整条复查链是否全对」;
6. L6 全路径(CP-Epi.):217 个处置决策、100 位病人,把病理、T 分期与全部处置答案绑在同一个病人身上判定;
7. O1 开放问诊(C-Rub.):103 份自由文本会诊,按病例专属评分细则给 0 到 100 分。
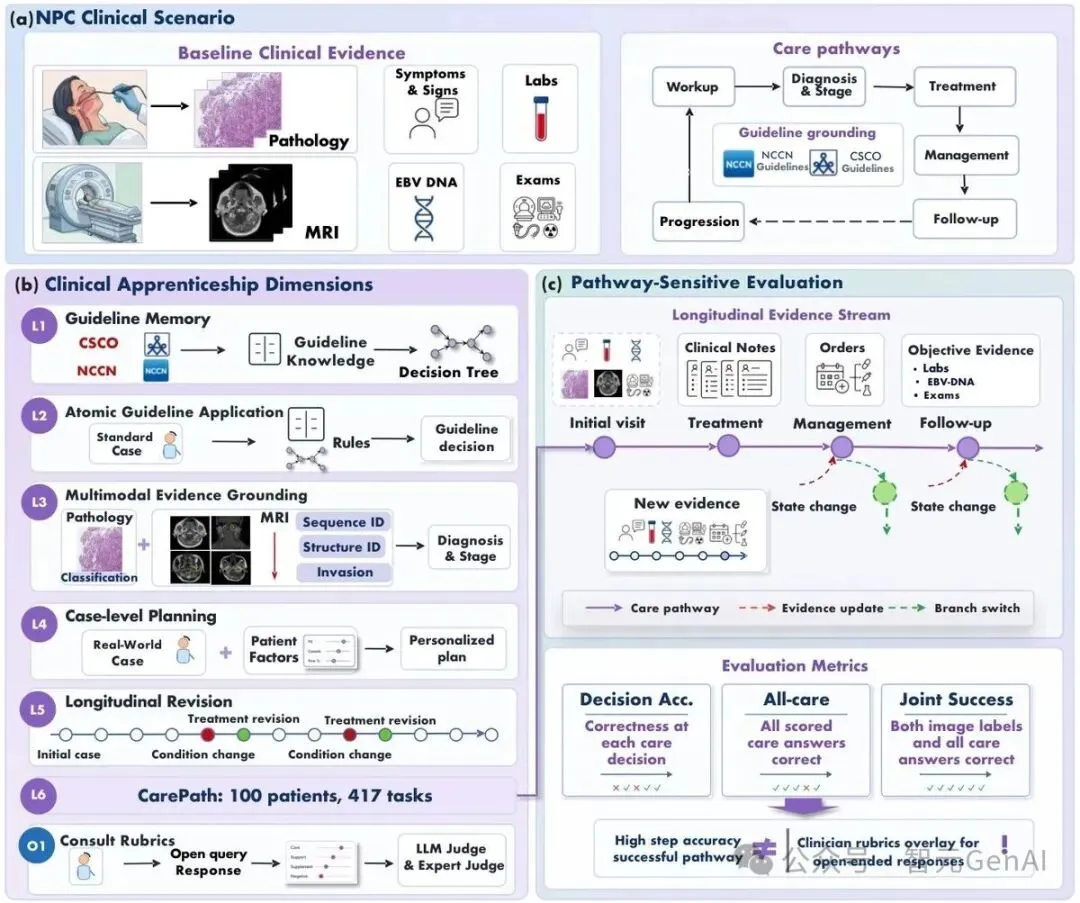
阶梯之外有四条构造原则,其中两条是真正的技术含量。
能力隔离要求每一级只测一个临床上说得清的能力成分。证据边界控制要求把模型可见信息严格截断到该决策点,未来治疗、未来结局、任何能反推答案的线索全部删掉。后者听着像工程细节,实际决定榜单可信度:若 L5 的题混进后续疗效描述,模型顺着文本抄就能答对,纵向能力根本没测到。
另外两条是临床确定性(参考答案必须有指南或专家共识支撑,不能是出题人个人偏好)和可审计评分(开放问诊按病例专属细则,拆成临床理由、证据落地、条件推理、安全性四类判据)。
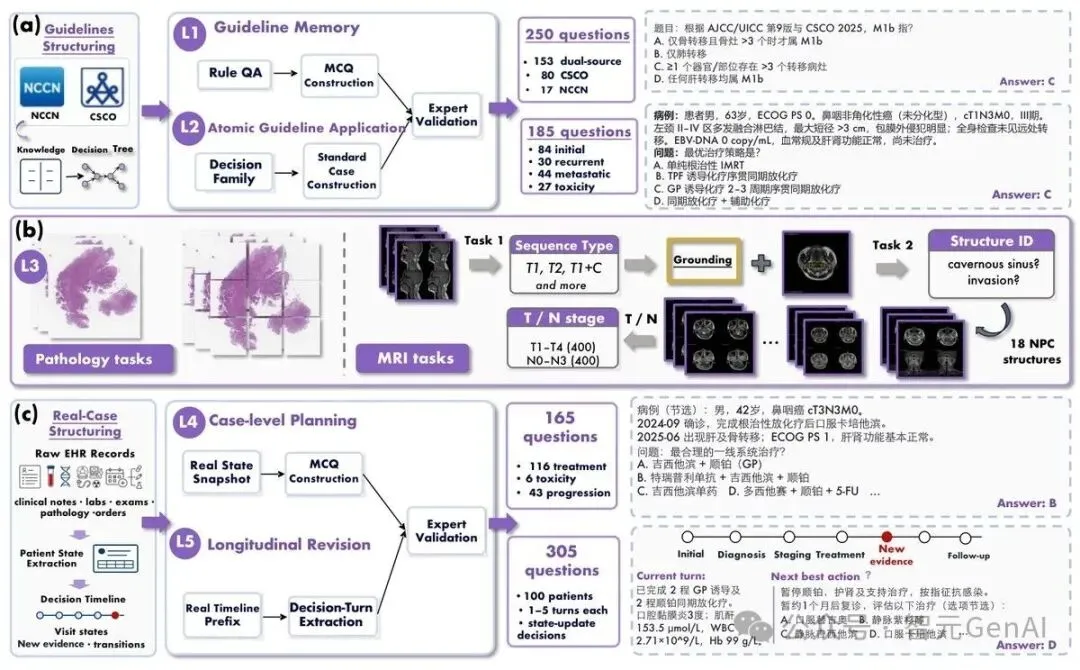
数据规模上,全套共 4,777 个成分题与问诊题,加一个 100 位病人的 CarePath 队列,其中 417 个诊断与处置任务被打分。所有病人材料脱敏,由鼻咽癌专科医生复核成分效度、决策确定性与病人状态转移的真实性。
严格通过率:一个连乘号定生死
这套基准最关键的设计在指标上。论文没有用平均准确率当主指标,而是定义了两种口径。
处置级准确率是
Care = 100/N · Σ_p Σ_{j∈S_p} c_pj
其中 p 遍历 P 位病人,S_p 是病人 p 的非空打分决策集合,n_p = |S_p|,N = Σ_p n_p 为总决策数,c_pj ∈ {0,1} 表示第 j 个处置答案是否正确。这个式子算的是「所有决策里有几成对」,等价于常规准确率。
严格病人级通过率是
Strict = 100/P · Σ_p d_p · t_p · Π_{j∈S_p} c_pj
d_p 是病理标签是否正确,t_p 是 MRI T 分期是否正确,后面的连乘项要求该病人所有处置决策全部正确。
差别就在这个连乘号上。Care 是加法,Strict 是乘法。一位病人有五个决策点、每个点九成把握,Care 口径下贡献 4.5 分,Strict 口径下贡献 0.9 的五次方约 0.59。病人一多,两个数字拉开一个数量级。
论文还定义了一个中间量,即全处置正确率
C_p = Π_{j∈S_p} c_pj
以及病人级平均 AllCorrect = 100/P · Σ_p C_p,把「处置全对」与「诊断也对」两件事分开看。把病理与 T 分期联合正确记为 Path.+T,就能用 2×2 列联表把严格失败拆成四类:诊断对且处置全对(n₁₁)、诊断对但处置有错(n₁₀)、处置全对但诊断错(n₀₁)、两边都错(n₀₀),计数之和恰为 P。这张表是后面归因的全部依据。
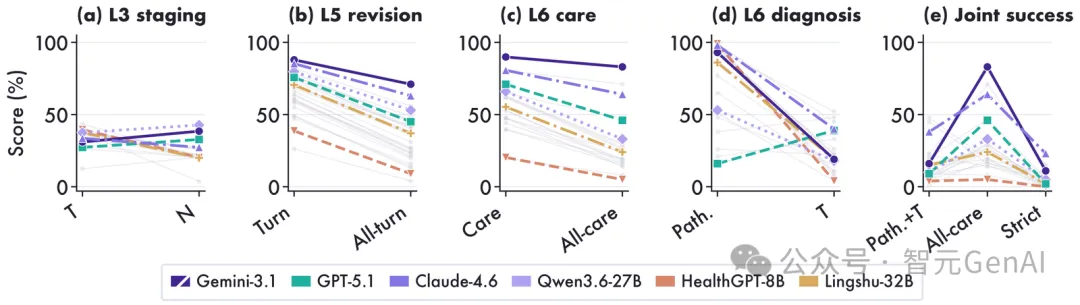
实验:单项九十分,合起来两成
评测覆盖 30 个模型,其中 21 个具备多模态能力,可以跑 L3 与 L6 的图像任务。基线横跨医学专用模型(HuatuoGPT-o1 系列、HealthGPT-Pro、Hulu-Med、Lingshu)、开源通用模型(Qwen3 系列、Qwen3-VL、Qwen3.5/3.6、GPT-OSS、DeepSeek-V3.1、InternVL3.5)与闭源模型(GPT-5.1、GPT-4.1、Gemini-3.1-Pro、Gemini-2.5-Pro/Flash、Claude-Sonnet-4.6)。
第一层结论很反直觉:单项成绩已经很高。L1 指南记忆,Gemini-3.1-Pro 拿 94.0,Claude-Sonnet-4.6 与 Gemini-2.5-Pro 都是 93.2,DeepSeek-V3.1 是 90.0;L2 原子应用,Gemini-3.1-Pro 到 92.5。「背 + 简单用」这一层,前沿模型基本压满了。
到纵向层就掉下来。L5 的 All-turn(整条复查链全对)最高是 Gemini-3.1-Pro 的 71.0,Claude-Sonnet-4.6 是 63.0,GPT-5.1 是 45.0。L6 处置级 Care 最高是 Gemini-3.1-Pro 的 89.9,看着还行。
真正的分水岭在 Strict。21 个多模态模型里,严格通过率最高是 Claude-Sonnet-4.6 的 23.0,其次是 Gemini-2.5-Pro 的 15.0,Gemini-3.1-Pro 只有 11.0,Hulu-Med-32B 是 10.0,Lingshu-32B 与 Qwen3.5-27B 都是 2.0,HealthGPT-Pro 与 Hulu-Med-4B/7B 直接是 0.0。
把 Care 和 Strict 并排看,落差最大的是 Gemini-3.1-Pro:处置级 89.9,严格通过 11.0。同一个模型,两种口径差八倍。这就是论文说的构成性差距——它不是因为模型不会做单点判断,而是因为单点判断的微小错误在连乘下被放大,且诊断与处置两层错误还会互相独立地叠加。
配对对照进一步排除了「是不是题出得不好」的怀疑。论文做了两组控制实验。第一组把完整时序病历换成打乱时间标记、按内容重排的快照,同样 305 个问题、同样 100 位病人。20 个模型里有 14 个在完整时序下轮次准确率更高,但病人自助法 95% 置信区间有 19 个跨零——「时序信息有用」这件事在统计上大部分模型立不住,只有 DeepSeek-V3.1 提升 4.9 个百分点、Gemini-3.1 提升 3.3 个百分点是显著的。
更值得注意的是抵消效应。GPT-5.1 有 22 道题只在完整时序下答对,同时有 19 道题只在快照下答对,净增益 1.0 个百分点,但全链通过率反而降了 1.0 个百分点。20 个模型里有 3 个在这两个指标上方向相反。这说明「改对一处」未必改善整条链,新引入的错误可以直接把原本正确的 episode 作废。
第二组只打乱行序、保留全部时间标记,用来把「记录顺序」和「时间信息」分开。20 个模型里 19 个置信区间跨零,唯一例外还是 Gemini-3.1(+3.0 个百分点,95% 置信区间 0.6 到 5.7)。
为什么这套设计能测出真问题
回头看,NPCBench 有效的三个原因都不在题目数量上。
第一,证据边界把「抄答案」的路堵死了。大多数医疗基准的纵向题,本质上还是阅读理解——线索就埋在文本里。这套基准要求每个决策点的可见信息严格截断到该时点,模型只能靠推理补齐,无法靠后文反推。这也解释了为什么前沿模型在 L1/L2 上能到 90 分,到 L5/L6 就掉档:前者可以检索,后者必须推理。
第二,连乘口径把误差累积显式化了。Care 是加法,容错;Strict 是乘法,不容错。临床实际关心的是后者——一个病人的方案里五个环节错一个,这个方案就是不能用的。用加法口径评测,会系统性高估模型的可用性,而这正是过去医疗榜单的普遍问题。
第三,2×2 拆分让失败可归因。有了 n₁₁ 到 n₀₀ 这张表,就能回答「严格失败主要来自诊断还是处置」。论文的观察是两类错误独立发生:多数模型的 Path. 落在 56.5 到 72.5 之间,而多数类基线已有 99%,T 分期基线是 58%,多个模型却在 12.5 到 43.5 区间波动。两种失败需要完全不同的改进手段,混进一个总分就看不出来。
一句话总结 NPCBench:它把「会做题」和「会看病」之间的距离,用一个连乘号量了出来——单项九十分,合起来两成。
局限与总结
这套基准的边界也很清楚。它只覆盖鼻咽癌一个病种,虽然该病种在证据与决策的耦合上很有代表性,但结论能否推到其他瘤种,论文没有验证。病人队列只有 100 位,Strict 这类病人级指标的置信区间偏宽,1 到 2 个百分点的差距不宜过度解读。O1 开放问诊依赖评分细则与自动判官,虽做了医生标定,主观成分仍在。
对医疗 Agent 团队来说,它的用法不是刷分而是定位:先用 L1/L2 确认知识层没问题,再用 L3 查多模态落地,最后用 L6 的 2×2 表看严格失败集中在哪一层。如果 Strict 低而 Care 高,说明问题在单点可靠性而不是知识覆盖,该做的是降方差,不是加数据。
更多更全的Arxiv论文、直播、求职信息,关注[大模型技术]知识星球
点击小程序链接加入:大模型技术知识星球
欢迎关注我们的公众号【大模型技术】,每日AI相关新闻推送、arxiv论文分享
