上下文工程 · 第 12/12 篇
约 10 分钟读完 · 数据均来自可查证公开报道
作者:潇然 · Context Engineering 第 12 篇
第 01 篇我给一个会话记了第一本账:35 次调用、76,070 字符工具台账、人话 91 个字符。记的是钱花在哪。这一篇记另一本:改动值不值。把规则文件从 40 行砍到 20 行,加一句“禁止静默降级”,技能描述截断阈值从 80 字调到 60 字。效果好了还是坏了?大多数人答不上来,只能凭手感,凭“我感觉它听话了”。手感不是证据。改了装配说不出数字的优化,全是玄学。
行业里有两把现成的尺子,先量它们,再量我自己家的改动。
※ ※ ※
一、外部基准:METR 把“能干多久的活”折成人时
METR 的 time horizon(时间地平线)是目前长任务能力评测绕不开的一把尺(metr.org,检索日期 2026-11-02)。口径要先说清:task-completion time horizon 不是 AI 花了多少时间,而是以人类专家完成时长计的任务难度。把一批软件工程任务按“人做完要几小时”标好难度,再测模型在各难度上的成功率,50%-horizon 就是“成功一半的任务平均要人做多久”。
趋势数字:2019 到 2025 年,前沿模型的翻倍时间约 196 天,差不多七个月难度翻一档。2026 年 1 月 29 日 METR 发布 Time Horizon 1.1,任务集从 170 题扩到 228 题,8 小时以上的长任务从 14 题加到 31 题,评测基建也从自家 Vivaria 迁到英国 AISI 的 Inspect 框架。换尺重量的结果:2023 年以后的翻倍时间从 TH1.0 的 165.3 天缩到 130.8 天,进度估计提速约 20%。截至 2026 年 5 月 9 日,最佳模型的 50%-horizon 约 16 小时以上。这个“以上”要打括号,因为 METR 自己写明:超过 16 小时,现有任务套件测不准。80%-horizon 是 3 小时 6 分,可靠性一加码,能接的活立刻从半天缩到一顿午饭的体量。
真正把这把尺用明白的方式,是把它的局限一起抄过来。METR 自陈:horizon 不是 AI 能独立工作的时长,而是它可替代的人类串行劳动量,且对任务构成敏感:任务池里软任务多,地平线就虚高。2026 年 3 月 3 日 METR 公开更正过一处正则化错误:曲线拟合里一条没有理论依据的正则项把近期模型的 50%-horizon 吹高了 10–20%,Opus 4.6 从首发口径的约 14.5 小时改到约 12 小时。一家评测机构在众目睽睽之下改自己的数,这件事本身比任何单个数字都重要:基准不是圣旨,基准也是一本需要定期对账的账。所以看到“某某模型能干 16 小时的活”这种转述,可以直接判定为吹歪了。地平线量的是任务难度刻度,不是工时发票。
※ ※ ※
二、评测转向:从“记住信息”到“用好信息”
第二把尺子管记忆。LongMemEval(arXiv 2410.10813,ICLR 2025,检索日期 2026-11-02)的设计动机一句话:模型能背下来不等于会用。它用 500 道人工构造的问题埋在可任意拉长的多会话历史里,测五种能力:信息抽取、跨会话推理、时间推理、知识更新、拒绝回答(abstention),最后这项专治“历史里没有却硬编一个答案”。结果很难看:商用助手和长上下文模型在持续交互下的准确率掉了约 30%。论文给的框架也值得抄:记忆系统拆成索引、检索、阅读三段,每段单独能测。
这和上下文工程是同一道题。窗口多大、装了多少字符,那是“背没背下”;装配改动之后下游任务成功率动没动,才是“会不会用”。拿窗口尺寸当 KPI,等于拿内存容量当智力。更扎心的是 abstention 那一栏:历史里根本没提过的事,系统会一本正经地编一个答案回来。这在我们的台账里都有对应物,第 09 篇坏摘要污染后续对话、第 05 篇零召回死重撑候选池,全是“记住了但用不对”的不同变体。评测口径一旦从“在不在窗口里”改成“答没答对、更新没更新、该不说时有没有不说”,很多看起来合格的装配立刻现原形。本篇后面所有本机数字,都按这个标准要答案:不看装了什么,看答出什么。
※ ※ ※
三、A/B 方法:一次装配改动怎么记功过
外部尺子再准也量不到你家项目。自研改动(规则文件、技能描述、记忆条目、工具装配)的验证,我用一套固定动作,四条纪律加四个指标。
四条纪律。固定任务集:改动前后跑同一批题,题目从改动声称会影响的行为里出,每题在跑之前写好判分口径,标准答案落在文件系统的哪一行都提前标好。单变量:一次只动一块装配,同时改三处等于没改,出了负效果也找不到凶手。同模型同温度:除了装配内容其余全锁死,换模型跑对照等于测了两个产品。各跑一遍不算数:同一组至少跑三轮取分布,单次运行的方差足够吞掉一个 10 个百分点的“提升”。这套纪律听着眼熟,就是第 01 篇埋进预算表的那句:没闸门的优化不是优化,是没有对照组的手感。
四个指标:任务成功率(对题数除以总题数);token 成本(新输入、缓存读取、输出分开记——第 01 篇讲过历史是复利,缓存读取最能暴露工具循环的代价);幻觉引用数(答案引用了不存在的文件、条目或口径的次数);失败恢复(一次没答对,模型有没有靠工具自救回来、花了几轮)。
这四个数在会话日志里全取得到。本机 Hermes 的 state.db 里,sessions 表一行一个会话,api_call_count、input_tokens、cache_read_tokens、output_tokens 齐着;messages 表按 role 存每条往返。跑完两组各来一句:
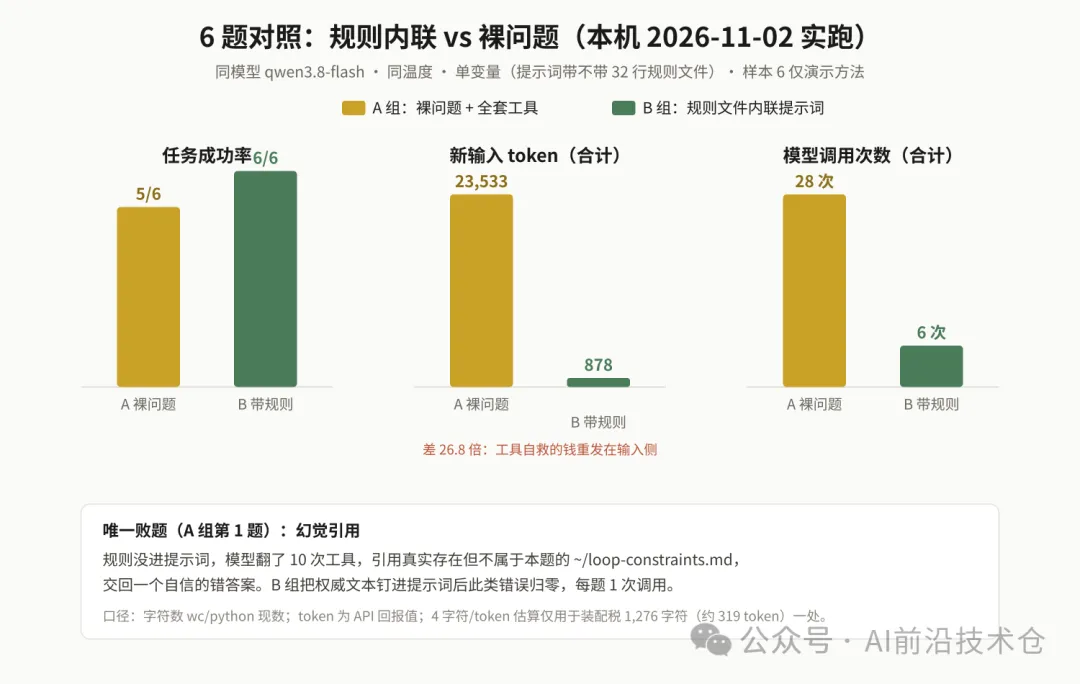
SELECT id, api_call_count, input_tokens, cache_read_tokens, output_tokensFROM sessions WHERE id LIKE 'local-%'ORDER BY started_at DESC LIMIT 12;答案全文在 messages 表 role='assistant' 的行里,判对错时人读一遍、按事先口径打钩,别临时加标准。取账还有两个容易踩的坑,一并说在前面。第一个坑:别拿输出 token 当成本大头。这次实验两组答案都只有一句话,输出侧 3,766 对 491,看着差距不大;成本全压在输入侧的新输入 23,533 对 878(26.8 倍)和缓存读取 452,096 对 153,088 上。光看答案长短,会得出两组差不多贵的错觉。第二个坑:判“引用不存在”要回文件系统对账。模型报了个文件名,你得 ls 一下它是否真实存在、内容是否真含它声称的那条规则,这次 A 组第 1 题就是这种查法查出来的:文件真实存在,口径属于隔壁,判引错。没有这两步,指标表就是抄模型的自我报告。下面这组数字就是这么取的,查询现跑现贴。
※ ※ ※
四、本机实测:6 道题,一组带规则,一组裸奔
先交代实验的寒酸处:任务集只有 6 题,样本小到只配演示方法,不配下结论。但每个数都是今天(2026-11-02)在写这篇稿子的这台机器上真跑的。
规则材料用的是本机一份真实在用的规则文件:~/AGENTS.md,32 行、1265 字符,写的是 loop 任务的开工纪律:动手前先读 STATE.md、单条目最多 3 次修复尝试、验证回执要 SHA 加命令加环境三者一致才能复用、并行子代理派发前声明 will-touch 清单这些。第 06 篇说过这份文件“每条都在对空气说话”的旧事;本篇给它记功过,基于它出了 6 道可判分短题:
1. 开始任何 triage 动手之前必须先读哪个文件?(判分口径:STATE.md)
2. 单个条目最多几次修复尝试,超过怎么办?(3 次;升级上报)
3. 验证回执复用必须哪三个条件一致?(git SHA、命令、环境)
4. 状态双轴标签里 Phase 词要求什么词性?举一个被禁的写法。(名词;“Coding”)
5. 明确禁止编辑的文件名单有哪些?(.env、.env\*、auth/、payments/、secrets/、credentials/)
6. 派发并行子代理前要声明什么,有交集怎么办?(will-touch 清单;改串行)
对照组 A 只拿裸问题,实验组 B 拿同样的问题、前面拼上规则文件全文(1265 字符加 11 字符包装语,提示词从 35–60 字符涨到约 1330–1360 字符,多出的 1276 字符按系列统一的 4 字符/token 估算口径约 319 token,英文为主所以这把尺偏松)。两组都用 hermes chat --oneshot 单发,同一模型 qwen3.8-flash,同一份 34,767 字符的系统底座(都加 --ignore-rules,把规则注入从框架里摘干净,只留“提示词里带不带规则”这一个变量)。要如实标注的一个不对等:A 组手里有全套工具,裸奔可以靠翻盘补救。这恰好就是真实场景里“没装配但能自救”那条路,值得看它花多少钱走通。
跑完从 state.db 拉账,逐题读数:
| | |
|---|
| 10 次调用、15,378 新输入 token,答 loop-constraints.md,判错 | 1 次调用、571 token,答 STATE.md,对 |
| | |
| | |
| | |
| | |
| | |
| 28 次、23,533 新输入、452,096 缓存读、3,766 输出 | 6 次、878 新输入、153,088 缓存读、491 输出 |
四个指标摊开:成功率 A 组 5/6,B 组 6/6。token 成本:B 组每题固定多付约 1276 字符装配税,换来每题 1 次调用;A 组零装配,但平均每题 4.67 次调用,新输入 token 是 B 组的 26.8 倍(23,533 对 878),缓存读取 2.95 倍,工具循环每轮重发前缀的复利在账本上原样显形。失败恢复:A 组 5 题靠 search_files 和 terminal 翻盘自救成功,恢复率 5/5,代价全埋在调用次数里。幻觉引用:A 组 1 处、B 组 0 处,而且这一处是全场最贵的错法。
第 1 题展开讲。模型在 ~/ 下翻到一个同名路数的文件 loop-constraints.md,那是另一套流程的约束清单,里面确实写着“每次运行先读它”、确实写着“Max 3 fix attempts”。它引用了这个真实存在、但口径不属于本题的文件,十次调用、一万五千 token,交上来一个自信满满的错答案,零自我纠错。一个家目录里躺着两份互相打架的规则文件,模型分不清题目问的是哪一本。这正是第 05 篇记忆污染和第 06 篇规则文件挂错门牌的事故在评测台上的复现。装配缺失的代价不是“少装一点答得糙一点”,是没有权威源时它会自己找一本经书念。
所以这个 6 题小实验给出的方法学结论比数字本身值钱:带装配的优势要用对题率、调用次数、失败模式三个轴一起看;单一“成功率”会骗人:A 组 5/6 看着只差一题,那 1 题是引错来源的幻觉错误,B 组把权威文本钉在提示词里之后这类错误直接归零,还顺手把成本从平均 4.67 次调用压到 1 次。样本 6,置信度 0,方法可复跑。
※ ※ ※
五、全系列合账:12 篇各钉一个数
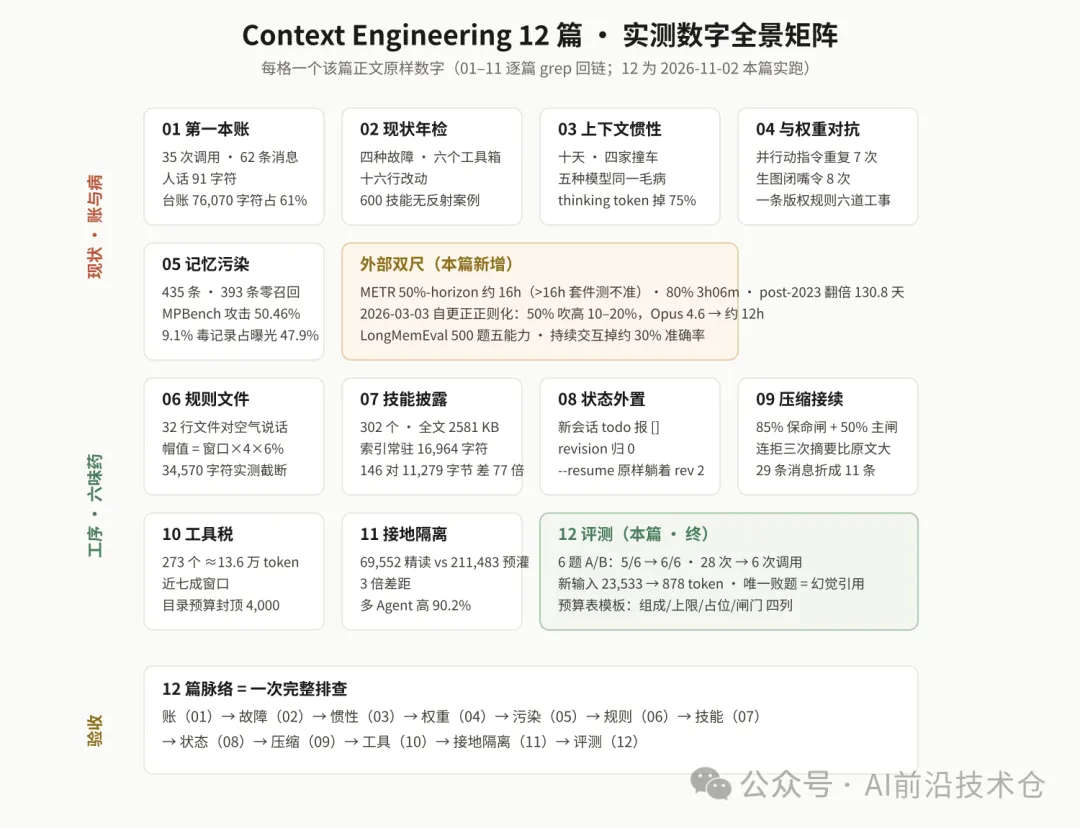
终篇按第 01 篇埋的约,把全景图合上。下表每一格都是对应篇正文里的原样数字,我逐篇 grep 回来对过账,取不到的不列;全系列脉络正好是一次完整的排查顺序:记账(01)→认故障(02)→惯性(03)→对抗权重(04)→记忆污染(05),这是现状五病;规则(06)→技能(07)→状态(08)→压缩(09)→工具税(10)→接地隔离(11),这是六道工序;最后是今天这篇评测(12)把工序质量本身量出来。
| |
|---|
| 35 次模型调用、62 条消息;人话 91 个字符;工具台账 76,070 字符、占 61% |
| Breunig 四种故障、六个工具箱;十六行改动的实现账;600 个技能无反射的案例 |
| 十天四家撞车;thinking token 每轮缩水 75% |
| 并行动指令重复 7 次;生图闭嘴令写 8 次;一条版权规则六道工事 |
| 435 条记忆 393 条零召回;MPBench 攻击成功率 50.46%;9.1% 毒记录占曝光 47.9% |
| 32 行文件在对空气说话;帽值窗口 token×4 字符×6%、钳 20000–500000;34,570 字符实测截断 |
| 302 个在册技能全文 2581 KB 换索引 16,964 字符;单技能常驻 146 字节对全文 11,279 字节、差 77 倍 |
| 新会话 todo 报 []、revision 归 0;旧会话 --resume 原样躺着 |
| 85% 粗估保命闸配 50% 真实账主闸;连拒三次摘要比原文大;29 条消息折成 11 条 |
| 273 个可延迟工具 ≈13.6 万 token、近七成窗口;目录清单预算封顶 4,000;Claude Code 口径 85%(77K→8.7K) |
| 16,257 字符搜索列表→69,552 全链路 vs 211,483 全文预灌、3 倍差距;Anthropic 多 Agent 高 90.2% |
| 6 题对照:成功率 5/6 对 6/6;新输入 23,533 token 对 878;28 次调用对 6 次;一处引错规则本的幻觉引用 |
收拢成一页可抄的预算表模板。列就四个:组成部分、预算上限、实测占位、处置闸门。上限是设计值,占位是评测跑出来的真数,闸门是超限后系统的动作。拿我的 Hermes 底座当已填样例(数字出处见上表):
| | | |
|---|
| | | 工具目录预算封顶 4,000,超了五级降级(10 篇) |
| | | |
| | | 单技能触发才加载,5k token 封顶(07 篇) |
| | | |
| | | |
| | | 入口截断、spillover 落盘(09、10 篇) |
上线前自检清单,一条一句,全对着前文来:规则文件帽值截断状态查了没有(06);技能是常驻还是按需、索引行多长量了没有(07);新会话里任务状态还在不在,--resume 对账过没有(08);压缩后拿同一验证问题前后各问一遍、答案对过没有(09);工具目录清单是不是超了预算(10);检索链路是按需精读还是全文预灌、字符账算过没有(11);改动进没进固定任务集的 A/B、四个指标出不出数(本篇)。八条里有一条答不上来,上线的就是玄学不是工程。
※ ※ ※
六、收个尾
12 篇走完。回头看,整个系列其实只反复说了一件事:上下文窗口是每轮收费的注意力预算,工程就是给这笔预算建账(01)、认病(02–05)、开药(06–11)、验收(12)。第 01 篇那本账记的是钱去了哪,今天这本账记的是每一笔改动值不值。两本合上,第一季齐了。
下一季预告:Memory Engineering 记忆工程系列已在路上,专治第 05 篇挖开的那道口子:写进去的东西怎么管、怎么忘、怎么被信任。题单先不透,索引照旧挂在 https://ivisi.cc/tutorials/context ,十二篇全本都在。
留个互动:你的 agent 项目里有没有“两份规则文件打架”的经历?哪家踩的坑最深,评论区摆出来,下一篇也许就写它。
※ ※ ※
资料来源:METR time horizons 方法与数据(metr.org/time-horizons/ 与 Time Horizon 1.1 发布文 metr.org/blog/2026-01-29-time-horizon-1-1/,2026-11-02 检索核实);METR 对正则化错误的公开更正(metr.org 2026-03-03 更正帖与 2026-03-20 建模假设影响分析,Opus 4.6 修正至约 12 小时口径);LongMemEval(arXiv 2410.10813,ICLR 2025,2026-11-02 检索核实 500 题、五能力、30% 准确率下降口径);本机 Hermes 实跑与 state.db 账目(qwen3.8-flash,--oneshot --ignore-rules,6 题×2 组 12 个会话,sessions/messages 表逐行回读,2026-11-02 现取;规则文件与干扰文件均为 ~/ 下工作文档、业务名已泛化;token 折算处标 4 字符/token 估算口径);系列第 01–11 篇正文数字(逐篇 grep 回链,见 ~/wechat-articles/ 各篇);文中示例主机均为文档保留地址,非作者真实环境。
你的 agent 项目里有没有两份规则文件打架的经历?哪家踩的坑最深,评论区摆出来。
在看 · 转发 · 评论区聊聊