Anthropic 在 2026 年 11 月 9 日发布了新一代旗舰模型 Claude Fable 5.2。
第二天,第三方评测平台 Artificial Analysis 公布了它的完整实测成绩单。
测试对象是最高思考档位 Claude Fable 5.2(Max,Default Fallback)。
平台给出了一句非常直白的评价,称它是目前最强之一,也可能是最不划算之一。
在综合智力榜单上,它拿到 65 分,在 74 个主流模型里高居第 1,把同价位模型 40 分的中位数甩开了一大截。
换到账单和速度这两栏,画风却来了个急转弯。
它的接口标价达到每百万输入 8 美元、每百万输出 40 美元,单个评测任务平均花费 26.54 美元,成本排名在 73 个模型里直接垫底。
等待时间同样夸张,首字回答要等上 235 秒(最初批次约 231.55 秒),平均一个任务耗掉 44.4 分钟,全套测试总共吐出 2.75 亿个输出 token。
比起秒回和省钱的日常对话需求,它更像一台把能力上限摆在首位的重推理怪兽。
一、1 个第 1 名换来 3 个倒数:这份成绩单到底有多极端
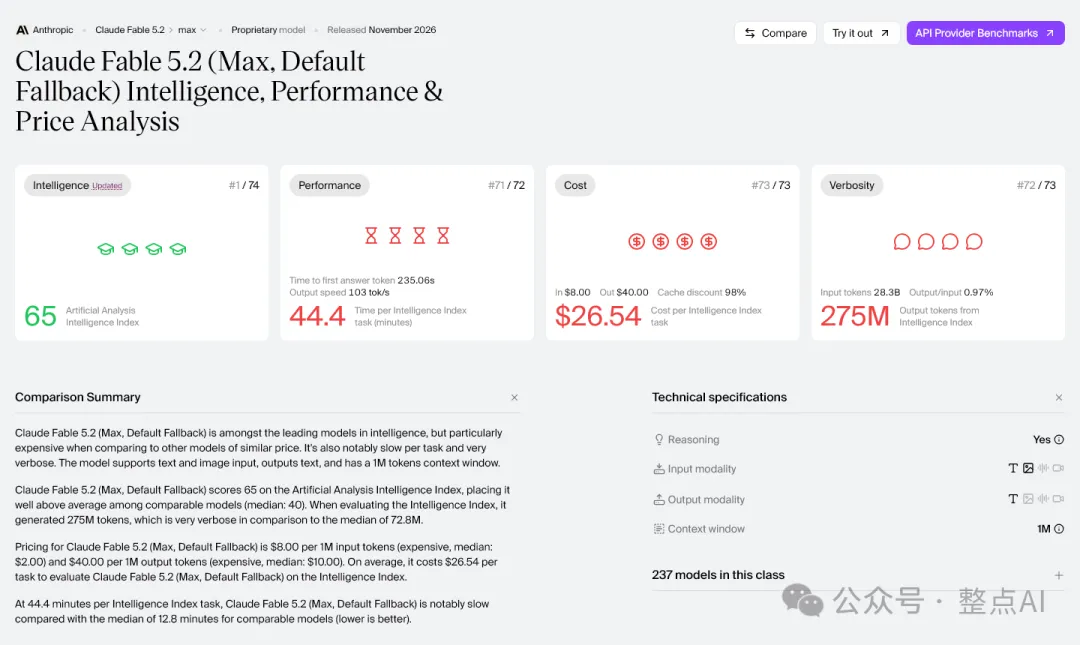
先看 Artificial Analysis 实测页面的第一屏四张核心卡片,绿红对比一眼就能看明白。
在四项关键排名里,Claude Fable 5.2 满血版活生生跑出了「一绿三红」的极端偏科。
唯一亮绿灯的,是 74 个模型里排第 1 的综合智力得分。
Artificial Analysis 的新版智力指数由 9 项高难度独立测试拼成,专门防刷题污染,同价位模型中位数只有 40 分。
Fable 5.2 满血版一口气拿下 65 分(精确值 64.56),六个细分行业能力里全部站上高位。
它在工程能力拿了 72.6 分,战略运营 67.4 分,经济学 66.5 分,医疗健康 65.4 分,金融会计 64.8 分,法律 63.3 分。
在专考冷门硬核知识的「人类最后一次考试高难版」里,它答对 80.2%;在物理推理高难测试里拿下 76.5%;在科研终端任务里拿下 73.3%。
另外三张亮红灯的卡片,记录了它为这个第 1 名付出的全部代价:
- 性能排倒数第 2(第 71 / 72 名):发完指令要等 235.06 秒才看到第一个正式回答的字,单个任务平均耗掉 44.4 分钟,而可比模型中位数只有 12.8 分钟。
- 成本排倒数第 1(第 73 / 73 名):单个任务平均花掉 26.54 美元(约合人民币 190 元),整套测试跑一轮光模型费就烧掉 22,191 美元(超 15.8 万元)。
- 篇幅话痨排倒数第 2(第 72 / 73 名):整套评测累计输出 2.75 亿 token,几乎是同价位模型中位数(7280 万)的 3.8 倍。
而且随着你喂给它的文本变长,等待时间还会成倍往上涨。
实测数据显示,在 10 万 token 的超长上下文请求下,光是等它开口吐出第一个字,就需要整整 580.5 秒(将近 10 分钟)。
二、明明单价降了 20%,为什么实际账单反而翻倍
翻开 Anthropic 的官方定价表,你会发现一个反直觉的账目矛盾。
上一代 Claude Fable 5.1 的接口标价是输入 10 美元、输出 50 美元。
这次 Fable 5.2 主动降价 20%,降到输入 8 美元、输出 40 美元,缓存读取更是低至 0.20 美元。
它的纯生成速度也并不慢,每秒能吐出 102.8 个 token,比上一代还快了不少。
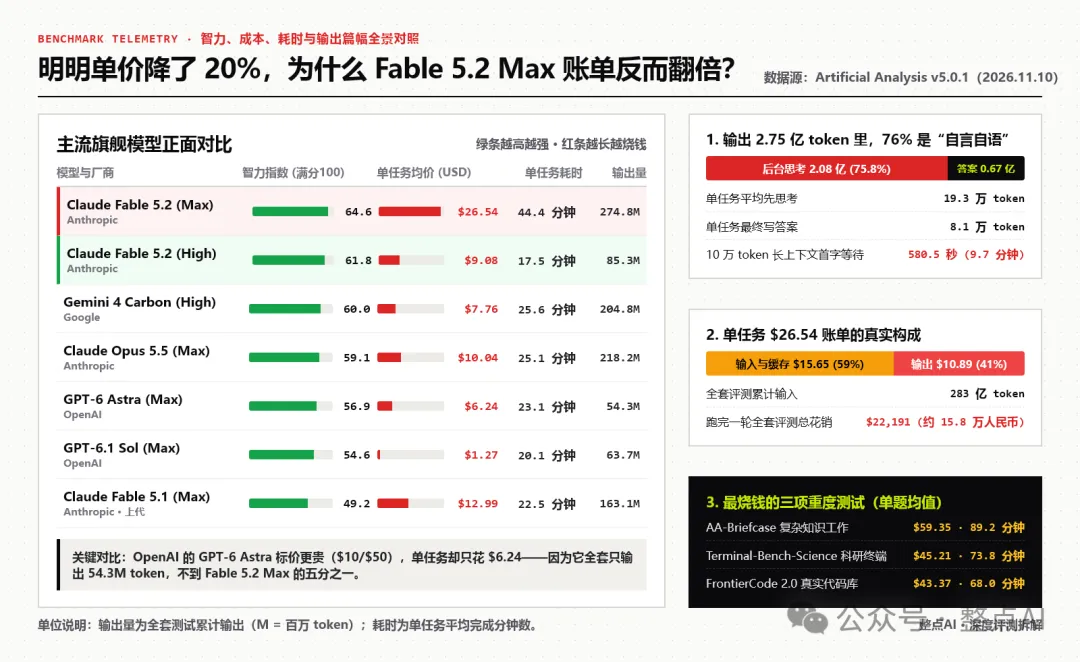
单价降了、吐字也快了,单任务账单却从上一代的 12.99 美元一路飙升到 26.54 美元,为什么反而贵出一倍还多?
我们把 Artificial Analysis 后台记录的同台竞争对手和 token 消耗拆开一看,真相就藏在两张数据里。
第一个真相,是它 75.8% 的输出全是在后台「自言自语」。
Fable 5.2 开启了始终在线的自适应思考机制。
整套测试累计输出的 2.75 亿 token 里,高达 2.08 亿都是藏在幕后的推理思考过程,真正输出给用户看的答案只有 6650 万。
摊到单个任务上,它平均要在后台先琢磨 19.3 万个思考 token,再写出 8.1 万个正式答案 token。
反观 OpenAI 的 GPT-6 Astra,单价标得比它还贵(输入 10 美元、输出 50 美元),单任务成本却只要 6.24 美元。
GPT-6 Astra 之所以便宜,是因为它全套只输出了 5430 万 token,篇幅不到 Fable 5.2 满血版的五分之一。
第二个真相,是超长多轮任务反复读取上下文,把输入和缓存费滚成了雪球。
在 9 项测试里,Fable 5.2 累计吞下了 283 亿个输入 token。
在单个任务 26.54 美元的账单里,输入与缓存读写就占走 15.65 美元(占比 59%),思考加回答输出占 10.89 美元(占比 41%)。
遇到最烧钱的复杂商业知识工作评测(AA-Briefcase),单道题平均就要烧掉 59.35 美元,让模型足足跑上 89.2 分钟。
哪怕是科研终端任务和真实开源代码库改错,单题均值也要 45.21 美元和 43.37 美元,每道题都要跑满一个多小时。
三、花 26 美元跑一个任务,它到底干成了什么大事
如果只算小账,每道题接近两百块人民币确实吓人。
但如果把眼光放到真正没人能替你啃下来的高难工程和科研极限上,Anthropic 这回展示的几个实测案例确实有两把刷子。
先看基础规格。Claude Fable 5.2 属于 Anthropic 闭源旗舰,支持文字和图片输入、纯文字输出。
它原生配备 100 万 token 超长上下文(约合 1500 页 A4 纸文档),单次最高可输出 12.8 万 token。
官方还额外提供了「极速模式」,生成速度最高可提速 2.5 倍,但代价是单价直接翻倍到输入 16 美元、输出 80 美元。
在能力天花板上,Fable 5.2 这次重点打了三场硬仗:
1. 长周期自主写代码与控电脑
软件工程测试拿了 93.0%,从零做完整网页应用拿了 93.77% 排第 1。
模拟真人操作电脑桌面,它也拿到 89.3% 的高分。
官方测试中,它还能自主调度上千个子代理持续工作数小时,从零写出一套原型操作系统。
2. 协助攻克数学与理论物理难题
预发布测试里,1000 个 Fable 5.2 实例组成智能体团队,花了 30 小时把费马大定理的证明写成了机器可校验的代码。
在理论物理领域,它还协助解开了涉及黑洞相变与量子引力的两道未解算题。
3. 只靠一段话从零设计真实硬件
跟硬件团队配合时,Fable 5.2 只读了一段文字需求,就独立画出四层电路板、做好 3D 打印外壳建模并写完底层软件。
最终做出来的语音中枢、USB 会议扬声器和掌上电子宠物,全部是能真实开机运行的实体设备。
顺带一提,Anthropic 当天其实同步推出了兄弟版本 Claude Mythos 5.2。
两者共享完全相同的底层模型大脑,区别在于公开发布的 Fable 5.2 保留了严格的生物安全与网络安全护栏。
护栏更宽松的 Mythos 5.2,目前仅面向通过安全审查的特定科研机构开放。
四、真想上手用 Fable 5.2,千万别默认直接开 Max
说到这里,普通开发者和企业团队最关心的问题其实只有一个:这东西这么贵又这么慢,到底值不值得接进工作流?
Artificial Analysis 这次挂在头条里排到成本倒数第 1 的,其实只是把思考强度拧到最顶端的 Max 档。
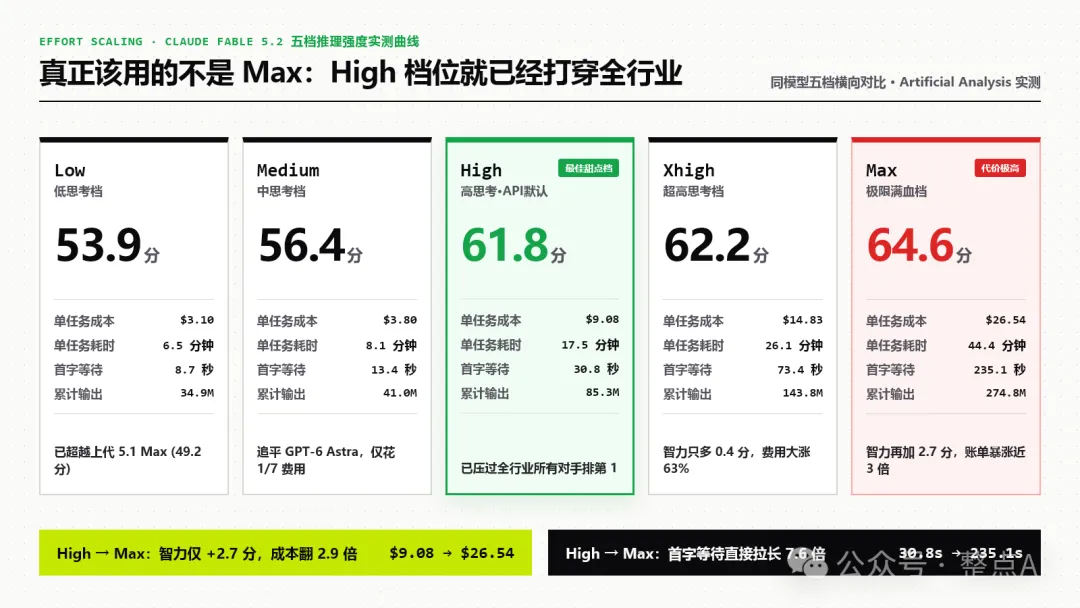
Anthropic 给 Fable 5.2 留了整整五个思考强度档位:Low(低)、Medium(中)、High(高·默认)、Xhigh(超高)和 Max(极限)。
我们把这五个档位的 Artificial Analysis 实测数据全部拉出来排成一排,拐点立刻就出现了。
看这张五档实测图,几乎所有人都该把目光锁在中间绿色的 High 档(也是官方默认推荐档),甚至是左边两个轻档位:
- Low 档已经强于上代满血版:智力拿到 53.9 分,压过上代 Fable 5.1 Max 的 49.2 分。单任务只花 3.10 美元,首字等 8.7 秒,6.5 分钟做完。
- Medium 档性价比极高:智力 56.4 分打平 GPT-6 Astra,单任务仅花 3.80 美元,耗时 8.1 分钟且首字等 13.4 秒,费用比 Max 降 86%。
- High 档就已经打穿全行业:智力 61.8 分,超过 Gemini 4 Carbon(60.0 分)和自家 Opus 5.5(59.1 分),单任务只要 9.08 美元。
- Xhigh 和 Max 档明显不划算:拧到 Xhigh 涨价 63% 仅多 0.4 分;再拧到 Max 只多 2.7 分,账单却翻近 3 倍,首字等待暴涨 7.6 倍。
上线这两天,Reddit 和海外开发者社区里的真实评价也印证了这种撕裂。
不少习惯拿它当日常对话或写小脚本的人吐槽,开高档位后模型明显“想太多”,喜欢过度设计复杂方案,每周限额和 API 余额烧得飞快,甚至有老用户调侃这周全靠官方发的临时额度重置救急。
相反,给出极高评价的几乎清一色是用来啃硬骨头的工程师。有人把查了一周没定位出的底层存储死锁扔给它,吃一顿饭回来,它已经翻完几十万行代码把根因和补丁一起交出来了。
所以最务实的用法非常清楚:
日常写代码和改文档,或做通用对话,选成本更低且响应快得多的 Claude Opus 5.5 或 Fable 5.2 Medium 档就够,别拧到 Max 当聊天用。
真正值得让 Fable 5.2(High 或 Max)上场的,是卡了几天找不到方向的系统重构,或者需要一次吃进百万字资料做深度审计的硬仗。
面对宁可挂在后台跑四十分钟也要一次做对的科研和工程难题,这笔预算才算花在刀刃上。
五、写在最后
回到 Artificial Analysis 页面最后留下的那句判断。
如果你追逐的是当下AI能够触及的能力天花板,Claude Fable 5.2 交出的这份 65 分成绩单确实很有说服力。
可只要你真正开始在业务里算部署账单与界面响应时延,或者在意模型输出能不能克制一点,满血 Max 档那 26.54 美元和 44 分钟的门槛,会让人按下调用键前先犹豫三秒。
大模型的竞赛跑到这里,拼的早就不只是谁能考出最高分,而是谁能让你花得起、等得及。
如果给你配一个「会思考 40 分钟、但大概率一次帮你彻底搞定」的超级助手,你手头哪一件事最值得丢给它慢慢跑,又有哪些活绝对不该浪费这笔预算?欢迎在评论区聊聊你的选择。