BUILD · 从零搭 RAG
上一篇那版跑起来之后,我又把切块改了一回。
改完觉得比原来好。
好多少,说不上来。
说不上来,是因为手上没有尺子。今天就把这把尺子做出来,五十条题。
别设计,去捡
闭门造车写出来的题,会长成文档的样子。
比如「退款期限是几天」。这句话文档里有,用户嘴上不这么说。
用户会说「我买的东西还能退吗」。
前一种问法,只要有一块里出现「退款」「期限」,就算命中。分数很漂亮,线上照样错。
别写,去捡。
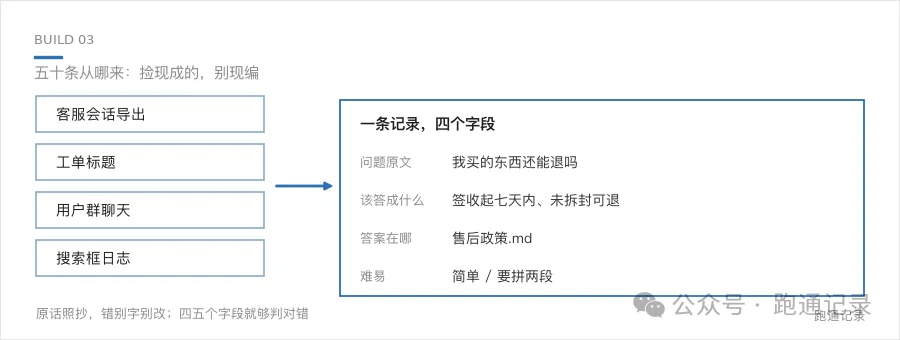
客服会话导出、工单标题、用户群聊天、搜索框日志。最后一条有最好,没有也不耽误。
三十份文档的号,做了几个月,历史会话几百条是有的。挑五十条,两小时的事。
挑的时候只做一件事:把姓名、手机号、订单号抹掉。
错别字留着,口语留着。
你把它「规范化」成书面语,等于原地又造了一遍题,白捡。
一条长四个字段
[ { "q": "我买的东西还能退吗", "a": "签收起七天内、未拆封可退", "src": "售后政策.md", "level": "简单" }, { "q": "拆了吊牌还能退不", "a": "不能,仅限未拆封", "src": "售后政策.md", "level": "要拼两段" } ]
src 只写文件名,不写第几段。
段落号写死了,你下次一改切块,全变成误判。判定到文件这一级就够用。
跑之前,让切块带出处
上一篇的 chunks 是纯字符串,谁是谁都分不出来。先补一层。
from pathlib import Path docs = [] for p in Path("kb").glob("*.md"): for c in split(p.read_text()): docs.append({"src": p.name, "text": c}) chunks = [d["text"] for d in docs]
search 也改一行,返回下标,别返回文本。
def search(q, k=5): v = embed(q) v = v / np.linalg.norm(v) scores = vecs @ v return [(float(scores[i]), int(i)) for i in scores.argsort()[::-1][:k]]
二十行,跑出一张清单
import json cases = json.load(open("evalset.json", encoding="utf-8")) hit, miss = 0, [] for c in cases: hits = search(c["q"], k=5) ok = any(docs[i]["src"] == c["src"] for _, i in hits) hit += ok if not ok: miss.append(c["q"]) print(f"命中 {hit}/{len(cases)} = {hit/len(cases):.0%}") for q in miss: print(" 漏:", q)
没有依赖,跑完两秒。输出的下半截才是重点。
第一次的数,别当真
第一遍跑完,多半不好看。这很正常。
五十条里中几条,取决于你的文档有多乱,跟模型关系不大。别人的数字别拿来对。
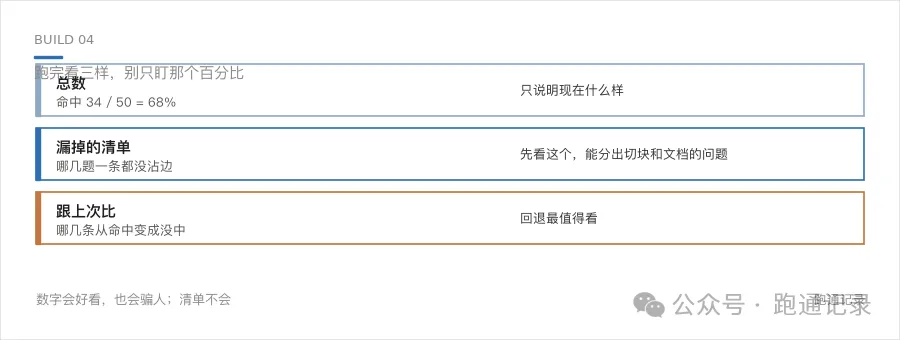
分数只说明现在什么样,清单才告诉你去改哪儿。
漏的那几题,扫一眼就能分出来:是切块切坏了,还是文档里压根没写。
前者改切块,后者改文档。两件事,别混着做。
改完再跑,先看回退
切块参数一改,总命中可能涨三条,同时掉两条。
涨的那三条是新的,掉的两条是老问题回来了。
只盯总数,这两条你就看不见。
所以每次跑,把 miss 存下来,跟上次比一次。
掉回去的题,比新修好的题更值得看。
这五十条会一直长
线上每答错一次,就往里补一条。
三个月后它可能一百多条。那时候它才算你真正的尺子。
不方便手打,就把客服导出的表丢给模型,让它按四个字段整理一遍。
整理完,答案和出处自己逐条核。这活儿不能省。
下一篇讲漏掉的那几题:先改切块,还是先上重排。