评测一个大模型,动辄要跑几千道题;如果只随机抽一小部分,结果往往已经够用——真正让人睡不着的是那条偶尔翻车的长尾。笔者这次读的是博世研究院与 CMU 的《Random Is Almost Enough?》,它先用理论解释了「随机采样为什么几乎够用、又为什么不稳」,再提出 BestRand:让几个小模型当探针,从一堆随机子集里挑出最像全集的那个。在 70 个文本、多模态、Agent 基准上,它把高误差风险降低了 50.2%,构造成本只要对比方法的 51.3%。
Benchmark compression(基准压缩)做的事很朴素:不跑全量测试集,只挑一个子集,用子集分数估计全量分数。它之所以有市场,是因为评测真的很贵。以论文附录里的基准为例,MMLU 有 14,042 条测试项,HellaSwag 有 10,042 条;每换一个模型就要全部重跑一遍。到了 Agent 和 VLA,成本还要再上一个台阶——VLA 的每个 item 往往要跑一次交互式 rollout,而不是一次前向。
现有方法大致分两派。一派依赖历史模型响应:TinyBenchmarks 用 IRT 学题目难度,ZipBench 造合成响应,Anchor Points 做聚类,SparseEval 训练线性模型或 MLP 预测全量分数。另一派只用 prompt 表征做多样性选择,比如 Facility Location、MIS、Agreement、Coverage;它们构造便宜,但误差通常更大。随机采样夹在中间:几乎零构造,平均不差,但没人能保证这一次抽到的不是坏子集。
这篇论文要回答的就是三个问题:随机采样到底能有多准?它为什么不稳定?能不能用很小的额外成本,把最坏情况压下去?
先把问题形式化。假设 benchmark 有 道题、 个模型, 是模型 在题目 上的分数。随机抽一个大小为 的子集 ,子集均值 与全量均值 的差就是估计误差 ;论文关心的主指标是所有模型误差绝对值的平均,即 。
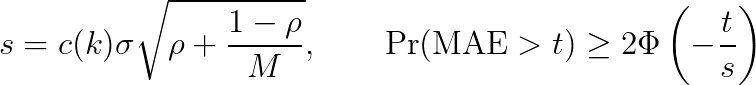
关键是把误差拆成两部分:所有模型一起偏高或偏低的「共同位移」,以及每个模型各自的残差。论文证明,在有效样本量不太小的条件下,误差向量近似零均值多元正态,而 MAE 一定不小于 。于是,MAE 的长尾下界由共同位移的尺度 控制:
其中 是标准正态分布函数。 越大,同样的阈值 对应的尾部概率就越高。问题于是变成:什么让 变大?在模型两两误差相关系数都为 的简化假设下,
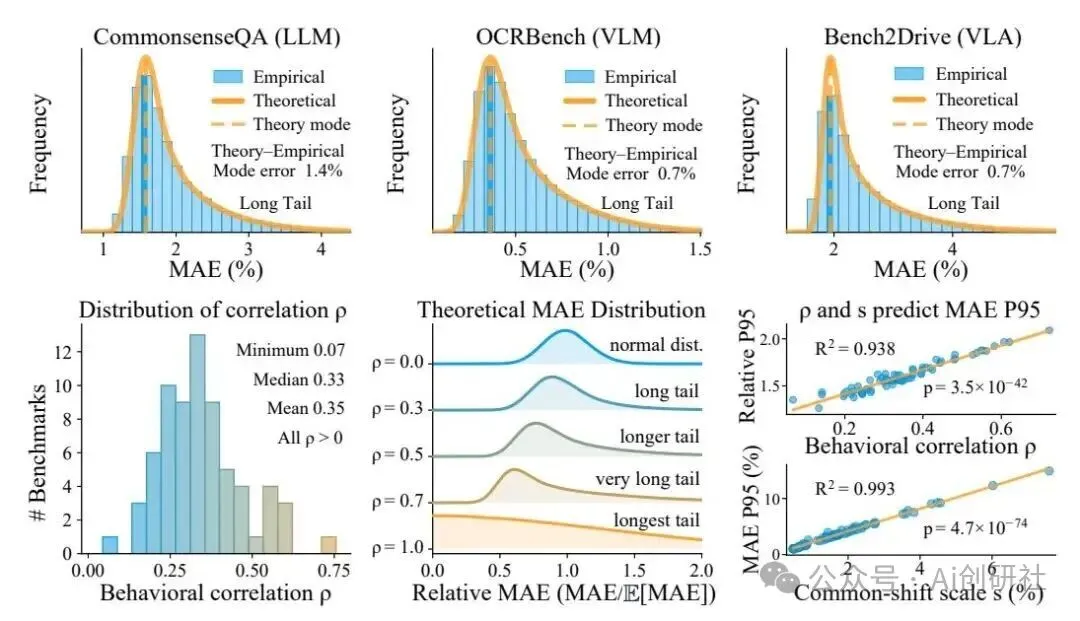
这里 是单个模型分数的标准差, 是有限总体修正因子。 越大, 越大,长尾越厚。图 1 的数值实验和这个预测吻合得相当好:在 LLM、VLM、VLA 三类基准上,理论 MAE 分布与实测分布几乎重合;跨基准统计的 最小 0.07、中位数 0.33、均值 0.35,全部为正。
*图注:理论预测的 MAE 分布与实测高度吻合(上排); 在各类基准上普遍为正(左下),且 与共同位移尺度 能高度解释 MAE 的 P95(右下)。图源:论文 Figure 1。*
不是抽象参数。LLM、VLM、VLA 往往共享 backbone、训练语料,知识蒸馏还会让行为进一步对齐;它们容易在同一批题上一起对、一起错。只要相关性还在,共同位移就不会被平均掉。论文给出一个很刺眼的极限:固定 、,当模型数 时,
换句话说,多找几个模型来评测,并不能消除这类不稳定性。这也是这篇论文和「多模型平均」直觉最不一样的地方:不稳定的根源不是模型数量不够,而是模型之间太像。
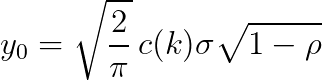
那为什么随机采样又「几乎够用」?论文的第二条定理给出解释:当 很大时,MAE 分布的最低端是 ,而分布的众数 以 的速率逼近这个下端点,其中 。也就是说,大多数随机子集的误差都挤在低端,随机采样高概率表现不错;但分布仍有一条右尾,少数子集会翻车。这就是标题里那个「almost」的来源。
既然随机采样的优点是便宜、缺点是长尾,最自然的修补就是:保持便宜,只把「坏子集」挑掉。BestRand 的做法是四步。
1. 先从 道题里随机抽一个大小为 的候选池 ,其中 是池倍数;让 个探针模型在 上跑一遍,记录每道题的探针分数向量 。
2. 算池平均 ,把它当作全量探针均值的近似。
3. 从 里随机抽 个大小为 的候选子集 ,算每个子集的探针均值 ,以及它和 的 L2 距离 。
4. 选 最小的那个 ,只在这个子集上评测所有目标模型。
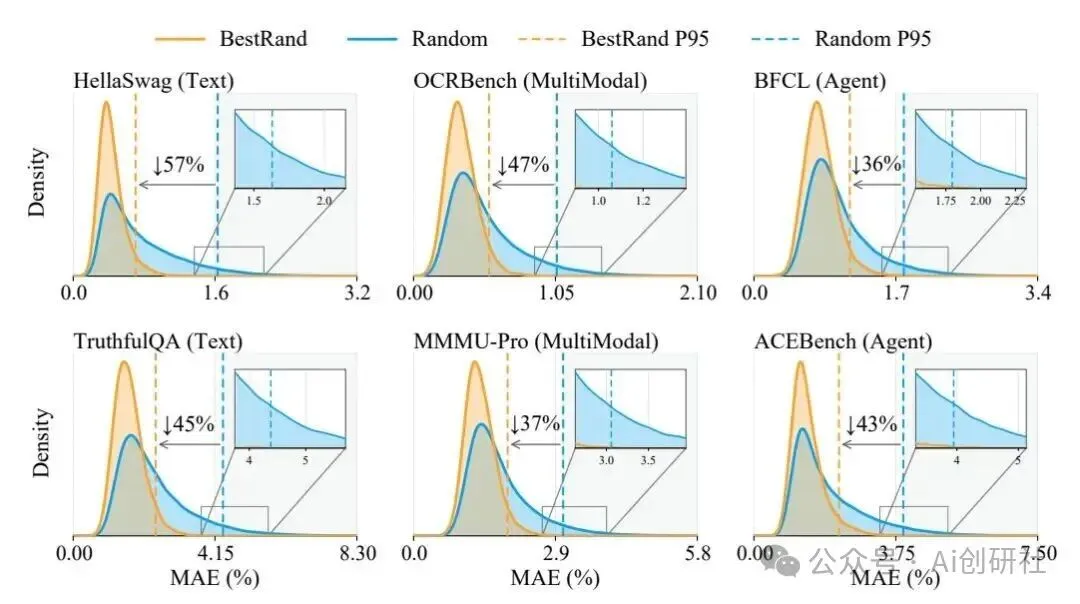
这套流程的妙处在于「一次探针,多次复用」:探针分数只算一次, 个候选的比较只是缓存向量求平均,不增加任何模型调用。候选搜索在 CPU 上并行执行不到 0.1 秒。默认配置是 、、、L2 匹配;在 2% 留存下,构造成本只有依赖数据基线的 8.0%,平均为 51.3%。
图注:20% 留存下,BestRand(橙)把六个代表性基准的误差分布压向 0,并把 P95 降低 36%~57%;Random 的右尾是浅蓝色。图源:论文 Figure 2。
BestRand 本质上是在挑「难度分布最像全集」的子集。论文把这件事写成了一个可证明的机制:把共同位移对探针分数做最小二乘投影,
其中 和 分别是子集和全集的探针均值, 是子集上的残差均值。最小二乘正交性让两部分不相关,方差分别是 和 ; 就是探针能解释的共同位移比例。
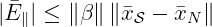
由 Cauchy–Schwarz 不等式,。所以,只要让子集的探针均值贴近全集,就能压住这一项,而且不需要知道 ,也不需要跑目标模型。BestRand 用池均值 近似全集均值: 控制参考准不准, 控制搜索细不细。理想情况下,选中的共同位移方差会从 降到 ; 越大,收益越大。但残差项 仍然在,所以它不是零误差。
共同位移的尺度与长尾下界:
「随机为什么几乎够用」:MAE 分布的最低端是
众数以 的速率逼近它,。
「探针为什么有效」:
选择子集让 时,共同位移方差趋近 。
主结果。 论文在 70 个基准(44 文本、16 多模态、10 Agent)上做了 2%~50% 六个留存率的实验。BestRand 在三类基准上的平均 MAE 分别是 2.92、2.87、5.43,对比 Random 的 3.47、3.24、6.14,TinyBenchmarks 的 3.65、3.40、6.27,以及 ZipBench 的 3.23、3.19、6.01。相对 Random、ZipBench、TinyBenchmarks 三个强基线,平均 MAE 降低 16.4%。不过要注意,5%~50% 留存下的 Spearman 排名相关性和 Random 几乎一样(文本 0.922 对 0.921,多模态 0.917 对 0.919,Agent 0.870 对 0.870,表 8)——它改善的主要是绝对误差和尾部,不是模型排序。
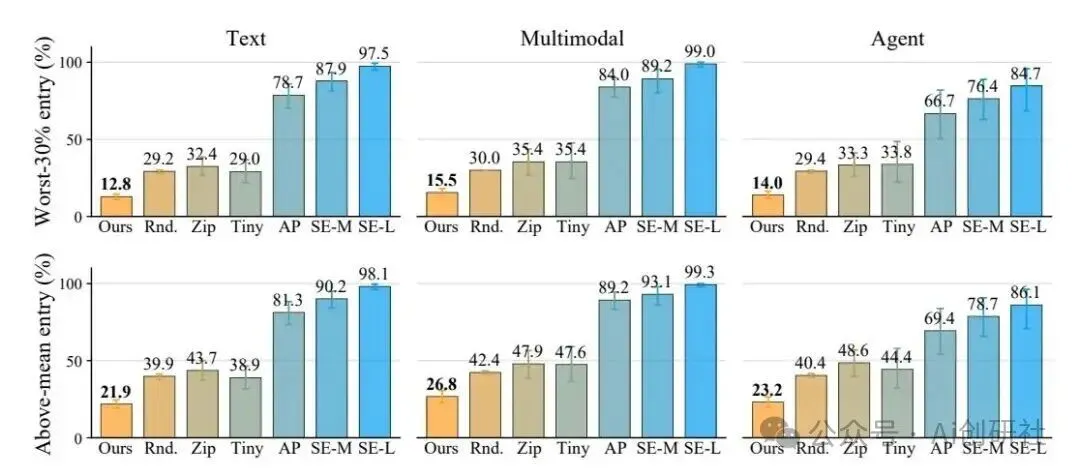
高误差风险。 论文用 Random 的 70 分位数和均值作为两条高误差阈值,分别对应「最差 30% 的随机子集」和「比随机平均更差」。在 70 分位阈值下,BestRand 在文本、多模态、Agent 三类基准上的高误差概率分别是 12.8%、15.5%、14.0%,Random 是 29.2%、30.0%、29.4%;在均值阈值下是 21.9%、26.8%、23.2% 对 39.9%、42.4%、40.4%。相对三个强基线平均,高误差风险降低 50.2%。这比平均 MAE 更能说明问题:用户真正怕的不是平均差一点,而是某一次评测刚好抽到坏子集,得出错误结论。
图注:以 Random 的 70 分位(上)和均值(下)为高误差阈值,BestRand 在文本、多模态、Agent 三类基准上都是最低;文本最差 30% 阈值下为 12.8% 对 29.2%。图源:论文 Figure 3。
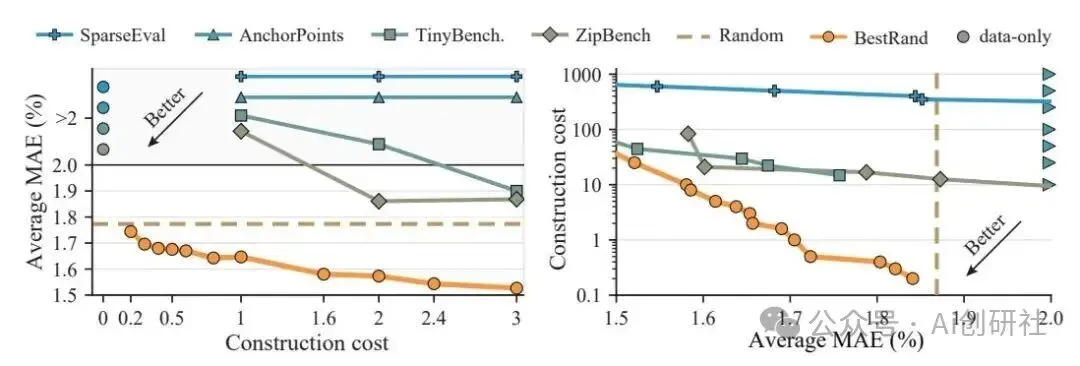
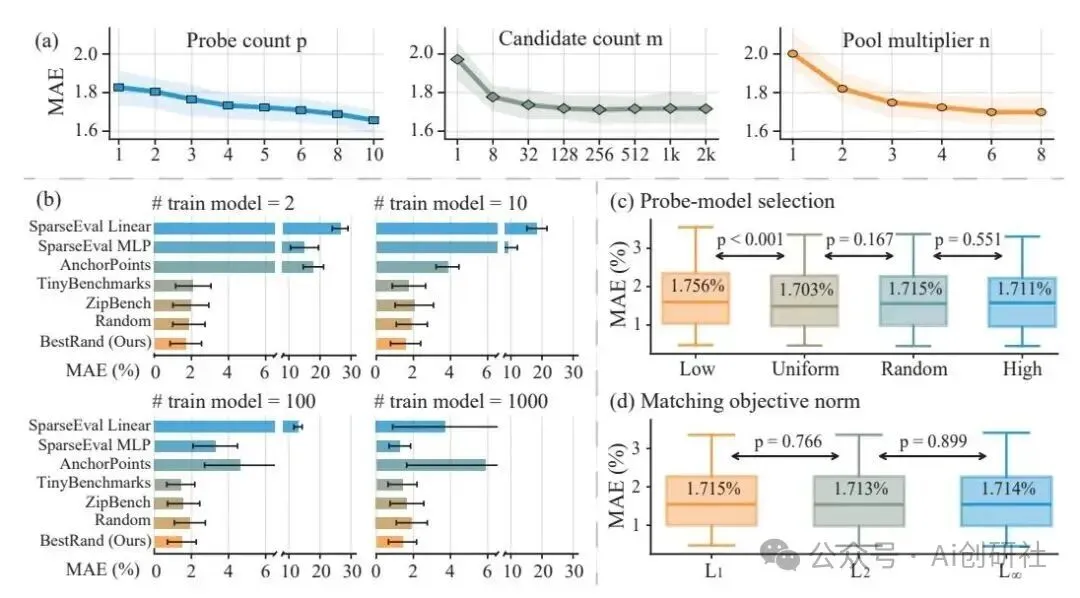
成本与消融。 论文把构造成本定义为 , 是观测到的模型-题目分数总数; 相当于把一个模型在全量基准上评一遍。BestRand 在 Cost<1 时就已经优于 Random,而 SparseEval、TinyBenchmarks、ZipBench 等可学习基线通常需要 Cost≥1;达到同样的 MAE,它需要的成本也明显更低。平均构造成本为对比方法的 51.3%,2% 留存时只要 8.0%。消融方面,、、 都有收益但边际递减, 从 1 增到 8 提升最明显;探针选择和 L1/L2/L∞ 范数都不敏感(只有全用低分模型会明显变差);默认 、、 是性价比点。构造模型从 2 个增到 1000 个时,BestRand 在模型少时优势最大,模型多时仍与最强基线相当。
图注:20% 留存下的精度-成本权衡:同样成本下 BestRand 的 MAE 更低,达到同样 MAE 所需成本也更低;它在 Cost<1 时已优于 Random,而可学习基线通常要 Cost≥1。图源:论文 Figure 5。
图注:BestRand 的消融:(a) 探针数、候选数、池倍数的边际收益递减;(b) 构造模型从 2 到 1000 个时的对比;(c) 探针模型选择,只有「全用低分模型」显著更差;(d) L1/L2/L∞ 匹配范数无显著差异。图源:论文 Figure 4。
OOD 与 VLA。 在 20% 留存下,论文把构造模型和测试模型按分数区间、模型家族、时间三种方式错开。BestRand 在全部 5 个 OOD 设置中误差最低,平均 MAE 为 1.69,Random 为 1.95,ZipBench 为 2.19,TinyBenchmarks 为 2.36;相对竞争基线平均降低 21.8%。有意思的是,依赖历史分数学习的方法在分布偏移下反而不如 Random——拟合历史记录会过拟合。VLA 方面,Bench2Drive 上 BestRand-SR 把平均误差从 Random 的 1.99 降到 1.89(移除 50% 路线),从 2.84 降到 2.46(移除 65%);Fail2Drive 上从 2.56 降到 2.14,从 3.38 降到 2.88。进一步把成功率、驾驶分数、效率、平滑度四个指标一起匹配,Bench2Drive 的平均误差在 50%/65% 移除率下降到 1.47/2.00。附录还把基线扩到 15 个,在 12 个基准上 BestRand 总体 MAE 最低,且每个留存率都排前二。
还有一个稳定性证据。 附录表 16 在 12 个基准、每个留存率下都比较了 Random 和 BestRand 的 MAE 均值与跨种子标准差;BestRand 在每一格都同时更低。比如 HellaSwag 在 2% 留存下,MAE 从 2.67 降到 1.81,标准差从 1.50 降到 0.74。标准差下降可能比均值降一点更有意义——它意味着换一个随机种子,结论不会跟着晃。
第一,这篇论文最值得带走的不是 BestRand,而是它的问题设定。很多压缩方法一上来就优化平均误差,但用户真正感知到的是「某一次评测翻车」。平均 MAE 降 16.4% 听起来不算惊艳,高误差风险降 50.2% 才是质变:它把「偶尔得出错误结论」的概率压了下去。如果评测结果要用于模型选型、发布决策或对外报告,尾部风险比平均误差更值得盯。
第二,模型之间的相关性是评测噪声的结构性来源。我们习惯用更多模型、更多样本平均掉噪声;这篇论文说,只要模型共享 backbone、数据或蒸馏路径,共同位移就不会随模型数增大而消失。对做 leaderboard 的人来说,「多加几个同质模型」不等于更稳;要增加的是行为上真正不同的模型。这是等相关系数假设下的结论,现实中 会变,但方向值得警惕。
第三,BestRand 的工程美学是「选择而非学习」。不训练 predictor、不用 embedding、不需要全量历史分数;探针只在候选池上跑一遍,选子集在 CPU 上不到 0.1 秒。对算力有限的团队,这比训练一个 IRT/MLP 压缩器更友好,也更容易复现和审计。官方代码已经开源,配套数据可以在 CPU 上跑,这一点比很多「只给算法不给数据」的压缩论文实在。
第四,它也有清晰的边界。BestRand 不是零误差,探针推理也不是零成本;收益大小取决于 ——探针能不能解释目标模型的难度变化。换到一个全新领域,如果探针模型和目标模型的行为不相关,选择就会失效。论文的 OOD 实验覆盖了分数区间、模型家族和时间偏移,但 VLA 只测了 Bench2Drive 和 Fail2Drive 两个基准;机器人评测的多样性远不止于此,真实部署前最好先在自己的任务上验证探针的预测力。
第五,排名和分数是两件事。BestRand 把 MAE 降下来,但 Spearman 和 Random 几乎一样;如果你的目的只是判断「谁比谁强」,随机采样可能真的够了;如果你要报告「强多少」、做阈值判断,或者担心一次评测抽到坏子集,才值得为绝对误差和尾部付探针成本。这也正好呼应标题里的「almost」:随机采样几乎够用,剩下的那一点,取决于你要回答什么问题。
最后,从评测基础设施的角度,笔者建议压缩 benchmark 的报告里除了平均 MAE,也带上 P95 或高误差概率;最好固定并公开选中的子集,否则不同论文用不同子集算出的分数并不可比。BestRand 这类方法降低了「造一个压缩基准」的门槛,但门槛降低之后,评测协议的一致性反而更重要。
 道题、
 个模型,
 是模型
 在题目
 上的分数。随机抽一个大小为
 的子集
 ,子集均值
 与全量均值
 的差就是估计误差
 ;论文关心的主指标是所有模型误差绝对值的平均,即
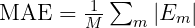 。
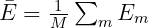 ,以及每个模型各自的残差。论文证明,在有效样本量不太小的条件下,误差向量近似零均值多元正态,而 MAE 一定不小于
 。于是,MAE 的长尾下界由共同位移的尺度
 控制:
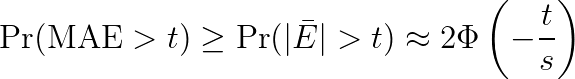
 是标准正态分布函数。
 越大,同样的阈值
 对应的尾部概率就越高。问题于是变成:什么让
 变大?在模型两两误差相关系数都为
 的简化假设下,
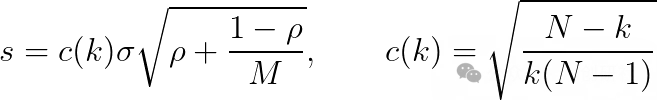
 是单个模型分数的标准差,
 是有限总体修正因子。
 越大,
 越大,长尾越厚。图 1 的数值实验和这个预测吻合得相当好:在 LLM、VLM、VLA 三类基准上,理论 MAE 分布与实测分布几乎重合;跨基准统计的
 最小 0.07、中位数 0.33、均值 0.35,全部为正。
 在各类基准上普遍为正(左下),且
 与共同位移尺度
 能高度解释 MAE 的 P95(右下)。图源:论文 Figure 1。*
 不是抽象参数。LLM、VLM、VLA 往往共享 backbone、训练语料,知识蒸馏还会让行为进一步对齐;它们容易在同一批题上一起对、一起错。只要相关性还在,共同位移就不会被平均掉。论文给出一个很刺眼的极限:固定
 、
 ,当模型数
 时,
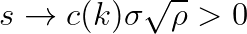
 很大时,MAE 分布的最低端是
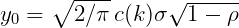 ,而分布的众数
 以
 的速率逼近这个下端点,其中
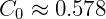 。也就是说,大多数随机子集的误差都挤在低端,随机采样高概率表现不错;但分布仍有一条右尾,少数子集会翻车。这就是标题里那个「almost」的来源。
 道题里随机抽一个大小为
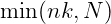 的候选池
 ,其中
 是池倍数;让
 个探针模型在
 上跑一遍,记录每道题的探针分数向量
 。
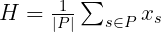 ,把它当作全量探针均值的近似。
 里随机抽
 个大小为
 的候选子集
 ,算每个子集的探针均值
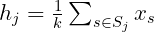 ,以及它和
 的 L2 距离
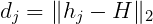 。
 最小的那个
 ,只在这个子集上评测所有目标模型。
 个候选的比较只是缓存向量求平均,不增加任何模型调用。候选搜索在 CPU 上并行执行不到 0.1 秒。默认配置是
 、
 、
 、L2 匹配;在 2% 留存下,构造成本只有依赖数据基线的 8.0%,平均为 51.3%。

 和
 分别是子集和全集的探针均值,
 是子集上的残差均值。最小二乘正交性让两部分不相关,方差分别是
 和
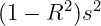 ;
 就是探针能解释的共同位移比例。
 。所以,只要让子集的探针均值贴近全集,就能压住这一项,而且不需要知道
 ,也不需要跑目标模型。BestRand 用池均值
 近似全集均值:
 控制参考准不准,
 控制搜索细不细。理想情况下,选中的共同位移方差会从
 降到
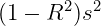 ;
 越大,收益越大。但残差项
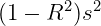 仍然在,所以它不是零误差。
 的速率逼近它,
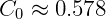 。
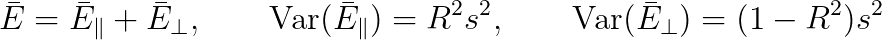
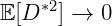 时,共同位移方差趋近
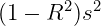 。
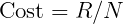 ,
 是观测到的模型-题目分数总数;
 相当于把一个模型在全量基准上评一遍。BestRand 在 Cost<1 时就已经优于 Random,而 SparseEval、TinyBenchmarks、ZipBench 等可学习基线通常需要 Cost≥1;达到同样的 MAE,它需要的成本也明显更低。平均构造成本为对比方法的 51.3%,2% 留存时只要 8.0%。消融方面,
 、
 、
 都有收益但边际递减,
 从 1 增到 8 提升最明显;探针选择和 L1/L2/L∞ 范数都不敏感(只有全用低分模型会明显变差);默认
 、
 、
 是性价比点。构造模型从 2 个增到 1000 个时,BestRand 在模型少时优势最大,模型多时仍与最强基线相当。
 会变,但方向值得警惕。
 ——探针能不能解释目标模型的难度变化。换到一个全新领域,如果探针模型和目标模型的行为不相关,选择就会失效。论文的 OOD 实验覆盖了分数区间、模型家族和时间偏移,但 VLA 只测了 Bench2Drive 和 Fail2Drive 两个基准;机器人评测的多样性远不止于此,真实部署前最好先在自己的任务上验证探针的预测力。
