系列:LangChain + LangGraph 工程实战
prompt 换个版本、检索换个分块尺寸、路由多接一家供应商,单测照过,升级后回答有没有变差却没人说得准。模型输出没有唯一正确答案,不能像函数返回值那样 assert 相等;同一批问题重跑一遍,分数上下动几个点,分不清是采样波动还是新版本把某一类问题答偏了。需将评测集与判定标准统一为固定基准,以消除实验变量,实现跨版本结果的因果归因。
LLM-as-Judge:用模型当考官
人工评测贵且慢,Ragas/DeepEval 的某些指标也是 LLM 驱动。LLM-as-Judge 的思路是:拿一个够强的模型,按 rubric(评分细则)给被测回答打分。
- 点对点(Pointwise):给单条回答打绝对分(如相关性 1–5、事实一致性 0/1)。
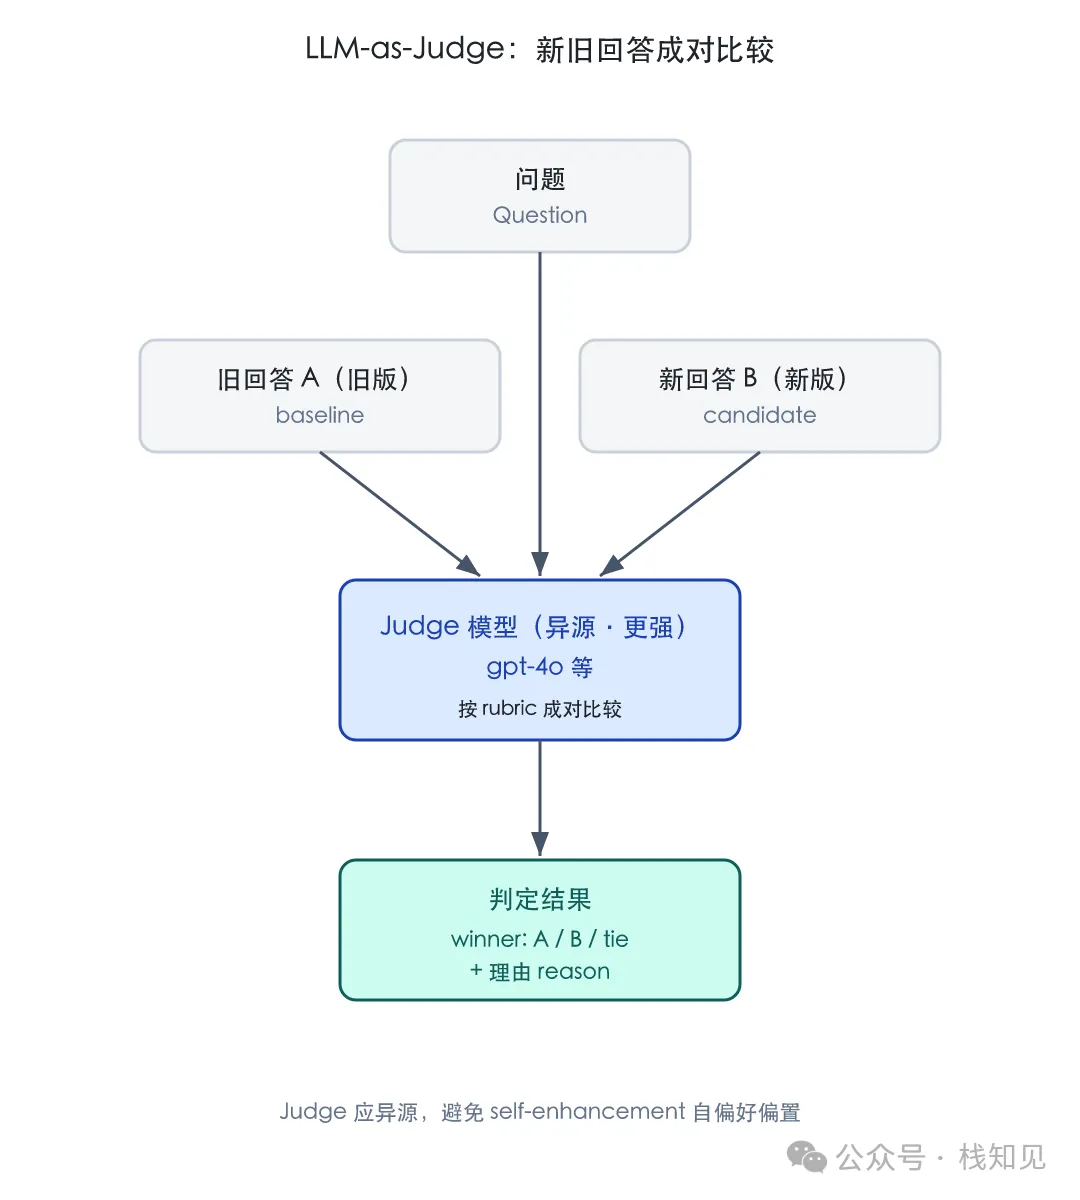
- 成对(Pairwise):拿新旧两个回答让 Judge 比"哪个更好",适合"改动前后对比"这种回归场景,比绝对分更稳(人/模型对绝对分尺度漂移大,对相对好坏更一致)。
LLM-as-Judge 最危险的是自我偏好(self-enhancement bias):用 A 模型生成、又用 A 模型评,它会偏向"像自己风格"的答案。所以我们一般会换一个异源、更强的模型当 Judge,并配置一份判定标准的 rubric;这是不是像极了我们的生活,不能又是球员又是裁判。
#成对 Judge:比新旧回答谁更好from langchain_core.messages import ( SystemMessage, HumanMessage,)from langchain_openai import ChatOpenAIfrom pydantic import BaseModelfrom app.config import settingsdef _build_llm(): # Judge 用异源、更强的模型,避开 self-enhancement bias return ChatOpenAI( model=”gpt-4o”, # 或可用的异源强模型 base_url=settings.openai_base_url, api_key=settings.openai_api_key, temperature=0, )class Comparison(BaseModel): winner: str# ”A” / ”B” / ”tie” reason: strjudge_llm = _build_llm().with_structured_output(Comparison)RUBRIC = ”””你是严格的评测考官。对比回答 A(旧版)与回答 B(新版):只依据【事实正确性】【是否紧扣问题】【是否含编造】三项判定。编造/事实错误的一方直接判负;都好则 tie。不要偏好更长或更客气的表述。”””def judge_pair( question: str, ans_a: str, ans_b: str) -> Comparison: return judge_llm.invoke([ SystemMessage(content=RUBRIC), HumanMessage(content=( f”问题:{question}\n” f”A:{ans_a}\n” f”B:{ans_b}” )), ])
with_structured_output 把 Judge 的判定以结构化输出 {winner, reason},这样比自由文本好消费、好做统计。rubric 里那句"编造直接判负"是关键。
Rubric 评测:把"好"拆成可打分项
泛泛的"回答质量"不好量化,要把"好"拆成独立可量的维度,每个配判给定一个标准:
- Faithfulness(事实一致性):回答是否全部能从给定上下文推出,无编造。Ragas 的 faithfulness 就是拆成"陈述点 → 逐点验证是否源自有据"。
- Answer Relevancy(相关性):是否正面回答问题,没跑题。
- Context Precision / Recall(上下文质量):检索回的片段里,相关的排前了没有、该有的有没有漏。
这些指标不用我们自己写,Ragas / DeepEval 已内置封装,直接对数据集进行判定。但rubric 必须和业务对齐:客服 Agent 的"安全性"权重高于"话术"。
回归平台:黄金集按 commit 存快照,改动才有得比
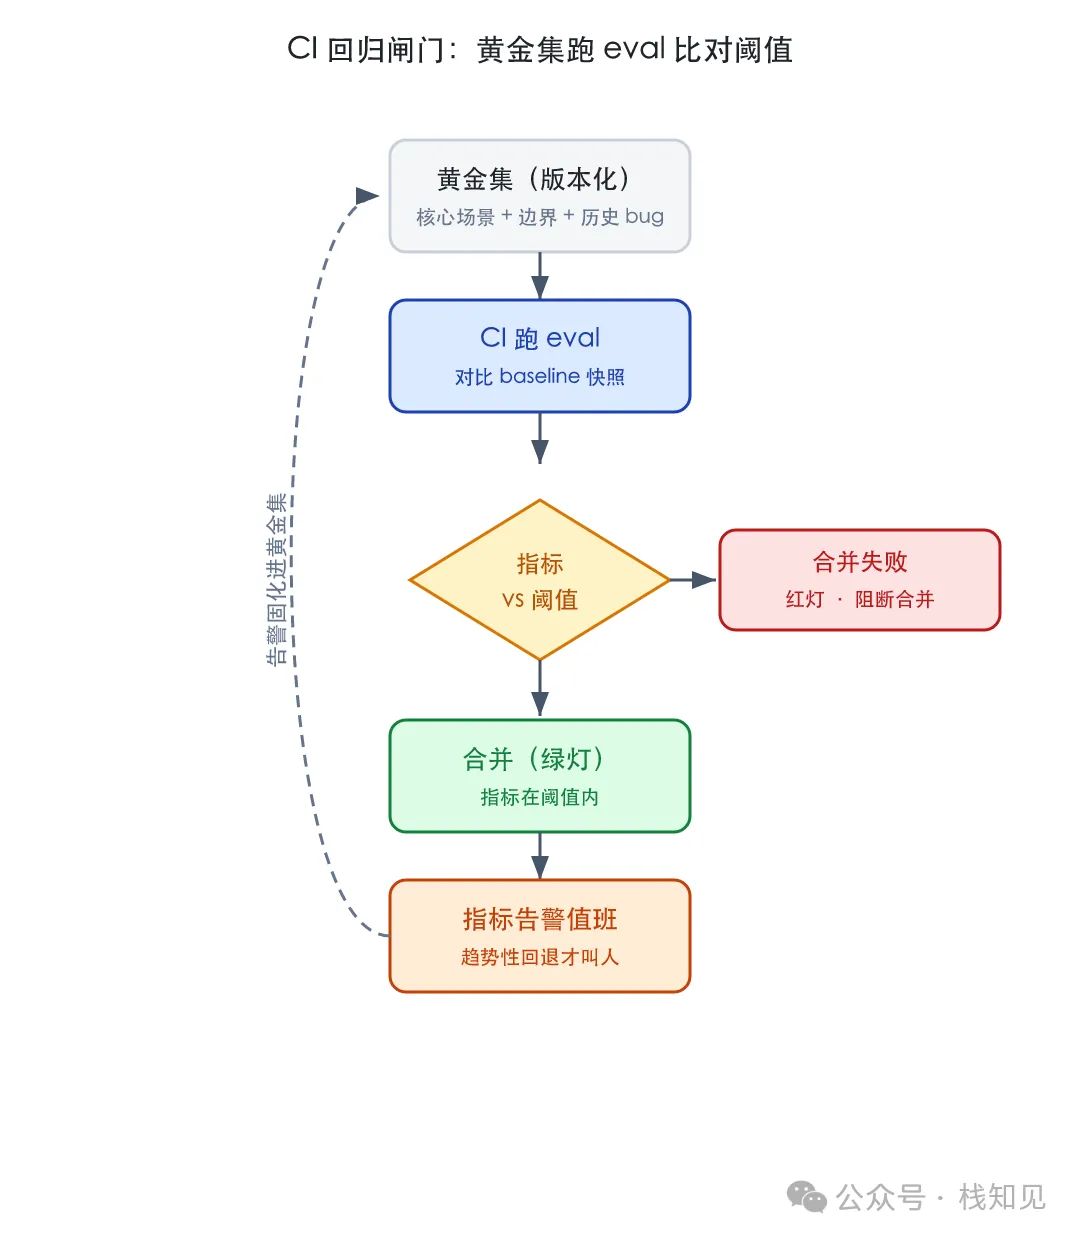
评测要可复现,必须对数据集版本化管理。构建一个"黄金集(golden set)":几百条覆盖核心场景、边界输入和历史 bug 固化样本,每条含 {问题, 标准上下文/标准答案, 维度期望}。每次改动前跑一遍,产出指标快照文件,git commit 时以当前日期作为版本号。
一份黄金集的价值甚至比Agent代码的价值都要高,因此数据集我们要像代码一样进行管理:增删改必须走 PR,守住数据集的权威,防止"为了过 eval 偷偷挪低标准"。
CI 跑 eval:把闸门焊在合并前
本地/手动跑的 eval 改成生产化要做成 CI 卡:PR 提上来,流水线自动跑黄金集,和 baseline比,关键指标回退超阈值就让 CI 红、阻断合并。
# pytest 里跑回归,超标即失败import pytest# 来自 main 分支快照BASELINE = {”faithfulness”: 0.92, ”answer_relevancy”: 0.88}REGRESS_THRESHOLD = 0.03# 允许 3% 内波动,避免噪声误杀@pytest.mark.evaldef test_no_regression(): # 跑黄金集,返回各维度均值 report = run_golden_set() for metric, base in BASELINE.items(): got = report[metric] drop = base - got assert drop <= REGRESS_THRESHOLD, ( ( f”{metric} 回退 {drop:.3f}(base={base},” f” got={got}),超过阈值 {REGRESS_THRESHOLD}” ) )
单测可以使用 mock LLM,但eval 这层必须要用真实模型,否则测不出质量。REGRESS_THRESHOLD 留 3% 缓冲——eval 本身有随机性,卡太死会"假阳性阻断",卡太松又放过了真回退,这个值需要根据历史波动做调整。
指标告警:从"报告"到"值班电话"
eval 快照和线上指标要上看板、接告警,CI 日志留档:
- 离线指标(faithfulness、relevancy):每次评测后写进看板,通过趋势线一眼就能看出"哪次提交开始掉"。
- 线上指标(Langfuse 的延迟、token、错误率,越狱拦截率、PII 命中率):设阈值告警。
- 成本指标:每 token 成本、缓存命中率跌破基线也需要接入告警。
下一篇 → 前端协同与 Agent 协议全景