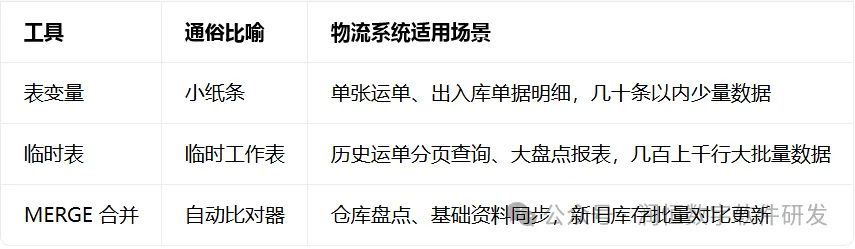
大家好。很多客户日常使用物流进销存系统,关注点大多在:录单快不快、查询历史运单卡不卡、盘点库存会不会出错。很少关心系统后台是怎么处理这些数据的。
同样是临时存放数据,后台会根据数据量、业务场景,选择不同的处理方案。在开发这套轻量级物流进销存系统时,我最常用到三类工具:表变量、临时表、MERGE 合并语句。
不用记复杂专业名词,今天用大白话聊聊三者的区别,结合咱们物流业务场景举例,看看分别适合什么情况。
PS:代码仅作为技术参考,非技术朋友可以直接跳过代码部分。💡一句话理解:一张临时小纸条,用来临时存放一小批数据,任务结束自动销毁。
✅适合场景:数据量少
👉【业务实例】当你新增一张运单,录入货物明细。一张运单一般就十几、几十条货物记录。系统后台就会用表变量临时承载这张运单明细,完成校验、保存后自动释放资源,轻快无负担。
❌不适合:一次性几百上千行的大批量数据,例如历史运单分页查询、大盘点报表。
--存放单张运单的明细数据DECLARE @运单明细 TABLE( 物料编号 INT, 物料名称 NVARCHAR(100), 数量 DECIMAL(18,4));
业务小结
单张运单、出入库单据这种少量明细,用 “小纸条” 表变量,轻便高效,不会多余消耗数据库资源。
二、临时表:分页查询、大盘点报表的首选
✅适合场景:数据量大的场景!
👉【业务实例】你在系统筛选过去半年全部运单记录,符合条件的数据可能有几百上千条。系统不会一次性把全部数据丢到页面上,而是先把筛选结果放进临时工作表,再做分页,只展示当前页面的几十条记录。这就是分页查询为什么大多依赖临时表。
为什么分页查询大多要用临时表?如果直接在原始大表里分页读取,数据库压力大,查询容易卡顿。先把符合条件的数据放进临时表,再分页读取,查询更稳定,翻页速度更可控。
❌不适合:仅仅几十条的单据明细,属于 “杀鸡用牛刀”。
--临时工作表,用于历史运单分页查询CREATE TABLE #临时运单表( 运单号 NVARCHAR(50), 客户名称 NVARCHAR(100), 发货时间 DATETIME, 货物数量 DECIMAL(18,4));
只要页面需要翻页查看大批量历史记录、大盘点报表,后台基本会使用临时表。✅适合场景:盘点、基础资料同步,新旧数据批量比对。
👉【业务实例】仓库盘点,导出现场实盘数据。系统拿盘点结果,和系统现有库存批量比对;同时入库保存时,也会用这个逻辑自动更新库存:该物料批次已有库存就累加数量,新物料批次自动新增库存记录。系统已有物料 → 更新库存数量;系统没有的新物料 → 自动新增库存记录。一次操作完成批量库存更新,不用一条一条处理。
补充技术小结:
在低并发场景,MERGE 搭配锁提示使用,代码会非常精简。不用写一堆「判断数据是否存在,存在就更新,不存在就新增」的分支代码,一条语句搞定新增 + 修改。
像小游戏存档、单机台账这类很少多人同时修改同一条数据的场景,用起来很省心。
而在物流这种多用户并发操作库存的业务场景,我会搭配UPDLOCK更新锁,用来规避并发下库存脏数据问题,保障库存计算准确。
❌不适合:简单新增单据、单条记录修改。
--一小段入库提交同步实时库存源码--------------------------------------MERGE INTO tb_sel_store_time WITH(UPDLOCK) AS targetUSING (SELECT b.item_id, b.qty,spec,batch_no,unit_id,goods_typeFROM tb_store_in_m aINNER JOIN tb_store_in_d b ON a.id = b.m_idWHERE a.ID=@new_id ) AS srcON target.c_id = @c_id AND target.s_id = @s_id AND target.item_id = src.item_idAND target.spec = src.specAND target.batch_no = src.batch_noAND target.unit_id = src.unit_idAND target.goods_type = src.goods_typeWHEN MATCHED THENUPDATE SET qty_in = qty_in + src.qty, qty = qty_in - qty_out + src.qty, sys_update_time = GETDATE()WHEN NOT MATCHED THENINSERT(c_id, s_id, item_id,spec,batch_no,unit_id,goods_type, qty_in, qty_out, qty, sys_update_time)VALUES(@c_id, @s_id, src.item_id,src.spec,src.batch_no,src.unit_id,src.goods_type, src.qty,0, src.qty, GETDATE());
后记:聊聊我的开发思路
我是自学起步的独立开发。在搭建这套物流进销存系统时,所有的数据处理方案,都是结合真实业务场景反复调试优化出来的。
最开始开发的时候,不分数据量大小,全部用同一种方式处理。小单据没问题,可一旦客户做大盘点、翻页查询大量历史运单,页面加载卡顿,性能体验很差。
慢慢摸索之后总结出这套思路:数据规模不一样,就要匹配不同的数据处理方式。
- 仓库盘点、入库库存批量比对,用 MERGE 减少循环操作,降低数据出错风险。
一套好用的系统,不只是功能能跑通。同样的功能,选对后台处理方案,查询更快、大数据场景更稳定,减少数据异常的隐患。
如果你正在选型流管理软件、仓储管理系统,或是现有系统存在查询慢、盘点容易出问题,欢迎随时交流。
如需物流管理软件、仓储系统定制,欢迎点击下方【阅读原文】联系交流。