Agent 评测方法论综述
- 更新时间 2026-11-10 19:21:34
当前 AI 与 Agent 评测是研究热点,相关 benchmark 数不胜数,但系统性的方法论讨论较为少见。本文在阅读多篇评测论文的基础上,提炼出一套完整的 Agent 评测思路,形成这篇综述。
本文聚焦基模评测,重点讨论 Agentic 任务的评测方法。这类评测与业务流程评测有较大区别。业务评测衡量的主要是 AI 输出与特定业务规则的契合度,因为业务目标通常是明确的,评测题目和答案都容易构建。基模评测关注的则是模型本身的能力边界,而模型能力可以从无数角度衡量,所以它是一个更开放的命题。正因如此,基模评测在题目设计、评分标准、结果分析等环节都需要更严谨的方法论支撑。
评测对象的精确界定
基模评测的目标虽然是测试模型能力,但实际评测中往往会混入其他因素。一个 Agent 系统可以分解为 model + harness,其中 model 是基础模型,harness 是围绕模型构建的工具调用、记忆管理、多轮对话等基础设施。因此需要先明确评测对象。当前的评测工作可以分为以下几类。
这个分类决定了评测结果能够说明什么。如果使用固定 harness,不同模型之间的分数差异主要反映模型的 agentic 能力差距。如果 model 和 harness 同时变化,就需要通过控制变量实验拆解两者的贡献。如果直接评测厂商产品,结果则是模型、harness 与产品交互设计的综合体现,很难归因到具体的能力维度。
评测的本质
从第一性原理来看,评测就是验证模型或 Agent 在特定能力维度上的表现。具体而言,评测让被测对象完成一系列精心设计的测试任务,收集执行结果,再通过统计分析找出能力缺失点,从而为下一代模型的改进提供方向。
这个定义隐含了评测工作的基本结构。首先要明确评测的能力维度,然后围绕这些维度设计题目,并确保题目本身的质量;接着设计可靠的评分机制,为模型提供稳定的运行环境并完成测试;最后深入分析结果,把表现归因到具体能力。下文沿着这个结构逐一展开。
评测维度的定义
评测的第一步是明确想要测试什么能力,这一定义决定了后续所有环节的设计方向。
常见的评测大类包括 long-horizon 执行能力、multi-agent 协作能力、代码能力、GUI 操作能力等,每个大类还可以进一步细分。以代码能力为例,它可以分解为代码补全、调试、安全攻防、大型仓库处理、从零构建项目等子维度。维度定义得越具体,题目设计的目标就越明确。
定义维度时需要考虑三点。第一,这个能力在实际应用(包括业务场景)中是否重要。第二,它能否被清晰地定义并设计成题目。第三,它与其他维度是相互独立,还是存在依赖。
以 long-horizon 能力为例,它通常依赖多个基础能力的组合,也是 coding 能力的重要一环。Agent 需要规划多步任务,在每一步执行后根据环境反馈调整策略,维护跨步骤的状态信息,并在出错时恢复。因此,如果一个模型在代码理解、工具调用、错误诊断等基础能力上就表现不佳,那么它在 long-horizon 任务上的失败很可能来自这些基础能力的缺失,而不是长程规划能力本身。这种依赖关系会直接影响后续的失败归因。
题目的设计
定义好评测维度之后,下一步是围绕这些维度构造题目。题目设计包括三个相互关联的问题,即题目从哪里来、题目如何构造、题目的分布如何设计。数据来源会约束构造方式,构造方式又会影响最终的题目分布,所以三者需要统一考虑。
数据来源
题目的原始材料主要有五类来源。
第一是公开数据。GitHub 上的真实代码仓库、StackOverflow 上的问题、公开的技术文档等都可以作为评测材料。这类数据容易获取,任务本身也来自真实场景,因而具有较强的生态效度。但是,现在的模型可能在预训练阶段已经见过这些内容,所以使用公开数据时,可能还需要设计额外的实验,验证模型是否在“背题”,而非真正具备对应能力。
第二是私有数据。大公司内部积累的业务数据、代码库和工作流程经过脱敏后,可以用于评测或训练。这类数据通常能够保证模型没有见过,质量也相对可控。
第三是专家构造,即邀请对应领域的专家专门设计评测题目。金融建模、3D 生成、医疗诊断等专业领域的评测通常采用这种方式。专家构造的数据质量最高,能够准确覆盖目标能力,但成本高昂,难以批量生成。
第四是虚构知识。CL-bench 让专家虚构全新的法律体系和编程语言,或者改写已有事实,从源头保证相关知识不在预训练数据中。这种方法排除了数据泄露问题,但构造成本极高,而且虚构知识与真实应用场景之间存在一定距离。
第五是程序生成,即通过程序自动生成答案已知的题目。例如 LHTB 2.0 的 reconstruction 任务让真实软件在多组参数下运行,公开一部分输入输出样例,保留另一部分用于评分。这种方法可以批量出题,答案准确性也有保障,但题目的多样性和真实性往往不如人工构造的题目。
AI 也可以用来生成题目,但需要处理 self-bias 问题。Xu 等人(Google / ETH Zurich,EMNLP 2026)把“模型出题、模型评分”的做法称为 LLM-as-a-benchmark,并发现这样得到的题集会系统性地有利于出题模型本身。原因在于,如果出题模型和答题模型是同一个模型,二者的概率分布相近,生成的题目往往更符合它自身的语言风格、知识结构和推理偏好。为了缓解这个问题,人类需要在模型出题之前给定明确的出题标准,约束题目要覆盖哪些类型、满足哪些要求,避免模型完全自由发挥。同时还要控制题型的多样性,避免大量题目集中在模型最擅长生成的模式上。
题目构造
有了原始材料之后,需要把它转化为能够测到目标能力的题目。这个过程的核心是定义 Input 和 Output,也就是针对想要考察的能力,Agent 应该看到什么样的 Input,又应该在什么地方、以什么形式产出怎样的 Output。
Input 设计的第一个问题是信息披露的粒度。
如果披露得非常详细,比如直接列出需要修改的文件、函数、问题根因和交付格式,就相当于把大部分解题步骤告诉了模型,原本想考察的许多能力也就无从体现。反过来,如果披露得过于粗略,模型又可能缺少完成任务所必需的信息。
粒度的选择取决于评测想要考察什么。如果评测本身希望考察模型在信息不充分时澄清需求、探索环境、理解隐含意图的能力,题目就应该有意省略部分信息。WorkBuddy Bench 强调任务应该是“an intent and a constraint, not a specification”,有意省略目标文件、问题根因、具体接口和实现方案,让澄清需求、探索 workspace、寻找隐藏 context 成为任务的一部分。NL2Repo-Bench 则提供了平均约 18800 tokens 的详细规格文档,包含目录结构、依赖和 API 签名。软件工程可以理解为从 intent 到 specification、再到 implementation 的过程(nju jyy),而 NL2Repo-Bench 主要测量的是从 specification 到 implementation 这一环节,并不覆盖从 intent 到 specification 的过程。
GDPval 在这方面的做法值得参考。它意识到 prompt 是否说清楚本身会严重影响模型表现,因此请领域专家评估每个 prompt 的 Task Specificity,结果约 89% 的任务被评为 well-specified,约 8% 欠说明,约 2% 过度说明。之所以交给专家判断,是因为一个 prompt 是否 well-specified 很难仅靠形式规则判定,往往依赖大量领域经验和上下文。在此基础上,GDPval 又设计了 Under-contextualized 实验,删去“数据在哪里、应该怎么处理、最终格式要求”等信息,使 prompt 平均只剩下原来约 42% 的 token。结果模型表现明显下降,这说明 Agent 在澄清需求和探索信息方面还做得不够。
Input 设计的第二个问题是信息的提供方式。
最直接的做法是把所有信息写进 prompt,也有一些 benchmark 把部分信息放在 workspace、文件或环境状态中,让模型自己寻找。π-Bench 的设计比较特殊,它在评测环境中构造了一个模拟用户。当 Agent 发现自己缺少完成任务所需的信息时,可以主动向模拟用户提问,再根据回答继续完成任务。这样一来,“主动发现信息缺口并询问”本身也成为被评测的能力。
Input 设计的第三个问题是完备性检验。
有一部分题目的问题出在任务本身。典型的情况是题目没有规定某个具体实现细节,评分器却要求必须符合某个固定标准,也就是 instruction 与评分标准没有真正对齐。
WorkBuddy Bench 的部分任务就出现过这类问题。题面只要求完成某项功能或输出某类分析,并没有规定具体的字段名、函数名或实现结构,但 hidden verifier 会继续检查这些具体形式。Security 任务中甚至出现过题面明确要求输出 idea 字段、评分器实际读取的却是 exploit_idea 的情况。这样一来,Agent 即使完全按照题面作答,也会因为一个无法从 Input 中得知的字段名而失分。代码任务中同样常见这类问题,题面只要求“实现某个功能”,测试代码却依赖某个固定的 API 名称或内部结构。如果这些要求无法从 instruction、workspace 或其他可见信息中推导出来,这道题的评分可信度就有很大问题。
检验 Input 完备性是评测 benchmark 最基础也最必要的工作。一个评测工作做得好不好,重要的不是是否有一群天才和一堆令人惊叹的好点子,而是做评测的人思维是否足够严谨、做得是否足够扎实。如果题目本身存在重大问题,就无法据此评价考生的能力。
题目分布
评测题目通常是一整组,因此设计时还必须考虑整套测试集的分布。这里的分布既可以指难、中、易的分布,也可以指不同领域、任务类型、软件或能力维度的分布。
题目分布会直接影响最终结果代表什么。以一套 Office 能力测试为例,如果题目极端偏向 Word 操作,那么一个擅长 Word、但不擅长 PPT 和 Excel 的模型,可能会胜过一个三方面都比较均衡的模型。此时最终分数更接近 Word 操作能力,很难代表整体 Office 能力。
分布如何设计,取决于这套 benchmark 想表征真实世界中的什么能力。
ALE 和 GDPval 关注的是 Agent 能完成多少现实世界中人类可以完成的工作,因此题目分布尽量参考真实的人类工作和职业结构。GDPval 参考 GDP 与工资总额来确定不同职业的权重,ALE 参考 O*NET 职业分类来设计任务分布。
还有一些 benchmark 会围绕某个研究问题主动划分题目。NL2Repo-Bench 希望观察“从零构建仓库”的表现如何随项目规模变化,因为“项目规模与模型表现之间是什么关系”本身就是它想回答的问题之一。所以,它按原仓库代码行数把 104 道题分为三档:Easy ≤1,500 LOC(26 题)、Medium 1,500–4,000 LOC(46 题)、Hard ≥4,000 LOC(32 题)。实验结果显示,随着项目规模增加,模型表现明显下降,Claude Code + Claude-Sonnet-4.5 在三档的平均测试通过率分别为 51.8%、44.5%、25.1%。
SWE-bench Verified 采用了类似策略。标注员会估计“开发者决定并实现方案需要多久”,并分为 <15 分钟、15 分钟–1 小时、1–4 小时、>4 小时四档。构建题组时会更多保留后两档,从而让 benchmark 保持足够的挑战性。
题目的难度分布也未必需要事先完全确定。Humanity's Last Exam(HLE)把每道候选题先交给前沿模型(GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro、o1 等)作答,任何一个模型答对就拒收。筛选阶段记录了 7 万余次尝试,约 1.3 万道题通过,再经两轮专家审核与公开纠错,最终敲定 2500 题。Long-Horizon-Terminal-Bench 1.0 则用 DeepSeek-V4-Pro 在 1.5 小时预算下反复运行,并根据模型表现持续调整题目,直到题目达到“有挑战但原则上可解”的要求,120 道候选题最终保留 46 道。这类 benchmark 先构造候选题,再根据前沿模型的实际表现筛选和调整难度,所以最终的题目分布是在构造和测试过程中逐步形成的。
确定题目分布之后,还需要追问这样的分布为什么能够代表我们真正想测的总体。
一种常见做法是锚定外部数据。前文提到的 GDPval 和 ALE 即属此类,WorkBuddy Bench 则参考生产环境中聚合得到的任务类型与难度分布。这样一来,benchmark 的题目空间就和某个现实总体之间建立了可以解释的映射关系。
另一点是总分的加权方式。按题平均时,题目更多的领域自然拥有更大的权重。ALE 中 Engineering 题目较多,所以整体 pass rate 也更多地受 Engineering 表现影响。GDPval 每个职业固定 5 题,因此最终结果更接近“不同职业等权平均”下的模型表现。
所以,判断一个 benchmark 的分布是否合理,还要看题目的数量比例最终代表了什么。无论均匀分布还是有所侧重,都需要回到 benchmark 希望代表的总体,以及最终希望如何解释这个分数。
题目质量的检验
完成题目构造之后,还需要检验题目本身是否成立。许多 benchmark 在这个环节做得非常不扎实,但它恰恰是保证评测结果可信的关键。题目质量检验主要关注三个问题。
Task Validity:题目真的测到了声称想测的能力吗?
一道题可能看起来符合某个能力的定义,实际测到的却是完全不同的东西。
LHTB 2.0 声称评测 Agent 的 long-horizon execution 能力,但其中的 Reconstruction Tasks 主要要求 Agent 根据若干输入输出样例,逆向推断未知程序或科学工具的行为,再自己实现程序并通过隐藏测试。因此,这类任务的难点可能大量来自归纳推理、逆向工程、代码实现与调试,与 long-horizon execution 考察的不是一回事。论文本身也提到,部分任务可以在相对有限的交互步数内完成。GPT-6 Astra 成功完成 Reconstruction Tasks 时,中位数约为 37 个 Agent steps,即使把上限限制在 50 steps,它也能解决其中相当一部分任务。所以,仅凭任务允许 Agent 运行数小时,或者任务看起来比较复杂,并不足以证明它测到的是 long-horizon 能力。
要讨论这一点,需要先定义 long-horizon task。它通常要求 Agent 在一次任务中持续完成大量相互依赖的步骤。每一步操作都会改变环境状态,后续决策又依赖这些已经改变的状态。早期错误可能在若干步之后才暴露出来,因此 Agent 需要能够追溯问题、修正策略并恢复执行。这与单纯把一个复杂任务分解为多个独立子任务有本质区别。
按照这个定义,要更有力地证明一组题目测到了 long-horizon 能力,还需要说明任务表现确实依赖长程状态维护、跨阶段依赖、错误累积与恢复等能力。例如,当这些长程因素被削弱或移除之后,模型表现应该出现明显变化。否则,最终分数可能更多反映的是模型综合的 coding 和 reverse-engineering 能力。
Data Leakage:模型是否在预训练中见过题目?
第二个问题是数据泄露。如果模型在预训练阶段已经见过题目或答案,高分可能只反映记忆能力,而不是真正的任务能力。
降低这一风险通常有三种方法。
1. 使用足够新的数据。 优先选择模型知识截止时间之后才产生或公开的信息。
2. 使用冷门数据。 选择传播度和曝光度较低的数据,降低其进入训练语料的概率。
3. 对已有数据进行二次构造。 修改实体、数值、关系、条件、代码结构等,生成网络上原本不存在的新任务。
除了事前降低泄露概率,还可以通过实验判断模型是否可能见过题目。
●原题识别实验。 将原始内容与若干同样合理的扰动版本混在一起,让模型判断哪个是原始版本。如果识别率显著高于随机水平,说明模型可能对原始内容存在特殊的熟悉度。
●Counterfactual Twin。 为原题构造结构和难度相近、但实体、数据或事实全部替换的新题。如果模型在原题上的表现显著优于同构的新题,就可以怀疑存在记忆污染。
●熟悉度对照。 比较模型表现出熟悉感的题目与没有表现出熟悉感的题目的准确率,具体做法可参考我的评测项目。
●去除关键信息的对照实验。 CL-bench 去掉 context 后,约 1,000 题中只有 9 题通过。
Solvability:题目是否可解?
第三个问题是可解性。题目可能因为设计缺陷,导致即使人类专家也无法完成。
最常见的缺陷是 Input 信息不完备,即题面没有提供完成任务所需的关键信息,评分器却期望某个特定结果。前文讨论 Input 完备性时提到的 WorkBuddy Bench 字段名不一致,就是典型的可解性缺陷。这是一个非常基础的问题,但许多著名开源评测论文的题目都存在这种情况。
另一类缺陷是环境配置错误。题目依赖某个特定版本的库或工具,而评测环境中的版本不匹配,所以即使代码逻辑正确也无法通过测试。NL2Repo-Bench 的做法是在构造题目时记录原始仓库的依赖版本,并在评测环境中通过环境快照严格复现。
验证题目是否可解,通常有以下几种方法。
1. 人工试做。 让人类评审员在与 Agent 相同的题目要求和可见信息下完成任务,验证任务能否被正常解决。
2. 评测前试跑。 在 benchmark 正式发布或大规模运行之前,用模型或 Agent 反复测试,尽早发现无法完成、环境异常或评分不稳定的题目。
3. 参考解(oracle)运行。 将参考解放入完整的 hidden tests 中运行,确认它能够稳定得到满分。LHTB 2.0 把“参考解可复现地达到 R=1.0”列为题目入选条件。反观 LHTB 1.0,根据仓库 Issue #7,作者重新运行 oracle 后,46 道题的平均得分只有 0.7353。
4. 检查 instruction 与 verifier 是否一致。 逐条检查评分器要求的内容,确认它能否从 instruction 和 workspace 中推导出来。SWE-bench Verified 让 3 名标注员独立审查,只要任何一人认为存在问题,就会进一步处理。审查发现,38.3% 的任务描述信息不足,61.1% 的单元测试可能把正确解判为错误,所以最终删除了 68.3% 的候选题,只保留 500 题。LHTB 2.0 则使用 DeepSeek-V4-Pro 辅助进行这类审查。
5. 平凡解测试。 空提交、什么都不做或仅仅创建一个文件,理论上都应该得到接近 0 的分数。如果这类几乎没有完成任务的行为也能获得较高分数,评分本身就失去了区分度。LHTB 2.0 的 reconstruction 任务中,只要写出 reconstruct.py,即使所有 hidden 场景都没有通过,也可能获得 0.5–0.67 的分数。论文报告 30 道 reconstruction 题的二值分数平均为 0.221,阶梯分数平均却为 0.653,这说明 partial reward 中有大量分数与真正完成任务关系较弱。
这些检验方法或许大家都知道,但能把这项技术性工作做得非常扎实的,确实少之又少。
评分机制的设计
评分机制需要准确、稳定、可复现地判断 Agent 是否正确完成了任务。
能用代码客观验证的,就尽量用代码验证。只有当任务涉及视觉判断、复杂操作结果等难以用规则直接判断的内容时,才考虑使用 LLM-as-Judge。除了使用通用大模型,还可以通过 post-training 专门训练一个评分模型。GDPval 在实验中训练了专门的 automated grader,它与人工评分的一致率约为 65.7%,而人类评审员之间的一致率约为 70.8%。这个 grader 还无法完全替代专家评分,但它说明,专门训练的 grader 可以在大规模评测中承担一部分自动化评分工作。
使用 LLM-as-Judge 时应当尽量减少开放式判断。与其直接问“你觉得做得怎么样”或“1~10 分你打几分”,更好的做法是把评分标准拆成明确的二值问题,例如“该网站页面是否存在表单”“文件中是否包含要求的三个字段”。这样可以尽量减少 Judge 自由解释 rubric 的空间。
然而,评分器能够运行,并不意味着它给出的分数可信。接下来还需要验证评分结果是否真的对应任务完成情况。
这个验证过程关注的是 Outcome Validity。
以一个简单的 coding task 为例。任务要求给项目增加“删除账户”功能,benchmark 的评分方式是运行 5 个 hidden tests,全部通过即为 success。这里真正需要验证的是,“5 个测试全部通过”是否等价于“删除账户功能已被正确实现”。
我们可以把这个问题理解为两个集合。一个集合是按照任务本身的要求真正应该判为正确的结果,另一个集合是评分器实际会判为通过的结果。理想情况下,两个集合应该尽可能重合,二者之间的偏差则表现为以下两种错误。
一是评分器放过了本不应该通过的答案,也就是 False Positive。比如 Agent 通过 hard-code 特定输入绕过测试,使 hidden tests 全部通过,但实际功能根本不可用。如果 Agent 是有意利用评分规则的漏洞拿分,就进一步构成了 reward hacking。
二是 Agent 实际已经正确完成任务,grader 却因为额外要求某个特定函数名、文件路径或字符串格式而判定失败,也就是 False Negative。典型的情况是题面只要求“实现某个功能”,测试代码却依赖某个固定 API 名称或内部结构,即前文所说的 instruction 与评分标准未对齐。
Outcome Validity 要回答的,就是评分器给出的结果在多大程度上对应任务是否真正完成。检验与保障方法包括以下几个方面。
1. 评分规则尽量检查真实的任务结果,避免对具体实现方式施加额外假设。
2. 隔离评分环境,避免 Agent 利用 grader。
3. 评测人员使用 coding agent 主动攻击评分器,通过成对变异测试验证其区分能力。一类变异保持结果不变、只改变实现方式,评分应当不变;另一类则寻找任务未完成却能通过测试的办法,评分应当拒绝。
如果使用 LLM-as-Judge,还要额外验证什么?
相比代码 verifier,LLM-as-Judge 又引入了一层模型自身的不稳定性和偏差,因此需要额外做几类验证。
第一,Judge 的稳定性和 Bias
可以把同一批答案交给多个 Judge 模型评分,观察结论是否稳定。如果更换 Judge 模型后,benchmark 排名或者大量样本的通过与失败发生变化,那么最终结果就明显依赖评分模型本身。
但是,只比较多个 Judge 之间的一致率可能还不够,因为多个模型可能同时具有同方向的系统性偏差。所以还需要针对常见 bias 做受控实验。例如,互换候选答案 A/B 的位置,检查是否存在 Position Bias;在不增加有效信息的情况下单纯扩写答案,检查是否存在 Verbosity Bias;比较 Judge 对自己、同系列模型以及其他模型生成内容的评分,检查是否存在 Self-preference Bias。具体需要做到什么程度,可视情况而定。
第二,Judge 与人工判断是否一致
可以抽取一定数量的样本,让领域专家独立评分,再以人工结果为校准依据,与 Judge 的结果比较。
这里不能只报告一个整体 accuracy,因为原始样本分布会严重影响这个数字。假设 95% 的答案本来就是正确的,那么一个永远判断“通过”的 Judge 也能得到 95% 的一致率。因此,更有意义的做法是分别统计 False Pass 和 False Fail,观察 Judge 更容易把哪一类样本判错。
此外,还可以检查 Judge 给出的评分理由,判断错误究竟来自事实识别失败、rubric 理解错误,还是评分标准本身存在问题。
第三,Judge 正式使用之前要做前测
Judge prompt 写好之后不应直接投入正式评测,而应先在一批答案已知的样本上测试。测试集至少应包含明确正确的状态、明确错误的状态、容易与正确状态混淆的 hard negatives,以及一些边界案例。只有 Judge 能够稳定区分这些情况,才能用于正式评分。
OSWorld 2.0 采用了类似的做法。对于需要模型判断的 checkpoint,它尽量使用客观的 binary checklist。每个 Judge prompt 都要先在人工标注的正确状态和容易混淆的错误状态上测试,并且在所有支持的 Judge 模型上都能持续判断正确,才会正式投入使用。
评测基础设施的设计
评测基础设施要解决的是如何安全、高效、可扩展地运行大量 Agent 评测任务。Agent 需要与环境交互,执行文件读写、代码编译运行、网络请求、系统命令等操作,这些操作既不可预测,又可能存在风险。因此,基础设施的设计直接决定了评测的可靠性和执行效率。
一、任务环境怎么构建?
按 Agent 需要执行的任务复杂度,评测环境可以分为以下几个层级。
注:L1 测的是 base model;从 L2 开始测的是 Agent 能力,harness 成为影响结果的变量。
每个评测任务都可以归入其中某一层,再根据实际情况选择所需的沙盒环境。沙盒环境可以参考 DSec 的分层思路。
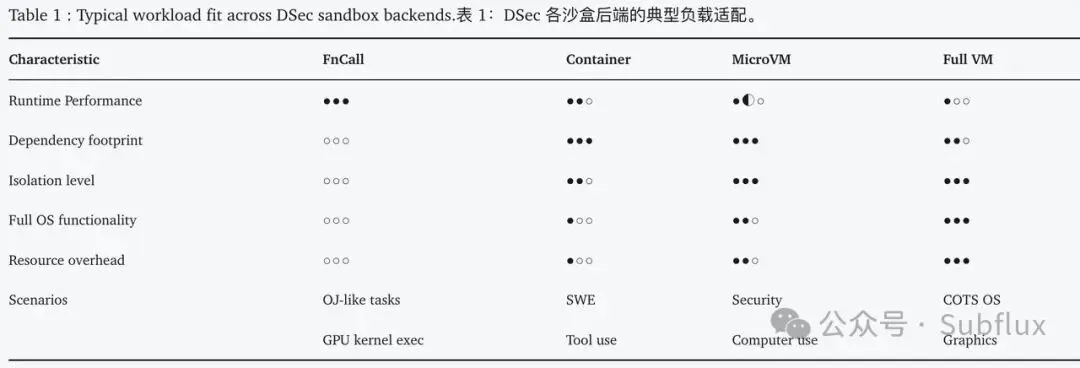
从前到后,各层的隔离强度不同,Agent 能够操作的权限也不同。这里的权衡在于,更强的 isolation 和更完整的 system functionality 通常意味着更高的启动延迟和资源开销。因为没有一种 sandbox 能覆盖所有 Agent workload,DSec 论文提供了四种 backend。
FnCall 使用可复用的、预先创建好的 GPU 和 CPU 环境,把函数放进这个环境中运行并返回结果,适合短时、无状态的任务。
Container 常用于软件工程评测以及一些需要工具调用的测试。它启动快,单机可以容纳很多实例,因此适合 SWE benchmark。但是,container 共享 kernel,遇到 security-sensitive workload 时隔离性不足。
如果既需要更好的隔离性,又不愿承担完整虚拟机的巨大开销,可以使用 microVM。每台 microVM 都有完整的 guest kernel,主要用于 security-sensitive task、需要 strong tenant isolation 的场景,以及需要 VM boundary 但仍以 Linux 为主的 workload。
最重的一层是完整的 VM,主要服务于 QEMU Android VM,或者需要浏览器、GUI、图形渲染的 computer-use 环境。
了解基本的环境概念之后,如果继续深入,还会面临一系列工程问题,包括如何批量搭建环境、如何高效调度以最大化资源利用率、如何保证实验可复现,以及如何处理运行异常中止和网络不稳定。下面简单讨论 OSWorld 2.0 的实践与 DSec 的贡献。
OSworld2.0的 Worker-based 架构
OSWorld 2.0 采用了经典的 worker pool + task queue 架构,可以作为真实工程环境下调度系统的参考实现。
首先准备数百个待评测任务,每个任务包含 instruction、初始文件与软件状态、环境规格 env_spec,以及隐藏的 setup 和 evaluator 逻辑。评测人员决定启动多少个 worker,例如 num_envs=20。所有任务进入共享任务队列,哪个 worker 空闲,就从队列中领取下一题。
Worker 拿到任务后先检查 env_spec。如果手里已有符合要求的 VM,就继续复用;如果新任务要求不同的规格,例如从 Ubuntu 切换到 Windows,或需要不同的 VM 配置,就关闭旧环境并创建新环境。随后由 env.reset(task_config=example) 初始化 VM,准备任务所需的初始状态,例如下载输入文件、打开软件、恢复浏览器或文件系统状态。
接下来进入 Agent–Environment 循环。Agent 模型通常运行在 Host / Worker 一侧,而不在 VM 里。Worker 把 VM 的 screenshot 或 observation 交给 Agent,Agent 返回点击、键盘等 action,再由 env.step(action) 发送给 VM。任务结束后,代码执行 result = env.evaluate(),由隐藏的 Evaluator 根据 VM 最终状态判断任务是否完成并给出 reward。系统随后保存评分和完整的运行记录,包括 reward、traj.jsonl、每一步的 screenshot、runtime log 和录屏。
然后 Worker 回到队列领取下一道任务。如果下一题的 env_spec 相同,就复用当前 VM,并 reset 成下一题需要的初始状态;只有环境规格不匹配时才真正更换 VM。
这个架构有两个优势。一方面,任务队列实现了负载均衡,不会出现部分 worker 空闲而其他 worker 过载的情况。另一方面,每个 worker 独立运行,单个任务失败不会影响其他任务。
DSec 的 Elastic Computation 与多层后端
DSec(Dynamic Sandbox Execution Control)是更底层的基础设施,它关心的核心对象是“环境”。它要解决的问题是,当每天需要创建数百万个 Agent sandbox 时,如何快速、低成本、稳定地把这些 sandbox 调度到整个计算集群上,并保证它们可靠运行。
评测与 RL rollout 的执行链路高度相似,都可以抽象为 Task → Agent 思考 → 在环境中执行操作 → 获得反馈 → 继续思考与执行 → …… → Verifier / Reward Model 给出 reward。所以,两者对基础设施的需求有很大重合。区别在于,评测利用这些轨迹衡量模型能力,RL 则进一步把大量 rollout 产生的 reward 与 trajectory 用于参数优化。
借用 DSec 原文中的描述:
每个 rollout 或评测任务,都需要平台具体化出一个隔离的任务专用环境:代码仓库、依赖、服务、评测脚本与编码 harness,一样不能少。这一环境必须足够接近真实机器,才能不加修改地运行既有软件栈、包管理器、构建工具、浏览器、模拟器与任务特定服务。健壮且高吞吐的沙盒运行时,因此成为获得准确、可验证 RL 训练与评测结果的基础。
创建单个 sandbox 并不困难,但扩展到大规模 RL 与评测场景后,问题就复杂得多。短时间内可能有大量 sandbox 突发创建,同一台机器上需要高密度运行多个环境,有些长程任务需要长期保存状态,不同任务对 CPU、GPU、内存、软件栈和系统能力的要求差异很大,环境镜像数量庞大,而且 Agent 产出的代码不可信,需要严格隔离。为此,DSec 提供了统一的沙盒抽象层,底层对接四种不同的 backend,根据任务特点灵活选择。
我们先从评测使用者的视角看 DSec,即如何通过命令完成调度。
假设要跑 10,000 道 SWE 类 Agent 题,并且已经准备好了 task instruction + repo/workspace + Agent + verifier。如果自己搭建评测基础设施,还需要考虑很多执行层的问题,例如第 x 个任务应该分配到哪台机器、这台机器有没有足够资源、环境镜像怎么准备、任务结束后什么时候回收。
DSec 把这些底层问题统一封装成了一套 sandbox 服务。上层 evaluation framework 只需要通过 libdsec 描述“我要一个什么样的执行环境”,随后通过统一接口使用这个环境。
container_image="python-dev-env",
memory_limit_mb=4096,
cpu_cores_limit=4,
ttl_running_stop=300,
network_rules={"npm": False, "pypi": True},
init_user="root",
)
sandbox = await client.run_container(args)
# Harness 将 Agent 产生的操作发送到对应 sandbox
result = await sandbox.run_shell("pytest tests/test_user.py")
# 最后执行 verifier / tests
result = await sandbox.run_shell("python verifier.py")
await sandbox.stop()
因此,Benchmark 开发者(评测人员)主要只需考虑两类问题。
1️⃣ 这个任务需要什么样的执行环境?
这一步是定义 sandbox 的环境契约,即 backend + environment artifact + resources + lifecycle + network policy + user,各项含义如下。
● backend:FnCall / Container / MicroVM / Full VM
● environment artifact:什么基础镜像、workspace、依赖和 toolkit
● resources:需要多少 CPU、RAM,是否需要 GPU 等特殊硬件
● lifecycle:sandbox 可以存活多久,空闲多久后回收
● network policy:允许访问 PyPI、GitHub 或其他外部服务吗
● user:以 root 还是普通用户运行
比如普通 SWE 任务通常可以选择 Container,安全任务可能需要隔离更强的 MicroVM,而依赖完整桌面系统、Android 或 GUI 的任务则可能需要 Full VM。
2️⃣ Benchmark 的执行流程如何接入这个 sandbox?选用或搭建合适的harness层
这部分通常由 Harness / Evaluation Framework 负责。Agent 本身只会产生动作,例如:
command = "pytest tests/test_user.py"
Harness 接收到这个动作后,将它映射成:
于是整条链路变成:
↓ 产生 action
Harness / Evaluation Framework
↓ 调用 libdsec
DSec
↓ 路由到对应 sandbox
Container / MicroVM / Full VM
↓
执行结果
↓
Harness
↓
Agent
这样一来,评测框架只需要知道“我要什么环境”和“我要在这个环境里执行什么操作”。至于 sandbox 最终被放到集群的哪台机器、镜像如何加载、请求如何路由、资源不足时如何调度,都由 DSec 负责。从这个角度看,libdsec 就是 Evaluation Framework 与 DSec 基础设施之间的边界。
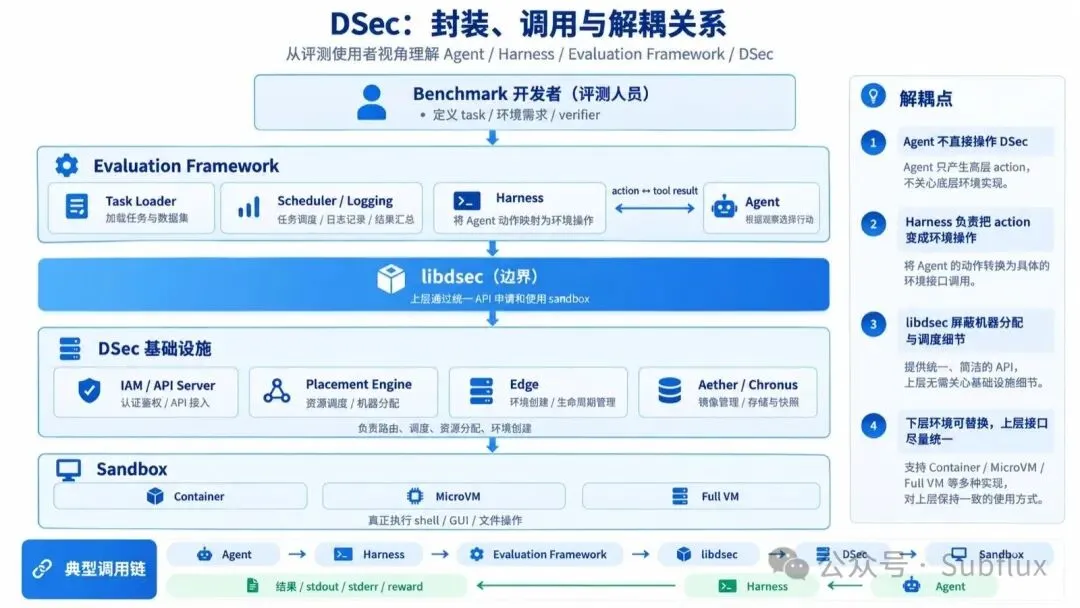
DSec架构与调用解耦关系图
调度之下——DSec设计与搭建
上层使用者向 DSec 请求 sandbox 之后,DSec 需要把这个抽象请求变成集群中某台真实机器上的可用 sandbox,并保证后续所有命令都能准确送达,使状态不丢失、资源不混乱、结束后正确回收。从 DSec 开发者的视角,可以把整个系统粗略分成控制面和执行面两部分。
第一部分:控制面
控制面主要包括 IAM、API Server、Placement Engine、Watcher,负责判断请求能不能执行,以及应该放到哪台机器上执行。当大量 sandbox 创建请求进来时,首先由 IAM / API Server 处理身份认证、权限和请求入口,随后由 Placement Engine 根据任务需求选择合适的节点。例如某个任务要求 GPU,没有 GPU 的节点会先被排除;Placement Engine 再从剩下的候选节点中抽取一小批,优先选择其中负载较低的节点。这样做是为了降低大规模调度本身的计算成本。Placement Engine 依据的节点信息来自 Watcher,后者持续收集各节点上 Edge 的健康状态和资源负载。因此,控制面可以概括为 请求鉴权 → 筛选可用机器 → 选择一个合适节点。
第二部分:执行面
执行面主要包括 Edge、Aether、Chronus 和具体 Backend,负责把调度决定变成一个可以运行的 sandbox,并管理它后续的运行。
例如 Placement Engine 已经决定 task #7281 → node 37,创建请求就会被发送到 node 37 上运行的 Edge。Edge 相当于每台机器上的“本地管理员”,它在真正创建 sandbox 之前,会再次检查 CPU 是否足够?RAM 是否足够?需要的 backend 是否支持?本地资源是否还能容纳这个 sandbox?。之所以需要这次复查,是因为 Watcher 提供给 Placement Engine 的状态存在一定延迟。比如 100 ms 前 node 37 还有 20 GB RAM,但在这 100 ms 内它可能已经接收了很多新任务,所以最终创建前需要由 Edge 根据机器的实时状态再确认一次。
确认资源充足后,Edge 才会启动对应的 Container / MicroVM / Full VM。sandbox 创建以后,Aether + Chronus 作为 DSec 放在 sandbox 内部的管理组件,让 Edge 能继续监控和远程管理这个 sandbox,例如执行管理命令、访问文件和获取运行结果。所以执行面可以概括为 Edge 接收调度结果 → 本机再次检查资源 → 创建 Backend → Aether / Chronus 负责后续管理。
统计分析
跑完 benchmark 得到一个分数,并不意味着分析已经结束。我们还需要回答一系列问题:这个分数稳定吗?不同模型之间的差异真的存在吗?我们选择的统计指标是否对应想衡量的能力?这个差异究竟应该归因于模型,还是模型与 harness 的组合?
由于 Agent 评测涉及的变量多而复杂,这部分工作极其困难和繁琐。但是,只有把这部分做到位,才能解释评测过程中 Agent 的种种行为表现。
结果稳定性
Agent 评测天然存在随机性。模型采样本身是随机的,环境状态可能不完全确定,长程任务中的误差还会不断累积。因此,同一个模型在同一道题上的不同 rollout 可能得到不同结果,只跑一次 benchmark 很难区分模型能力差异和随机波动。
要论证模型 A 优于模型 B,更稳妥的做法是进行多次重复实验,并报告均值、置信区间等统计量。由于两个模型通常回答的是同一批任务,还可以对逐题结果做配对统计检验,从而判断观察到的差异是否已经超过正常的随机波动。
指标选择:pass@k 与 pass^k
同一道题进行多次 rollout 后,还需要根据评测目的选择指标。pass@k 与 pass^k 衡量的是两种不同的能力特征。
pass@k 衡量的是给模型 k 次尝试机会时,它至少成功一次的概率。它更适合衡量模型的探索能力和能力上限,尤其适用于存在可靠 verifier、实际系统允许多次尝试并从中选出正确结果的场景,例如 coding、数学证明或搜索型任务。
pass^k 衡量的是连续 k 次尝试全部成功的概率,更强调模型的稳定性和可靠性。它适用于希望每次调用都能稳定完成任务的场景,例如客服、运维操作、财务流程等。
所以,“多跑几次”本身并不决定该报告哪个指标。指标的选择取决于 benchmark 想衡量的是模型偶尔能不能做到,还是能不能持续稳定地做到。
Model-Harness 归因
在 Agent benchmark 中,模型运行在某套 harness 里。Harness 决定了模型能调用哪些工具、工具接口长什么样、上下文如何组织、错误如何反馈,甚至决定了模型如何观察环境。
当前很多 Agent benchmark 固定同一套 harness 来比较不同模型。如果评测目标是比较哪个模型在这套 Agent 系统中表现更好,这样的设计已经足够。但如果想把分数进一步解释为基模自身较为普适的 coding 或 Agentic 能力,就需要考虑 model–harness interaction。因为模型在 post-training 中可能已经适应了某些工具接口、调用协议和上下文组织方式,所以固定 harness 下观察到的性能差异,可能同时包含模型的能力差异和模型对当前 harness 的适配程度。
更完整的实验设计是 model × harness 交叉实验,即让多个模型分别运行在多套 harness 上,再观察同一个模型更换 harness 后性能变化有多大,以及不同 harness 下模型之间的相对排名是否稳定。如果模型对 harness 的敏感度普遍较低,并且排名基本稳定,我们就更有把握把差异解释为模型能力差异。
已有 benchmark 采用过类似设计。ALE 分别进行了固定 harness、更换模型,以及固定模型、更换 harness 的实验,用于观察 model 与 harness 各自对结果的影响,结论是能力差异主要源自 model 本身,其次才是 harness。ALE 还把 Fable 5 和 GPT-5.5 在不同 harness 上的结果按领域聚合,观察模型在哪些专业领域强、哪些领域弱。结果显示,两个模型的领域表现排序比较相似,计算数学、农业/环境相对较高,教育最低。作者据此认为,这种共同的领域排序反映了模型本身的领域能力差异,以及训练数据中不同类型工具任务的覆盖差异。
WorkBuddy Bench 则让模型分别运行在 CodeBuddy Code 与 Claude Code 上,发现不同任务对 harness 的敏感程度不同。例如 Office 赛道整体变化较小,而 Security 赛道的平均绝对变化达到 8.6 分。
当然,是否需要固定 harness,最终取决于评测目的。如果目标本身就是寻找每个模型能够达到的最佳 Agent 表现,那么完全可以为不同模型选择或调优不同的 harness。结果统计分析不存在固定 SOP 方法论,方法的选择取决于目的是什么。
失败分析
让模型在不同 benchmark 上运行,目的不只是展示当前模型有多强,更重要的是分析模型的能力特征和能力缺失之处,从而为下一阶段的模型训练提供明确的方向。
然而,现有的很多论文止步于分数和表现,很少能深入、准确地指出模型的能力缺陷。为了更好地讨论失败分析的深度,我把失败分析分为四个层次。
1. 结果分析:完成率、pass@k、final reward。
2. 过程分析:partial score、checkpoint reward,回答"做到了哪里"。
3. 行为模式分析:轨迹、工具调用模式、token 预算、重复、验证、恢复,回答"常见的失败行为是什么"。
4. 能力缺失定位:通过消融与对照实验,回答"缺的是哪种能力"。
ALE 的失败分析方法
ALE 的分析分为两个环节。
Trajectory 分析
对于每个失败任务,ALE 让 OpenAI Codex 检查整次运行留下的证据,包括 interaction_log.json 中的 Agent 行为、run_result.json 和 agent_result.json 中的运行信息、debug/eval/result.json 中评分器给出的结果,以及 events.jsonl 中的事件轨迹。Codex 据此生成一张结构化的 analysis card,内容包括以下五项。
1. 一句话判定,包括总体判断(成功 / 部分成功 / 失败)与最重要的单个问题。
2. 任务描述,用平实语言解释任务要求,包括关键约束与运行时元数据。
3. agent 做对了什么,即正确行为,并附上指向具体日志条目的证据指针。
4. agent 做错了什么,即观察到的错误,同样附上证据指针;提示词要求把已确认的错误与不确定或推断的原因分开。
5. 打分,包括最终得分、原始得分分解(如有)、推断的评估标准与置信度评级。
为了降低幻觉、提高分析的可靠性,每个判断都要求 Codex 引用具体的 artifact 和字段作为 evidence。
失败类型归类
随后,ALE 用 GPT-4o(temperature=0)把 analysis card 归入一个四层分类体系,每个失败最终在以下八个类别中选出一个最主要的原因。
understanding:对待解决问题的理解是否到位
● 25% Domain Knowledge Gap:missing specialized expertise。如果一个真正的领域专家通常不会犯这个错误,就倾向于归为领域知识不足,但这个判断比较主观。
● 6% Hallucination/Fabrication:Agent 没有真正计算、查询或验证,凭幻觉编造了数据和结果。
Approach:理解了待解决问题,解题路线有问题
● 30% Wrong Strategy:采用了根本不合适的方法,或者违反了明确约束。
● 17% Incomplete / Abandoned:做到一半就结束,或漏掉了必要的交付物。
Execution:思路基本对,执行实现出了问题
● 8% Implementation Bug:方案本身没问题,但具体实现中出现了 logic errors、calculation mistakes 或 data processing bugs。
● 10% Output Format Error:实质内容已经做对,但交付物的格式、位置或者结构不符合任务要求,包括 wrong format、location、structure。
Infrastructure:外部环境导致的问题
● 4% GUI / Browser Failure:环境出错。
● Timeout / Resources:超时或资源不足。
论文据此认为,当前 Agent 的主要瓶颈是模型的领域知识和推理能力,而不只是执行能力。因为缺乏专业知识,Agent 往往绕开领域专用软件,转而编写临时脚本,这也解释了专业 GUI 工具利用不足的现象。需要注意的是,ALE 只分析了 Claude Code + Opus 4.7 的轨迹,因此上述错误归因只体现了 Opus 4.7 的特点。
由于 Agent = model + harness,ALE 主榜的模型与 harness 配对选自真实世界中常用的组合,如 Gemini CLI × Gemini 3.1 Pro、Codex × GPT-5.5、Claude Code × Fable 5,展现的是 Agent 能力的上限。为了进一步说明能力差异来自 model 还是 harness,论文又做了“固定模型、更换 harness”与“更换模型、固定 harness”的实验,结果如下图所示,具体结论已在前文 Model-Harness 归因一节中介绍。
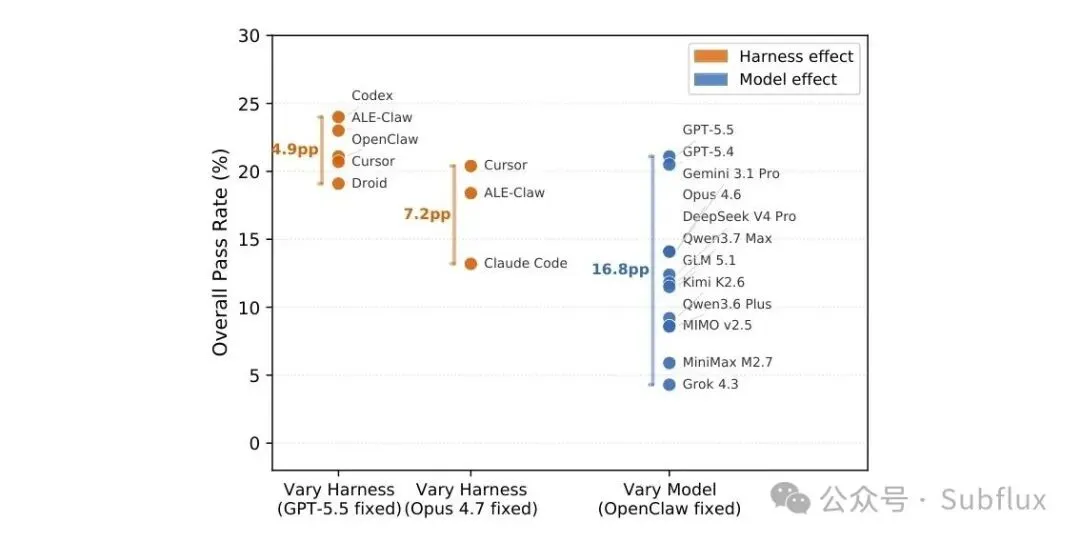
总结来看,这篇论文提供了一套常用的实验分析方法,说明了模型能力差异是 leaderboard 差距的主要来源,并指出了模型基础能力缺失的一些关键因素。
从失败归因到模型改进
前面各个流程的严谨,都是为了保证失败归因的准确。只有准确的失败归因,才能映射出模型能力的真实缺陷,才能为模型改进提供明确的方向。由于我对具体训练涉猎较少,以下讨论仅供批评。
假设一个评测实验发现,同样在 Claude Code 中,DeepSeek-V4 对 memory 的管理能力(读、写、用)明显弱于 claude-opus-4-8。如果 Memory 管理能力在下一阶段的模型迭代中优先级较高,就可以在训练阶段尝试针对性地优化。
优化之前,首先要定义清楚优化的目标,也就是弄清 Memory 管理的问题具体出在哪里。可能是模型对相关工具的调用不敏感,也可能是记忆处理策略有问题。这里的处理策略是指,面对一段新对话和已有的记忆,模型应该新增、更新、删除,还是不做任何操作。
如果失败分析发现,模型经常在应该使用 Memory 时不调用工具,可以先尝试用 tool-use SFT 改善这一行为。以查询为例,当所需信息只保存在 Memory 中时,训练数据示范如何调用工具、填写参数,并根据返回结果作答;当相同的信息已经出现在当前上下文中时,则示范如何直接回答。这样的数据既教模型如何使用工具,也帮它学会判断什么时候需要调用。
但是,如果问题进一步涉及“什么信息值得记、已有记忆应该新增还是更新、什么时候删除,以及一次 Memory 操作能否在数十轮之后真正帮助任务”,就进入了 policy 学习的范畴。SFT 可以教模型模仿一套看起来合理的 Memory Policy,然而“看起来合理”未必等于真正有用。因此,还可以进一步通过 RL,让记忆操作接受后续任务结果的检验。RL 的难点在于 reward 和 credit assignment,因为一次 memory_write 在发生的当下,往往很难判断是对是错。例如用户说“我最近在研究 Agent Benchmark”,如果之后连续几十轮都会用到这条信息,这条记忆就有价值;如果以后再也没有出现,它可能只是一次无意义的写入。
所以,很难简单地定义一条规则,规定哪类信息该记、哪类不该记。一种可能的做法是从同一前缀分叉,分别执行写入、更新或不操作,再用相同的后续用户请求做多次 rollout。比较各分支的任务成功率,就可以估计这次操作在给定场景下的边际收益。至于信息是否存对、需要时是否取回、旧记录是否仍在干扰回答,这些信号更适合用来解释某个 action 带来了什么影响。
除此以外,数据配比也会影响结果。如果训练数据中大量样本都要求新增记忆,模型很可能形成“看到用户信息就写”的行为先验;反过来,NOOP 样本过多,又可能导致模型过度保守。因此,实际训练中还需要反复调整数据分布和 reward 权重,并观察不同类型 Memory 操作的 precision / recall,逐步把行为推到合适的位置。最终,通过大量实验找到一组有效的配方,使模型该写的时候写、不该写的时候不写、该更新的时候更新。
综上所述,评测更近似于一门实验科学。All you need in evaluation is 实事求是。
