导读Agent 的输出不确定、正确解不止一个、执行路径由它自己选,传统单元测试管不住,于是有了从 TDD 借来的「评测驱动开发」。文章给出三步流程:先写清「好」长什么样,再在动手实现前把 eval 写出来并跑一条基线,最后每改一版就拿实验两两对比,盯住回退而不只是均分。文中用文档 agent 加一个 create_ticket 工具贯穿全程,还讲了怎么把 eval 接进 CI 与生产、把线上失败样本回灌成数据集,以及五个常见错误。
作者:Divya Santhanam
编辑:浮世Talk
要点速览
- 评测驱动开发(EDD)是一边搭 agent、一边用一套稳定的指标衡量表现,并朝着某个 eval 不断爬坡的过程。
- EDD 的第一步,是为你想实现的行为写一份简短 spec,说明「好」长什么样。里面要包含 agent 不该做的事,以及哪些已有行为必须保持不变。
- 迭代过程中,判断一次改动好不好,靠的是拿实验两两对比。修好一个 case,很可能弄坏另一个。
- 让 eval 持续跑在 CI 和生产里,并把发现的失败样本变成数据集里的新例子。
大多数 agent 的开发都是从同一个套路开始的:写一版 prompt,手动问几个问题,调一调,再问一遍。早期这招很有效——agent 的错误一眼能看出来,改动有没有用也肉眼可见。但随着时间推移,你会越来越难判断:最近这次改动,到底把 agent 变好了还是变坏了。
评测驱动开发(Eval-Driven Development,EDD)解决的正是这个问题:它给你一套稳定的指标,用它衡量 agent 的表现,并用它来指导决策。在 LangChain,我们在构建最复杂的几个 agent 时都用了 EDD(我们写过一篇关于 IssueBench 的博客),并把它归纳成三步:
这篇文章会一步步走完整个流程,方便你的团队把它套用到自己的 agent 开发过程中。
什么是评测驱动开发?
评测驱动开发这个名字和概念,都借自测试驱动开发(TDD)——先写一个会失败的测试,再写让测试通过的代码。但 agent 和传统代码不同,它是非确定性的:
- 输出会变。 同一个问题,每次运行都可能得到不一样的回答。
- 正确答案不止一个。 两段自然语言的回答措辞不同,却都可以算对。
- 执行步骤由 agent 自己选。 它可能调了一个根本不需要的工具,也可能漏掉本该用的工具,最后仍然答对了。
因此,agent 需要另一种测试方式。eval 的做法是:让 agent 在一组样例上跑一遍,然后给每次运行打分。eval 比传统测试灵活得多——agent 运行的任何一个方面都可以被打分,你甚至可以用另一个 LLM 来打分(即 LLM-as-a-judge)。
在 EDD 里,和 TDD 一样,这些 eval 就是你对「成功」的定义,你把 agent 朝着它们去建。
第一步:定义你的 agent 表现成什么样才算「好」
EDD 的第一步,是定义你的 agent 应该做什么。然后列出为了做到这件事,它需要处理哪些行为。这些行为可能是:回答知识库里的问题、替用户执行某个动作,或者知道什么时候该追问一句。把每种行为的要求写下来,合在一起,就是你这个 agent 的产品需求文档(PRD)。
EDD 一次只处理一种行为。这样你有一个很窄的目标可以往上爬,不会因为一次改动搅浑了另一次改动的效果。要挑哪种行为,通常来自你马上要做的功能,或者 agent 过往运行中暴露的一个失败。在写代码之前,先写一份简短的 spec 会很有帮助,它覆盖:
这份 spec 要明确到足以判定 pass 或 fail。
假设我们有一个内部文档 agent,员工用它查公司信息。它有两个工具:search_docs 查内部文档,web_search 查其他一切。我们打算加一个 create_ticket 工具,让它能提 IT 工单。spec 大致是这样:
- 时机:用户报告某个东西坏了,比如「我的笔记本连不上 VPN」。
- 不该做:为「怎么做」类的问题提工单,比如「我怎么连 VPN?」
- 保持不变:
search_docs 和 web_search 仍然处理它们今天处理的问题。
我们就按这些准则来评测,尽管这个 agent 现在还根本没有这个能力。
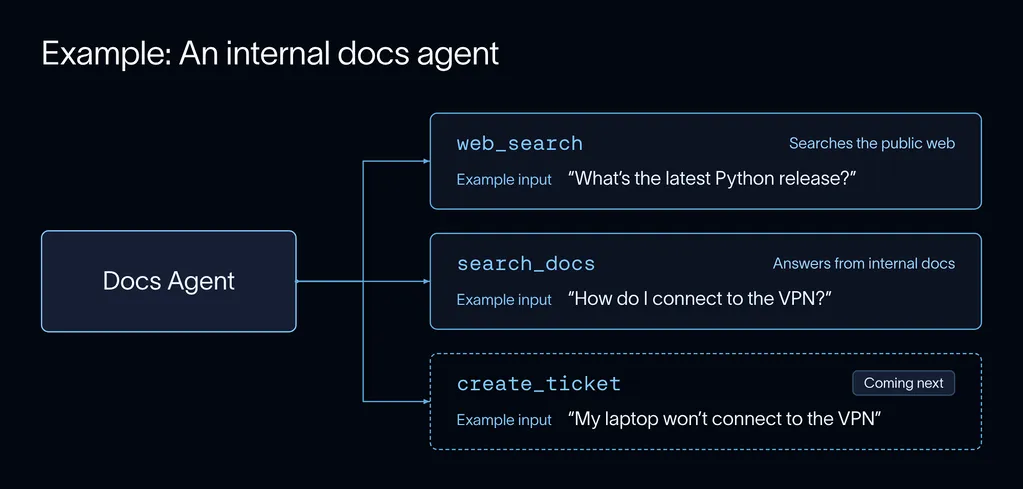
图中是文档 agent 当前的示例实现,以及我们计划新增的工单工具。每个工具都配了一条会触发它的示例输入。
第二步:在动手实现之前先写 eval
构建数据集。 数据集是一组测试用例(称为 example)的集合,每个用例有输入,并可选地带有参考的「golden」输出。输入最好的来源之一,是 agent 的真实运行记录。用户的措辞方式你根本预料不到,他们的请求里还包含你自己想不出来的边缘情况。如果你的 example 看起来像真实流量,那么 eval 拿到高分,就更可能意味着生产环境里表现也好。在 LangSmith 里,你可以直接把真实的 agent 运行加进数据集。如果目前连一条运行记录都没有,常见的替代做法是从零开始手写 example。
对我们的文档 agent 来说,几个 example 就够起步了。数据集里我们会放入提工单的请求,同时放入那些仍然应该走 search_docs 和 web_search 的问题,这样已有行为也被覆盖到了。
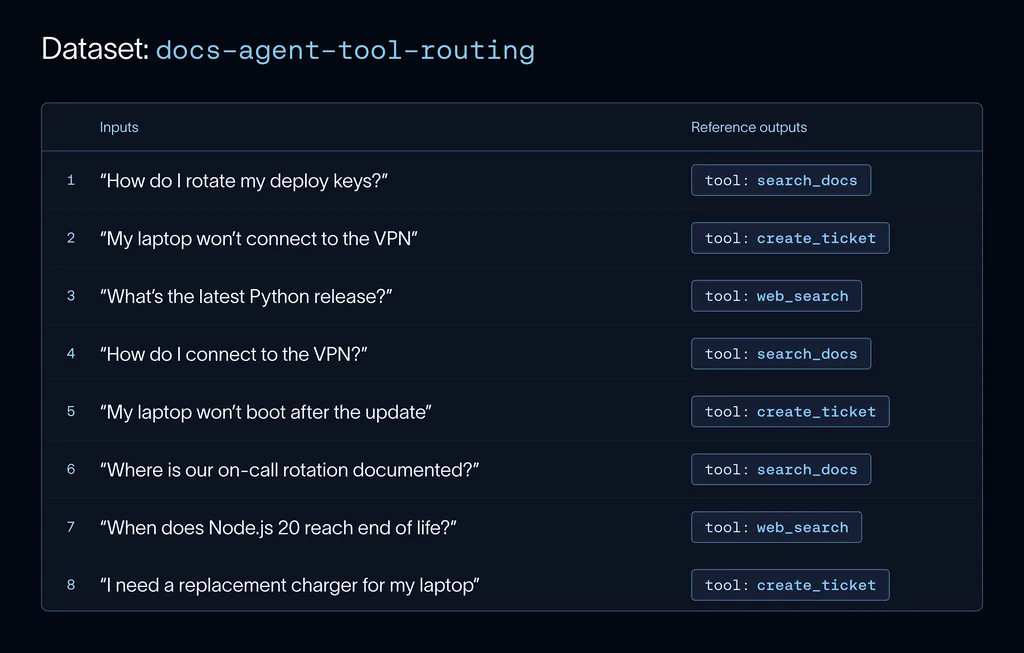
每条 example 把一个输入问题与参考输出(即 agent 应当调用的工具)配成一对。
你还可以把数据集扩展到它目前还没有覆盖的情况。假设我们手里很少有情绪激动的用户案例,那就可以把现有 example 交给一个 LLM,让它改写成更愤怒的说法,然后检查 agent 是否仍然调用了正确的工具。
编写评测器。 有了数据集,你就可以把 PRD 里对「好」的定义,变成一个测试或 eval,用它在你的 example 上给 agent 的表现打分。写 evaluator 时,要挑最适合这个测试的打分方式:判断是确定性的,就用 code eval;不是确定性的,就用 LLM-as-a-judge。同时想清楚:你要看的是 agent 的最终回答,还是它为了得到回答而执行的某个动作,还是完全另一回事?对我们的文档 agent,我们要看它调用了哪些工具,以确认每种情况下用的工具都对。工具选择在代码里很容易检查,所以可以用 code eval 来核对每条 example 是否调用了它参考输出里列出的工具。
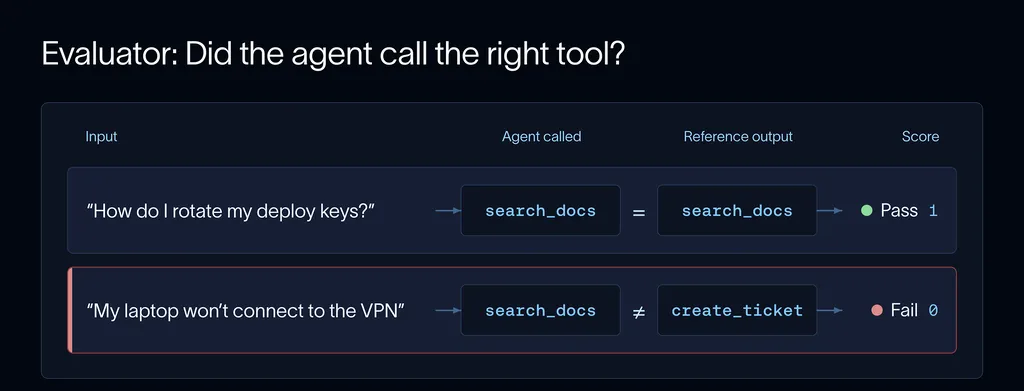
只要 agent 调用了参考输出里的工具,这条 example 就算通过。
我们的文档 agent 只是个带几项特定功能的简单聊天机器人。当 agent 越来越复杂时,你的 eval 套件大概也需要换个样子。如果你的 agent 会在某个环境里留下改动,比如沙箱里的编码 agent,那么只检查几个工具调用和最终回答就不够用了。你需要检查 agent 在系统里留下的状态,而且每次运行都需要一个干净的环境,避免上一次运行影响下一次。Harbor 就是一个用来跑这类任务的 agent 的开源框架,也是 Terminal-Bench 这类行业基准背后的 harness。每个任务都在自己的沙箱里运行,并附带一个测试脚本,用来给最终状态打分。
针对 Terminal-Bench 这类基准做优化,遵循的是和 EDD 完全相同的循环:先写任务和测试,跑一条基线,然后每改一次 agent 就对比实验。我们在构建 LangSmith Engine 时,就用真实和合成的 agent 运行记录做了一个自己的基准,并把它作为 Harbor eval 来跑。我们也用 Harbor 给 Deep Agents 做基准测试——它能告诉我们,砍掉 harness 的某些部分(比如 todo 列表中间件,或者系统提示的一部分)之后,agent 会不会变差。
跑一条基线。 不管你怎么搭数据集、怎么写 evaluator,都可以让 agent 在每条 example 上跑一遍,并把结果作为一次实验记录到 LangSmith。一次实验,就是 agent 在整个数据集上的一次运行,每条 example 的输入、输出和 evaluator 打分都保存在同一条记录里。有了这样一个集中管理的地方,你才能把不同版本 agent 的结果相互对比。在改动 agent 之前,先跑一次基线实验作为对照指标,这一点很重要。
在我们的文档 agent 上,数据集里那些提工单的 example 会得到失败分数,因为工具还不存在。其他 example 记录的是已经能正常工作的部分,这样以后加新工具时,你就能看出它有没有弄坏别的东西。
第三步:做出改动,然后对比
现在,我们把 create_ticket 工具建出来,再跑同一套 eval。
记住,EDD 的核心是朝着 eval「爬坡」(hill-climbing)。爬坡意味着反复执行「评测、对比、调整」这一改进过程,从而建立一个有客观改进证据的固定循环。之后每一次对 agent 的改动都有自己的实验,每个实验都和上一个比,以确认是否真的前进了。在 LangSmith 里,同时选中两个实验就能打开对比视图,它会并排显示每条 example 的分数,让你看清哪些变好了、哪些退步了。
对比实验时,不能只看均分的变化,还要注意有没有回退,有没有把原本正常的行为覆盖掉。在我们的文档 agent 上,那些工单 example 现在通过了,但「我怎么连 VPN?」这句现在变成了提工单,而不是去查文档。均分上去了,可有一个 case 坏了。
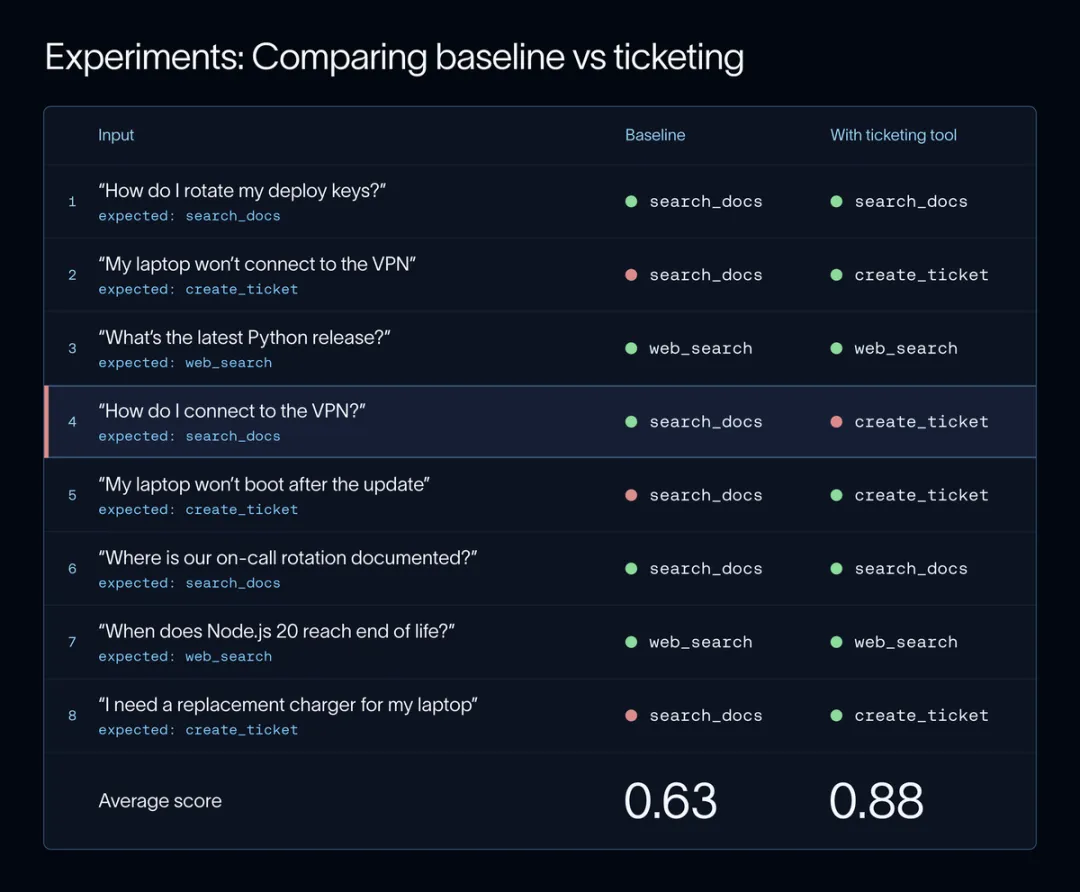
加上工单工具后平均分提高了,但「我怎么连 VPN?」这条现在失败了。
想搞清楚一次 eval 为什么失败,最好的办法是看 trace。trace 是一次 agent 运行的记录,包含每一次模型调用和工具调用。只要你用任意框架构建 agent,都可以在 LangSmith 里做 tracing。更多信息可以看 tracing 快速上手。
打开最新实验里那条失败运行的 trace,我们看到工具描述写的是「VPN 和笔记本问题」就用 create_ticket,于是任何提到 VPN 的问题都会命中它。这就覆盖掉了基线上正常的行为。
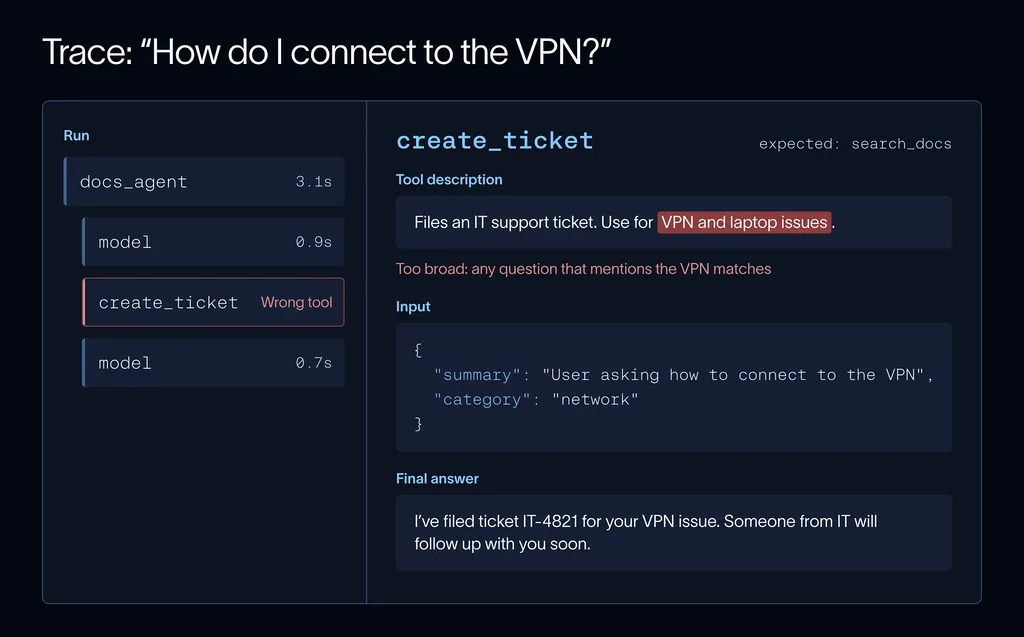
trace 告诉我们,工具描述的范围太宽,导致 agent 为一个文档本来能回答的问题提了工单。
解决办法是把工具描述收窄,只覆盖确实需要 IT 出手的请求。改完之后再跑一次 eval,这次每条 example 都通过了。
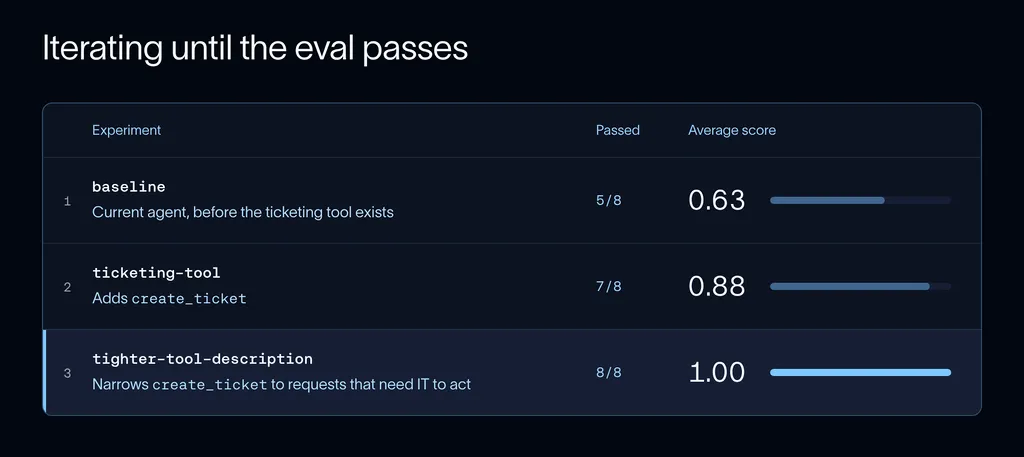
工具描述收窄之后,所有 example 全部通过。
在这么小的数据集上拿满分是好迹象,但 100% 并不总是正确的目标。我们是在盯着这几条具体 example 的情况下调的这条工具描述。如果你一直调到每条 example 都通过为止,agent 可能就开始过拟合你的数据集,而不是你真正关心的那个行为:它通过了你的 eval,却仍然会在遇到你 example 没覆盖到的说法时失误。要检查这一点,就留一组你迭代时不去看的 held-out 集合。如果你反复调优的那批 example 分数上涨、而 held-out 集合上一直持平,那很可能就是过拟合了。
多步 agent 可能在任何一个步骤上出错,所以在 LangSmith 里你不只能评最终回答:可以给单个步骤打分,给完整的工具调用序列打分,也可以给归并到一个 thread 里的多轮对话打分。
让 EDD 跟着上线一起跑
把评测自动化
当你开始更快地部署改动时,很容易就跳过跑 eval,或者把旧的 example 忘在一边。把自动评测加进工作流,你就能挡住没测过的改动,在生产之前抓到回退。
搭建 eval 套件的最佳策略,取决于你具体的环境。跑得快的代码检查可以直接挡住一次糟糕的合并,而带 LLM judge 的慢速 eval 可以每晚跑一次,或者发版前跑一次。迭代时用数据集切分只跑你正在处理的那个行为的 example,上线前再跑全集。
LangSmith 可以和 pytest、Vitest 集成,这样 eval 就放在代码旁边,每个 pull request 都跑一次。每次运行都记录为一次实验,结果和别的东西在同一个地方看。
在生产环境中评测
上线之前,你的数据集大概只覆盖了你在开发阶段想到要测的那些情况。剩下的可以在生产里标出来,用下面这些评测方法:
- 在线评测器(Online evaluators):随着 trace 进来就实时打分。你可以把代码检查和 LLM judge 挂到一个 tracing 项目上,并只抽样一部分流量来控制成本。
- 标注队列(Annotation queues):让你的团队人工复核被标记的运行。在你真正依赖某个 LLM judge 之前,也是用它来确认 judge 的判断和人的判断一致。
- 看板(Dashboards):可以长期跟踪 eval 分数、反馈、成本和延迟,让你看清一次发版是变好了还是变差了。
- Insights:把生产 trace 聚类,让你能从成千上万次运行里发现新的模式。
- LangSmith Engine:再往前一步,把聚类出来的问题变成带断言(assertion)的数据集 example,交给你复核。
我们也已经把给 Deep Agents 用的 eval 发布在它的仓库里了,你可以看到一个真实的生产级 eval 套件。
常见错误
- 把成功定义得太松。 前期多做点重活,把成功定义清楚,eval 才好判定 pass 或 fail。「回答有帮助」不是一个定义良好的指标。
- 先修好再写 eval。 见过新的输出之后,人很容易写出一个「天生就会通过」的 eval。要先写,并且确认它在当前这个有问题的版本上确实是失败的。
- 只看平均分。 均分上涨会掩盖掉那些退步的 example,也会掩盖掉覆盖了原有好行为的改动。决定保留一次改动之前,逐条看 example。
- 加不需要的 eval。 每个 eval 都会把 agent 往某个方向推。让每个 eval 都对应一次具体的改动,比如你正在修的失败,或者你马上要做的功能。
- 迷信没校验过的 judge。 先把你的 LLM judge 和人工打分对一遍。问它窄一点的问题,用 pass / fail,而不是含糊的 1 到 10 分。
延伸阅读(原文所列,标题保留英文):The most common questions about agent evals, answered · How we build evals for Deep Agents · Towards automating eval engineering · LangSmith evaluation quickstart
引用链接
[1] What Is Eval-Driven Development? How to Improve AI Agents: https://www.langchain.com/blog/what-is-eval-driven-development
