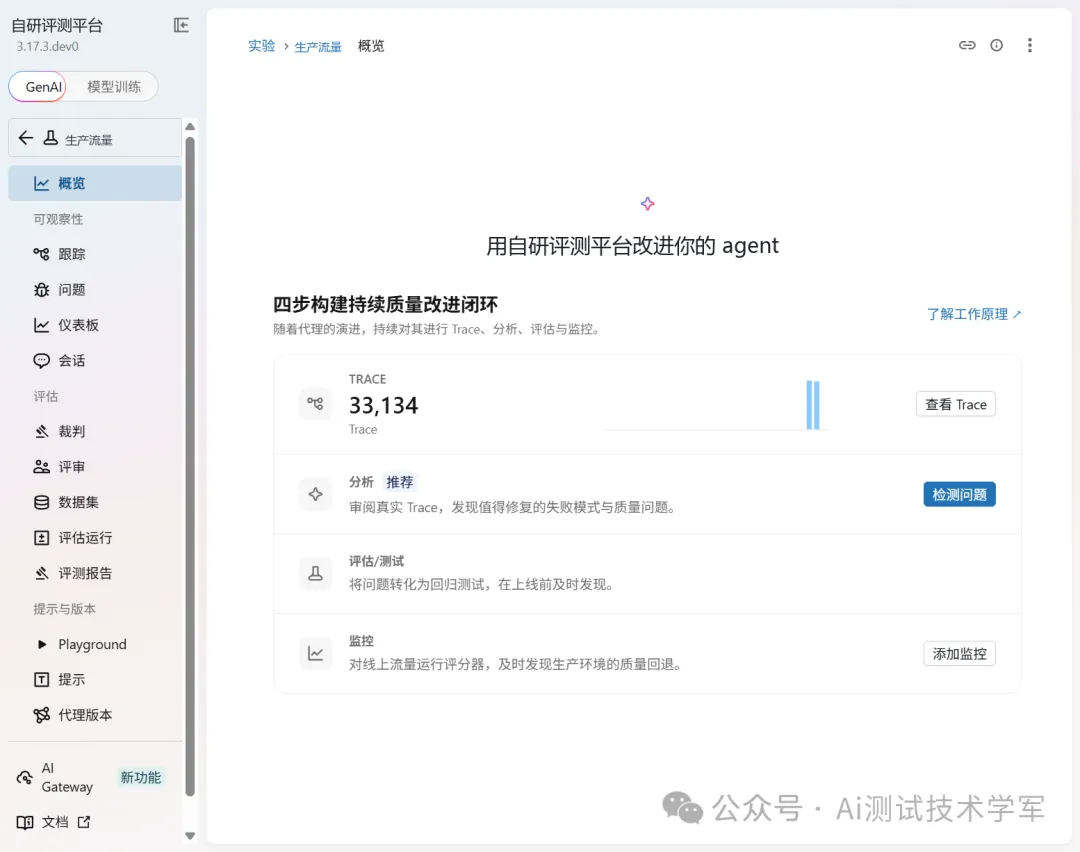
上期结尾,16,710 条 Trace 像心跳一样灌进来。今天早上,这个数字变成了 33,134——24 小时翻倍,曲线完美。然后,我点开了列表。
先给结论:Trace 数量曲线不会告诉你数据是空的。评测平台给我上的第一课,是学会怀疑自己的漂亮数字。
这篇讲这批空壳是怎么被发现的、怎么验源、怎么隔离,文末附一份可以直接抄走的「Trace 有效性体检清单」。
一、曲线完美,列表全空
先把现场还原。
生产流量实验上线第二天,概览页的 TRACE 数字从 16,710 涨到 33,134,24 小时整整翻了一倍。列表页每隔几分钟就多出几行,时间戳新鲜滚烫——管道是通的,流量是活的,一切都在变好。
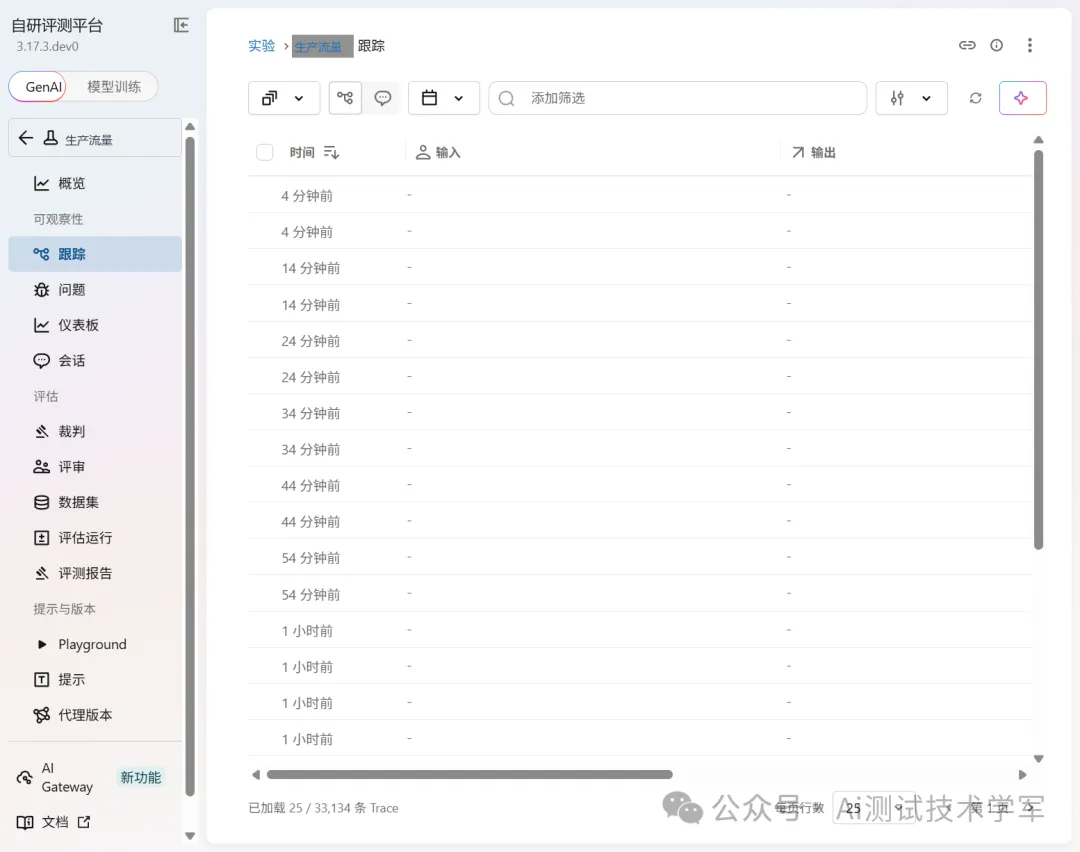
然后我点进了跟踪列表。
输入:"-"。输出:"-"。耗时:1ms。Token:"-"
不是个别几行——第一屏 25 条,清一色;往下翻,还是。
说实话,那一刻的第一反应不是沮丧,是后怕。这 33,134 条要是直接进了问题检测,评分器会把每一秒都花在空数据上;要是进了趋势报表,曲线会漂亮得一塌糊涂,且毫无意义。
教训一句话:数量曲线只回答"管道里有没有东西流过",不回答"流过的是什么"。
二、随机点开一条:这不是智能体的对话
列表没有内容,详情呢?我随机挑了一条,点开。
是一条数据库查询。一条 SELECT,耗时 1.17ms,身上挂着 16 个标签:数据库操作语义标签、JDBC 连接信息、调度线程名。
这不是智能体的 LLM 调用链,一眼就能确认。这是一个 Java 服务进程里最普通不过的一次数据库操作。
几条对下来,真相拼出来了:接进评测平台的,是某个内部 Java 服务挂的自动探针打出来的进程级遥测。 SQL 查询、定时任务,服务进程里发生的每一件事都被探针如实记录,顺着管道送了进来。
管道没坏,是接错了水管:平台在喝水,喝进来的却是服务遥测,不是智能体流量。
回头想,探针没做错任何事——它忠实记录了一个服务进程的全部行为。错的是我们把"某个进程在持续产数据"当成了"智能体流量在进来"。这两件事在数量曲线上一模一样,在内容上完全不同。
三、真货长什么样:空壳和真货,一眼就懂
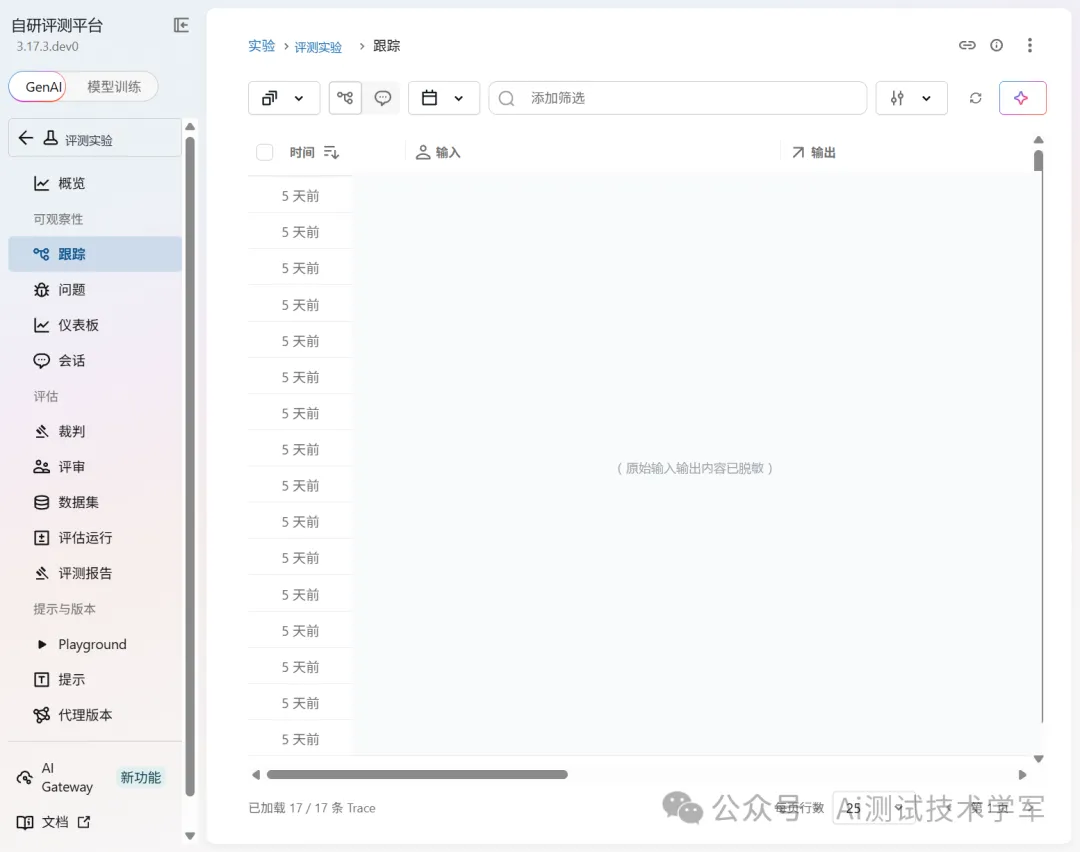
对照一下真正的智能体 Trace。链路实验里那 2 条,其中一条 6.4 秒、6,902 Token,带模型名和完整输入输出——那才是一条 LLM 调用该有的样子。精评实验里人工筛过的 17 条,条条有真实内容。
把两种 Trace 放在一起,差异大到不需要任何工具:
还有一个更直观的感官判据:真货打开有"人味"——有提问、有回答、有多轮对话;空壳打开是工程日志——有 SQL、有线程、有连接参数。人看 5 条就能分清,不需要写任何检测脚本。
四、为什么会接错水管:曲线为什么不报警
复盘时最值得问的是:为什么数量翻倍都没有触发怀疑?
因为数量、时间戳、状态,这三类聚合指标全是"管道健康"指标。探针打得勤,数量就涨;服务活着,时间戳就新;遥测协议自带状态,状态就正常。所有仪表都指着"一切正常"。
而"数据是不是你要的数据",是内容问题。聚合指标天生回答不了内容问题——33,134 条的总数曲线、平均耗时,恰好把"每一条都是空的"这个事实抹平了。
还有一个原因让我们放松了警惕:上期链路实验刚验证过,管道是通的。于是"通了"被默认推成了"对了"。但链路实验证明的是"这条路走得通",不证明"现在走在路上的是谁"。
教训一句话:"管道通了"和"接对了管道"是两次验证,少一次都不行。
五、Trace 有效性体检清单(可直接抄走)
把这次的教训整理成 5 条。任何新数据源接入评测平台,照这个顺序过一遍:
1. 先抽样打开,再看曲线。 数量和状态曲线不会告诉你内容是空的。新数据源接入后,先人工打开 5 条,再去看仪表盘——顺序不能反,先看曲线,人会被漂亮数字安抚。
2. 查三个体检指标。 输入/输出非空率,这是空壳率的直接度量(这次接近 100%);时长分布,全是 1ms 的一定不是 LLM 调用,真实 LLM 调用秒级起步;Token 数有无,LLM 调用的 Trace 必有 token 记录。
3. 用语义标签验源。 标签里是进程参数、数据库语义、线程名的,是服务级遥测——自动探针打的;标签里有模型名、输入输出、token 数的,才是 LLM 调用遥测。看一眼标签,就知道水从哪根管来。
4. 无效源立刻隔离。 切到独立实验或直接停采。别让 33,134 条空壳混进有效实验——污染报表是小事,烧评分器的钱是大事。
5. 修复按固定顺序。 停无效采集 → 找到真正的 LLM 调用点埋点 → 小流量验证内容完整 → 再放开全量。跳步的代价,这次已经现场演示过了。
六、诚实边界:发现空壳,不等于已经修好
照例把边界说清楚:截至发稿,生产实验仍是空壳遥测状态,问题检测和监控评分器依然没有配置——上期如此,本期还是如此。
所以这篇只写了两件事:怎么发现空壳,发现之后怎么体检。修复埋点不写,因为还没做完。
但有一笔账可以算:这批空壳在被发现时是 33,134 条,还没有进过任何评分器。 发现得早,损失是存储和一点情绪;发现得晚——比如配置好监控评分器、对空壳全量跑了一周评分之后——损失就是真金白银的调用费用,和一份被连续污染七天的报表。
从这个角度说,3.3 万条空壳确实是个好消息:它用最直观的方式,把"漂亮数字不可信"这一课教完了,而且是在烧钱之前。
教训一句话:空数据最贵的结局不是占存储,是被当真数据用——趁早发现,就是在省钱。
总结
回扣开头:24 小时翻倍的数量曲线,一句谎都没撒——管道确实通了,数据确实在涨。它只是从来没承诺过"涨的是你要的数据"。
评测平台的第一课,不是搭得多快、灌得多猛,而是学会怀疑自己的漂亮数字:先抽样、查三指标、验标签、做隔离、按顺序修。清单在第五节,可以直接抄走。
下期预告:修复埋点之后的真实智能体流量,加上问题检测的首跑——上期说好的检测篇,修完水管就补上。真实做完,再写给你。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
往期推荐 · 智能体评测落地记
• 智能体评测落地记(一):16,710 条流量灌进来的第一晚