幻觉治理 · 评测 · 回归 · 反馈闭环
01 开篇:失效路径与一条链路
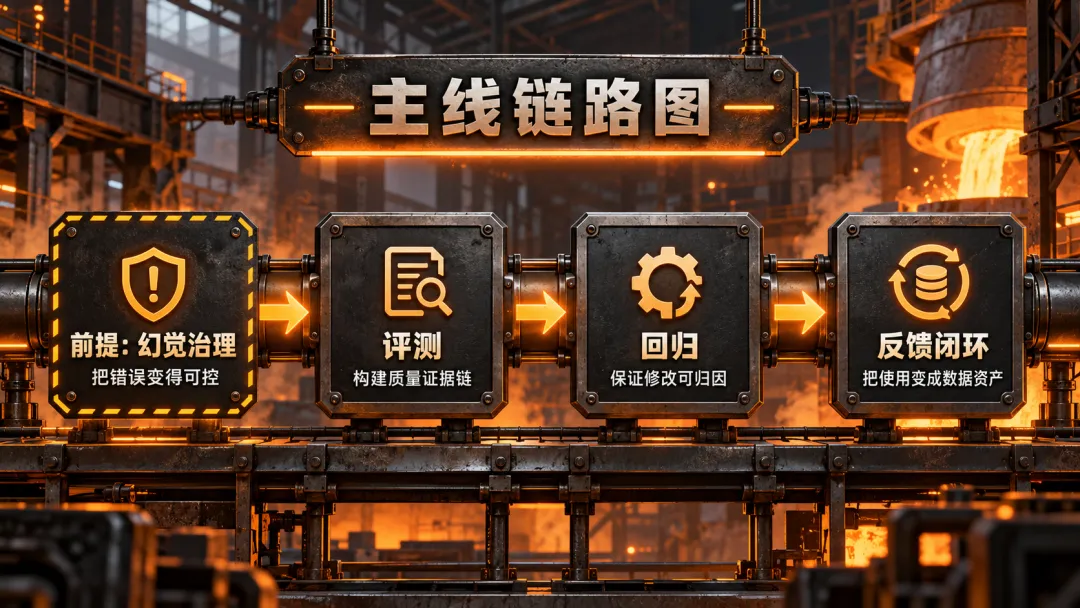
AI 产品的典型失效路径:上线效果惊艳 → 迭代几轮后指标说不清 → 改动无法归因 → 团队凭感觉决策。根因可以归为三项缺失:质量不可度量、改动不可归因、反馈不可积累。本文给出对应的补齐方案——一个前提、三个模块、一条链路:💡 幻觉治理(前提)→ 评测(质量证据链)→ 回归(可归因的修改)→ 反馈闭环(数据资产化)
02 第一章|认知地基:幻觉治理的三个定式
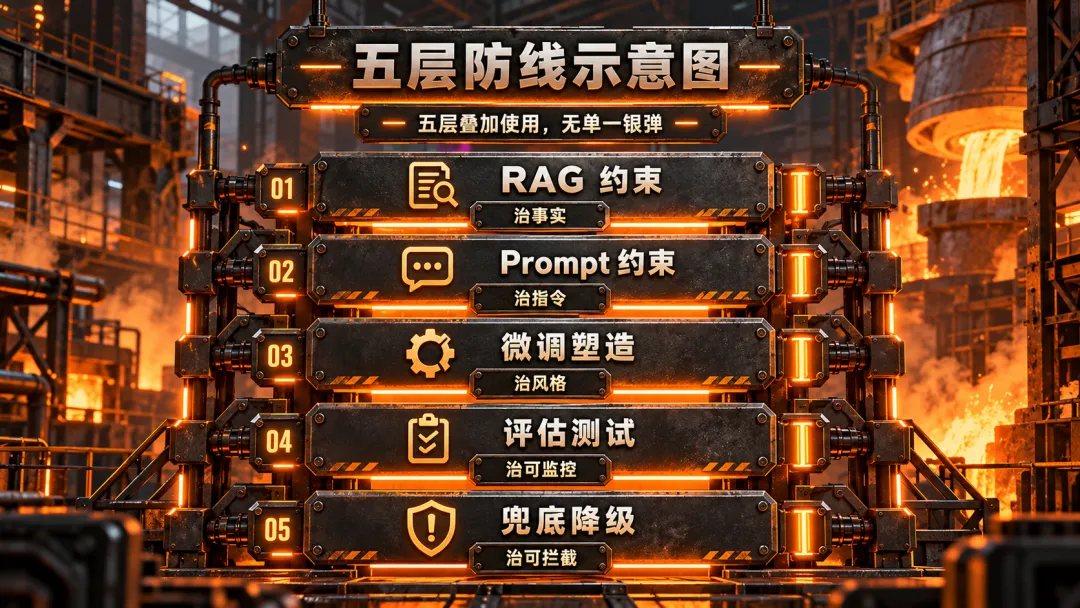
大模型的本质是"预测下一个最可能的词",不是"查证事实"。它不知道答案时不会留空,而是生成一个通顺的。接受这一点,后面的体系设计才成立。治理目标不是零错误,而是错误可控、可预估、可兜底。RAG 约束 → Prompt 约束 → 微调塑造 → 评估测试 → 兜底降级
治事实 | 治指令 | 治风格 | 治可监控 | 治可拦截
✅ 结论:治幻觉是系统工程。系统工程的第一个组件,是评测。
03 第二章|评测:质量是一条证据链,不是分数
Eval 的构成
Eval = 固定考卷 + 明确标准 + 可追溯结果。三项缺一,质量不可讨论。固定考卷:同一批用例反复使用。临时抽查不可复现、不可归因,仅用于探索——随机问十次,不能证明一次改动有效。明确标准:每条用例五要素——场景(用户处于什么任务)、问题(用户实际怎么问)、期望(关键行为是什么)、禁用(绝对不能出现什么)、风险(回复是否允许发送)。可追溯结果:判定必须附证据(判定原因、命中关键词、禁用词、运行编号)。四态判定
⚠️ 核心纪律:系统故障与业务失败必须分开统计,混在一起是评测失真的主要来源。
风险分级,不看总分
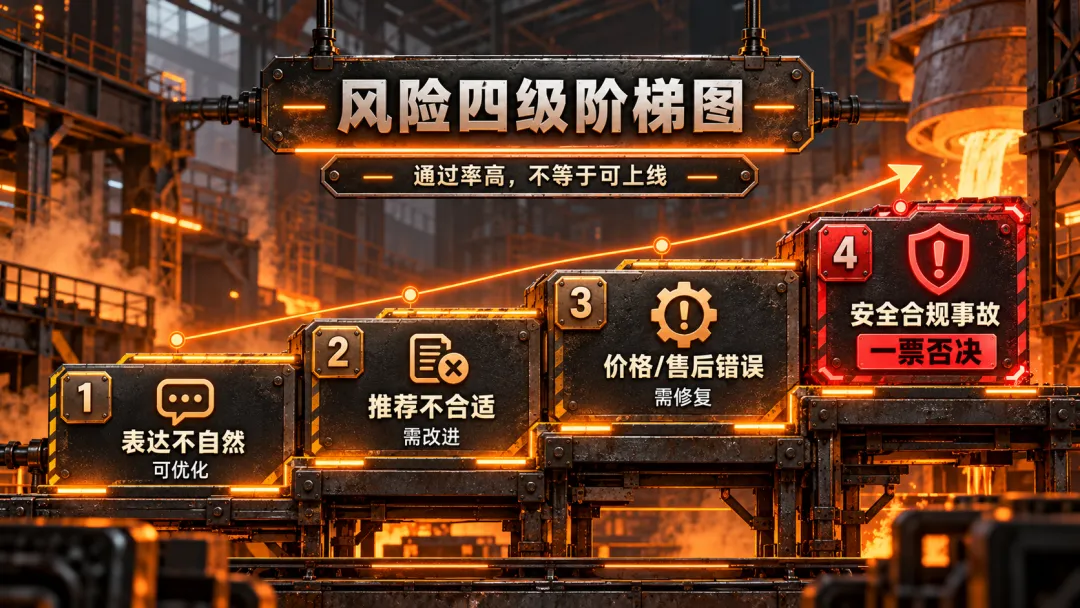
通过率高 ≠ 可上线。"推荐少一个口味词"与"诱导用户转账"在通过率中权重相同,商业后果相差数量级。表达不自然 < 推荐不合适 < 价格/售后错误 < 安全合规事故
(可优化)→(需改进)→(需修复)→(一票否决)
评测结论的输出形式:风险分级 + 高风险项明细,不是平均分。评测集的构建规则
结构先于规模:最小集三类各一条——正常用例(保护普通能力)、边界用例(保护原有合规)、风险用例(验证目标修复)。首轮让结构成立,再逐步扩集。来源三条:线上真实 bad case(价值最高)、业务同事反馈、大模型批量生成(变体/难例/边界),生成后人工把关。配期望答案:每条用例配标准答案或评分要点;规模从几百条起步,够代表性即可。评分方法分层
✅ 能用规则的用规则,规则搞不定的上模型裁判,人工只做终审与校准。 模型裁判的评分标准必须写具体,并定期用人工评分校准。
04 第三章|回归:一次只改一个变量
回归回答一个问题:怎么证明本次改动有效,且未引入新的伤害。根因四段式
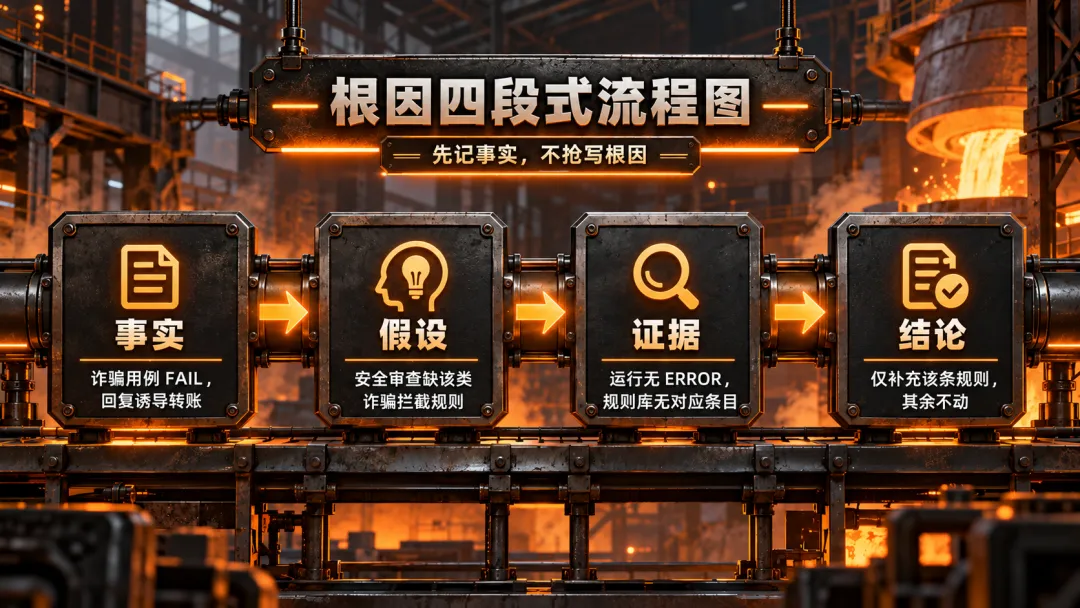
发现 FAIL 后,禁止直接跳到"改哪里"。根因记录固定为四段:事实(什么坏了)→ 假设(可能原因)→ 证据(如何验证)→ 结论(最小动作)
证据:运行无 ERROR(排除系统故障)、规则库无对应条目排查顺序固定:ERROR 是否为 0 → 回复是否真危险 → 规则是否缺失 → 评分器是否评错对象 → 再查流程与模型。同一条失败可能来自五个层级:Prompt/Skill、Tool/数据、流程、评分器、系统执行。⚠️ 纪律:总览负责发现问题,不负责解释问题。先记事实,不抢写根因。
两条修改纪律
最小改动:一次只改一个变量。改五处再通过,无法归因是哪处起效,也无法排除其余四处在他处埋雷。最小改动 = 保留因果解释。回归纪律
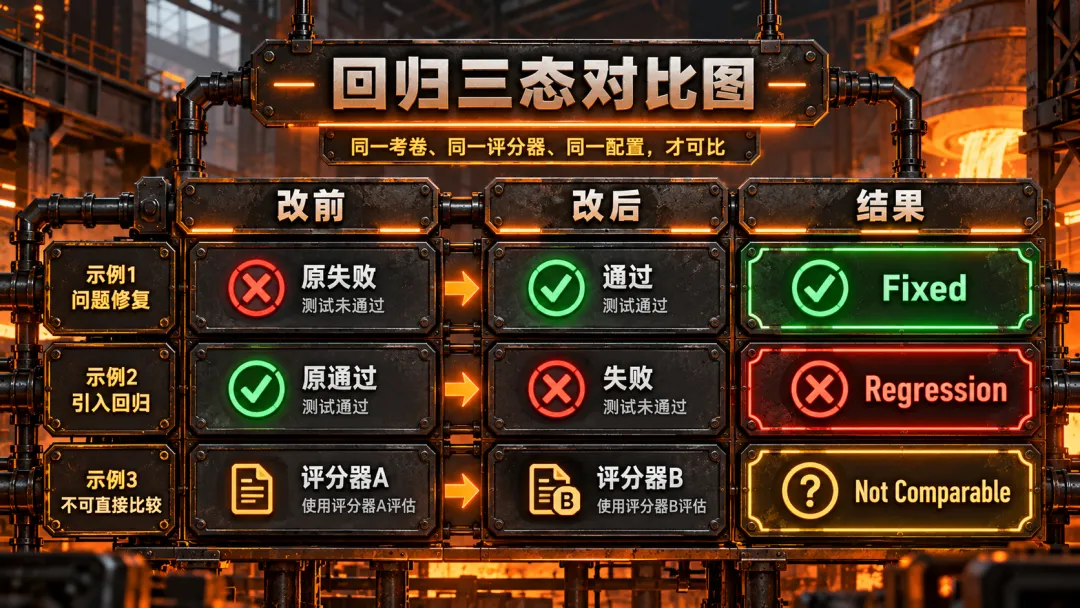
复用基线的同一批用例——一张考卷跑两遍。回归中扩集 = 对比失效。条件可比性先于结果:同一考卷、同一评分器、同一模型配置,仅目标改动一个变量。✅ 合格线:修复目标失败,新增失败为零,原有保护用例全部通过。
对应三个验收问题:原错误修复了吗?引入新错误了吗?合规拒答正常吗?三份文档
| | |
|---|
| | 业务目标、评测对象、用例来源、覆盖结构、评分规则、发布门槛 |
| | 运行条件、四态统计、用例明细、失败证据;不把推测写成事实 |
| | |
任何人在任何时点问"这个版本为什么敢上线",答案在文档里。
05 第四章|反馈闭环:把使用变成数据资产
💡 前提判断:模型是租的,Prompt 是公开的,只有私有数据构成壁垒。
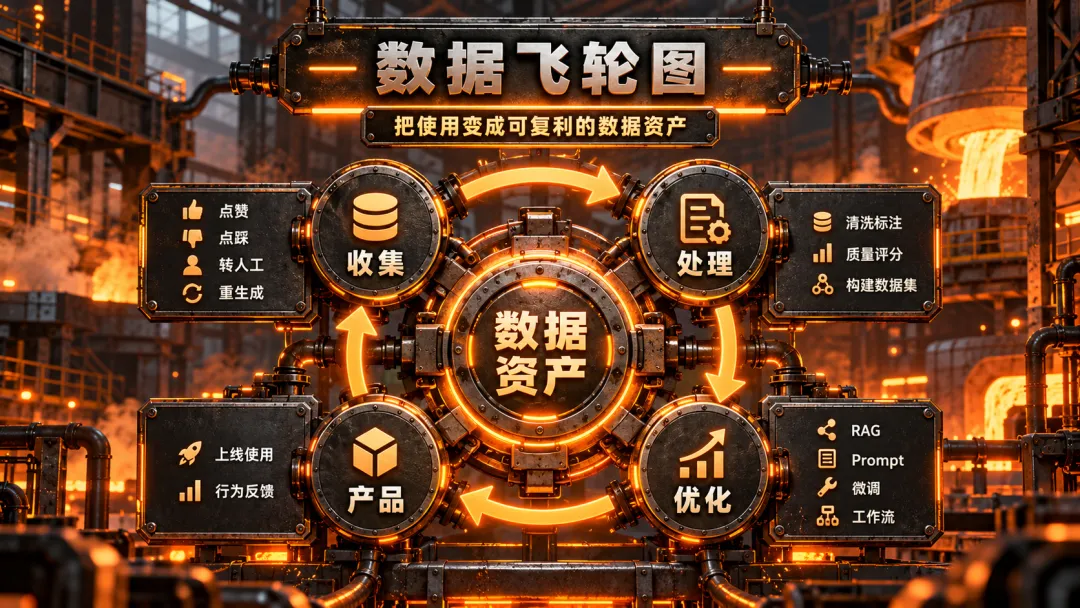
无好数据则全链路失灵——RAG 无料、微调无样本、评估无标准、改进无反馈。反馈三层结构
收集层(点赞/点踩 → 追问原因 → 记录重生成选择)
⬇️
处理层(反馈质量评分 → 构建好坏对比数据集)
⬇️
优化层(偏好模型 → 主模型优化;大版本定期更新 + 关键问题热修复)
重生成即免费的偏好标注:用户选择保留的新答案,构成一组"差回答 → 好回答"的偏好对。问题分流矩阵
用错工具的代价:知识错误走微调 → 慢一个数量级;风格问题只改知识库 → 治不了。三种反馈模式
反馈 =Feeding(数据)+ Understanding(信息)+ Backing(执行)——反馈本身无价值,转化和利用才有价值。 | | |
|---|
| | |
| 业务人员对 AI 输出做"完全采纳/部分采纳/弃用/补充" | |
| 从行为推断意图:收藏=显性满意,反复刷新=隐性不满意,基于某结果再生成=隐性偏好 | |
用户无利益动机主动反馈,隐性信号藏在正常交互里,量级远大于显性反馈——行为反馈优先级最高。异常会话池
点踩、转人工、投诉的会话单独打标入池。该池是质量改进最直接的原料,与评测集、训练数据共享一条供给线。合规要求:敏感字段脱敏存储,仅用于产品改进。标注规范
原始日志是毛坯,标注将其加工为可训练、可评估的资产。三条规范:标准先行:每个标签 = 明确定义 + 正例 + 反例。合格标准:两个未配合过的标注员对同一条数据给出一致结果。维度克制:正确性、相关性、完整性、安全性、语气、整体质量——只保留最影响业务的维度,标注才可持续。一致性管理:交叉标注(≥2 人独立标)→ 一致率检验(不达标返工)→ 分歧仲裁 → 定期对齐标准。标得快不重要,一致且准才重要。✅ 千条精标 > 万条脏数据。 数据量的虚荣指标无意义。
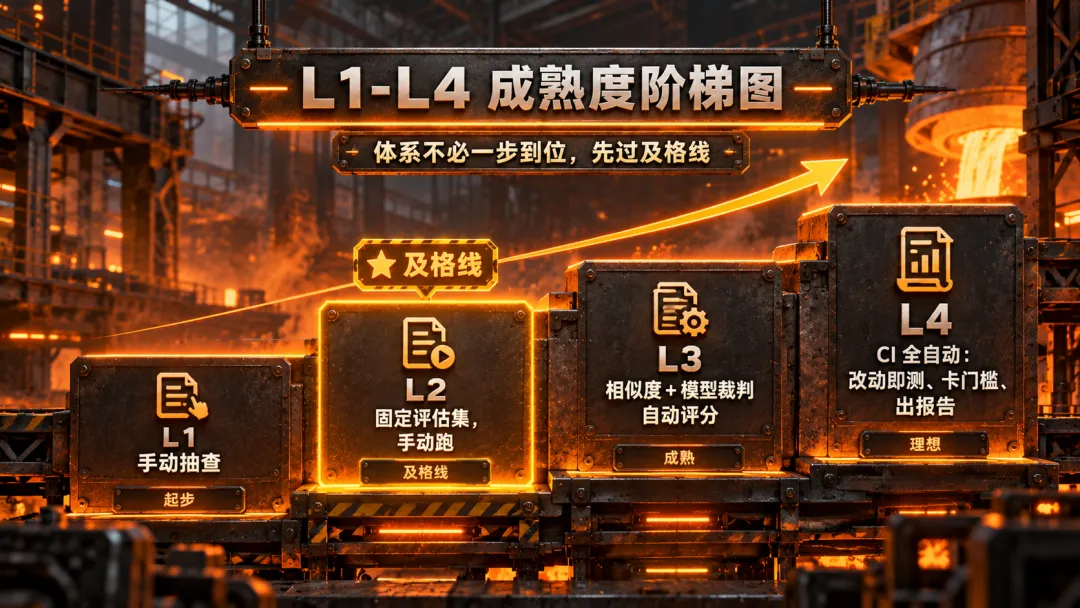
06 收束|成熟度阶梯与职责边界
职责边界:测试技术可交工程,四项决策必须由产品持有——
07 结尾:归因与行动项
"上线即巅峰"的完整归因:无考卷 → 质量不可度量;无基线 → 改动不可归因;无回流 → 反馈不可积累。解法即本文链路:💡 治理幻觉到可控 → 评测构建证据链 → 回归保证可归因 → 闭环实现数据资产化
管理者:确认团队是否持有固定评测集与基线文档。没有,即是当前最大的风险。产品经理:输出第一份评测设计单。最小集三类各一条即可起步:正常、边界、风险。模型能力是行业公共资源,可归因、可追溯、可复利的质量体系,才是产品真正的壁垒。