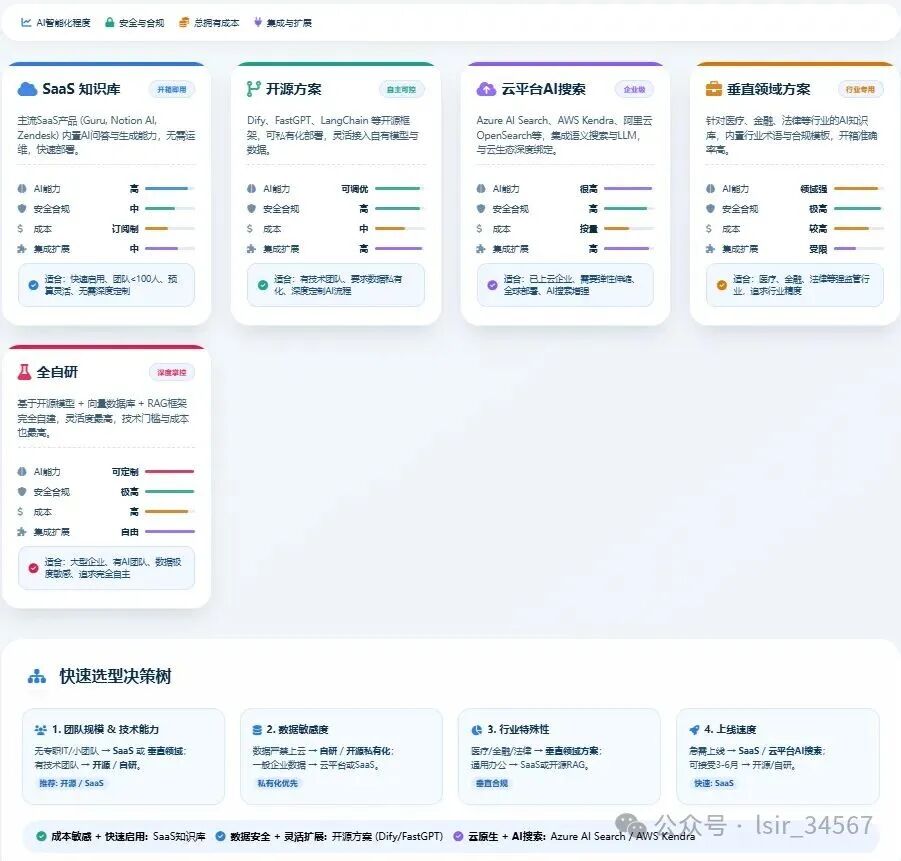
大模型落地企业,最实在、最容易见效的场景之一,就是垂直领域知识库。
标书、合同、工艺文档、规章制度、技术手册——这些文档里有大量专业术语和私有知识,通用大模型没见过、答不准,还容易一本正经地胡说八道。于是 RAG(检索增强生成)成了标准解法:把企业自己的文档喂给系统,让大模型"开卷考试"。
好消息是,如今开源知识库产品已经相当成熟,RAGFlow、Dify、MaxKB、FastGPT……随便拉一个出来,官网截图都很好看,都号称"支持知识库问答"。
坏消息是,真正用起来,差距大到离谱。有的产品上传扫描件直接变乱码,有的产品检索永远召回不到关键页,有的产品部署完才发现许可证根本不敢商用。
这篇文章,就是来解决这个问题的:我们把 8 款主流开源 RAG / 知识库平台,放在 34 个维度下横向对比,再加上我们自己在项目里踩过的坑,希望能帮正在负责选型的项目负责人、技术负责人,把这道选择题做对。
先说结论,文档解析与混合检索最强的主推 RAGFlow;求快选 Dify;轻量起步选 MaxKB;但千万别忽略 Onyx 的连接器能力。下文展开。
unsetunset一、选型之前,先想清楚三件事unsetunset
1. 知识库不是"一个聊天框",而是一条链路
很多负责人对知识库的想象是:上传文档 → 提问 → 得到答案。但背后真正决定效果的,是一条完整的链路:
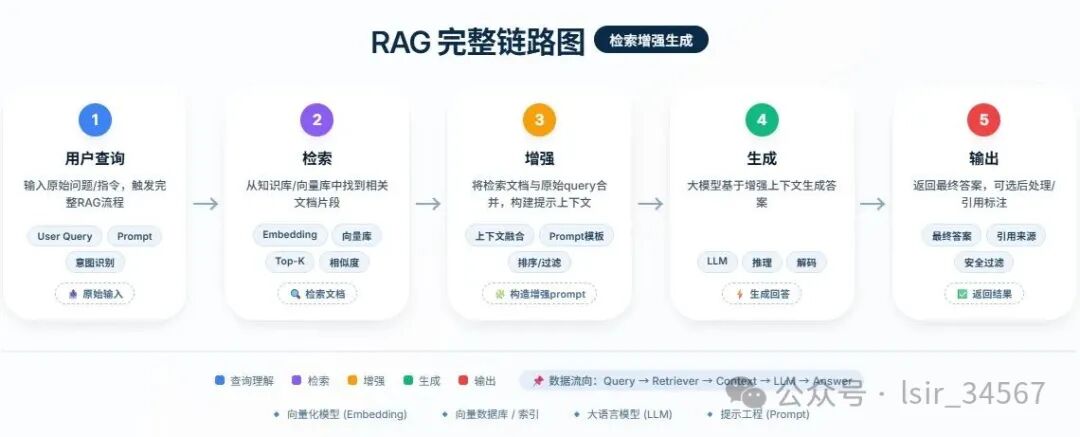
文档解析 → 文本切片 → 向量化 → 检索召回 → 重排 → 生成回答 → 引用溯源。
链路上任何一环拉胯,最终体验都会崩。而企业知识库翻车,八成翻在解析和检索这两个环节,而不是大模型本身。选型时要盯的,恰恰是这条链路的每一环。
2. 框架 ≠ 产品
LangChain、LlamaIndex、Spring AI、LangChain4j 这些是框架,不是产品——没有管理后台、没有权限体系、没有开箱即用的界面,用它们本质上是从 0 到 1 自研。这条路适合有长期投入打算的团队,不适合"三个月要上线"的项目。
本文对比的 8 款,都是部署起来就能用的开源产品。框架自研路线放到文章第五部分讨论。
3. 你的场景,决定每个维度的权重
34 个维度不是每条都同等重要,先对号入座:
- 重文档场景(标书、合同、工艺文档、技术手册):文档解析、混合检索权重拉满;
- 重分发场景(多部门共用、多应用接入):工作流编排、权限与多租户优先;
- 数据敏感场景(数据不出域):私有化部署、许可证条款优先;
- 信创场景(麒麟 + 鲲鹏/海光):ARM 架构适配优先。
unsetunset二、8 款候选:一分钟认识它们unsetunset
| | | |
|---|
| RAGFlow | | | |
| Dify | | | |
| MaxKB | | | |
| FastGPT | | | |
| WeKnora | | | |
| QAnything | | | |
| Onyx | | | |
| AnythingLLM | | | |
几点补充说明:
- RAGFlow(InfiniFlow 开源)的招牌是 DeepDoc 深度文档理解——版面分析、表格结构识别、OCR 一应俱全,在开源阵营里属最强一档;
- WeKnora 2025 年 8 月开源,GitHub 星标已超 18k,增长很猛,但项目年轻,生态和插件还少;
- Onyx 的强项是连接器——Confluence、飞书、网盘这些企业知识真正存放的地方,它都能直接接;
- QAnything 自带 BCEmbedding(中英双语优化),PDF 图表和图片问答处理得好。
unsetunset三、34 个维度里,真正拉开差距的是这五处unsetunset
8 款产品 × 34 个维度的完整矩阵塞进手机没法看,这里只讲决策关键处。图例统一为:● 强 / 支持,◐ 中等 / 部分,○ 弱 / 无。
1. 文档解析:第一分水岭,也是宣传水分最大的地方
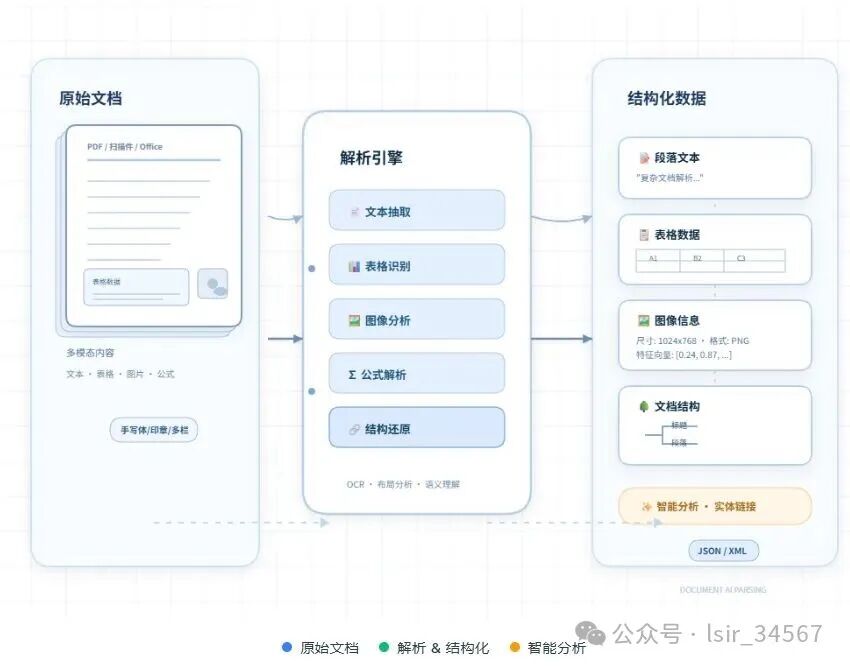
企业的真实文档,从来不是干净的 txt:盖着红章的扫描件、跨页大表格、图文混排的技术手册、几百页的合同。这一关过不了,后面检索再强也是空中楼阁。
| | |
|---|
| | DeepDoc 版面分析 + 表格结构 + OCR,开源阵营天花板 |
| | |
| | |
| | |
| | 深度解析依赖 doc2x 云服务(敏感场景要本地化替代) |
| | |
| | |
切片策略是解析的孪生兄弟,差距同样明显:RAGFlow 有十余种模板化切片(论文、合同、简历、问答、表格、书籍、法律等),可配分隔符、chunk 长度、自动关键词;FastGPT 支持逐段手动编辑与合并;Dify 只有通用 / 父子 / Q&A 三种;而 AnythingLLM 只有 chunk size 和 overlap 两个参数——文档里写"支持自定义"的,实测往往就这两个参数。
经验提醒:这个维度是各家宣传与实际差距最大的地方。用同一批难例文档(扫描件、跨页表格、图文混排、长合同)实测,别信官网截图。
2. 检索链路:混合检索、重排与引用溯源
纯向量检索在中文企业文档上经常拉胯(专有名词、型号、编号都容易召不回),**"关键词 + 向量"混合检索 + 重排**才是可靠配置。
两个要点:
- 区分"两种检索都提供"和"真正做了融合排序"——让厂商演示同一个问题开关混合检索前后的召回差异;
- 引用溯源要看能否定位到页码和原文位置,只给一个"文件名"的,等于没做引用。答错了用户连核对的地方都没有。
3. 编排与权限:企业落地的两道硬门槛
工作流编排上,Dify 的 Chatflow / Workflow(可视化 DAG、条件分支、循环、并行)是 8 款中最成熟的;FastGPT 的 Flow 画布节点丰富;RAGFlow 有编排但偏知识库处理链;WeKnora 只有 ReAct Agent 无可视化编排;QAnything、AnythingLLM 基本没有。
权限与多租户,是很多团队吃过亏的地方:
| | |
|---|
| | |
| | |
| | |
| | |
| | |
| ◐ admin / manager / default 三级 | |
| | |
| | |
经典翻车点:企业知识库的第一个事故,往往不是"搜不到",而是"不该看到的人搜到了"。实测方法很简单——同一问题、不同账号,看返回是否不同。另外注意:**"工作空间"不等于多租户**,要看数据隔离级别、能否跨租户检索、资源是否共享。
4. 部署与资源:别小看运维账
| | |
|---|
| | |
| | PostgreSQL + pgvector,4C8G 起 |
| | MongoDB + PostgreSQL,4C8G |
| | PostgreSQL + Redis,4C8G 起 |
| | |
| | ES + MySQL + MinIO + Redis,建议 16GB+ 内存 |
| | |
| | |
两个细节值得单独说:
- 信创适配:WeKnora 是 Go 编译,ARM 容器容易;MaxKB 轻,ARM 编译相对容易;Onyx 的 Vespa 在 ARM 上部署困难,麒麟 + 鲲鹏环境要重点验证。ARM 镜像有没有官方构建,是很多信创项目的第一道坎。
- 向量库可替换性:Dify、FastGPT、RAGFlow 都支持切换向量库(Milvus / PGVector 等),RAGFlow 默认的 Elasticsearch 是 SSPL 许可,使用无碍但发行有约束,可切换自研引擎 Infinity。绑定死的(如 Onyx 绑 Vespa)后期想换底座就难了。
5. 开源协议:别等上线了才发现踩雷
按约束强度从高到低排:
- QAnything(AGPL-3.0):传染性最强。内网自用一般不触发,但只要对外提供网络服务且修改过代码,就要开源全部修改;
- MaxKB(GPL-3.0):内部部署不分发通常不触发;一旦随产品交付给客户,需一并提供源码;
- Dify / FastGPT(Apache-2.0 + 附加条款):附加条款涉及多租户 SaaS 运营、Logo 版权等,内部使用无碍,对外商业化前必须逐条读;
- RAGFlow(Apache-2.0):最宽松的一档,专利授权明确,适合二次开发后闭源分发;
- WeKnora / Onyx / AnythingLLM(MIT):几乎无约束,最省心。
许可证随时会变。落地前拉取目标版本的 LICENSE 原文,不要看 README 摘要。
unsetunset四、按场景加权:一张评分表看排名unsetunset
单纯比功能多少没有意义,关键看你的场景给哪些维度加权。下面这份加权评分来自一个真实项目:Java 主技术栈、全私有化部署、以标书/合同/工艺文档等重文档为主的内部智能库。权重分配:文档解析 20、混合检索与重排 15、二次开发友好度 15、引用溯源 10、权限与多租户 10、工作流编排 10、协议友好度 10、资源占用 5、会话与嵌入 5。
| | | |
|---|
| RAGFlow | 400 | | |
| WeKnora | | | |
| Dify | | | |
| MaxKB | | | 分数吃亏在 GPL-3.0,内网部署实际可用性更高 |
| FastGPT | | | |
| Onyx | | | |
| AnythingLLM | | | |
| QAnything | | | |
读这张表,有四件事必须说清楚:
- QAnything 分数低不代表技术差。它的文档解析和引用溯源其实相当能打,扣分在权限、多租户、可编排性——也就是说,它不适合做"通用知识库系统"的主体,但值得研究学习;
- Onyx 的价值不在表内。它的强项是连接器(Confluence / 飞书 / 网盘)——企业存量知识多半不在上传的文档里,而在这些协作工具里,这恰恰是评分维度覆盖不到的;
- MaxKB 的分数被 GPL 压低了。只在公司内网部署、不分发,GPL 义务基本不触发,实际可用性高于表内得分;
- 这份评分是主观初判,只能用来收敛讨论。解析准确率、召回命中率、引用正确率三项实测数据一出来,排名很可能变。
所以一句话结论是:主推 RAGFlow(文档理解 + 混合检索最强);求快选 Dify(编排与权限最成熟);轻量起步选 MaxKB(部署最省、中文体验最好);无论选谁,都研究一下 Onyx 的连接器。
unsetunset五、进阶打法:开源引擎 + 自研应用层的组合拳unsetunset
到这里你可能已经发现一个矛盾:RAGFlow 引擎能力最强,但工作流编排、权限粒度却不如 Dify;Dify 编排最成熟,文档解析又是硬伤。
真实项目里的解法,通常不是二选一,而是组合:
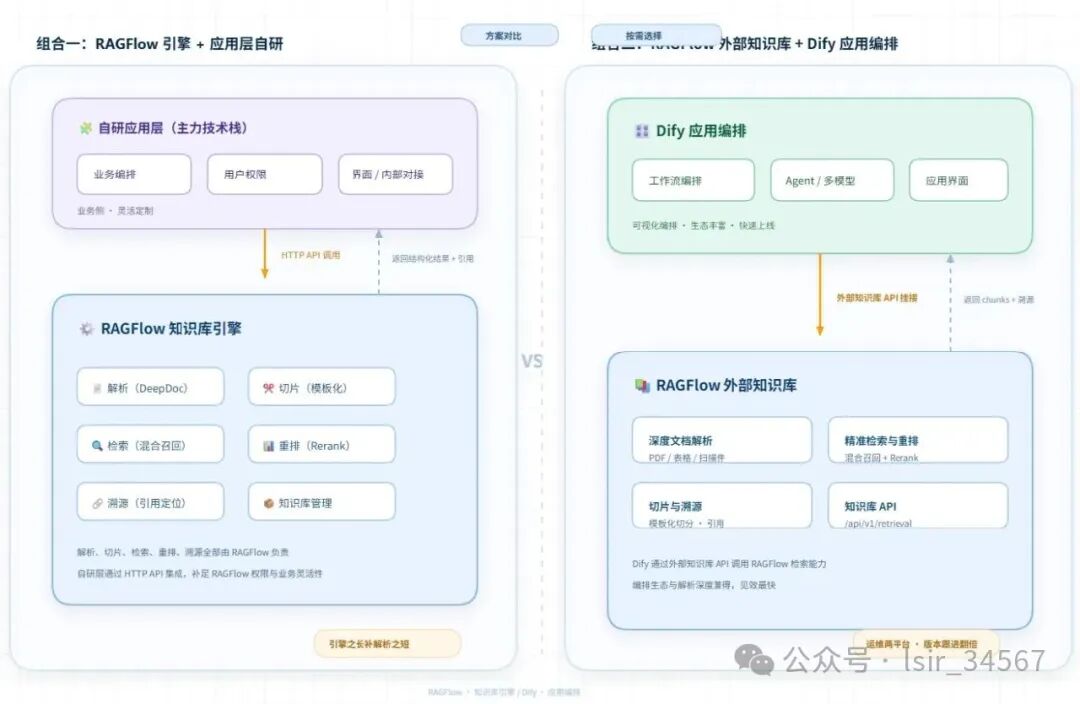
- 组合一:RAGFlow 做知识库引擎 + 应用层自研。解析、切片、检索、重排、溯源全部交给 RAGFlow(通过 HTTP API 集成),业务编排、用户权限、界面、内部系统对接用自己团队的主力栈自研。引擎之长补自研解析之短,自研之灵活补引擎权限之粗。
- 组合二:RAGFlow 做外部知识库 + Dify 做应用编排。Dify 通过外部知识库 API 挂接 RAGFlow,编排生态与解析深度兼得,见效最快——代价是同时运维两个平台,版本跟进成本翻倍。
如果你们的场景和上文评分场景接近(重文档、全私有化、有 Java 团队),给你一个真实的工期参考(3 人团队:2 Java + 1 Python):
全程 AI 辅助开发(结对编程、测试与手册自动生成)可以把全周期压到约 4.5~7 个月。但要清醒:AI 压缩的是编码和文档环节,部署实测、评测调优、信创验证、评审决策几乎不可压缩——对外报人工基准,对内按 AI 口径推进,别用未经验证的效率假设去立军令状。
unsetunset六、落地之前,把这 10 个"宣传坑"实测一遍unsetunset
最后是全文最重要的部分。开源产品官网说的话,和私有化环境里的实际表现,中间隔着一整条马里亚纳海沟。无论你选哪款,上线前务必逐项实测:
- 文档解析能力:用同一批难例(扫描件、跨页表格、图文混排、长合同)跑,别信官网截图;
- 切块可配置粒度:写"支持自定义"的,实测往往只有 chunk size / overlap 两个参数;
- 混合检索真假:区分"两种检索都提供"和"真正做了融合排序",看同一问题开关前后的召回差异;
- 引用溯源:看能否定位到页码和原文位置,只给文件名的等于没做;
- 权限隔离:同一问题、不同账号,返回必须不同——这是企业知识库第一翻车点;
- 多租户隔离:看数据隔离级别、能否跨租户检索,"工作空间"不等于多租户;
- 可评测性:除 Onyx 与 Dify 有部分能力外,其余基本要靠 RAGAS / DeepEval 自建评测管线,这部分工作量要单列;
- 增量构建:测三件事——新增、更新(同文件新版本)、删除。多数产品只做好了新增;
- 许可证原文:拉取目标版本的 LICENSE 原文逐条读,特别是 Dify / FastGPT 的附加条款;
- 信创适配:ARM 镜像有没有官方构建,在麒麟 + 鲲鹏上过一遍。
实操上,建议用 6~8 周做一轮带里程碑的研究验证,而不是会议室里拍脑袋:
- M0(0.5~1 周)建评测基线:30~50 份真实难例文档 + 50~100 条问答对(事实型 / 汇总型 / 跨文档 / 表格题),这一步决定后面所有对比的含金量;
- M1(1 周)调研初筛:架构、许可证、社区活跃度、资源需求走查,顺带核查数据出域风险点(云端解析服务、插件市场外联);
- M2(2~3 周)部署实测:4~5 个方案私有化部署,同一批评测文档过"解析 → 切片 → 检索"全链路,开关式对比检索与重排;
- M3(1.5~2 周)效果评测:召回命中率、引用正确率、端到端准确率跑分,外加并发压测和 100MB+ 长文档验证;
- M4(1 周)二开与信创验证:代码走读、API 覆盖度、中间件替换点、麒麟 + 鲲鹏预验证,每个候选做一个最小二开 POC;
- M5(1 周)报告与评审:评分卡 + 评测数据 + 风险清单 + 推荐路线,组织评审会拍板。
unsetunset写在最后unsetunset
选型这件事,最容易犯的错,是用偏好拍板,而不是用数据拍板。
"我们团队熟 Python,就用它吧""这个产品 GitHub 星标多,肯定没错"——这类决策路径,往往在扫描件解析翻车、权限串号事故之后才被推翻。与其那时候返工,不如先花 6~8 周,用同一批评测文档把候选拉出来遛一遛。
最后送你三句实在话:
- 存量知识多半不在你上传的文档里,而在 Confluence、飞书和网盘里——连接器能力别忽略;
- 框架自研 vs 成品二开,本质是"自建程度 vs 交付速度"的权衡——先 POC,再用二开走读的真实工作量拍板。
本文数据基于公开文档、GitHub 仓库与社区资料整理(评估基准截至 2026 年 10~11 月),并叠加了我们在私有化项目中的实测经验。开源产品迭代很快,评分仅用于收敛讨论,不构成选型依据——最终请以你自己的评测数据为准。
如果这篇文章帮你理清了思路,欢迎转给正在做知识库选型的同事。有具体的场景问题,也欢迎留言讨论。
