在生成式模型的对比测评里,整个行业越来越偏向依靠主观的人类偏好排序。但只看主观评价会产生很多盲区,其中很关键的一点就是对用户偏好的保真度。如果一张图看着效果不错,却换掉用户指定字体、改动配色方案,或是对画面做不必要的修改,该怎么办?
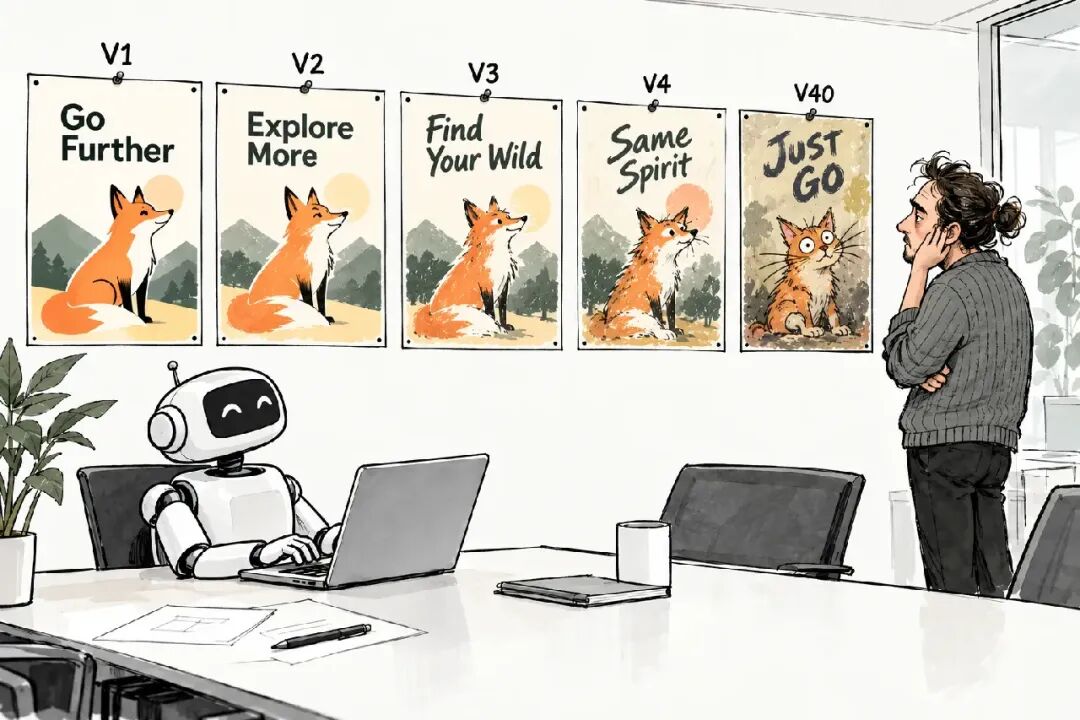
人工标注者很可能忽略这类问题,但用户能明显察觉到。即便是高分模型,我们也经常收到这样的疑问:多轮迭代多少次之后,风格就开始跑偏? 用户反复修改标题、调整组件等内容时,Logo 或是画面其他地方会产生细微改动,改动不断累积,最终画面效果和用户想要的风格背道而驰。
客观指标可以把这种 “风格偏移” 量化。它能够算出改动幅度,帮助我们看清多次迭代之后偏差会如何叠加放大。
我们推出了全新评测基准 VybBench,用来客观衡量模型能否守住用户的风格偏好。用户偏好的核心要素包含字体、色彩、图像元素。这套基准从三个维度评测模型能力:
- 执行非破坏性编辑,不改动画面里需要保留不变的区域(编辑保真度)
评测方法
字体保真度
为量化模型按指定字体生成文字的能力,我们选取了 145 款谷歌免费字体。针对每一款字体,选定一个不同单词交由模型生成。我们借助 Python 图像处理库 Pillow,程序自动生成基准真值图。之后让各个模型在纯色背景上,用指定字体生成这个单词。 由于各个模型输出的文字大小、位置各不相同,我们对所有输出图做裁剪与缩放,尽可能对齐基准真值图,最后计算交并比(IoU)。计算方式:生成图与真值图中文字墨迹重合像素数量,除以两张图文字墨迹的总像素数量。得分 100% 代表完全匹配。
模型具有随机性,因此针对每一款字体,每个模型都会生成 3 次,分别单独打分。这套评测方式存在一个明显局限:缩放、固定分辨率、抗锯齿都会引入噪声。我们通过生成不同大小、位置的真值图并计算 IoU,量化了噪声带来的影响,得到基准 IoU 均值 94.4%。模型得分越接近这个数值,代表在这套评测方案下,字体保真能力越强。
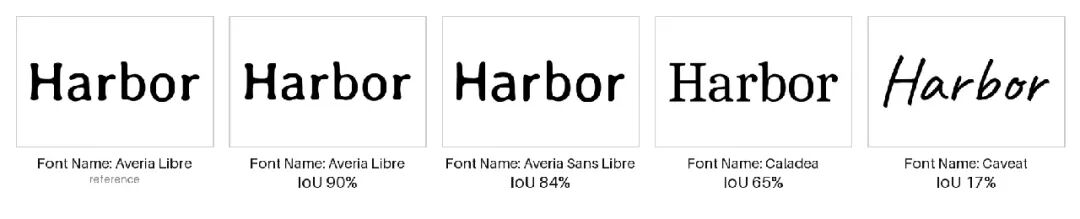
下图可以直观展示不同字体对应的 IoU 得分规律:字体之间差异越大,得分越低。
我们用不同字体打印单词 Harbor。针对每一种字体,将它和参考样本(使用 Averia Libre 字体的 Harbor)对比,计算 IoU 得分。和预期一致,字体差异越大,IoU 得分越低。
色彩保真度
同理,为量化模型生成指定颜色的能力,我们选取了 100 组不同的十六进制 RGB 色值。对每一组色值,要求模型生成填充该色值的矩形。随后使用 Pillow 计算生成色彩与目标色值之间的差值。 每一次测算,我们分别取 RGB 三个通道生成值和目标值的绝对差值(取值范围 0–255),再取三个通道里的最大值作为结果。
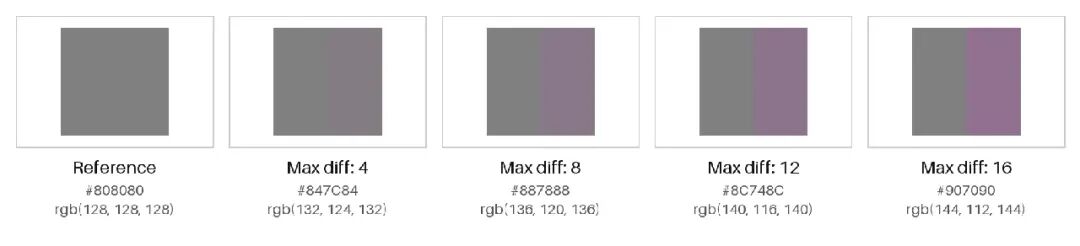
我们选用通道最大值作为评判标准,原因是任意一个通道发生偏移,都会让最终颜色偏离用户设定。下图可以直观展示不同最大差值对色彩观感的影响。
我们以参考色 RGB (128,128,128) 为例,展示通道最大差值逐步增大时,人眼感知到的色彩会如何变化。
同样,由于模型具备随机性,每个颜色我们都会让模型生成 3 次,分别独立打分。
编辑保真度
最后,为衡量模型精准局部编辑的能力,我们采用如下方案:所有模型使用同一张输入原图。分层式模型以图层形式读取输入,而只支持平面图像的模型则读取 PNG 原图。我们要求每个模型执行完全相同的编辑指令,之后统计发生变化的像素数量。为防止模型直接返回原图、钻评测规则的空子,我们使用大语言模型评审员判断编辑指令是否真正执行。
这套评测一共包含 200 组编辑任务,覆盖多种类型:改色、增加 / 移除素材、修改装饰、替换图片 / Logo、修改文字。和前面一样,每组编辑任务生成 3 次,单独打分。
你可能会好奇:为什么我们要统计像素变化占比?我们早期尝试为每一项编辑任务划定允许改动、禁止改动的区域,但很快发现这套方案难以规模化;基于 Segment Anything 3(SAM 3)的实现方式也容易出错。因此我们改用上面这套方案,分开输出两项指标:像素改动占比、编辑通过率。我们刻意记录所有幅度的像素变动,以此衡量模型在多轮迭代下的表现。
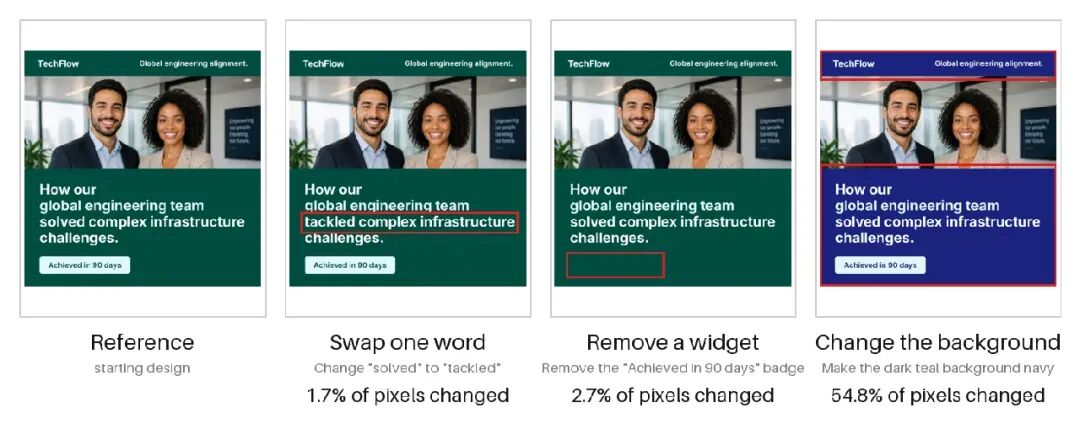
下图直观展示:几类理想的无损精准编辑,对应的像素改动规模。红色框标出改动区域:
图中展示不同编辑操作对应的像素改动占比。这里所有编辑都是程序层面的无损编辑:除目标区域外,画面其余部分完全不发生改动。
局限性
本评测基准存在以下局限: 第一,谷歌字体广泛用于线上视觉素材,模型大概率已经见过这些字体。因此模型在自定义字体上的表现,还无法通过该测试充分反映。 第二,当前基准只评估单次编辑,无法捕捉多轮迭代过程中风格偏移的走向。我们计划在后续版本中解决这两个问题。