QUOTE
训练 loss 不等于模型能力。评价一个模型,需要独立的指标、基准,以及对结果可信度的判断。
本篇讨论如何评价模型:困惑度的定义与适用范围,MMLU 等基准的评分方法,以及数据污染、评测配置和统计不确定性对结果的影响。本文实验使用 Qwen2.5-0.5B;引用论文中的结果另行注明,实验脚本与数据保存在同目录下。
本文看点
01
自然文本与随机文本的困惑度差异:这个指标衡量什么
02
100 道 MMLU 实测:选项顺序对准确率的影响
04
100 题下约 5 个百分点的标准误:小幅分数差异怎么判断
一 LoRA 扩展到全部线性层(含 FFN),如何比较格式达标率和回测 loss
不能仅根据可训练参数数量预测结果。上一篇的 rank 对照只表明,几种配置都通过了小样本格式检查,并未检验完整的任务质量。扩展目标模块会改变更新矩阵的数量和作用位置,但不必然加重遗忘。
实验应固定数据、训练预算和评测方法,记录 rank、alpha 与学习率,并使用多个随机种子,分别评价任务正确率、格式遵循和通用任务表现。
二 SFT 数据中混入格式规范但内容不准确的长回答,模型会学到什么
模型可能学习冗长的回答风格和错误内容。在按有效 token 汇总损失的配置下,长样本通常贡献更多预测位置,但这不等于训练目标显式规定「长回答更好」;实际权重还取决于损失归一化方式。
SFT 模仿错误样本,与策略利用奖励模型缺陷,是不同问题。成对偏好能提供相对质量信号,却不能自动消除长度偏差或保证答案正确,仍需数据校验和独立评测。
三 SFT 与 RL 对格式和推理各有什么作用;如何比较不同训练流程
SFT 可以学习输出格式,也可以学习参考解题过程;RL 可以利用正确性和格式奖励,两者没有固定的功能分工。SFT Memorizes, RL Generalizes(arXiv:2501.17161)在算术游戏和视觉导航的特定实验中发现,结果奖励 RL 的分布外泛化优于 SFT,这不意味着所有 SFT 都只能记忆。
比较「仅 SFT」「直接 RL」和「SFT 后 RL」时,应控制基座、数据与计算预算,在未见任务和规则变体上评测。
本篇讨论如何选择指标、设计实验,并据此判断模型在目标任务上的实际表现。
01
TRAINING LOSS
训练 loss 的适用范围
自回归预训练通常优化给定前文时下一个 token 的负对数似然。训练 loss 反映模型对训练文本的拟合程度,但不能作为模型能力的综合评分。
它有三个限制:训练目标与实际任务可能不同,语言建模损失没有直接评价回答正确性或指令遵循;训练集上的低损失可能来自过拟合,不能代替独立测试;按 token 平均的损失受 tokenizer 切分方式影响,跨 tokenizer 的数值不能直接比较。同一模型在不同数据集上的 loss,也需要结合数据分布和难度解释。
评测(evaluation)需要明确任务、样本和评分规则,并固定模型输入与运行配置。结果回答的是模型在这些条件下的表现,而非脱离评测条件的通用能力排名。
困惑度(Perplexity,PPL)是平均负对数似然的指数,它是目标 token 条件概率几何平均的倒数,不能解释为模型实际在多少个词之间选择。使用自然对数时,平均负对数似然的单位为 nat;除以 ln2 对应 bit/token。
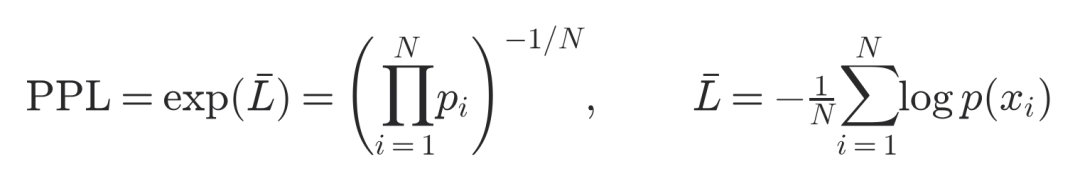
对 N 个有效预测位置的负对数似然取平均,再取指数;本文脚本采用因果语言模型的标签移位,首个输入 token 不计入预测损失
对同一个 Qwen2.5-0.5B Base 模型输入五种文本,得到以下结果:
图 1 · 同一个模型,五种文本的困惑度(Qwen2.5-0.5B 实测)
随机文本的 PPL 高于自然文本,说明模型对这些随机组合赋予了更低的条件概率。中文句子乱序后,PPL 从 10.34 变为 11.13,变化较小;在这个样例中,句内文本不变,句子重排对平均预测损失的影响有限。但自回归概率也依赖跨句上下文,PPL 并非只衡量局部连贯性,也不能单独评价全局逻辑。
中英文样例的 PPL 分别为 10.34 和 9.00;两段文本的内容、长度与切分不同,不能据此判断模型的两种语言能力相当,或推断训练数据比例。
跨模型比较 PPL 时,需要统一 tokenizer、测试文本、有效预测位置和上下文处理方式。不同切分改变了每个预测单位,因此 PPL 8 与 PPL 12 未必可比;切分更细也不保证 PPL 必然更低。跨 tokenizer 时,可以将文本的总负对数似然换算为 bits per character(BPC) 或 bits per byte,统一归一化单位;这仍要求相同文本、字符或字节计数约定,以及一致的评测设置。
基准(benchmark)由任务数据与评价规则构成。知识问答、数学推理和代码生成需要不同的样本与指标,不能仅用语言建模损失代替。
MMLU(arXiv:2009.03300)包含 57 个学科的选择题,覆盖数学、医学等领域。C-Eval(arXiv:2305.08322)是中文知识评测基准,包含 52 个学科、13,948 道四选一题。GSM8K(arXiv:2110.14168)包含约 8,500 道小学数学应用题,通常评价生成答案的正确性。EleutherAI 的 lm-evaluation-harness 是常用评测框架之一,具体结果仍取决于任务定义、版本和配置。
本文从 MMLU 测试集随机抽取 100 题,固定种子,比较原始选项顺序与随机重排后的准确率;重排后同步映射正确答案。两个模型都使用普通文本输入,Instruct 未套用 chat template。脚本从合并 dev 集取前 5 题,作为所有测试题的统一前缀,并非按学科提供示例的标准 MMLU 5-shot 协议。下面展示常见选择题提示的结构示意,不是实验输入的逐字记录:
The following are multiple choice questions (with answers)about abstract algebra.Question: Find the degree for the given field extensionQ(sqrt(2), sqrt(3)) over Q.A. 0 B. 4 C. 2 D. 6Answer: B( ··· 共 5 道例题 ··· )Question: What is the smallest prime factor of 87?A. 3 B. 29 C. 2 D. 87Answer:
图 2 · 选择题提示的结构示意:例题前缀 + 题尾停在「Answer:」
脚本在「Answer:」之后比较四个候选续接的分数,候选字符串为「 A」「 B」「 C」「 D」。前导空格和 token 边界都会影响评分。当前实现取候选编码的首个 token,因此需要验证每个候选是否为单 token;若候选由多个 token 构成,应计算完整续接的条件对数概率,不能只比较首个位置。复现时应记录实际 token ID、候选字符串和提示模板。
图 3 · MMLU 100 题实测:每题独立均匀随机选择时,期望准确率为 25%
原始顺序下,Base 为 44%,Instruct 为 36%;在本文的提示与候选概率评分配置下,Instruct 的准确率较低。这不足以解释为后训练降低了知识能力,也不能证明生成式评测一定会反转结果。选项重排后,Base 为 45%,Instruct 为 51%。两次模型评测使用的随机重排并不相同,因此不能直接比较两者对同一组排列的敏感性,还需要共享排列、多次重排及不同提示的实验。分数同时取决于模型、题集和评测配置。
在独立同分布伯努利近似下,准确率的标准误定义为:
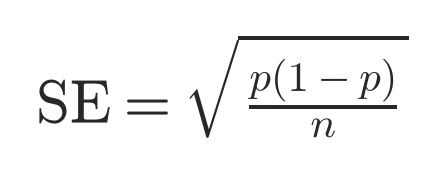
p 为准确率,n 为题数;p=0.44、n=100 时,标准误约 5 个百分点,95% 正态近似区间约为 ±9.7 个百分点
但比较同一批题的两种配置,应使用配对结果。Base 有 11 题由对变错、12 题由错变对,精确 McNemar 检验 p=1.0,总分接近不能证明逐题结果稳定;Instruct 有 5 题由对变错、20 题由错变对,检验 p≈0.004,支持这次重排配置下的差异。结论仍限于当前样本和配置,不能以两个单独置信区间或固定分差阈值判断所有榜单差异。
另一种候选评分方式,是计算完整答案文本的条件对数概率。由于序列概率由逐 token 概率相乘得到,长度不同的候选可能产生长度偏差,因此部分任务使用归一化分数。lm-evaluation-harness 中 acc 通常表示原始候选分数所对应的准确率,acc_norm 表示长度归一化候选分数所对应的准确率;归一化单位可能是 token、字符或任务定义的其他长度,需要核对实现。这两个指标都是准确率,并非「总分」和「平均分」。
候选概率评分之外,还有生成式评测和可执行验证。生成式评测:模型生成回答,再由规则、人工或评审模型评价。选择题需要事先规定如何处理「答案是 (A)」「选 A」等表达,并单独报告无法解析的比例;解析规则变化会改变分数。可执行验证:运行生成代码并检查测试结果。HumanEval(arXiv:2107.03374)包含 164 道 Python 编程题,pass@k 表示 k 个采样候选中至少一个通过测试的概率;从 n 个候选、c 个通过结果估计时,定义为:
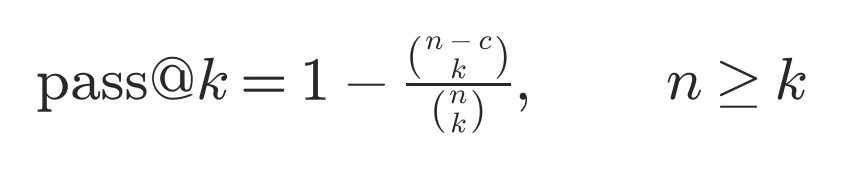
n 为采样候选数,c 为通过数,k 为采样预算;pass@1 对应单次采样成功率,pass@100 对应更高采样预算下的成功概率,两者不能脱离采样设置比较
测试也可能遗漏错误,需要隔离执行环境并检查覆盖度。SWE-bench(arXiv:2310.06770)进一步评价真实 GitHub 仓库中的 issue 修复,测试的是特定环境下的问题解决能力。
候选概率评分适合有明确候选答案的任务,生成式评测适合开放回答和指令任务,可执行验证适合结果可由程序检查的任务。三者评价的行为不同,应根据目标任务选择,并报告各自限制。
04
TWO MORE METRICS
两个补充指标:答案分布与置信度校准
准确率之外,同一份逐题记录还可以用于检查答案位置分布和模型置信度。这两项有助于识别单一总分未反映的问题。
这 100 题的正确答案位置为 A 34 次、B 26 次、C 18 次、D 22 次,样本中的答案位置并非完全均匀。固定选 A 得到 34%,固定选 C 得到 18%,均匀随机选择的期望仍为 25%。不能因为事后发现 A 最多,就认定基准存在系统性位置偏差,需要更大样本和预先规定的统计检验。选项打乱改变答案位置,但保留题干和候选内容,不会改变原始问题集合;两种配置可以按题配对比较,随机基线仍为 25%。应同时检查题集的答案分布与模型的预测分布。
还需要检查选项置信度与实际正确率是否一致。本文将四个候选的概率重新归一化,取被选中候选的概率作为置信度;它不是模型用自然语言声明的确信程度,也不包括其他可能输出。期望校准误差(ECE)将样本按置信度分桶,计算各桶平均置信度与准确率差值的绝对值,再按样本比例加权。实验采用 10 个等宽桶,在原始选项顺序下得到以下结果:
图 4 · 校准实测(Qwen2.5-0.5B,MMLU 100 题,四选一归一化置信度)
Base 的平均置信度比准确率高约 4 个百分点,Instruct 高约 22 个百分点;当前分桶下,Instruct 的 ECE 较大。在 Instruct 的 90%~100% 置信度桶中,共有 13 题,平均置信度约为 96%,实际准确率约为 62%,高置信度输出仍可能出错。这些数值来自 100 题和特定候选评分配置,不能据此认定后训练必然使回答更笃定或降低校准。GPT-4 技术报告(arXiv:2303.08774)也比较了后训练前后的校准,说明校准需要独立评价,不能由准确率或回答语气推断。
如果分类系统按置信度决定是否转人工,未校准的高概率可能使错误结果被自动放行。因此,应在接近业务分布的验证集上检查校准曲线、阈值下的错误率和样本量,必要时进行概率校准。ECE 受分桶方式与样本数量影响,不能仅凭一个 ECE 值决定上线。
05
CONTAMINATION
数据污染:评测数据与训练数据重叠
评测通常希望测量模型对未见样本的泛化。若测试题、答案或近似变体进入预训练、微调或其他训练阶段,就可能产生数据污染(contamination),使分数高估未见题表现。公开题集存在这种风险,但风险大小和实际影响需要证据,不能仅根据训练语料规模断定模型见过所有题目。
本文对《静夜思》和百科风格的 Einstein 介绍,分别比较原文与改写文本的 loss。这些文本具有常见表达或固定内容,但没有训练语料证据证明具体样例曾被模型训练使用:
图 5 · 原文与改写文本的 loss 对照(Qwen2.5-0.5B 实测)
《静夜思》改字后,平均 token loss 从 0.88 变为 4.85,约为原值的 5.5 倍。这说明模型更容易预测原文,但改字也改变了语义、常见程度和 token 切分,不能视为严格的同分布对照。低 loss 可以提供文本可预测性的线索,不能单独证明训练数据成员身份或基准污染。检测污染需要结合语料重叠、受控对照、样本抽取和新题表现等证据;单一样例不能区分记忆与一般语言规律。
GSM1k(arXiv:2405.00332)按 GSM8K 的风格和复杂度构建约 1,000 道新题。论文观察到部分模型准确率下降,最大约 8 个百分点,部分模型家族呈现系统性过拟合迹象。文中的 Spearman r²=0.36 描述的是生成 GSM8K 样例的概率与新旧题分差的关系,并非两个基准分数之间的预测力;不少前沿模型的过拟合迹象较少。GPT-4 技术报告也分析了潜在污染和污染调整后的结果。这些分析用于判断分数可能受重叠影响的程度,不能将新题掉分全部归因于污染。
可访问训练语料时,可以用 n-gram 重叠、近似匹配等方法筛查基准文本,再比较疑似污染和较干净的子集。GPT-3 技术报告(arXiv:2005.14165)描述了基于连续词重叠的污染分析,包括 13-gram 检查;「gram」采用的文本单位必须按实现说明,不能直接等同于模型 token。另一种监测方式是向受控数据放入独特的 canary 标记,观察是否被复现,用于提供数据暴露或记忆的线索,不等于完整污染检测。精确重叠容易遗漏改写,canary 检测失败也不能证明未见过数据,两者都需要结合具体条件解释。
06
BENCHMARK QUALITY
基准质量与评分配置的影响
即使排除了已知训练数据重叠,题目和标准答案本身仍可能存在错误,评分配置也可能影响结论。
Are We Done with MMLU?(arXiv:2406.04127)对 MMLU 的 5,700 道题进行人工复核,覆盖 57 个学科,估计约 6.49% 的题目存在错误;其分析的病毒学样本中,57% 存在问题。作者据此构建 MMLU-Redux,重测结果与原报告出现差异。这是抽样复核结果,不能描述为逐题检查了整个 MMLU。MMLU-Pro(arXiv:2406.01574)增加推理题,将候选数量从 4 个扩展至最多 10 个,并清理简单或有噪声的题目;论文中的模型准确率比原 MMLU 低约 16~33 个百分点,且对提示变化较稳定,反映两套基准的难度和构成不同。
题目相同也需要统一评分配置。lm-evaluation-harness 团队的复现经验论文(arXiv:2405.14782)讨论了至少四类让分数不可比的变量:
① chat template
对话模型是否套用对话模板、系统提示与角色标记怎么放,会影响分数
② few-shot 数量与选样
给 0 个还是 5 个示例、示例怎么选,同一模型的结果可以差一个档次
③ 候选概率或生成式评分
比较选项概率,还是先生成再解析,两者走的是不同口径
④ 答案解析规则
「答案是 (A)」「选 A」算不算对,由解析规则决定
图 6 · 让「同一个 MMLU」分数不可比的配置变量(arXiv:2405.14782)
报告「MMLU 71%」时,还应给出题集版本、任务配置、框架版本和模型运行方式。缺少这些信息,不能确认两份分数可直接比较。
07
HUMAN PREFERENCE
人类偏好评测:Arena 的方法与限制
开放式回答难以仅靠选择题评价。Chatbot Arena(arXiv:2403.04132)将两个匿名模型的回答展示给用户,收集偏好投票,再估计模型的相对评分。它测量的是参与用户在相应问题分布上的偏好,不能直接替代事实正确性或业务效果评价。
Arena 的一种主要评分方法是 Bradley–Terry 模型:为每个模型估计评分 r,假设 A 被偏好于 B 的概率为 σ(rA−rB),通过对战记录的似然拟合评分,并用 bootstrap 等方式估计不确定性。这与奖励模型中的成对偏好建模具有相同的数学形式。该方法能结合不同对手的投票记录,但一维评分不能完整表示非传递偏好。比较两模型时,应检查评分差的统计不确定性;单独置信区间重叠,不等于差异一定不显著,排名也不能省略样本量和问题分布。
The Leaderboard Illusion(arXiv:2504.20879)分析了私有变体测试与数据访问的不对称。论文识别到 Meta 在 Llama 4 发布前测试了 27 个私有变体,并估计 Google、OpenAI 分别获得约 19.2%、20.4% 的 Arena 数据,而 83 个开放权重模型合计约占 29.7%。这些数值限定于论文分析的时期与数据。若从多个候选中择优披露分数,结果可能产生选择偏差;评测报告应说明变体数量、公开规则和数据使用情况。
图 7 · 对战数据的分配差距(arXiv:2504.20879,限定于论文分析的时期与数据)
人类偏好也可能受回答长度、Markdown 排版和表达方式影响。Arena 的 style control 分析对这些风格特征进行控制后,部分模型的相对评分发生变化,说明原始投票包含风格相关信号。控制后的分数仍取决于统计模型和选定特征,并非自动等于不含偏差的内容质量评分。
其他方法同样需要说明限制。LLM-as-judge 的代表性研究 MT-Bench(arXiv:2306.05685)使用强模型评价回答,降低人工评审成本,但可能受位置、长度和裁判自身偏好影响。LiveBench(arXiv:2406.19314)持续加入和更新近期题目,并尽量依据客观答案自动评分,以减轻污染风险;题源包括竞赛、论文、新闻、数据集和既有任务变体,不保证完全没有污染。HELM(arXiv:2211.09110)在可行的场景中联合评价准确率、校准、鲁棒性、公平性、偏差、毒性和效率,避免仅用一个总分描述模型。
公开基准可用于初步筛选模型,最终选型还需要接近真实业务分布的评测。评测集应覆盖核心任务、常见输入和高风险情况,并定义可检查的质量标准。
选样:按业务分布分层抽样。根据任务类型、输入长度、多轮交互和领域内容划分样本,记录各层比例。常见场景可按实际流量加权,高风险场景可以额外抽样并单独报告,避免被总体平均掩盖。题量:根据目标精度确定。100 条可用于初步排查;独立伯努利近似下,准确率接近 50% 时,95% 区间约为 ±10 个百分点,500 条约为 ±4.4 个百分点。比较候选模型应利用同题配对结果,并根据目标分差和检验功效确定题量,不能把这些区间当作统一的显著性阈值。
防污染:控制分发并保留独立测试集。业务题集可能因外部评测、分享或反复用于调参而失去独立性。应限制访问,区分开发集和最终测试集,定期加入新样本;如使用 canary 标记监测暴露,需要预先定义检测方式,并说明其不能排除所有污染。版本管理:绑定数据与评分规则。记录题目修订、参考答案、评分规范和抽样方案,结果同时关联模型版本、提示模板、运行配置与评测代码。只有在可比条件下,才能解释分数变化;更换题集或规则后的结果应单独标注。
成本:按实际调用与采样预算估算。MMLU 测试集包含 14,042 题,但一次完整评测需要多少次前向,取决于候选评分实现、batch size 和缓存。生成式多次采样还受输出长度与候选数量影响。本文使用 100 题,约占全量题数的 1/140,用于说明评测现象,不能据此保证所有比较都具备足够统计功效。业务评测可以先用小样本筛选,再扩大对候选模型的独立测试,同时记录延迟、token 消耗和费用。
比较分数前,核对题集、框架版本、few-shot、chat template、评分与解析规则,以及 acc 或 acc_norm 等指标定义。使用多个相关基准检查能力差异,但不要把多榜平均直接视为业务质量;小幅分差应结合样本量和配对检验解释,不能一律当作噪声。涉及发布前测试或择优披露的结果,应检查候选数量与公开流程。为业务选型时,在真实问题上评价任务正确性、格式遵循、风险、延迟和成本;100 条人工评测可以作为起点,但不保证比所有公开基准更可靠。
| |
|---|
| 有效预测位置平均负对数似然的指数,比较时需统一切分与评测条件 |
| |
| |
| 模型生成回答后,按解析规则、人工或评审模型进行评价 |
| |
| 测试数据、答案或近似变体进入训练数据,可能高估泛化表现 |
| |
| |
| |
| |
| |
| |
| 准确率在伯努利近似下为 √(p(1−p)/n),配对分差需另行估计 |
| 分别按原始与长度归一化候选分数选答后计算的准确率,细节依任务实现 |
| 受控数据中的独特标记,用于监测数据暴露或记忆,不能排除所有污染 |
| 检查连续 13 个文本单位的重叠,需注明单位,难以覆盖语义改写 |
一、如果将本文的候选概率评分改为生成式评分,如何比较 Base 和 Instruct?除了准确率,还需要记录哪些指标,才能区分任务理解、chat template、结束标记和答案解析带来的影响?
二、《静夜思》原文 loss 为 0.88,改字版为 4.85。如果一篇未公开内部文档的 loss 为 0.9,语言规律、模板化内容和数据暴露分别能否解释?需要哪些对照或证据,才能检验训练数据重叠?
三、Arena 的人类偏好、LiveBench 的客观答案与 LLM-as-judge 的模型评分,各自可能包含哪些系统性偏差?评测中文客服回答时,如何组合事实核验、规则检查和人工评审,并检验评分一致性?
下一篇讨论 Scaling Law 与数据:参数和训练 token 的配比(Chinchilla)、训练数据质量与清洗,以及给定计算预算下的模型规模选择。
我是 Luke,广告算法工程师,在公众号写「大模型算法入门」系列。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
