你写了半年的模型,一行 model.to('cuda') 就把活儿甩给了 GPU。我 14 年写代码,第一次这么干的时候,压根没想过那块卡背后是门多凶的生意。
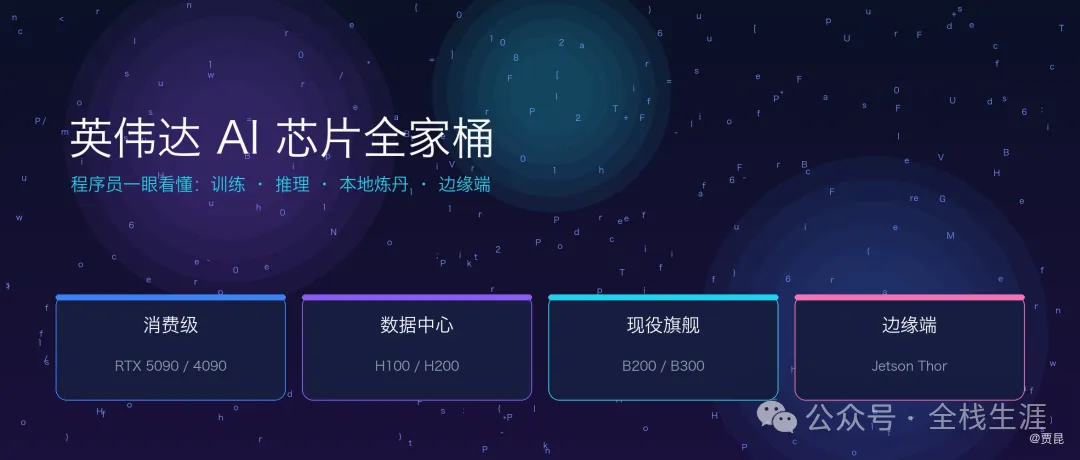
今年(2026)AI 芯片市场特别魔幻:H100 还在服役,Blackwell 的 B200/B300 已经成了出货主力,价格因为内存荒涨得离谱。这篇用程序员的视角,把英伟达的 AI 芯片家族捋一遍——训练、推理、本地炼丹、塞进机器人,各自该用什么。
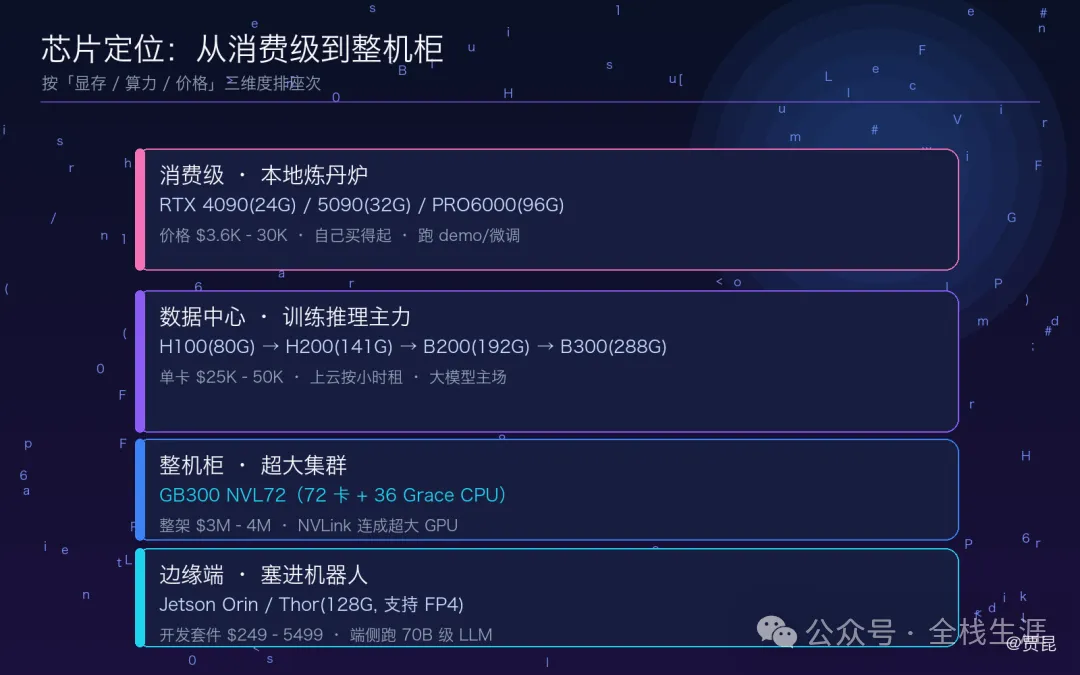
先给一张全家福定位:按「显存 / 算力 / 价格」排座次,从上到下是边缘端 → 消费级 → 数据中心 → 整机柜。下面逐个拆。
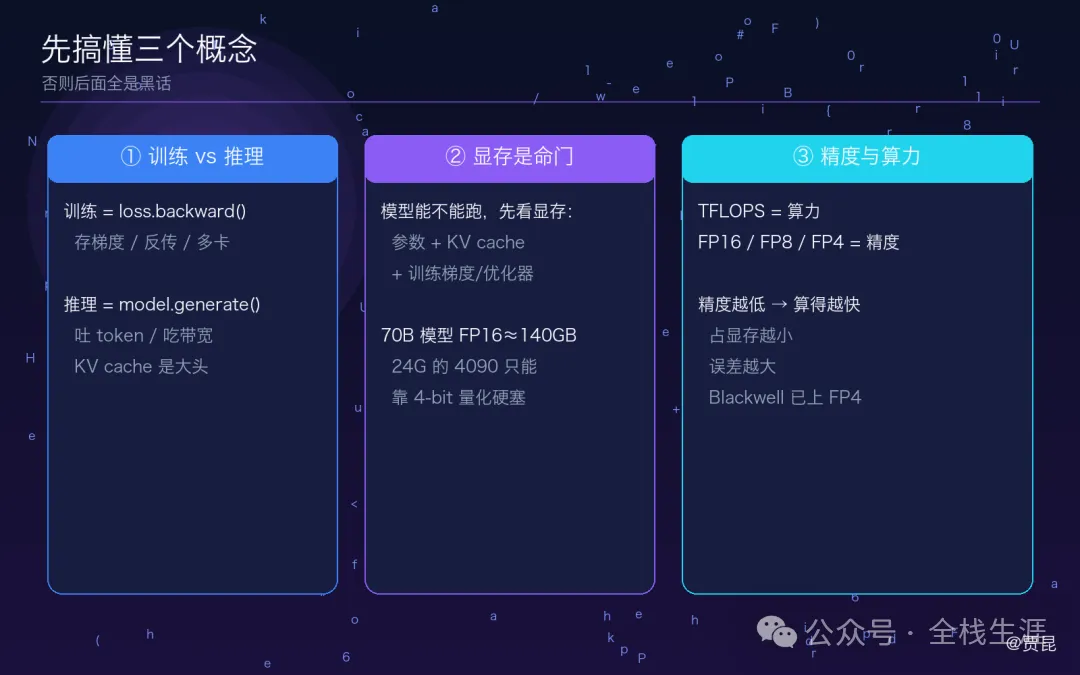
一、先搞懂三个概念,否则后面全是黑话
① 训练 vs 推理训练 = 你写 loss.backward()、optimizer.step() 那套,要反传、要存梯度、要动辄几百张卡一起算,既吃算力又吃显存。推理 = model.generate() 那一下,给用户吐 token,更吃显存带宽(KV cache 是大头)。同一张卡,训练能跑的模型往往比推理小一截。
② 显存是命门模型能不能跑起来,首先看显存够不够装下:模型参数 + 推理时的 KV cache + 训练时的梯度和优化器状态。70B 模型 FP16 约 140GB,所以单卡 24GB 的 4090 只能靠 4-bit 量化硬塞。显存不够,再强的算力也白搭。
③ 算力单位与精度TFLOPS(每秒万亿次浮点运算)= 算力;FP16/FP8/FP4 = 数值精度。精度越低,同样的芯片算得越快、占的显存越小,但误差越大。现在大模型推理大量用 FP8,Blackwell 更进一步上 FP4——这也是新卡"凭空变强"的关键。
二、数据中心旗舰:云上训练/推理的主力
H100(Hopper 架构,80GB HBM3)定位:上一代"标配",2023–2025 的绝对主力,如今仍是很多云厂商的性价比之选。价格:单卡约 $25,000–40,000;2026 云上租用约 $2–4 /GPU·小时。作用:大模型训练、高吞吐推理都行,FP8 约 4 PFLOPS 量级。
H200(Hopper,141GB HBM3e)定位:H100 的"加显存版",架构一样,显存从 80GB 涨到 141GB,带宽更高。价格:单卡约 $30,000–40,000。作用:同样算力,但能装下更大模型和更长上下文,推理场景(尤其长上下文、大 KV cache)明显更香。
B200(Blackwell,192GB HBM3e)定位:2025 年起的出货主力,性能和显存都翻倍级提升,FP16 约 2,250 TFLOPS。价格:单卡约 $30,000–45,000;8 卡 DGX B200 整机约 $280,000–500,000。作用:训练推理通用,单卡"成本/算力"比反而优于 B300。
B300 / GB300(Blackwell Ultra,288GB HBM3e)定位:2026 现役旗舰,显存顶到 288GB,FP4 算力约 30 PFLOPS。价格:单卡约 $40,000–50,000;整机架 GB300 NVL72(72 卡)约 $3M–4M。作用:万亿参数训练、超大模型低延迟推理。注意:单纯比算力性价比,B200 反而更值。
顺带一提 GB200/GB300 NVL72 这种"整机柜"——把 72 张卡用 NVLink 连成一个超大 GPU,专为超大集群设计,单位是"机架/百万美元",跟个人开发者基本无关。
三、中国特供:H20 的阉割故事
H20(Hopper 中国版,96GB HBM3)背景:美国出口管制卡"算力阈值",英伟达就砍算力、保显存——H20 算力只有 H100 的约 15%,但给了 96GB 显存和 4 TB/s 带宽。价格:上市约 $12,000–15,000,2025 年一度因 DeepSeek 爆单,2026 年初已停产。作用:显存大、带宽高,对"内存受限"的推理反而有竞争力;但训练几乎没法用。它本质是"为政策设计、不是为 workload 设计"的芯片。也提醒一句:买这类卡要盯紧出口政策风险。
四、消费级:程序员自己的"炼丹炉"
RTX 4090(24GB GDDR6X,2022 年发布)定位:本地跑模型的国民神卡,二手也香。价格:2026 街价约 $3,600–5,000(受内存荒影响远高于首发)。作用:本地跑 7B–13B 模型、微调小模型、做 demo,性价比之王。
RTX 5090(32GB GDDR7,2025 年发布)定位:4090 继任,显存和带宽都涨。价格:街价约 $5,000–10,000(波动巨大)。作用:本地 30B 级别量化模型、出图、轻量训练,单卡体验更好。
RTX PRO 6000 Blackwell(96GB GDDR7,工作站卡)定位:消费级里的"怪兽",单卡 96GB 能跑 70B 量化大模型。价格:约 $18,000–30,000(2026 涨幅超 100%)。作用:不想上云、又要大显存的本地工作站首选。
五、边缘端:把模型塞进机器人
Jetson 家族(Orin Nano / Orin NX / AGX Orin / Thor)定位:嵌入式、机器人、自动驾驶的"小钢炮",功耗从几瓦到一百多瓦。价格:Orin Nano 约 $249 起,AGX Orin 约 $1,999–3,499,新出的 Thor(Blackwell,128GB,支持 FP4)开发套件约 $3,499–5,499。作用:在端侧跑感知、视觉、甚至 70B 级 LLM(Thor)。Thor 还把数据中心的 MIG 多实例切分搬到了边缘,适合"一个设备同时跑多个实时模型"的机器人场景。
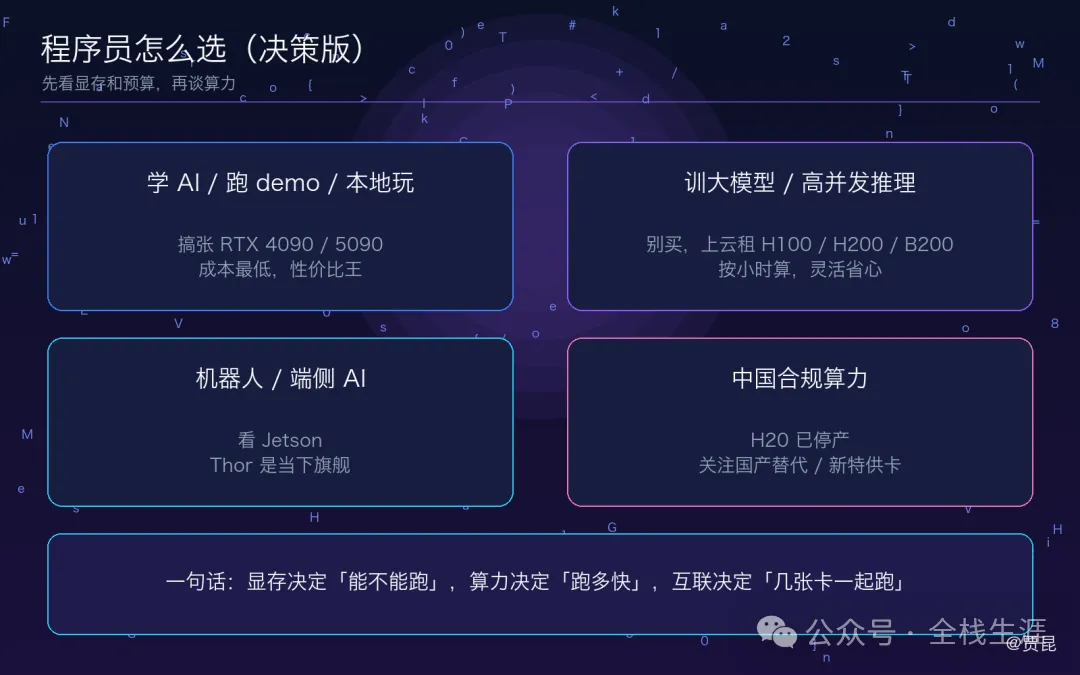
六、程序员怎么选(决策版)
- • 学 AI、跑 demo、本地玩模型:搞张 4090 / 5090,成本最低。
- • 真要训大模型 / 高并发推理:别买,上云租 H100 / H200 / B200,按小时算,灵活省心。
- • 做机器人 / 端侧 AI:看 Jetson,Thor 是当下旗舰。
- • 在中国做合规算力:H20 已基本停产,可关注国产替代(华为昇腾等)和新政策下的特供卡。
一句话记住:显存决定"能不能跑",算力决定"跑多快",互联决定"几张卡一起跑"。选型先看显存和预算,再谈算力。
最后提醒:2026 年所有 GPU 价格都被"内存荒"搅得天翻地覆,本文价位为量级参考(数据截至 2026-10),真实采购务必实时询价;对绝大多数个人和小团队,租云 GPU 比买更划算。
想一起转型 AI,加入程序员转型陪伴群,公众号回复『转型』了解