Agent评测这个趋势你必须了解
- 更新时间 2026-11-07 14:53:04
过去两年,我们沉浸在“会聊天的 AI”制造的幻觉里。
那些 Demo 里对答如流的 Agent,一旦被扔进真实的业务流,立刻被打回原形:长任务跑不到底、换种语言就胡言乱语、上周交代的事转头就忘。
现在,行业终于撕下了“嘴皮子”的遮羞布,开始死磕一个最朴素的硬指标——这活儿,你到底能不能办完?
1 先从一个“新同事”说起
假设公司来了个新同事,叫小安。
面试很漂亮:问什么答什么,逻辑清楚,措辞得体。HR 当场就想要人。
于是第一周,主管给了他一件真活:把过去半年的客户投诉梳理一遍,找出三条最该先改的流程,周五交。
这时候真正的问题才浮出来,而且一共四个:
- 他能不能把一整件事扛完?
不是答一个问题,是分步骤、找资料、中途自己检查、发现走错路能掉头。 - 换个城市出差,他还办得成事吗?
客户说的是方言,公司里的制度文件、系统字段、商品名录也全是当地版本。 - 他记不记得住上次的交代?
三天前说过的偏好、上周定过的口径,这次还得算数。 - 他有没有练手的场地和教练?
光看别人做事学不会,得有真环境让他反复试,还得有人告诉他哪一步做错了。
“小安”其实就是一个 Agent。
过去两年,我们评价 Agent 用的是:回答得好不好。2026 年则需要 Agent 能过四道关。先看全景:
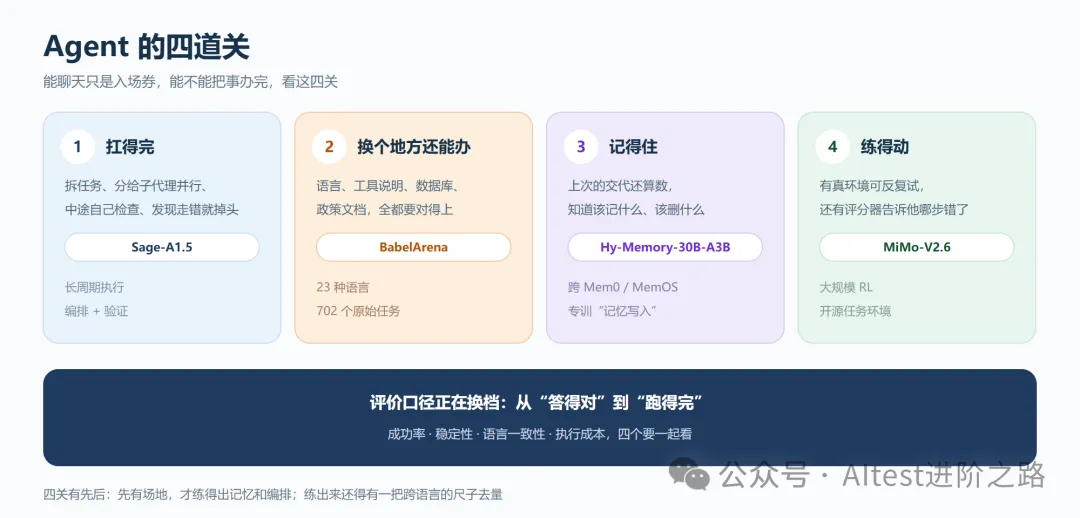
这四关不是并列的四件事,是有先后的:先有场地(环境),才练得出记忆和编排;练出来之后,还得有一把能跨语言、跨场景的尺子去量。最后一节会把这条链拼起来。
2 第一关:能不能把一整件事扛完
先说最常见的失败形态。
一个只会“一问一答”的 Agent,接到长任务时是这样的:读需求 → 想一步 → 调个工具 → 再想一步 → 输出。整条路是一条直线,中间没人回头看一眼。
直线的问题不在于短,而在于没有纠错点。它可能在第三步就理解偏了,然后一路顺着偏下去,跑得越久错得越远,最后还很自信地交答案。
Sage-A1.5 改的正是这件事。它是上海人工智能实验室基于前代 Agents-A1 做的 35B 混合专家模型,摘要里点明了三个方向,前两个对做工程的人最有参考价值:
一是智能体编排。 它不再让一个 Agent 单线跑到底,而是把任务拆开、分给子智能体并行去做,每个子智能体在自己的隔离上下文里干活。隔离这两个字很关键——上下文不互相污染,几个子任务同时推进也不会互相干扰。
二是智能体验证。 它会在执行过程中自己检查三件事:进度到哪了、手里的证据够不够、当前这条路要不要换。摘要里有个说法很实在:能识别出“没有产出的搜索路径”,然后转向别的方法。
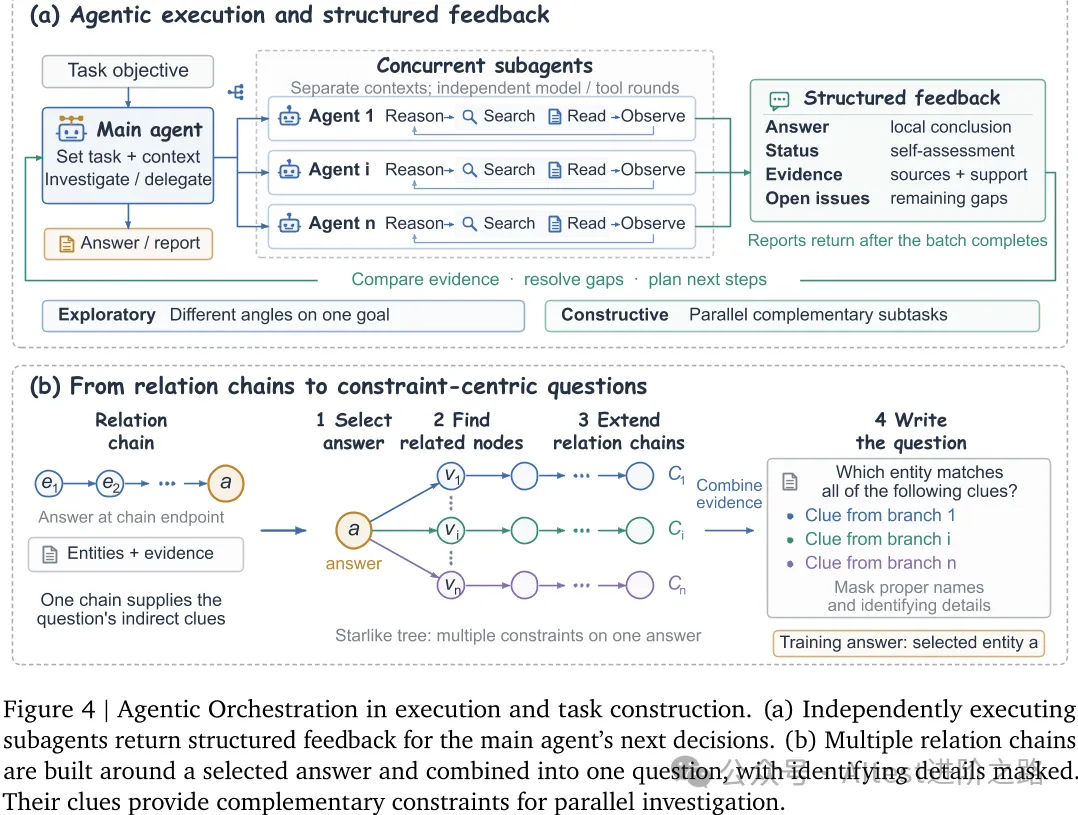
论文里画的编排结构很直观:主智能体只负责定目标和分发任务,几个子智能体在各自的隔离上下文里并行干活,干完交回来的不是一句“做完了”,而是带答案、带状态、带证据来源、带遗留问题的结构化反馈——主智能体靠这些反馈决定下一步是比对证据、补缺口,还是推进:
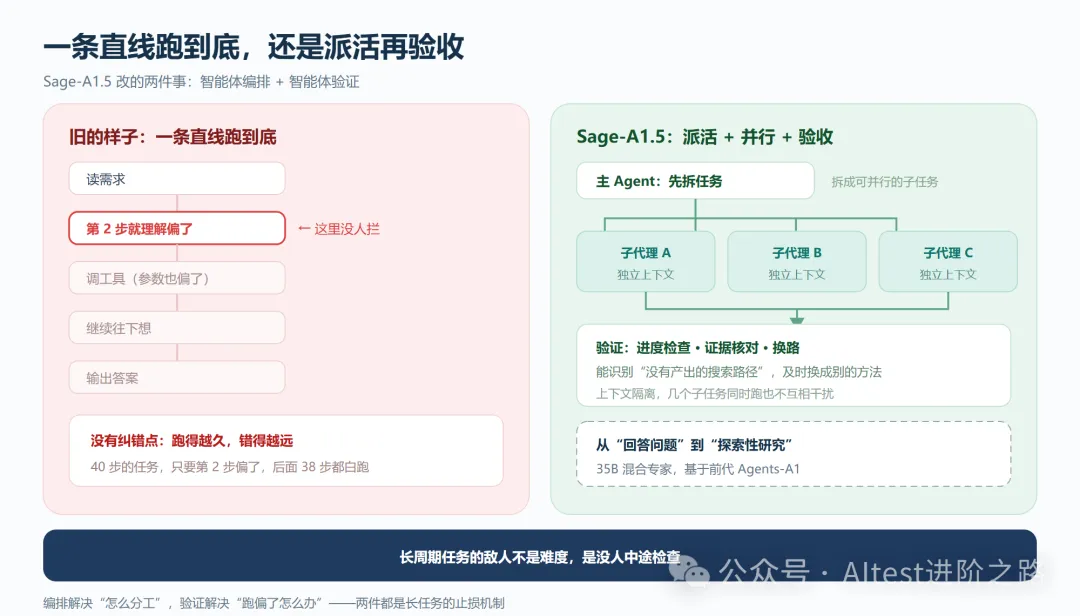
这里有个很容易被忽略的点:长周期任务的敌人往往不是难度,是没人中途检查。 一个任务跑 40 步,只要有一步偏了没人拦,后面 39 步都是白跑。所以“验证”不是锦上添花的功能,它是长任务的止损机制。
第三个方向是把能力从“回答预设问题”推到“探索性科研”,这个离日常测试稍远,但它说明了一件事:模型厂现在练的,是在没有标准答案的场景里持续工作的能力。
会答一道题,靠的是知识;扛完一件事,靠的是拆解、并行和自查。
3 第二关:换个城市,还能不能办事
第二关的问题最容易被低估:把问题翻译成目标语言,Agent 就能在多语言环境里干活了吗?
不能。这是 BabelArena 那篇论文的出发点,也是我认为它最有价值的地方。
原因很朴素:Agent 处理订票、购物、账户服务时,它读的不只是用户那句问题。它还要读工具说明、数据库记录、业务政策文档。你把用户问题翻成了泰语,工具说明还是英文,数据库字段还是英文,政策文档还是英文——Agent 面对的是一个“半翻译”的世界。
那我把每个组件都独立翻译一遍行不行?也不行。论文里列了三种典型翻车:
商品名称对不上:用户说的和数据库里存的不是同一个译名,检索直接落空 引用失效:任务里指向某条记录的 ID 或名称,翻译后指到了别处 正确操作被判错:Agent 明明做对了,评分器按翻译后的标准答案判它错
所以 BabelArena 做的事不是“再做一个多语言基准”,而是把评测扩到整条执行流程,并且保证各语言版本的任务 ID 和评分规则一致,这样同一个任务才能跨语言比较。
规模先感受一下:23 种语言、覆盖 15 种文字系统、13 个领域、702 个原始任务,展开成 16,146 个语言版本。它整合了四类已有基准:
τ³-Bench:航空、零售、电信、银行里的交互、工具调用与政策遵循,212 个任务 VitaBench:外卖、到店、在线旅行及跨领域任务,200 个 DeepPlanning:满足可验证约束的旅行与购物长期规划,120 个 ClawEval:服务编排、多模态感知与生成、专业对话,170 个
语言的选取也讲道理:既有英语、中文、日语、法语、俄语、阿拉伯语、西班牙语这类语料充足的“高资源”语言,也有高棉语、缅甸语、老挝语、泰米尔语、泰卢固语这类几乎找不到文本的“低资源”语言,书写方向、分词方式、字形结构都不一样。
怎么翻译才不出上面那些错?配套的 BabelFlow 给了四步,顺序很值得抄:
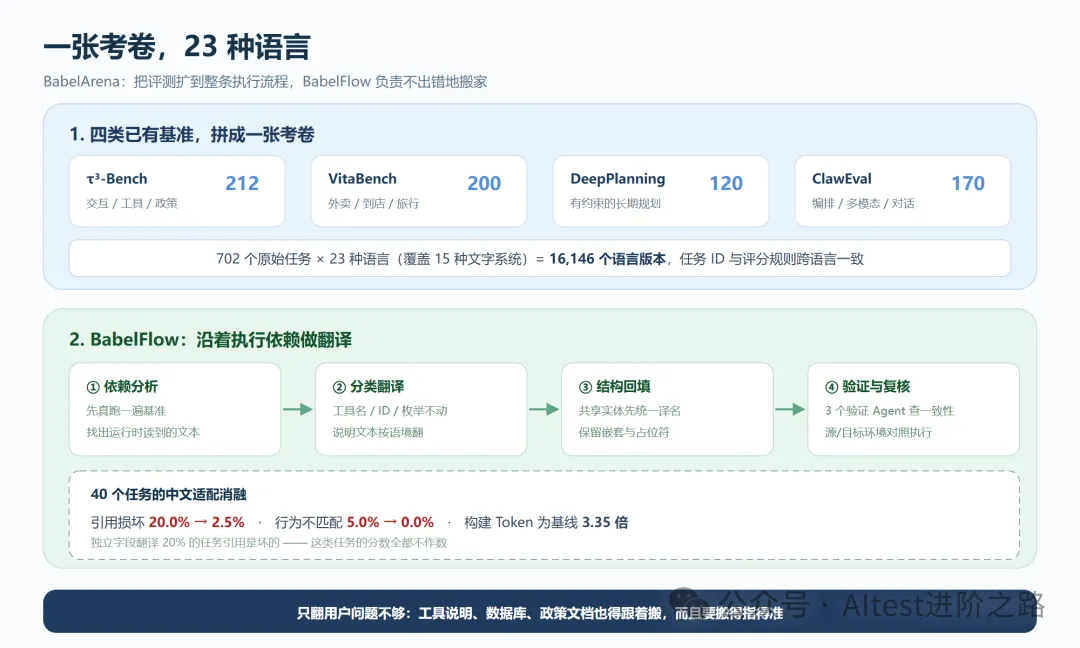
第一步,先追踪数据,再决定翻译范围。 不是拿着字段清单从头翻,而是把源基准真跑一遍,看任务、工具、数据库、模拟用户、评分器在运行时到底读了哪些文本,然后建立共享实体之间的依赖。
第二步,按字段类型翻译。 工具名、参数名、JSON 键、ID、执行用枚举值——一律不动;普通说明文本按上下文翻;共享实体先生成一个统一译名,再跨组件复用。
第三步,回填原位置。 翻译 Agent 只处理抽出来的字段,结果填回去,保留嵌套结构和占位符。原始图片、音视频这些决定任务内容的素材也原样保留。
第四步,用执行结果验证。 三个独立验证 Agent 分别查结构完整性、跨组件一致性、语义忠实度与行为等价性;然后在源环境和目标环境里跑同样的受控操作,比较工具返回、状态变化和评分结论。人工复核发现问题后,字段分类错误退回分析阶段,译名或语义错误退回翻译阶段。
论文原文的流程图更完整,把“该翻什么、不该翻什么”也画了出来:左边是运行时数据流分析,中间按字段分三类(要保留的工具名、ID 一律不动,普通文本随便翻,商品名这类共享实体先定统一译名),右边把译名字段塞回原来的结构里,底部是多层验证加人工复核:
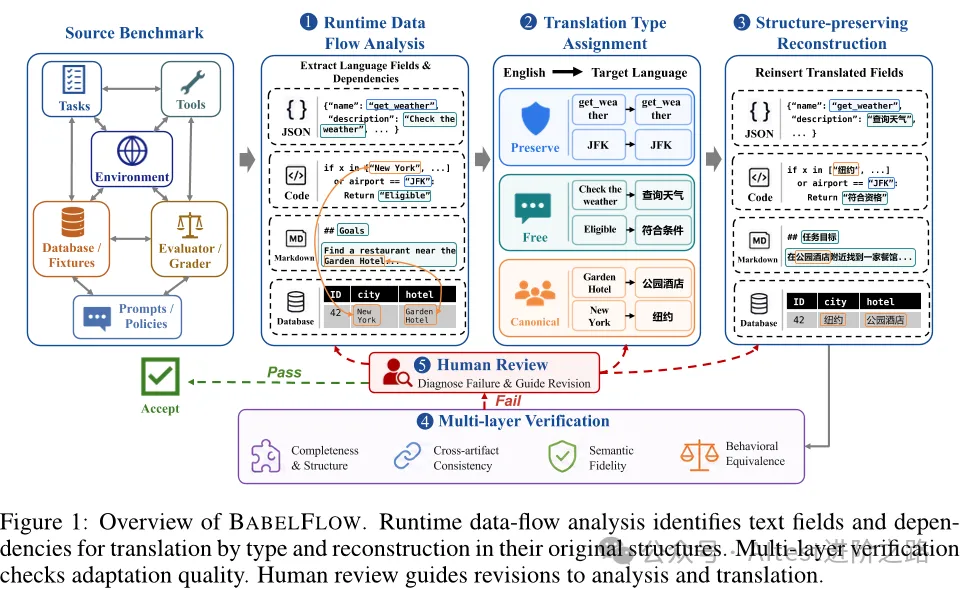
在 40 个任务的中文适配消融实验里,引用损坏的任务比例从独立字段翻译的 20.0% 降到 2.5%,行为不匹配从 5.0% 降到 0.0%。代价是构建过程 Token 用量为基线的 3.35 倍。
这个代价其实很值。翻译一次贵三倍,但翻译错了,后面所有评测结论都是废的。
多语言 Agent 的难点不是“会说”,是“说的时候,引用还指得准”。
4 成绩单:没有全能选手
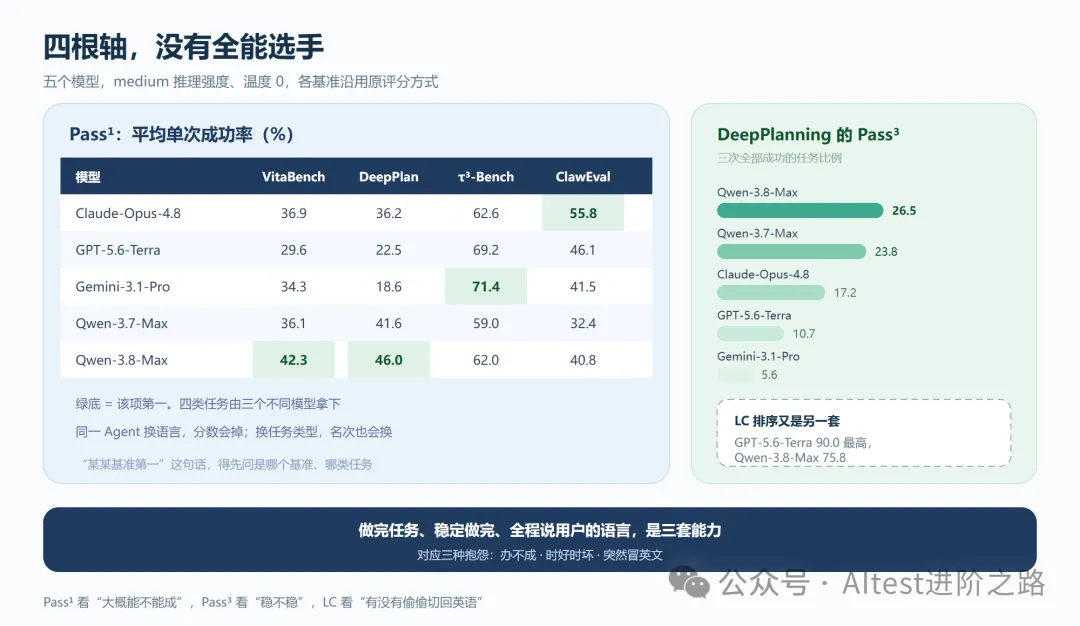
基准有了,接下来看谁考得好。五个模型都用了 medium 推理强度、温度 0,各任务来源沿用原评测框架,DeepPlanning 用确定性规则评分。
每个任务独立跑三次。三个指标要分清:
- Pass¹:
三次试验的平均单次成功率——大概能不能做成 - Pass³:
三次全部成功的任务比例——能不能稳定做成 - LC:
整条轨迹里面向用户的自然语言是否始终用目标语言——有没有偷偷切回英语
先看 Pass¹(单位 %):
| 55.8 | ||||
| 71.4 | ||||
| 42.3 | 46.0 |
这个表最有信息量的地方不是排名,是没人包揽:Qwen-3.8-Max 拿下 VitaBench 和 DeepPlanning,Gemini-3.1-Pro 在 τ³-Bench 领先,Claude-Opus-4.8 在 ClawEval 领先。
换句话说,“Agent 能力”不是一根轴,是四根不同的轴。你在选型时听到“我们某某基准第一”,第一件事该问的是:哪个基准,哪一类任务。
再看 DeepPlanning 这张更狠的表,因为它把“做对一次”和“稳定做对”分开了:
| 90.0 | ||
| 26.5 |
排序和 Pass¹ 不完全一样了。Qwen-3.8-Max 的 Pass³ 最高,但 LC 最高的是 GPT-5.6-Terra(90.0)。这意味着三件事是三套能力:做完任务、稳定做完任务、全程说用户的语言。
做产品的都知道,这三件事对应三种抱怨:办不成、时好时坏、突然冒英文。
5 贵在哪:低资源语言的三个账
如果只看成功率,你会以为低资源语言只是“分数低一点”。实际翻开轨迹,贵得离谱。
第一笔账是 Token。 在相同的 VitaBench 任务上,低资源语言轨迹的累计输入 Token 是英语的 1.69–2.06 倍,而交互轮数只有英语的 0.97–1.16 倍。轮数几乎一样,Token 翻倍——说明不是聊得更多,是每一轮塞进去的东西更多、更啰嗦。
第二笔账是检索。 DeepPlanning 的购物环境靠“查询词和本地化商品记录的词汇重合”来检索。五个模型的低资源语言购物轨迹里,53.7%–68.7% 的商品搜索返回空结果;英语只有 6.1%–17.1%。
第三笔账最直观。 论文里有个成功案例:Qwen-3.8-Max 在任务 37 的英语版和泰卢固语版里买到了同样的四件商品。英语版用了 9 轮、25 次工具调用;泰卢固语版用了 64 轮、201 次调用,158 次商品搜索里 126 次是空的。而且这条泰卢固语轨迹一开始还在用英语搜索词,直到改用泰卢固语查询,才找到候选商品。
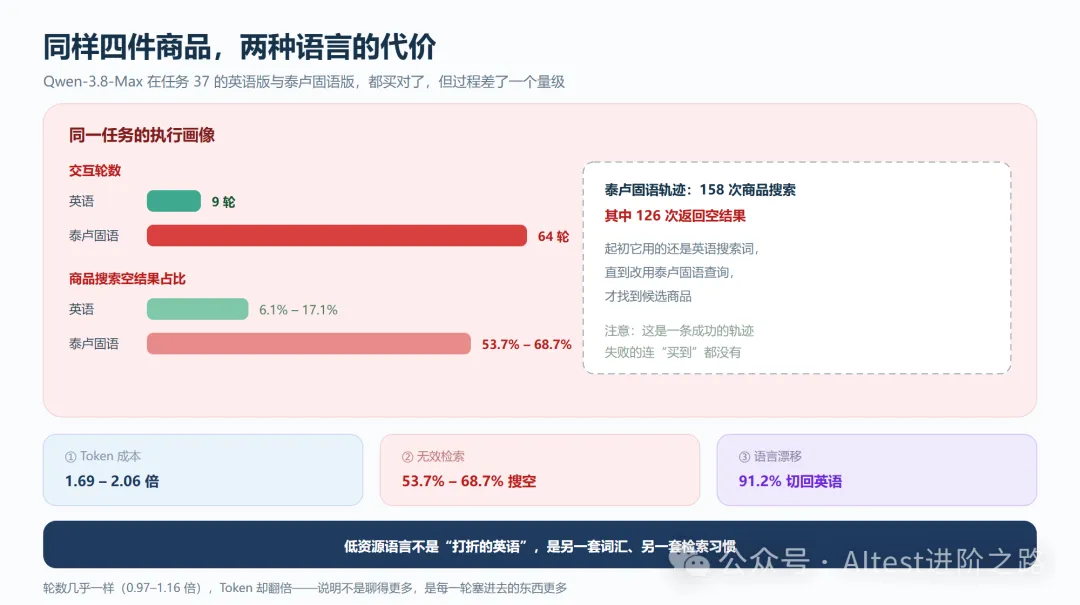
注意,这是一条成功的轨迹。失败的那些连“买到”都没有。
在 1,600 条 VitaBench 失败轨迹的抽样分析里,泰语和泰米尔语的工具使用、控制流错误占比明显高于英语和中文,具体表现是无效循环,以及给工具传了语言不对的参数。
还有一笔账容易被漏掉:语言一致性。 研究者从 DeepPlanning 和 ClawEval 里抽了 2,000 条已被判定语言不一致的轨迹,其中标注到的语言切换有 91.2% 指向英语。位置也有规律:DeepPlanning 主要出现在回复正文,ClawEval 则集中在调用工具前的那句说明——执行操作前先来一句英语。
所以多语言 Agent 的改进,得同时动三处:任务推理、工具参数、检索行为。只做提示词层面的“请用泰语回答”,治不了后两个。
低资源语言不是“打了折的英语”,是另一套词汇、另一套检索习惯。
6 第三关:记不记得住上次的交代
第三关是记忆,但真正的问题不是“能不能存”,而是该往里面写什么。
现在常见的做法是:记忆框架(Mem0、MemOS 这类)在需要写入时,临时叫一个通用大模型来判断“这条要不要记、怎么记”。问题在于,通用模型没被训练过“写记忆”这件事——它不知道这个框架的字段规范,不知道该记多细,也不知道记忆库会越堆越大。
Hy-Memory-30B-A3B 的思路很干脆:专门训一个小模型来干这件事,30B 总参、3B 激活的紧凑 MoE。它的定位是替换掉框架里那个通用 LLM,而不改框架本身的记忆逻辑,所以能跨 Mem0、MemOS、Hy-Memory 多个框架跑。
训练分两段,这个设计值得记:
第一段,先教会它“按规矩写”。 用记忆在策略蒸馏(OPD)的方式,把各个框架的写入协议教给它——相当于入职培训,先熟悉公司的报销单怎么填。
第二段,再用强化学习调“写得好不好”。 这一段的奖励设计有意思:
分块级 GRPO:把记忆切成块,逐块优化,而不是整段一起给分 失败面探测奖励:专门挑那些“写了但下游答不出来”的情况当信号,密集地告诉它哪里写废了 跨分块结果奖励:不只看单块,还看多块合起来能不能支撑下游问答 存储增长惩罚:写得越多不一定越好,堆库要扣分
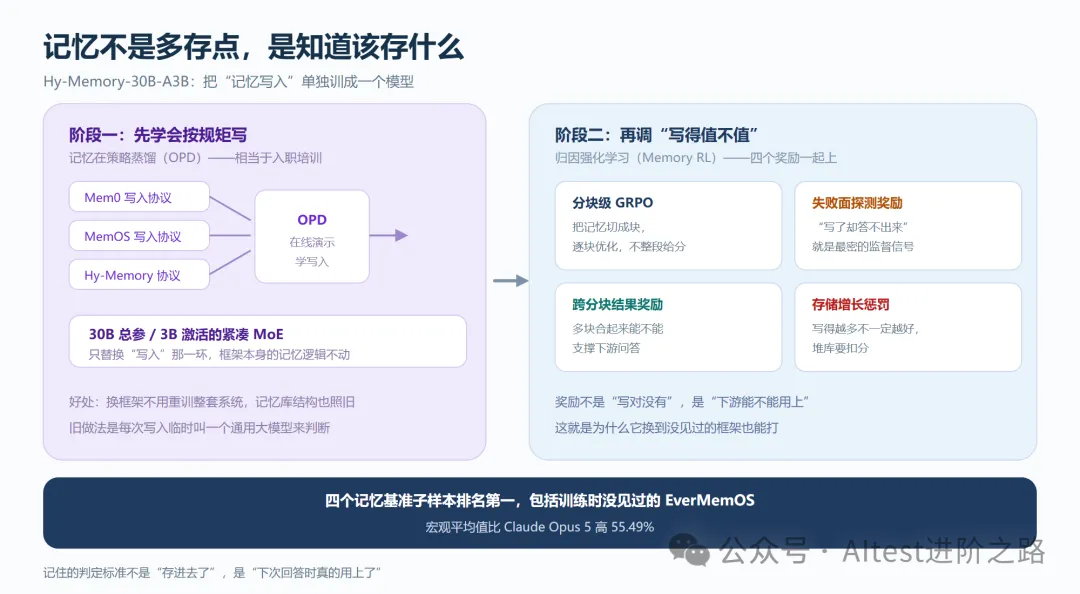
结果:在四个评估基准子样本上排名第一,其中包括训练时没见过的 EverMemOS;宏观平均值比 Claude Opus 5 高 55.49%。
“没见过的框架也能用”这点比分数更重要——说明它学到的不是某个框架的格式,而是“什么内容值得写进长期记忆”。
记忆不是“多存点”,是“知道该存什么、该删什么”。
7 第四关:有没有练手的场地和教练
最后一关是训练侧,但它和测试工程师的关系其实最近——因为它决定了“评分器”长什么样。
MiMo-V2.6 是小米的全模态模型家族,Pro 版 1.02T 总参 / 42B 激活,Flash 版 310B / 15B 激活。真正值得看的是它怎么扩强化学习:
在数千张 GPU 上扩 RL 计算,单次运行消耗 2.7–3.7B tokens 提出组级代理评分(Groupwise Agentic Grading),解决“一个任务有很多步、每步都对才算对”的评分粒度问题 用多前缀多教师在线策略蒸馏(MOPD2)把能力收进模型 开源了轻量蒸馏模型 MiMo-V2.6-Distill-Qwen-9B、端到端 RL 训练框架,以及多个领域的任务环境
环境是怎么造出来的?论文画了一条流水线:左边从真实文件和软件 Mock 出发,多智能体并行探索、互查修复,产出可反复重置的 RL 环境;右边再在环境里写任务、配评分标准,用多个模型跑批验证,反复修订,直到任务可验证:
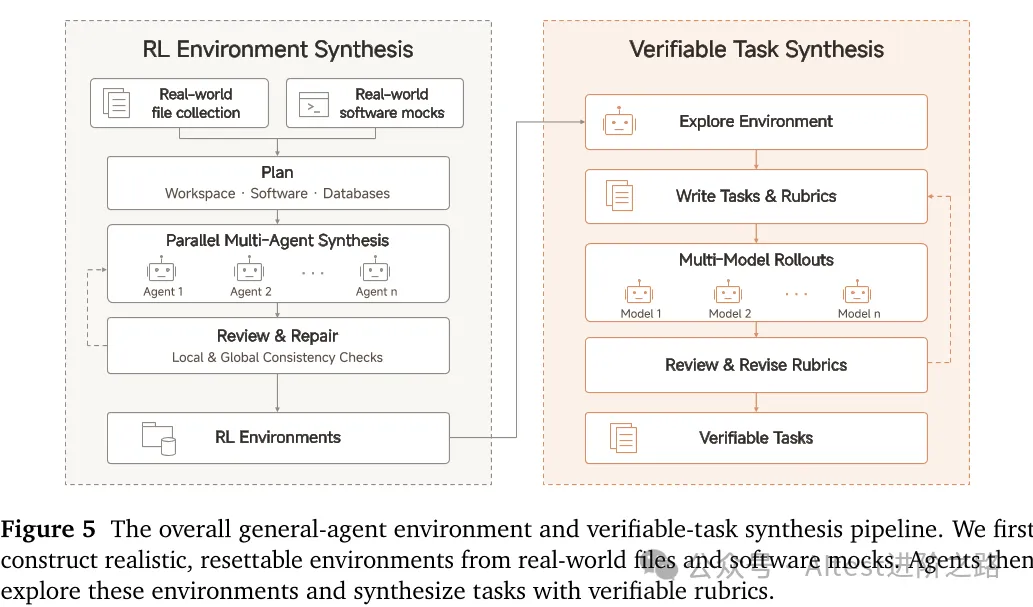
最后这一项最实在。做过 Agent 评测的人都知道,写一个评分器容易,造一个“能反复跑、结果稳定、还能给出过程信号”的环境很难。厂商把环境开源出来,等于把练习场也交出来了。
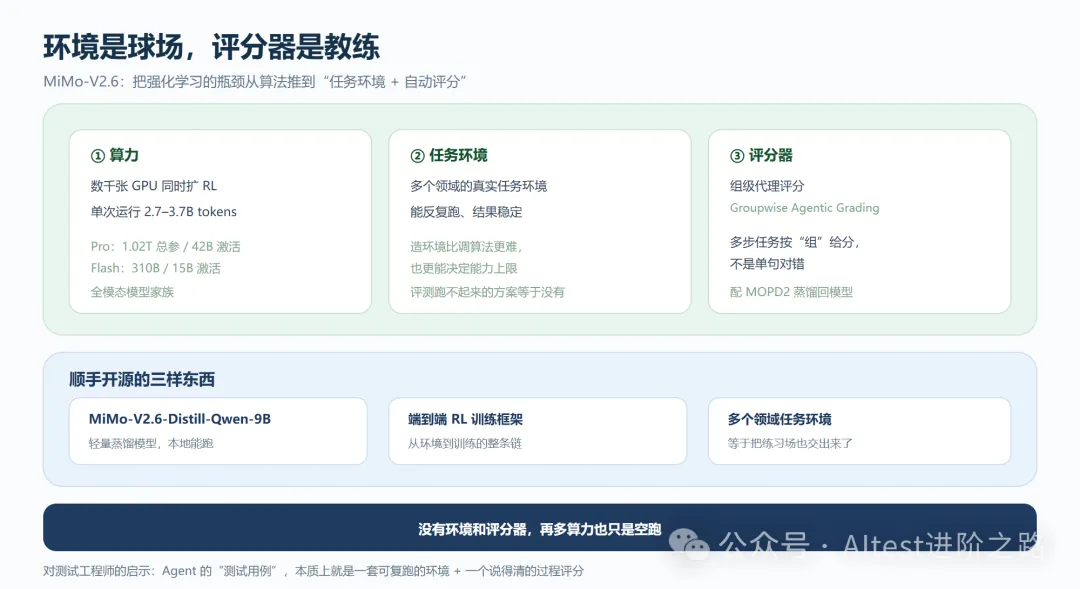
环境是球场,评分器是教练。没有这两样,再多的算力也只是在空跑。
8 把四关连起来
现在把四篇放回一条线上,你会发现它们是一套流水线:
练手场(MiMo 的任务环境 + 自动评分)→ 记忆(Hy-Memory 决定记什么)→ 编排与验证(Sage-A1.5 决定怎么拆、怎么自查)→ 跨语言评测(BabelArena 决定怎么量)
这也解释了为什么“评测”这件事越来越像工程而不是考试:你要评的不是一句话,是一条包含工具、数据、状态、语言、成本的轨迹。
落到我们自己身上,我想给三条建议:
第一,评测口径要扩。 只看“答案对不对”,会漏掉三样东西:跑了几轮(效率)、花了多少 Token(成本)、有没有偷偷切语言(体验)。BabelArena 的 Pass¹ / Pass³ / LC 三件套,可以直接借到自己的项目里。
第二,本地化要按依赖做,不要按字段做。 如果你在做多语言场景,先跑一遍真实链路,找出运行时会读到的所有文本,再决定翻什么;工具名、枚举、ID 一律不动,共享实体先统一译名。这套流程对“多环境适配”(测试环境、预发、生产)同样适用。
第三,别把“聊得好”当验收标准。 演示时的流畅对话,和第七步之后还能不能保持正确,是两件事。
想在魔搭上直接上手,资源都在这:
数据集给的是冻结的 standard 子集,包含 τ³-Bench、VitaBench、DeepPlanning 三类:每种语言 532 个任务,共 12,236 个实例。ClawEval 的任务数据单独分发,完整基准的 16,146 个实例和这个数据包的范围是分开算的。
pip install modelscopefrom modelscope.hub.snapshot_download import dataset_snapshot_downloaddataset_snapshot_download( dataset_id="Qwen/BabelArena", local_dir="./BabelArena-data",)下载后 tau3/、vitabench/、deepplanning/ 分别对应三类评测数据,里面的 task_subsets/standard/ 存着固定任务 ID,SHA256SUMS 用来校验文件。各语言用的是同一套任务集合,正好做对照——同一个 Agent,换语言,成功率、语言一致性、执行成本各掉多少,一目了然。
9 写在最后
最触动我的是 BabelArena 里那个泰卢固语的例子:一个 Agent 花了 201 次工具调用、126 次空搜索,最后买对了四件商品。
按老标准,这是 PASS,皆大欢喜。按新标准,这是一个成本高三倍、路径几乎靠试错堆出来的 PASS。
Agent 的评价正在从“结果导向”走向“过程 + 结果双轨”。这不是评测变苛刻了,是因为它真的要开始干活了——真干活的时候,没人只看你交没交,还要看你花了多久、绕了多少路、下次还能不能这么交。
会聊天是入场券,跑得完才是本事。
到这里,我们已经能看见 Task、Tool、Arguments、Trajectory、Output、Latency。那么哪些东西该被定义成 Agent 的核心质量指标?客服 Agent、测试 Agent、代码 Agent 能不能用同一套标准?
更多Agent评测的资料放在我的知识星球:AItest进阶之路
系统学习AI全栈测试看这篇:
一个残酷的真相:35岁之后还能走上坡路的测试人,大都是学透了这个能力,可惜99.9%人不敢承认
看到这里如果你觉得有帮助,欢迎关注、在看、转发!
推荐阅读
太幸福了吧!Playwright 官方推出这三个Agent,轻松搞定AI测试全流程,建议转发收藏(附详细操作步骤)
用Skills+知识图谱实现多接口串联测试,简直王炸(建议转发收藏)
一个测试人必备的需求分析Skill,搞定需求分析8大维度,生成用例采纳率直接拉满
太幸福了,10万行代码接口测试,我用知识图谱+Skill 让 AI 半小时全干完了,一学就会
太幸福了吧!Playwright 官方推出这三个Agent,轻松搞定AI测试全流程,建议转发收藏(附详细操作步骤)
一个测试人必备的需求分析Skill,搞定需求分析8大维度,生成用例采纳率直接拉满
3个测试Skills,让工作效率直接拉满!从入门到工程化全覆盖
