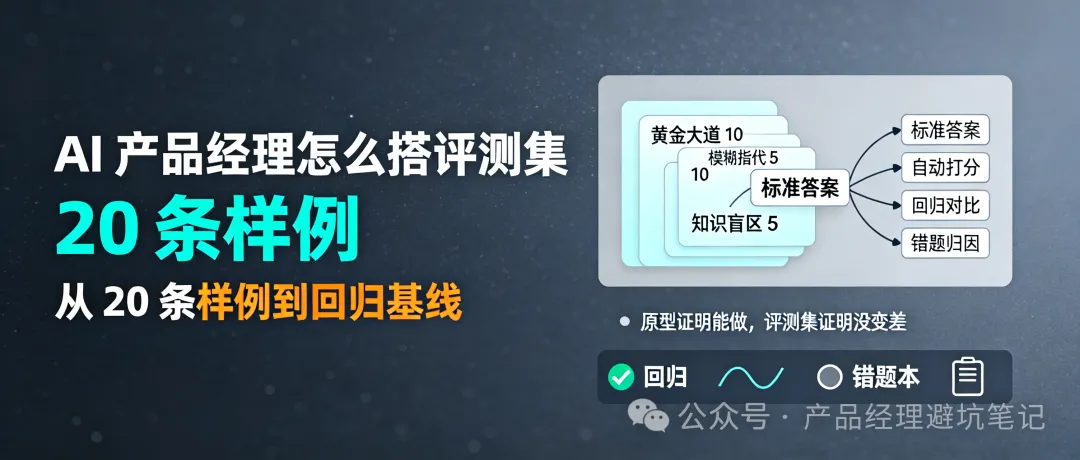
上篇我说「原型证明能做,评测集证明做得够好、改动后没变差」,有读者问:评测集到底怎么搭?是不是算法工程师的活?这篇把它拆开。结论先放前面:评测集是 PM 的「单元测试」。传统软件改一行代码有单元测试兜底,AI 产品改一句 prompt 没有——评测集就是那个兜底。 它把「好结果」从感觉变成数字,PM 不用写评判模型,但要写评判标准。
为什么这件事绕不开
先讲一个真实的坑。人人都是产品经理作者骆齐在《构建自动化评估体系》(2026-01)里复盘过一个客服机器人项目:初期靠三个实习生每天肉眼看 log,随着 prompt 版本迭代,回归测试工作量指数级上升,实习生累到离职,而每个人对「好回答」的定义不同,模型效果在几个版本间反复横跳。
他的总结很准:没有量化,就没有优化。 改一句 prompt,Case A 修好了,原本完美的 Case B、C、D 突然崩了——这是 LLM 产品的常态,因为模型输出有非确定性,prompt 又是个高度耦合的混沌系统。你为了让它在「写周报」更严肃,加一句指令,结果「写情书」也变得像教导主任。
传统软件靠人工测试能兜住,因为输入确定、输出确定。AI 产品靠「Vibe Check」——随便问几个问题看着像回事就觉得稳了——等于裸奔。这就是为什么评测集不是可选项,是 PM 的基本盘。
01 20 条怎么凑:不是随机抽,是覆盖三类边界
很多人一听「评测集」就觉得要几万条,那是大厂基建组的事。作为业务 PM,一份能用的集子从 20 条 起步就够。20 不是玄学,是覆盖三类边界的最小集。 我直接给你一套可抄的分层模板,来源是评测入门里常见的「黄金大道 / 模糊指代 / 知识盲区」结构(10+5+5=20):
表 1:评测集 20 条分层模板
| | | |
|---|
| | | |
| | | |
| | | 问一个知识库绝对没有的问题、或乱码,必须拒答而非胡编 |
三类里最有价值的是后两类。黄金大道只能证明「基本盘没崩」,真正暴露问题的是模糊指代和知识盲区——它们逼出失败模式。 呼应上篇说的:原型天然只覆盖顺利路径,评测集的任务是把不顺的路径也塞进去。
一个容易犯的错:20 条全是自己顺手能答对的。那等于没测。每类里至少放 2-3 条你是「故意想难住它」的,效果才出来。
02 标准答案怎么定:三类任务三种写法
有了题,还要有「标准答案」才能打分。不同任务写法不一样:
- 提取类(从简历提取电话、从合同抽金额):标准答案唯一,直接比对。
- 生成类(写周报、写诗):没有唯一答案,写「必须包含的要点」或「参考范文」。判断标准是「要点齐没齐」,不是「像不像范文」。
- 拒答类(涉黄涉政、知识盲区):标准答案就是「触发兜底话术 / 明确拒答」。这类在 OOK 那 5 条里是硬指标——没拒答就是 0 分。
关键点:标准答案由 PM 定义,不是工程定义。 算法关心 Loss 下降,PM 关心用户体验交付。一份评测集的「参考答案」本质是把你脑子里的「好」显性化、可衡量化。
03 指标两类:确定性能自动,模糊性靠裁判
打分指标分两类,对应两种实现难度:
确定性指标好办:要求输出 JSON 它却吐 Markdown,算格式不合规;遇到敏感词有没有触发兜底话术,算拒识率。这些用正则就能跑,不依赖人。
模糊性指标才是 PM 的主场。准确、友好、通顺没法正则匹配,但现在有了 LLM-as-a-Judge:写一段专门的 prompt,告诉裁判模型「你是严格考官,根据问题、模型回答、参考答案,打 1–5 分并给理由」。骆齐的实测是,在复杂语义理解场景下,GPT 当裁判的判决结果与人类专家一致性通常能达到 80%–90% 以上。
注意口径:这个 80–90% 是上述作者个人实测,不是行业基准,不同任务一致性差异很大。但它足以说明——裁判模型比「三个实习生肉眼看」快且稳。
04 从「测一次」到「回归基线」
单跑一次评测集,只能告诉你「此刻水平」。真正让它变成护城河的,是回归。
回归的意思是:每次改 prompt、换模型、调参数之前,先跑一遍这 20 条存档当基线;改完再跑一遍,对比分数掉没掉。华为云一篇大模型长效迭代框架(2026-09)里把「回归测试」定义为「模型/提示词/推理配置改动后,自动化验证原有能力不退化」——这正是评测集的核心用法。
表 3:一次回归对比怎么做
| | |
|---|
| | |
| | |
| | |
| 看错题本,定位是 prompt 还是检索还是模型问题 | |
这套流程的价值在成本侧也说得通。每次跑 20 条烧的是 token,但比雇人看 log、版本间反复横跳便宜得多——接得上我写的毛利那篇:评测集是 AI 产品里单位经济最划算的一次性投入之一。
05 错题本才是金矿
评测跑完,总分是给人自嗨的,生成的「错题本」才是资产。骆齐那篇文章的核心判断:PM 每天的重点,应该从「想新功能」转移到「分析错题」。
错题要分三类归因,才能对应到动作:
- prompt 指令不清
- RAG 检索到的上下文是错的
- 模型能力天花板
这跟前面交付物清单里写的「badcase 分流机制」是同一件事。评测集是「生产」badcase 的工厂,错题本是「消化」badcase 的地方。两者合起来,才是 AI 产品迭代的闭环。
06 PM 的活 vs 工程的活
回到最开始的问题:评测集是 PM 的还是工程的?答案是分层的。
PM 写:评判标准(什么算好)、Judge Prompt 里的业务规则、错题归类、OOK 对抗样本的设计。本质是「把业务规则代码化」——这呼应上篇的结论:不用学生产级工程,但必须会定义失败。
工程写:跑分脚本、把评测接进 CI/CD、Judge 模型的部署与成本控制。工具层面现在有现成的(Promptfoo、LangSmith、Ragas、DeepEval),不一定从零造轮子,但 PM 要知道它们存在、能看懂跑分报告。
一个常见误区:PM 把「搭评测集」整体甩给工程,结果工程按技术指标造了一份,和用户体验对不上。评测集的「考纲」必须由 PM 出,工程只是「印卷子和阅卷」。
07 最小可行动作清单
不用等工具、不用等团队,今天就能开始:
- 开一个 Excel,列四列:问题 / 期望行为 / 类型(黄金/模糊/盲区)/ 标准答案要点。
- 先填 20 条:10 条高频 + 5 条模糊指代 + 5 条故意刁难的盲区/对抗。
- 定标准答案:提取类写唯一值,生成类写必含要点,拒答类写必须拒答。
- 跑第一遍:手动或接 LLM 裁判都行,记一个总分和逐项分当基线。
- 每次改 prompt 前跑一遍、改完跑一遍
- 建错题本
骆齐在那篇文章结尾说了一句我很认同的话:哪怕先在 Excel 里整理出 20 条黄金 Case,也是构建你职业护城河的第一步。 在这件事上,「慢」有时候就是「快」。
最后
评测集不是算法工程师的专利,它是 PM 手里那根拐杖——AI 产品失去了「确定性」这根拐杖,PM 就得自己造一根。
你不用写评判模型,但你要写评判标准;不用造评测平台,但你要出考纲、定基线、啃错题。 20 条起步,回归兜底,错题闭环。这套东西一旦跑起来,你改 prompt 不再裸奔,面对老板「你凭什么说这个版本更好」时,能甩出冷冰冰但有说服力的数字,而不是一句「我觉得挺好」。