系列位置:第 43 篇(模块 G|量化,7 篇中的第 6 篇)|所属层:度量 本文讲量化的校准与评测:GPTQ、AWQ、SmoothQuant、KIVI、KVQuant 各自从校准集取什么、取多少条;校准集怎么选的两条经验;评测怎么分四层做——困惑度、零样本任务、长上下文检索、端到端指标——以及每一层的坑与代价。 前置篇:39(GPTQ)、40(AWQ)、41(SmoothQuant)、42(KV Cache 量化);本篇依据总纲 7.4(校准与评测方法)
一、本文讲什么
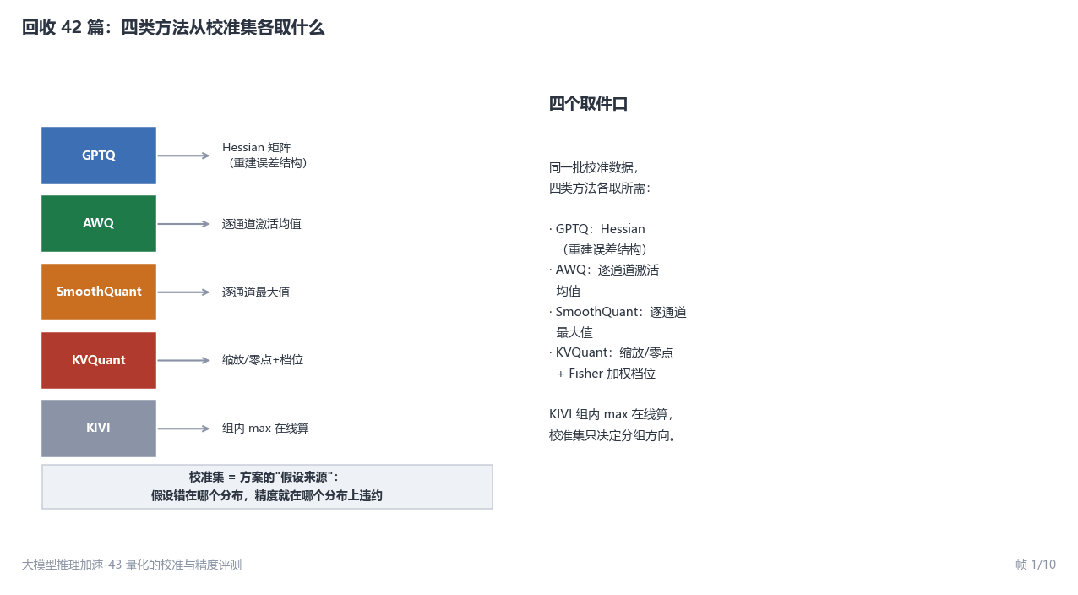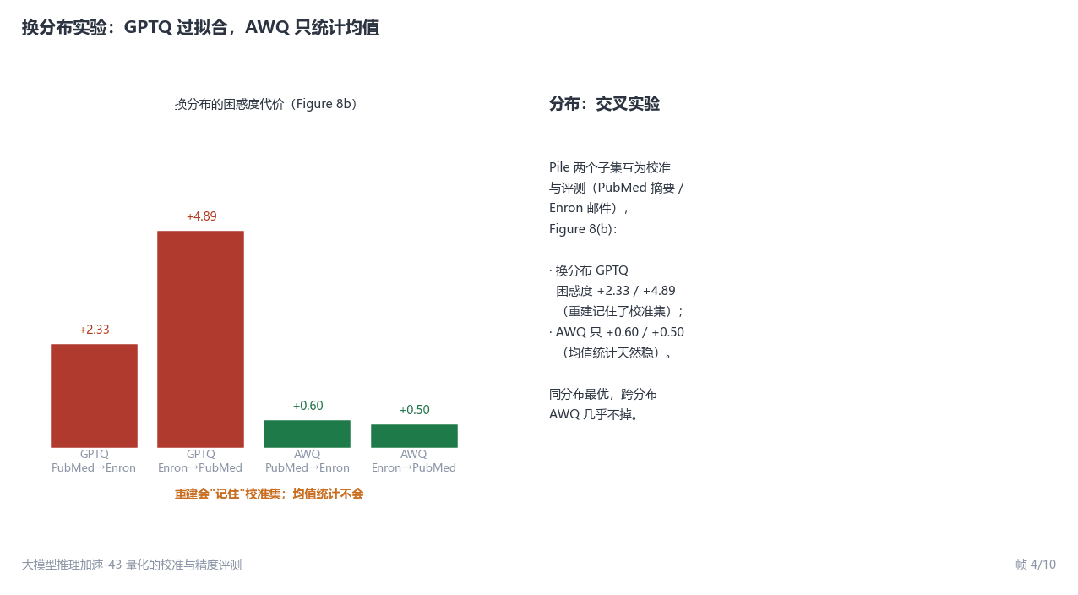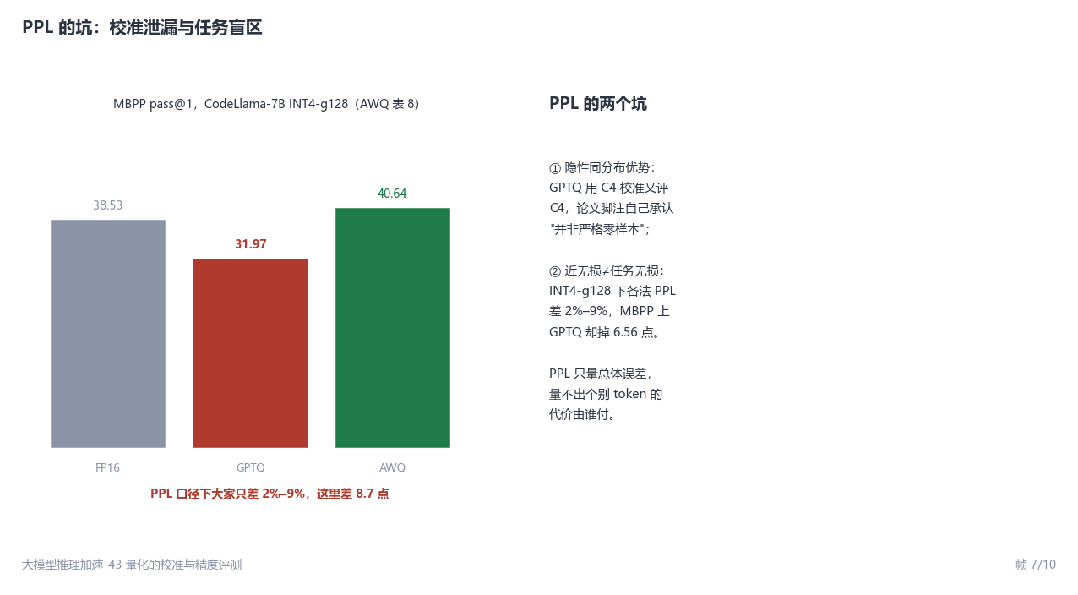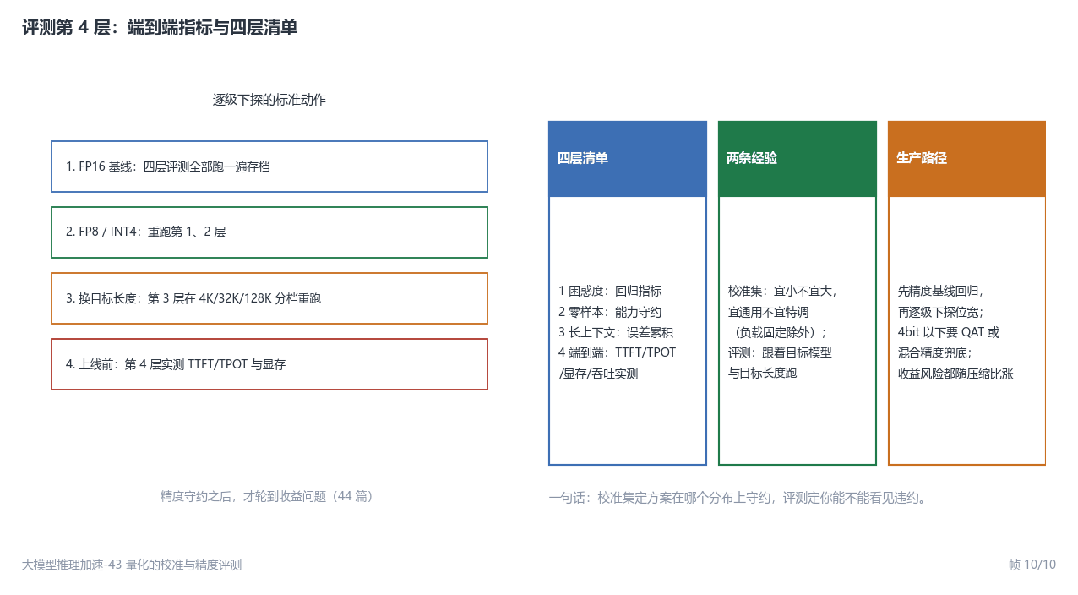
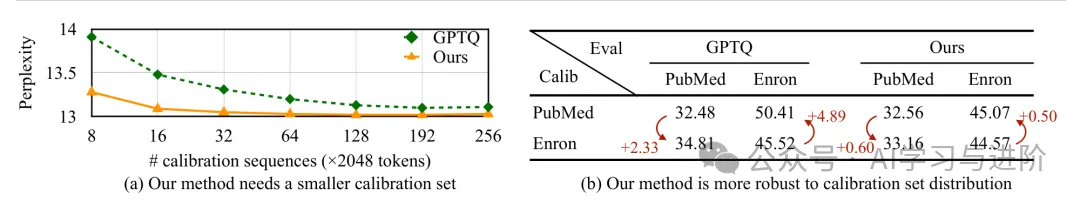
量化方案里的关键数字几乎都出自同一批数据:GPTQ 逐层重建的 Hessian 来自校准集,AWQ 的缩放因子来自校准集,KIVI 的分组方向、KVQuant 的档位与阈值同样取自校准集。这批数据给多少条、什么分布,直接决定这些数字算不算数。数字差别很直观:同为 4 bit,AWQ 用 16 条校准序列拿到的困惑度好过 GPTQ 用 192 条(AWQ 论文 Figure 8a);换一批分布校准,GPTQ 的困惑度上升 2.33~4.89 个点,AWQ 只上升 0.50~0.60 个点(Figure 8b)。
39 到 42 篇讲的是方案本身,这一篇补上它们共同依赖的两块底座:校准集怎么选,量化后的模型拿什么证明还能用。
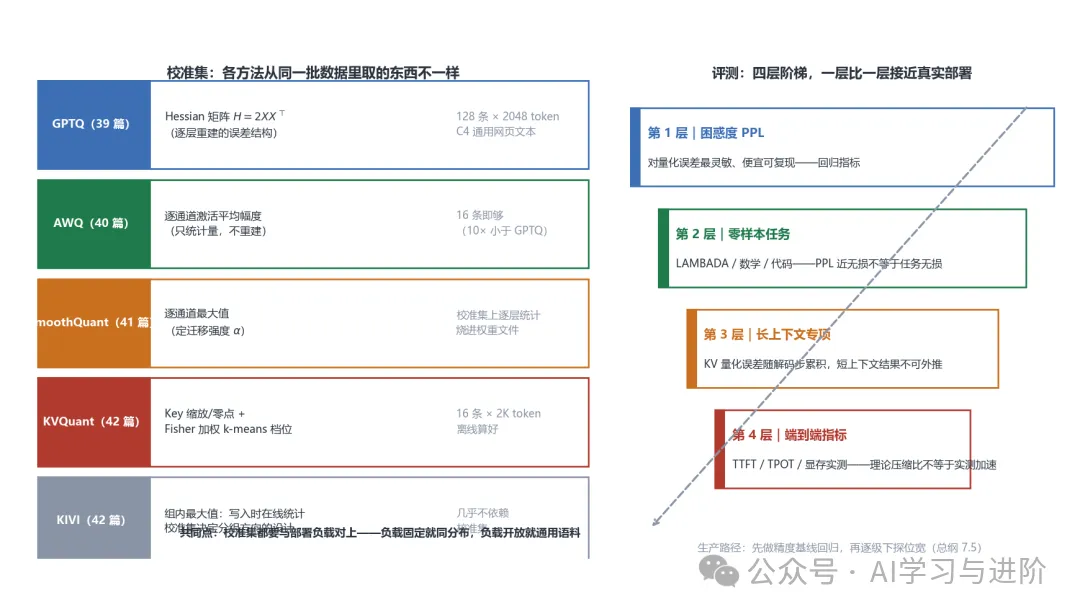
图1|自绘:校准集在四类方法里的角色与四层评测阶梯。 左侧是四类方法从同一批校准数据里各取什么:GPTQ 取 Hessian 矩阵(逐层重建的误差结构,128 条 × 2048 token)、AWQ 取逐通道激活平均幅度(16 条即够)、SmoothQuant 取逐通道最大值(定迁移强度 α)、KVQuant 取 Key 缩放与零点加 Fisher 加权档位(16 条 × 2K);KIVI 的组内最大值是写入时在线统计的,校准集决定的是分组方向的设计依据。右侧是四层评测:困惑度、零样本任务、长上下文专项、端到端指标,一层比一层接近真实部署。
校准两条经验:宜小不宜大、宜通用不宜特调(负载固定除外)。评测四层:困惑度、零样本任务、长上下文检索、端到端指标。 校准侧:AWQ 用 16 条拿到比 GPTQ 192 条更好的困惑度(Figure 8a),KVQuant 全部实验只用 16 条 × 2K;重建类方法会记住校准集,换分布困惑度 +2.33/+4.89(Figure 8b),KVQuant 换校准数据几乎逐位不变(表 21)。评测侧:PPL 只能当回归指标,MBPP 上 PPL 差 2%–9% 的两个方法任务分差 8.7 点;KV 量化必须在目标上下文长度上跑长上下文检索;上线前用 TTFT/TPOT 验证理论压缩比真的变成时间。
校准与量化的关系因方法而异。GPTQ 这类重建式方法对校准集依赖最重,误差结构、Hessian、逐层更新全部来自它;AWQ、SmoothQuant 这类统计式方法只取几个统计量;KIVI 几乎不依赖。所以"校准集怎么选"没有统一答案,先要看方法从校准集里拿什么。评测同理,跟着目标走:目标模型、目标负载、目标长度,换一个,结论就可能反转——40 篇见过 GPTQ 在 LLaMA 上比 RTN 还差,代码任务要用代码评测,KV 量化的误差随解码步累积、必须在目标长度上测。
本文依次讲四部分:四类方法从校准集里各取什么、取多少;校准集怎么选的规模与分布两条经验;评测的四层——困惑度与零样本任务、长上下文专项、端到端指标。最后给出适用边界与代价。
术语解释
| |
|---|
| 量化前输入给算法的一小批代表性数据:重建式方法用它算误差结构,统计式方法用它算缩放因子,非均匀量化用它定档位 |
| 语言模型对下一个 token 预测不确定性的度量,越低越好;对量化误差灵敏、计算便宜,是量化论文的标配指标 |
| 不给示例直接考的任务准确率,如 LAMBADA、ARC、PIQA;考的是通用能力是否守约 |
| 在长文本中埋一个随机密钥串,考模型能否原样取回;用于测 KV 量化在目标上下文长度上的累积误差 |
| 重建式量化把校准集的特征"记住"了:校准分布上表现好,换一个分布失真放大 |
| 衡量参数对输出敏感度的二阶统计量;KVQuant 用对角 Fisher 加权 k-means,把档位放在数值敏感的地方 |
| 首 token 延迟与每 token 输出延迟;端到端指标,用于验证量化收益在实际系统中是否兑现 |
二、四类方法从校准集取什么
图2|动图:从校准集到四层评测的完整链条(10 帧)。 ①四类方法各取什么;②GPTQ 的校准配置;③AWQ 16 条对 GPTQ 192 条;④AWQ 的换分布实验;⑤KVQuant 的 16 条配置与换数据稳健性;⑥PPL 为什么是标配;⑦PPL 的两个坑;⑧零样本任务拉开差距;⑨长上下文 passkey 实测;⑩四层清单与生产路径。
GPTQ 取得最深。它逐层前向收集输入 X,算出 Hessian 矩阵 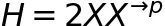 作为误差结构,重建的每一步——固定列序、懒批更新、Cholesky 重构——都建立在这批数据上(39 篇)。论文的校准配置是 C4 数据集随机抽 128 段、每段 2048 token;C4 是随机网页文本,通用、无任务倾向,论文据此称结果"仍是零样本"。
AWQ 取得最浅。它只从校准集统计每个激活通道的平均幅度  ,用来给显著通道定缩放,之后没有重建、没有反向传播(40 篇)。论文对此的表述是:对校准集的依赖"最小,因为我们只测每个通道的平均幅度"——统计量越简单,能记住校准集的自由度越少。
SmoothQuant 取的是极值:逐通道最大幅度,用来算迁移强度 α(41 篇),统计完烧进权重文件,运行时没有额外开销。KVQuant 取得最全:用 16 条 × 2K 的 Wikitext-2 样本,一次算出 Key 的逐通道缩放与零点、Fisher 加权的非均匀档位;Value 侧因为离群 token 无法离线标定,改成在线逐 token 定阈值(42 篇)。KIVI 最特殊:组内最大值是写入缓存时在线统计的,不用校准集;它从数据分析里拿到的是"Key 沿通道、Value 沿 token"这个分组方向的设计依据(42 篇图 3),不是任何数值。
三、校准集怎么选:规模与分布
第一条经验:宜小不宜大。AWQ 论文的 Figure 8(a) 是最直接的证据:OPT-6.7B INT3-g128 下,AWQ 用 16 条校准序列拿到的困惑度,比 GPTQ 用 192 条还要好——10 倍小的校准集。GPTQ 自己的标准配置是 128 条 × 2048(约 26 万 token),KVQuant 全部实验只用了 16 条 × 2K。几十条就够,是这几个论文共同的实测结论。
图3|论文原图(AWQ Figure 8)。 (a) 困惑度随校准序列数的曲线:AWQ(Ours)16 条即进入平台期,GPTQ 需要 192 条才到相近水平——AWQ 用 10 倍小的校准集;(b) 分布交叉实验:Pile 的 PubMed 摘要与 Enron 邮件互为校准与评测集,同分布最好(PubMed-PubMed、Enron-Enron),换分布时 GPTQ 的困惑度代价 +2.33 / +4.89,AWQ 只有 +0.60 / +0.50。
小校准集为什么反而好?因为校准集不是训练集。GPTQ 这类重建式方法在逐层重建时会向校准集的分布偏移,AWQ 论文的原话是"重建过程对校准集过拟合,损害了分布外域上学到的特征"。校准集越大,这种偏移越深、越难察觉;AWQ 只统计均值幅度,KVQuant 只定档位,自由度小,16 条就饱和。校准数据翻倍还有时间代价:GPTQ 量化 OPT-175B 要 4.2 小时(39 篇表 2),主要时间花在逐层重建上。
第二条经验:宜通用不宜特调,除非负载固定。Figure 8(b) 的交叉实验给出了方法间的差别:换分布时 AWQ 只掉 0.5–0.6 个困惑度点,GPTQ 掉 2.3–4.9 个点。KVQuant 的附录 L 把这个实验做到了 KV 侧(表 21):Wikitext-2 校准与 C4 校准交叉评测,4 bit 是 5.69 对 5.70,3 bit 是 5.75 对 5.75,2 bit 是 6.05 对 6.07,换校准数据,数字几乎逐位不变,KV 统计量对数据选择不敏感。反过来,服务负载固定(比如全是代码补全)就应该用负载同分布的数据校准——40 篇引过 AWQ 的结论:通用服务换分布代价小,专用服务同分布校准收益直接。
四、困惑度与零样本任务
第 1 层是困惑度。它是量化论文的标配,GPTQ 论文说得直白:困惑度类任务"已知对量化格外敏感"。OPT-175B 上 3 bit RTN 崩到 7.3×10³(fp16 基线 8.34,39 篇表 5),这种崩坏 PPL 最先反映。协议也高度统一:序列切成不重叠的 2048 token 段,算下一 token 对数概率的指数平均;零样本任务统一走 EleutherAI 评测框架。便宜、灵敏、可复现,适合当回归指标。
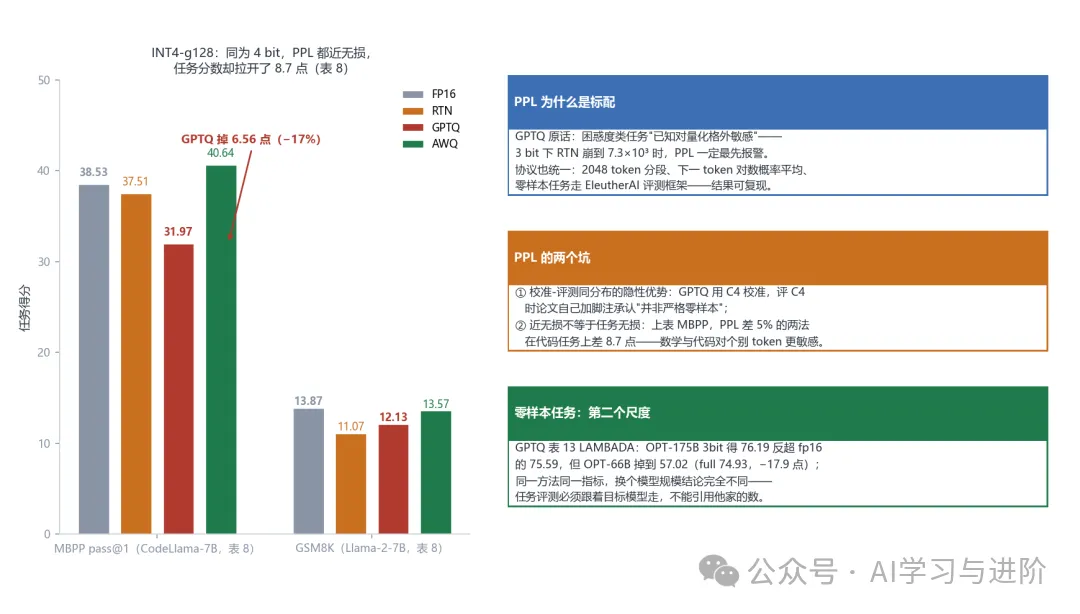
它有两个坑。坑一是校准-评测同分布的隐性优势:GPTQ 用 C4 校准,附录里评 C4 困惑度时论文自己加了脚注,说校准数据采自 C4 训练集,"这个任务并非严格零样本"——同分布校准让 PPL 好看一点,读表时要记得这层关系。坑二是近无损不等于任务无损:AWQ 表 8 是现成的对照,INT4-g128 下各方法的困惑度都在 fp16 的 2%–9% 以内;MBPP 代码任务(CodeLlama-7B-Instruct)上,fp16 的 pass@1 是 38.53,RTN 37.51,GPTQ 掉到 31.97,AWQ 反而到 40.64——GPTQ 比 fp16 掉了 6.56 点、约 17%,与 AWQ 相差 8.7 点。GSM8K(Llama-2-7B)上是 fp16 13.87、RTN 11.07、GPTQ 12.13、AWQ 13.57。数学、代码这类任务对个别 token 的误差放大更敏感,多模态同理。
图4|自绘:同一套 INT4-g128 量化,PPL 与任务分数的落差。 左侧柱状:MBPP pass@1 从 FP16 的 38.53 掉到 GPTQ 的 31.97(−17%),GSM8K 从 13.87 掉到 RTN 的 11.07,AWQ 两项都追平 fp16;右侧三张卡解释 PPL 为什么是标配、它的两个坑、零样本任务的第二个尺度。
第 2 层是零样本任务,补上 PPL 看不见的部分:通用能力(LAMBADA、ARC、PIQA)与专项能力(数学、代码)分开考。GPTQ 表 13 的 LAMBADA 结果值得细看:OPT-175B 上 3 bit GPTQ 得 76.19,反超 fp16 的 75.59;OPT-66B 却从 74.93 掉到 57.02,掉了 17.9 个点。同一方法、同一指标,换个模型规模结论完全不同。这正是 40 篇的老结论在评测侧的再现:GPTQ 在 LLaMA-7B INT3 的困惑度 8.81 比 RTN 的 7.01 还差。零样本任务必须跟着目标模型跑,引用别家的数不算数。
五、长上下文专项:KV 量化在目标长度上评测
权重与激活量化的误差是一次性的,矩阵乘算完就结束。KV Cache 量化不同:误差随解码步累积,早期 token 的量化误差会参与此后每一步的注意力得分(42 篇)。所以 KV 量化有一条专属要求:必须在目标上下文长度上评测,短上下文的困惑度和任务分数不可外推到 4K、32K、128K。
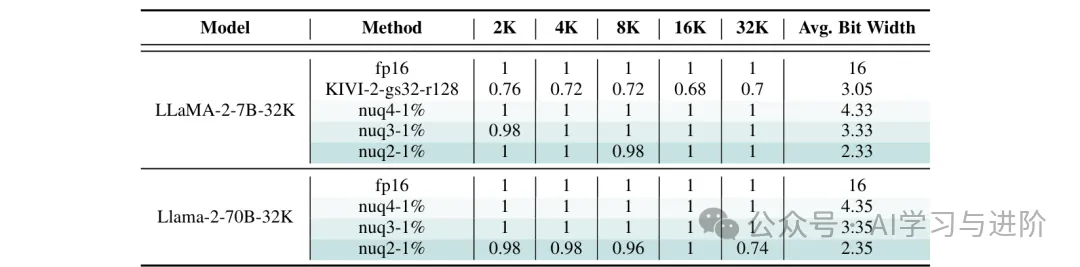
图5|论文原图(KVQuant 表 2):passkey 检索成功率。 LLaMA-2-7B-32K(位置插值加长训练)与 Llama-2-70B-32K(LongLoRA)在 2K–32K 各档的成功率,每档 50 样本;KIVI-2(G=32、R=128,平均 3.05 bit)成功率 0.68–0.76,KVQuant 的 nuq2-1%(平均 2.33 bit)全部成功——位宽更低反而更稳,非均匀档位把误差藏进了不敏感的地方。
passkey 检索的考法很朴素:在长文本里埋一个随机密钥串,让模型原样取回,直接测模型在目标长度上还能不能用上下文。KVQuant 表 2 的数字有两层信息。其一,位宽与成功率不单调:平均 2.33 bit 的 nuq2-1% 全过,平均 3.05 bit 的 KIVI-2 反而只有 0.68–0.76 的成功率,档位放置方式比位宽数字更决定长上下文表现。其二,70B 模型在 32K 处 nuq2-1% 也只有 0.74,fp16 基线与量化版的差距必须在目标长度上重新测。这与 34 篇讲的 RULER、大海捞针评测是同一件事:长上下文能力是独立的能力维度,通用任务分数替代不了。
六、端到端指标与四层清单
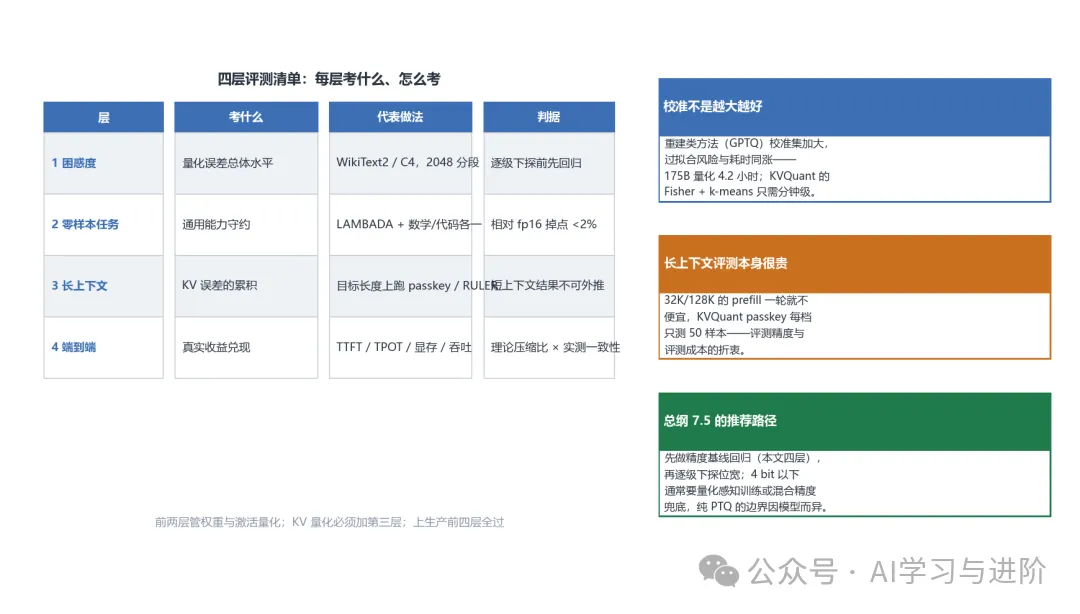
图6|自绘:四层评测清单与适用边界。 左侧是四层各自考什么、怎么考、判据是什么;右侧三张卡讲代价:校准不是越大越好(GPTQ 175B 量化 4.2 小时,KVQuant 的 Fisher 与 k-means 只需分钟级)、长上下文评测本身很贵(KVQuant 每档只测 50 样本)、总纲 7.5 的推荐路径(先回归再下探)。
第 4 层是端到端指标:精度守约之后,还要验证收益真的落到时间上。理论压缩比与实测加速之间隔着 kernel 的反量化开销与访存模式变化。40 篇核对过 AWQ 的加速数字:v1 论文的 1.45× 是 A100 上 kernel 级对 GPTQ INT3 的对比,终版换成系统级 TinyChat 的 2.7–3.9×,两个数字不能混用;42 篇的 KV kernel 是 Key 1.2–1.6×、Value 1.3–1.7×。上线前要实测 TTFT、TPOT、显存占用与吞吐四项,验证理论压缩比与实测带宽节约的一致性。四层合起来是一张清单:前两层管权重与激活量化,KV 量化必须加第三层,上生产前四层全过。
七、适用边界与代价
• 校准集的代价是单向的。 统计式方法(AWQ、SmoothQuant、KVQuant)校准便宜且稳健,16 条就够;重建式方法(GPTQ)校准集加大,过拟合风险与量化耗时同涨。负载固定就用同分布校准,负载开放就用通用语料小规模校准。
• 评测的成本集中在第三层。 32K/128K 的一轮 prefill 就不便宜,KVQuant 的 passkey 每档只测 50 样本,已是评测精度与成本的折衷;生产上按服务目标长度选两三档抽查即可,不必全档铺开。
• 精度基线回归先行(总纲 7.5):任何位宽下探之前,先用 fp16 模型把四层评测全部跑一遍存档;4 bit 以下通常需要量化感知训练(QAT)或关键层保留高精度的混合精度兜底,纯训练后量化的可用边界因模型而异。
• 校准与评测是一体两面。 校准集决定方案在哪个分布上守约,评测决定你能不能看见违约;用 C4 校准、用 C4 报 PPL 的组合,两层都看不见问题。
八、小结与下一篇预告
这一篇的机制可以复述成一段话。校准侧,四类方法从校准集各取所需:GPTQ 取 Hessian(C4 的 128 段 × 2048 token),AWQ 取逐通道均值(16 条即够),SmoothQuant 取逐通道最大值,KVQuant 用 16 条 × 2K 定缩放与档位,KIVI 在线统计、只借分布定分组方向。选集的两条经验:宜小不宜大,AWQ 用 16 条好过 GPTQ 的 192 条,换分布时 GPTQ 的困惑度 +2.33/+4.89、AWQ 只有 +0.60/+0.50,KVQuant 换校准数据几乎逐位不变(表 21);宜通用不宜特调,负载固定除外。评测侧分四层:PPL 是最灵敏的回归指标,但同分布校准会虚高、近无损不等于任务无损(MBPP 上分差 8.7 点);零样本任务跟着目标模型跑(OPT-66B 掉 17.9 点);KV 量化在目标长度上跑 passkey 这类长上下文检索;上线前用 TTFT/TPOT 验证收益落到时间。
精度守约的路径到这里完整了,收益侧还剩最后一个问题。同一套量化方案,Prefill 阶段算力受限,压显存访问的收益有限;Decode 阶段带宽受限,压多少字节省多少时间。收益在哪个阶段兑现、4 bit 以下为什么需要量化感知训练来兜底,下一篇按 Roofline 模型讲完这两点,模块 G 收束。
参考来源
• Elias Frantar, Saleh Ashkboos, Torsten Hoefler, Dan Alistarh, GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023:https://arxiv.org/abs/2210.17323 (C4 校准配置与"仍是零样本"表述(第 5 节)、困惑度类任务"已知对量化格外敏感"与附录中"并非严格零样本"的脚注、LAMBADA 零样本结果(表 13:OPT-175B 76.19/75.59、OPT-66B 74.93/57.02)、量化耗时(表 2:175B 4.2 小时)、OPT-175B 3 bit RTN 7.3×10³ 与 fp16 8.34(表 5)均出自此文)
• Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Wei-Ming Chen, Wei-Chen Wang, Guangxuan Xiao, Yujun Lin, Molin Yan, Zhiqiang Shen, Yao Lu, Chuang Gan, Song Han, AWQ: Activation-aware Weight Quantization for On-Device LLM Compression and Acceleration, MLSys 2024:https://arxiv.org/abs/2306.00978 (校准规模与分布交叉实验(Figure 8:16 条对 192 条、+2.33/+4.89/+0.60/+0.50)、"重建过程对校准集过拟合"的表述、任务评测(表 8:MBPP 38.53/37.51/31.97/40.64、GSM8K 13.87/11.07/12.13/13.57)、对校准依赖"最小,因为我们只测每个通道的平均幅度"的表述均出自此文)
• Coleman Hooper, Sehoon Kim, Hiva Mohammadzadeh, et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024:https://arxiv.org/abs/2401.18079 (passkey 检索(表 2:nuq2-1% 平均 2.33 bit 全通过、KIVI-2 0.68–0.76、70B 32K 处 0.74)、16 条 × 2K 校准配置、Fisher 加权 k-means 档位、校准数据交叉实验(附录 L 表 21:5.69/5.70、5.75/5.75、6.05/6.07)均出自此文)
• Zirui Liu, Jiayi Yuan, Hongye Jin, et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024:https://arxiv.org/abs/2402.02750 (KIVI-2 的分组 G=32、残差 R=128 与平均 3.05 bit 配置,"Key 沿通道、Value 沿 token"的分组依据出自此文)
• 本系列前置篇:39(GPTQ——Hessian 校准、表 2 耗时、表 5 精度的引用出处)、40(AWQ——Figure 8 与表 8 的原始出处)、41(SmoothQuant——α 的统计来源)、42(KV Cache 量化——KIVI 分组方向与 KV kernel 数字)、34(RULER 与大海捞针评测)、总纲 7.4(校准与评测方法)、总纲 7.5(推荐路径与边界)
• 后续篇目:44(量化收益的阶段反转与边界,模块 G 收束)