字数 2908,阅读大约需 15 分钟
Jev‑ToM评测:类型化决策模型,在心智理论任务上表现如何
心智理论(Theory of Mind,ToM),也就是推理他人信念、意图、情绪的能力,是对话智能体、协作Agent的核心基础。过去相关评测几乎全部面向生成式大模型。这篇论文提出 Jev‑ToM 评测框架,把**类型化决策模型(Typed Decision Model)**纳入心智理论测评,在9套公开ToM基准、合计11117道英文题目上,横向对比5款类型化决策模型与7款生成式大模型。
实验表明:TypeSafe Jev‑1.13综合能力位居前列,在情绪、社会语用类题目表现突出,但信念归因、心智状态应用任务仍存在明显短板;同时也揭示两个工程风险:置信度不能跨任务通用、附加理由既可以修复答案,也会破坏正确判断,不能直接拿来做生产系统的自动分流开关。
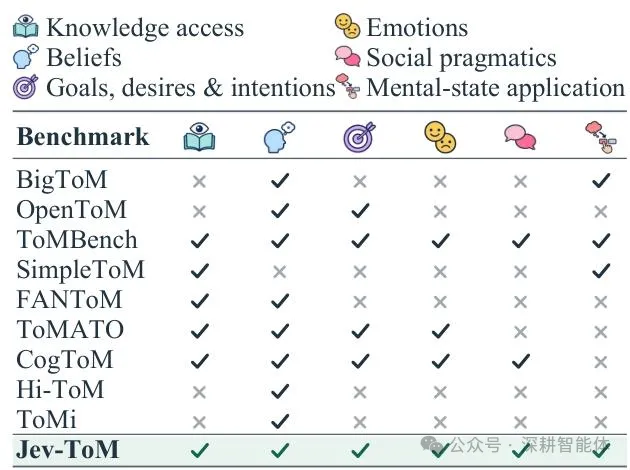
图1 9套基准的能力覆盖概览
图关键要点:横向为6大类心智能力:知识获取、信念、目标欲望意图、情绪、社会语用、心智状态应用;✓代表该基准包含该类题目,×代表不覆盖。Jev‑ToM评测集合完整覆盖六类能力。
一、背景:心智推理,不一定非要生成式大模型
对话、谈判、协作类Agent需要频繁做心智状态判断:对方知道什么、相信什么、意图是什么。这类任务很多时候是多选一的有限候选判断,不是开放式文本生成。
类型化决策模型(Typed Decision Model)专门处理这类场景:接收上下文、问题、候选选项,结构化输出选择结果+各个选项的概率分布,不需要长篇文本生成。它主打低时延、低成本输出标准化结构化结果,已经被用于文档判断、证据打分等场景。
但行业缺少针对ToM能力的系统性测评:
- 1. 不清楚类型化模型在信念、情绪、意图等不同心智子任务的强弱分布;
- 2. 置信度输出是否可靠,能不能直接用来做“高置信自动过,低置信转交大模型”的分流;
- 3. 输入附加理由,会对模型选择造成什么样的扰动。
Jev‑ToM把9个经典ToM数据集做标准化对齐,划分六大能力维度:知识获取、信念、目标/欲望/意图、情绪、社会语用、心智状态应用。
心智状态应用:不只是推断别人的想法,还要进一步用这个推断预测行为、做决策判断,难度更高。
表1 评测数据集总览
表注:全部使用公开已有的开发子集,剔除50道条件不完整的BigToM样本;候选选项数量跨度很大,从2个到15个不等。
评测一共12个模型:5个类型化决策模型(Jev‑1.13、Open‑Jev‑2B、Valen、Tiny‑Jev、OpenJev‑0.6B);7个生成基线(SmolLM3‑3B、Llama‑3.1‑8B、GPT‑4.1‑nano、GPT‑4o‑mini、GPT‑3.5‑1106、GPT‑5.6‑Luna、DeepSeek‑V4‑Flash)。
严格计分规则:输出必须格式合法,概率总和在允许误差范围内,最大概率要分配给选中选项;格式非法直接算作错误。
二、主评测结果:能力不均衡,不能只看总得分
表2 各模型整体准确率(基准等权重,%)
表注:如果去掉基准自带的控制题,Jev‑1.13得分下降至69.1%,GPT‑3.5‑1106为70.9%,二者排名反转。说明聚合总分高度依赖数据集构成,不能单凭一个总分数选型。
分六大能力维度看强弱:
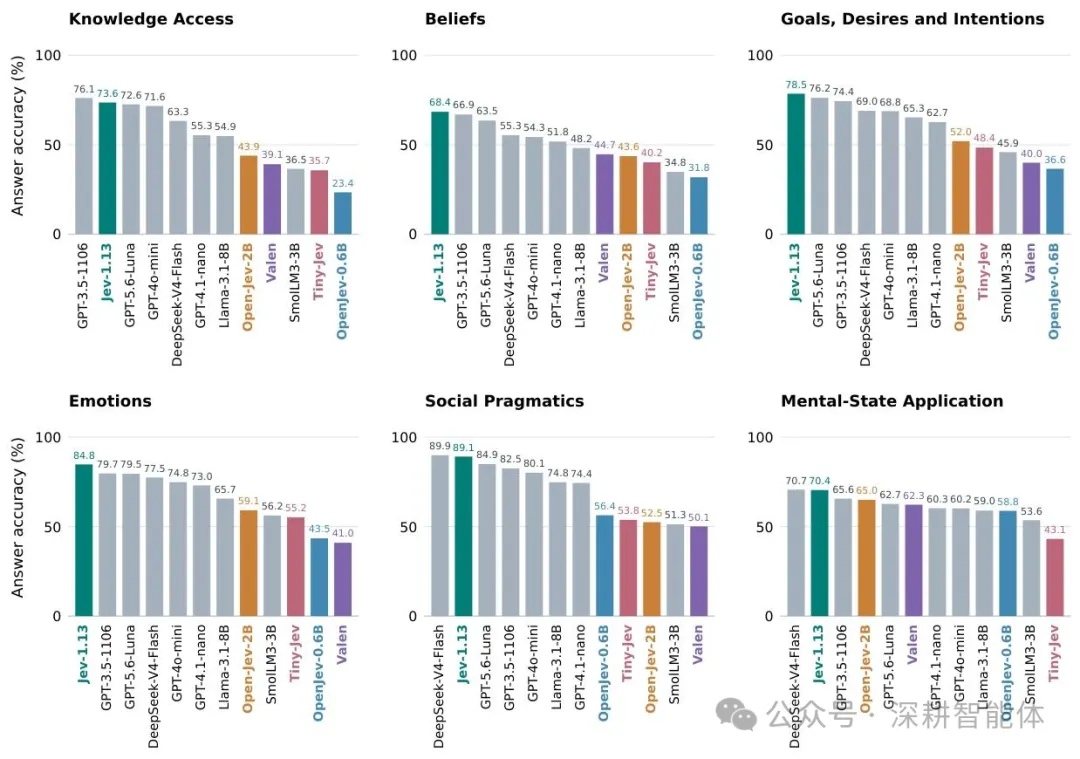
图2 六类心智能力各模型准确率柱状图
图关键要点:子图依次是知识获取、信念、目标欲望意图、情绪、社会语用、心智状态应用;彩色为类型化模型,灰色为生成模型。Jev‑1.13在情绪、社会语用两个维度拿到第一;信念、心智状态应用是它的短板。
核心观测:
- 1. Jev‑1.13在**情绪84.8%、社会语用89.1%**表现最优;但信念68.4%、心智状态应用70.4%存在明显短板。
- 2. 其他开源类型化模型能力差异巨大,不存在“同架构就能力接近”的现象:Open‑Jev‑2B、Valen各有擅长子任务,但整体显著弱于Jev‑1.13。
- 3. 总排名会随数据集过滤条件反转,选型必须匹配业务对应的心智子任务,不能迷信整体榜单。
三、两大关键干预实验:置信度与附加理由
3.1 置信度不能跨任务通用
开发者很容易产生一个设想:设置一个固定置信度阈值,比如0.9,置信高于阈值直接采纳结果,低于阈值交给大模型复核。
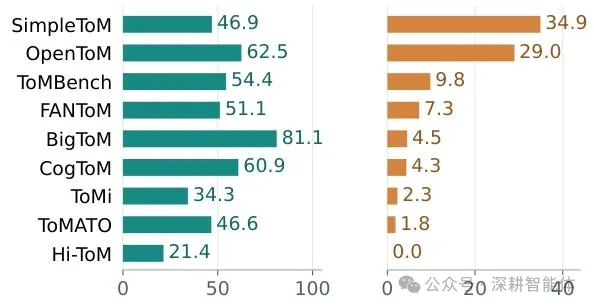
图3 Jev在阈值0.9条件下,各基准覆盖率与保留样本错误率
图关键要点:左侧绿色是样本保留覆盖率,右侧橙色是保留样本内部错误率。同样阈值0.9,Hi‑ToM保留33个样本错误率0;SimpleToM保留46.9%样本,错误率高达34.9%。
重点:同一个0.9置信阈值,在不同基准表现天差地别。不能直接拿一个全局阈值做生产分流,必须针对自己业务数据做任务级的置信度校准。
3.2 附加理由:既能修复也能破坏判断
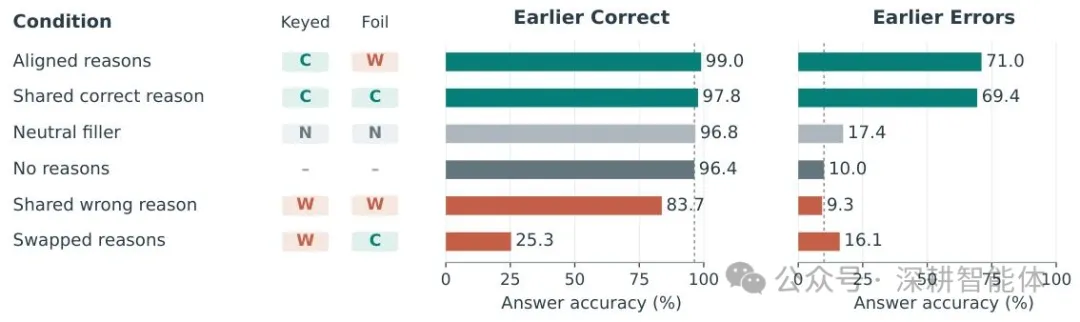
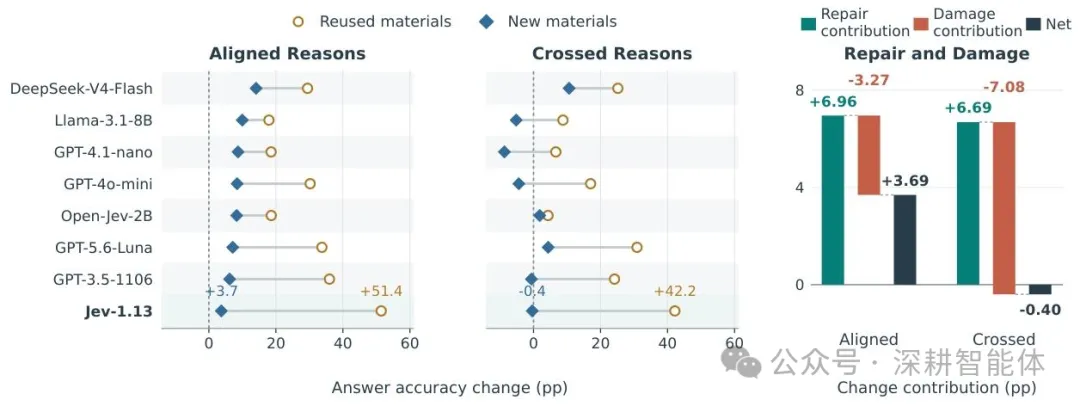
论文设计对照实验,给每一个选项附带一段理由,分为对齐(理由支持本选项)、交叉配对(理由和选项乱序打乱)两种条件。
图4 对齐/交叉理由条件下准确率变化,修复与损伤拆解
图关键要点:圆圈为复用旧样本,菱形为全新构造样本;右侧面板拆解修复(错误→正确)和损伤(正确→错误);对齐理由带来正向增益,交叉配对条件下修复和损伤同时存在,净收益几乎归零。
- 1. 对齐理由(理由匹配选项):在旧样本上带来很大提升;换到全新构造样本,增益大幅缩水。
- 2. 交叉配对(理由和选项乱序):即便正确选项还在候选集合内,模型正确率依然下滑。
- 3. 深层现象:修复与损伤是同时发生。交叉条件下,修复约7个百分点,但损伤也到7.1个百分点,净变化几乎为0。
现实启示:给选项附加解释理由,不是无脑加分项。如果理由来源不可控(用户输入、检索得到),错误的理由会直接扭曲模型选择,哪怕正确答案还在候选列表。
表3 交叉配对条件下输出分布(%)
表注:Jev会出现7.5%概率输出格式失效;生成式模型几乎没有格式失效,但更容易出现“选中理由,却选错答案”的现象。
另外一组候选扩展实验:把候选从8对扩充到16对,即便正确选项还在池子里,Jev与GPT‑3.5准确率都会下降。候选集合膨胀,会伤害选择质量,不只是候选多计算开销变大。
四、资源开销对比:速度与成本优势
图5 准确率‑成本、准确率‑响应时间帕累托图
图关键要点:左图准确率对每千次请求参考美元成本;右图准确率对平均响应毫秒。Jev‑1.13兼顾高准确率、低成本、低时延,平均响应282ms。
Jev‑1.13每千次请求参考成本 $0.0295:
- • 对比GPT‑4.1‑nano:成本降低32.7%,准确率高出11.7个百分点;
- • 对比GPT‑4o‑mini:成本降低56.3%,准确率高出6.7个百分点;
- • 平均响应时间282ms,显著低于参比的生成模型。
注意:该开销为评测环境观测结果,受并发、服务商限流影响;优势针对有限候选多选判断场景,开放式文本生成不在此对比范围内。
五、工程启示与局限
工程启示
- 1. 类型化决策模型可以作为心智推理的组件,但能力分布不均衡。 Jev‑1.13擅长情绪、社会语用类的有限候选判断;在复杂信念推理、心智状态应用任务短板明显,选型不要只看综合总分,要匹配业务实际子任务。
- 2. 置信度阈值不能全局复用。 同一个0.9阈值,不同任务错误率差异巨大;生产环境做自动放行‑人工复核分流,必须做业务数据集上的校准,不能直接照搬论文阈值。
- 3. 附加理由是双刃剑。 可信对齐理由可以改善判断;来源不可控的理由(检索、用户输入)会带来严重干扰,哪怕正确选项仍然存在。
- 4. 候选集合不能无限制膨胀。 选项数量扩张,会降低选择质量,并非仅仅增加计算量。
- 5. 类型化模型会出现结构化输出失效;生成模型几乎没有格式报错,但容易发生“选对理由选错答案”的现象,两种失败模式不一样,都要做结果校验。
存在局限
- 1. 评测全部为英文文本任务,不覆盖多模态、多语言心智推理;
- 2. 只是组件级评测,没有接入完整对话Agent做端到端业务效果验证;
- 4. 干预实验是受控模拟,真实业务里理由来源更加复杂,效果不一定直接平移。
引用论文观点:> 类型化决策模型有速度成本优势用于有限候选心智判断,但不能直接部署上线;任务专属置信度校准、候选集合设计、输出有效性校验是集成前的优先事项。
结语
Jev‑ToM这篇工作,填补了类型化决策模型在心智理论领域的评测空白。它告诉我们,面向Agent心智推理,不一定全部依赖生成式大模型做输出;Jev‑1.13在情绪、社会语用类多选任务表现优秀,同时具备时延、成本优势。
但它也给出很现实的警示:不要被结构化输出、自带置信度这些特性迷惑。 置信度不能一套阈值打所有任务;输入附带的理由解释,既可以修复错误,也能把原本正确的答案带偏。
对于开发对话、协作Agent的工程师:可以把类型化决策模型作为心智状态判断组件,但必须针对自身业务做校准、校验输出格式,不能直接把模型输出当成可靠事实。
https://arxiv.org/pdf/2610.18610