你搜「LLM 评测工具」,大概率会撞见同一份名单。
deepeval、promptfoo、ragas、langfuse、langsmith。五个名字并排放在一张表里,后面跟着几列:开源吗、免费吗、支持多少指标。
我把它从头看到尾,也没弄明白该装哪个。后来才想清楚,那张表回答的是「每个工具有什么」,而我真正想知道的是「我这种项目该用哪个」——两回事。
那就别看表了,直接装。同一台 Mac,一个个来。
第一个 import 就崩了。
01 装完就坏的那一个
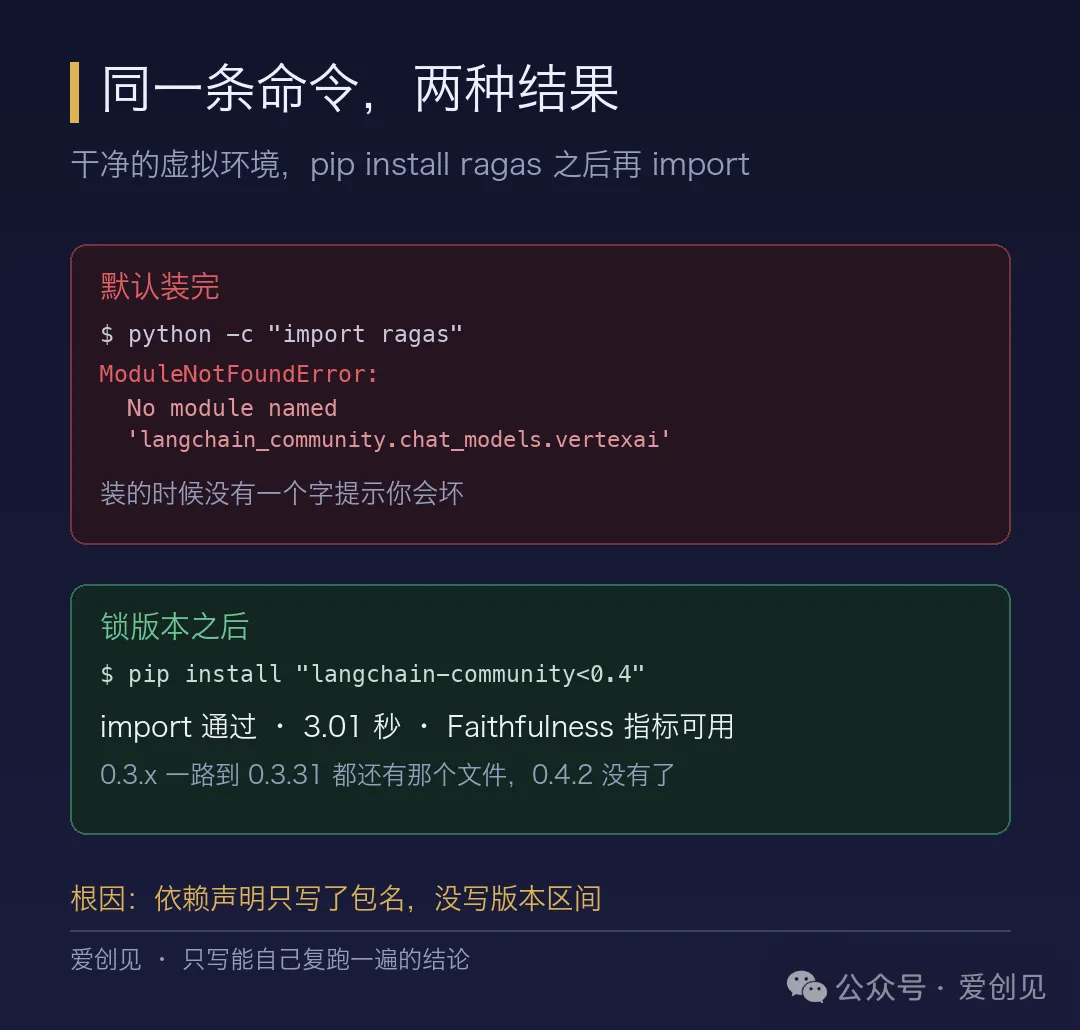
命令很普通,pip install ragas。装的过程没有任何异常,没报错,也没警告。
然后 import ragas:
ModuleNotFoundError: No module named 'langchain_community.chat_models.vertexai'
我第一反应是自己写错了。查了一圈,不是。
是 ragas 自己的代码在第 12 行写死了一个路径:
from langchain_community.chat_models.vertexai import ChatVertexAI
而今天装出来的 langchain-community 0.4.2,目录里已经没有这个文件了。
翻它的依赖声明,就一行:
Requires-Dist: langchain-community
没有下限,也没有上限。翻译过来是「随便哪个版本都行」。上游哪天把一个模块删了,它这边当天就断。
这种坏法在 Python 生态里很常见。装的时候一声不响,等你在自己机器上 import,才摔一跤。
我去翻了历史包,0.3.x 一直到 0.3.31 都还带着这个文件,0.4.2 就没有了。
所以修法只有一个方向,往回锁:
pip install "langchain-community<0.4"
锁完再 import,3.01 秒,过了,Faithfulness 也能正常用。
一个九个月没发版的包,坏在了别人更新太快上。
02 装完的账
这一节的方法说清楚,免得看着像编的:装之前先清了 venv,装完量目录体积、数包数、记耗时,五个工具的版本号全部从 PyPI 和 npm 现查。
五个工具,两次安装。
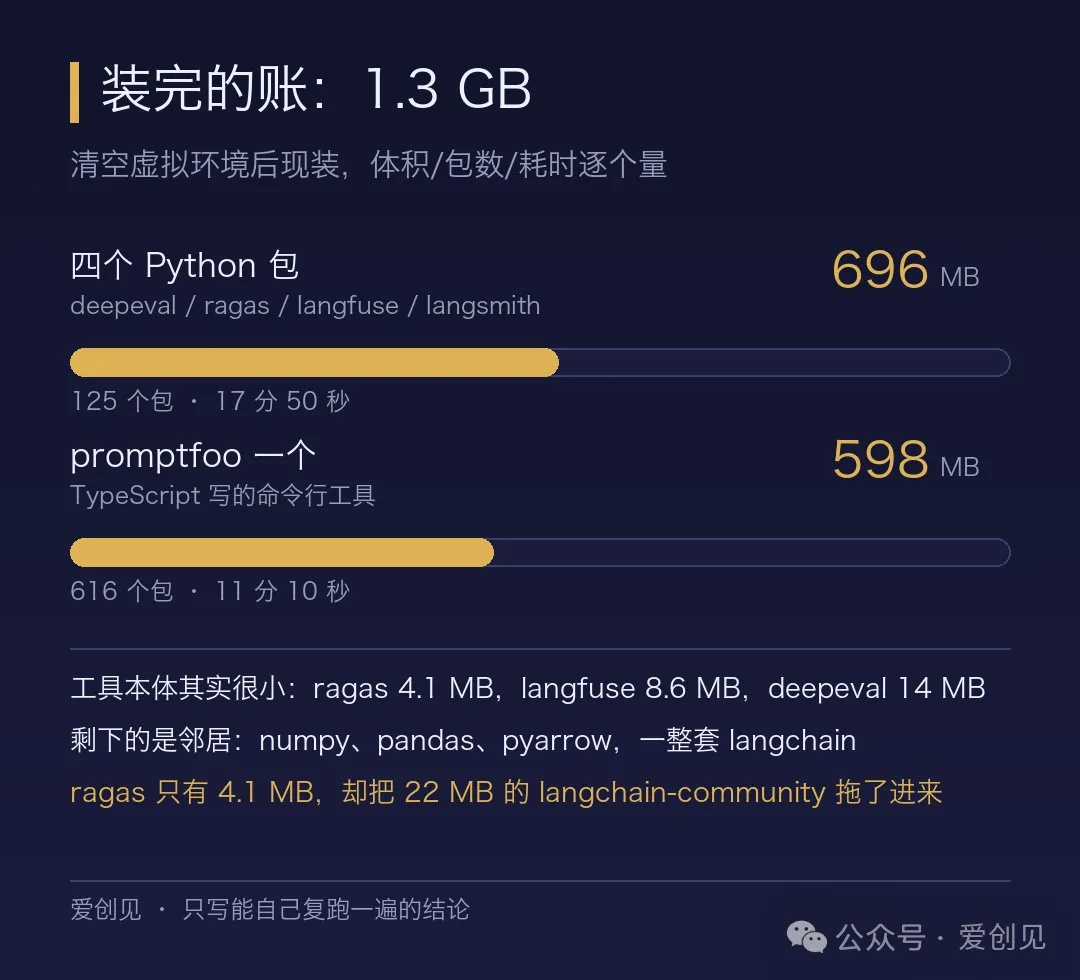
四个 Python 包(deepeval、ragas、langfuse、langsmith)一起装:696 MB,125 个包,17 分 50 秒。
promptfoo 单独装:598 MB,616 个包,11 分 10 秒。
加起来 1.3 GB。为了评一评模型答得好不好,先装进去 1.3 GB。
这里面最占地方的还不是工具本身。
deepeval 本体 14 MB,langfuse 本体 8.6 MB,ragas 本体只有 4.1 MB。
剩下的大头是它们带进来的邻居:numpy、pandas、pyarrow,还有一整套 langchain。
ragas 只有 4.1 MB,但它把 langchain-community(22 MB)、langchain-core(5.5 MB)、langchain、langchain-openai 全拖了进来。
工具的体积不是它的代码,是它的朋友圈。
promptfoo 那 616 个包更夸张。一个命令行工具,装出了一个小型前端项目的依赖量。
03 一个大声报错,一个悄悄闭嘴
装完就该跑第一次了。
我先把所有 API key 清空,看它们在「什么都没有」的状态下怎么反应。
deepeval 的反应是:直接抛错。你没配模型,它就告诉你没配模型。
langfuse 的反应是:什么都不说。
它的构造函数不抛异常,auth_check() 也不抛异常。
只在控制台打了一行字:
Authentication error: Langfuse client initialized without public_key. Client will be disabled.
「客户端将被禁用」,这句话藏在日志里,不在异常里。
你的程序照常跑完,一行 trace 都没记下来,退出码是 0。
langsmith 介于两者之间:初始化不报错,等你真的去查数据,才还你一个 401。
我把这个行为归成一句话:
评测工具会大声失败,观测工具会安静失败。
这不是 bug,是设计取向。
观测 SDK 的第一原则是「绝不能拖垮业务」。所以它宁愿丢掉自己的数据,也不愿意让你的请求多等一毫秒。
代价是,你以为在监控,其实什么都没记。
04 它们自己就把话说清楚了
我原本打算从功能上论证「这是两类东西」。
后来发现不用论证,五个工具的官方简介自己就写着。
deepeval:The LLM Evaluation Framework(LLM 评测框架)。
ragas:Evaluation framework for RAG and LLM applications(面向 RAG 与 LLM 应用的评测框架)。
promptfoo:LLM testing, red teaming, and security evaluation(测试、红队、安全评估)。
langfuse:LLM observability/tracing, datasets, experiments, LLM-as-a-judge evaluation, and prompt management。
langsmith:Observability and Evaluation Platform 的客户端。
注意 langfuse 那一行,「可观测」排在第一,「评测」排在第四。
langsmith 也是把 observability 放在 evaluation 前面。
这不是我分的类,是它们自己写的顺序。
05 真正的分界线:你在等答案,还是在等流量
把五个摆在一起,分界线其实只有一条。
左边三个,deepeval、promptfoo、ragas,要你先交出答案。你得写题目,还得把标准答案写下来。它拿你的答案跟模型的答案比,然后给分。
这类工具的核心资产是数据集。数据集越像真实业务,分数才越有意义。
右边两个不一样。langfuse 和 langsmith 不问你要标准答案,它们记录每一次调用的完整经过:输入是什么、检索到了什么、调了哪个工具、花了多少 token、最后说了什么。核心资产是日志。
所以有个很硬的推论:
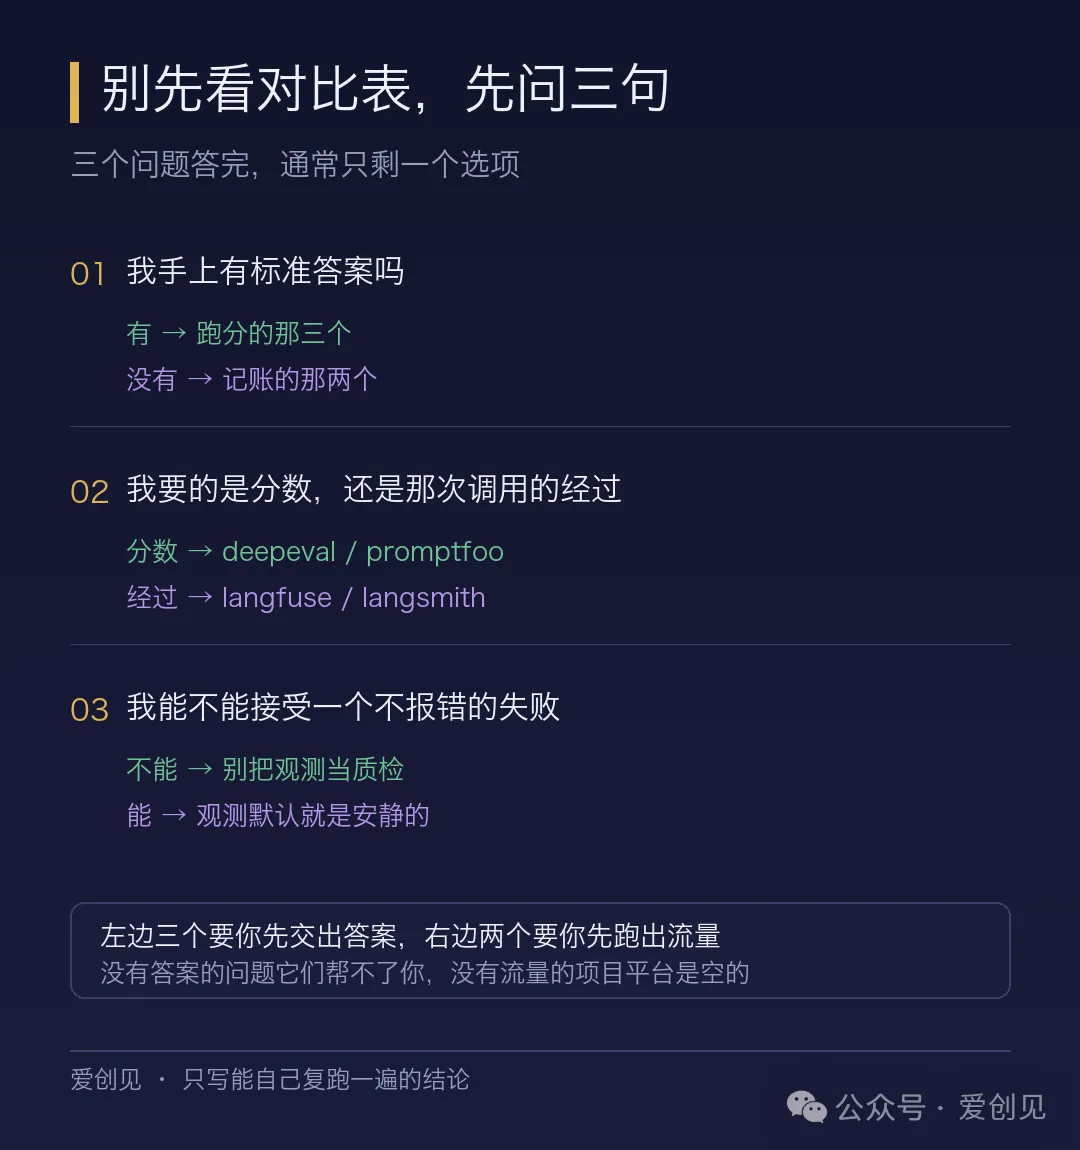
没有标准答案的问题,评测工具帮不了你;没有流量的项目,观测平台是空的。
举个具体的。「上周三下午那次超时,是卡在检索还是卡在模型」——这个问题只有日志能答,任何离线评测都答不了。
反过来,「这次改完提示词,整体准确率是涨了还是掉了」,日志答不了,只能靠数据集。
很多人装完 langfuse 之后的第一句抱怨是「它不告诉我准确率是多少」。
对,因为它从来就没打算告诉你。它只负责把那次调用原样摊开,准确率要你自己在上面挂一个裁判去算。
反过来,用 promptfoo 跑完一百分,上线以后某一次答错了,你也查不到那一次到底检索到了什么。
一个管「这批题对不对」,一个管「那一次发生了什么」。
这两件事都要,但它们不能互相替代。
好在这两类可以接起来。评测工具算出来的分数,可以写进观测平台,挂在对应的那次调用上。
你的历史 trace 就成了下一轮的数据集。这条回路是通的,只是要你自己接。
06 五个各自的位置
按这次装出来的实际情况,一个一个说。
deepeval 有 58 个内置指标,五个里最全。幻觉、答案相关性、多轮对话、MCP 工具调用、语音质量,都在里面。写法贴近 pytest,适合已经在写单测的团队。
它的确定性指标不需要任何模型,比如完全匹配,0.88 秒就出分。但这也暴露了一个问题,下一节说。
promptfoo 用 YAML 写配置,面向命令行和 CI,红队测试是它跟另外两个拉开距离的地方。代价是依赖重,616 个包。
有个设计细节值得知道:它连 --version 都要先把本地 SQLite 库建起来。库建不起来,命令就停在参数解析之前,什么也干不了。
我这次的运行环境里,SQLite 在任何路径都写不了(报 disk I/O error),所以 promptfoo 我一次都没跑起来。这是我的环境问题,不是它的缺陷,如实记在这里。
ragas 有 39 个指标,方向最集中。Faithfulness、Context Precision、Noise Sensitivity,这几个名字一看就知道是给 RAG 准备的。
除了停更这件事(下一节说),它还有个隐蔽的门槛:默认假设你手上有检索结果、有上下文、有标准答案这三段材料。少一段,指标就算不出来。
langfuse 开源,可以自托管,但「自托管」这三个字有具体重量。官方 docker-compose 里是 6 个容器:web、worker、ClickHouse、MinIO、Redis、Postgres。
ClickHouse 是为 trace 查询准备的,不是随手能删的组件。
还有个版本号上的坑:它的平台版本是 4.x(最新 4.75.0),Python SDK 却是 5.x(最新 5.1.0)。两边不同步,照着老教程写的 start_as_current_span 在 5.x 里已经不存在了,现在叫 start_as_current_observation。
想让评测跑在自己的机器上,先得能运维一个数据库集群。
langsmith 是托管服务,SDK 轻,import 只要 0.17 秒。它的 Python SDK 仓库 langchain-ai/langsmith-sdk 已经在 2026 年 10 月 16 日归档,代码迁去了 langsmith-python 和 langsmith-javascript。找文档的时候别停在旧仓库。
07 免费的那部分,为什么没用
deepeval 的确定性指标不要钱,不要 key,0.88 秒出分。
我拿它跑了两条。
第一条,答案和标准答案一字不差,1.0 分。
第二条,把「7 天内可退」写成「7天内可以退货」,0.0 分。
少一个空格、多一个「可以」,分数就从满分掉到零。
这就是确定性指标的真实处境:便宜到不要钱,也严格到没法用。
真实业务里,没人会用你标准答案的措辞说话。
所以大部分指标后面站着的其实是同一个东西:一个当裁判的模型。
它读题、读模型的答案、读参考答案,然后给一段理由和一个分数。
这条路能判对上面第二条。代价是要花 token、要一个能用的模型、还要先校准它跟人的判断对不对得上。
评测的成本,从来不在工具,在「判断依据从哪来」。
1.3 GB 的安装包,一次就装完了。让一个裁判的判断跟你一致,那是另一件事。
这也解释了一个常见现象:工具装了一堆,评测还是跑不下去。
卡住你的地方不在 pip install,在你写不出那 50 条标准答案。
08 ragas 那笔账,得单独算
我把发版记录拉了一遍,近 12 个月:
deepeval 63 个版本,langfuse 81 个,langsmith 151 个。
ragas 5 个。
最后一个版本 0.4.3 停在 2026 年 1 月 13 日。仓库在 2 月 24 日之后没有新推送。组织名也从 explodinggradients 改成了 vibrantlabsai。
这不是说它不能用了。
它的 RAG 指标设计得确实好,那 39 个指标的切分比另外两个细。
但你得接受三件事:
第一,你今天装它会崩,得手动锁 langchain-community<0.4。
第二,以后 langchain 再动,不会有人替它修。
第三,别指望新特性。
它不是死了,是停在了 2026 年 1 月。
如果你的项目就在那个时间点附近,用它没问题。如果你要跟着 langchain 一路升级,它会是那个拖后腿的。
09 怎么选:先问三个问题
其实不用看那张对比表。问自己三句话,比看十张表管用。
第一句,我手上有没有标准答案。有,就去看左边那三个;没有,右边那两个才是你的。这一句就能筛掉一半纠结。
第二句,我要的是分数,还是那一次调用的完整经过。要分数,deepeval 或者 promptfoo;要看经过,langfuse 或者 langsmith。
第三句有点刺人:我能不能接受一个不报错的失败。不能的话,别把观测当质检用。它默认就是安静的,不会替你喊。
三句答完,大多数人只剩一个选项。
如果还要再简化,我给一条:
先装跑分的那一个,等有了线上流量,再装记账的那一个。
顺序反了,你会发现平台里空空荡荡,什么也看不见。
如果你是一个人维护一个小产品,我的建议还能再具体:先花半天,从线上聊天记录里挑二十条真实问题,逐条写下你认为对的答案。
这二十条就是你的第一个数据集,成本是半天。
用它跑一遍 deepeval,把结果放进 CI,你就有了第一道防线。
等日调用量过了一千,再来考虑 langfuse。到那时你才有东西可查。
最后
装完这一遍,我最大的感受不是哪个工具更强。
是「五个评测工具」这个说法本身就在误导人。它们被摆在一起,只因为都能对 AI 的输出做点什么,可做的是完全不同的事。
刚起步的项目,缺的是十个能跑起来的测试用例,不是一个能查 trace 的平台。
已经上线的系统,缺的是知道上周三下午那次超时卡在哪一步,不是再跑一遍离线数据集。
工具没有高下,只有你手上有什么。
手上有答案,就去跑分。手上有流量,就去记账。
两样都没有,那就先去做那件能让你有答案的事。
关注爱创见,每天一篇 AI 深度拆解。这篇要是帮你省了半天试错,点个❤️,顺手把你踩过的坑写在评论里,我下篇接着验。