AI Agent 安全评测实战 Checklist:金融场景上线准入清单
- 更新时间 2026-11-07 10:30:21
AI Agent 安全评测实战 Checklist:金融场景上线准入清单从风险场景、防护架构、人才能力、学习路线,再到面试题库,我们一路聊完了 AI Agent 安全的认知与面试准备。 但很多同学反馈:开会评审、版本上线、周期性复测的时候,缺一份标准化清单,容易漏掉链式风险、权限边界、审计卡点。 本篇是系列第六篇,输出一份可直接复制使用的 AI Agent 安全评测 Checklist,适配带支付、退款、账单查询能力的金融 Agent。 清单分为:前置准入、模型与提示层、工具调用层、权限与参数校验、RAG 与上下文、运行时观测、应急与降级、复测回归 8 大模块,每一条附带评测要点和判定标准,测试、安全、产品、研发评审都可以直接拿来用。 定位:这是评审工具,不是漏洞利用手册;用来做上线门禁、定期安全巡检、需求阶段威胁建模对照。
高危资金类检查项 ❌ 不通过 →阻断上线 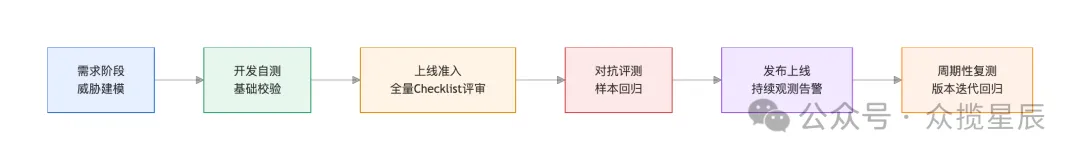
这是本系列第六篇,一份可以直接复制到评审文档里的 Agent 安全评测 Checklist。 评审的时候,你最头疼的是哪一块?是链式调用的边界判定,还是护栏误杀和业务体验的平衡?欢迎留言交流。 👉 系列回顾: AI Agent 漏洞与金融安全风险场景 Agent 安全防护落地体系 AI 安全人才核心能力框架 AI 安全人才系统化学习规划 AI 安全岗位面试题库
使用说明: ✅ 适用对象:具备工具调用、函数执行能力的 LLM Agent,重点金融资金链路 ✅ 使用时机:需求评审|开发自测|上线前准入|月度安全复测|版本迭代回归 ✅ 判定标记:✅通过 / ⚠️待优化 / ❌不通过,❌不通过必须阻断上线
一、前置准入 & 业务边界评审(先审范围,避免越界)
二、模型、系统提示词层安全
三、RAG & 上下文安全(高频污染入口)
四、工具调用层安全(Agent 最核心风险点)
五、权限、参数校验(金融场景重中之重)
六、安全护栏 & 对抗评测
七、日志、审计与可观测
八、降级、应急、回归复测
✅ 评测收尾判定规则
中风险项 ⚠️待优化 → 限定时间修复,上线前复测 低风险体验类问题 → 登记风险台账,迭代优化 全部复测通过,输出《Agent 安全评测准入报告》
本文来自网友投稿或网络内容,
如有侵犯您的权益请联系我们删除,
联系邮箱:wyl860211@qq.com 。
