案牍伙伴|沂蒙:评测与 Benchmark,如何让法律 AI 做得更好?
- 更新时间 2026-11-07 00:33:14
在法律 AI 公司,产品&法务实习生会做些什么?
张沂蒙在案牍的四个月里,既参与法律任务,也参与产品相关工作。一边要理解需求、处理材料、检查结果,另一边则要继续想:这些工作能不能借助 AI 和产品完成得更好?
结合她曾经在大厂参与的法律 AI 评测项目,接触到模型团队怎样系统地检查 AI 的表现,两段经历让她有机会从不同角度思考同一个问题:
法律 AI 的进步,除了依靠大厂的 AI 模型变强,还可以来自哪里?
这一期「案牍伙伴」,我们从她在两个岗位上的实践出发,聊聊法律工作、产品与评测之间的联系。
Q:介绍一下自己吧?为什么会选择来案牍?
大家好,我是张沂蒙,清华法硕在读,在案牍做了四个月的产品&法务实习生。
很长一段时间,我觉得法学生的路好像就那么几条:律所、法务和公检法。后来看到一句话,对我启发很深:
「法学不应该是缩窄我发展路径的石墙,而应该是让我登高一点的云梯。」
同时,学院计算法课程的老师也会鼓励我们去探索法律与 AI 的交叉。我就想带着自己的专业知识,看看这些技术能怎样改变具体工作,于是我选择来到案牍。
这份实习很有意思的地方,是我既要参与法律相关任务,也有机会从产品的角度,思考这些任务可以怎样完成。
很爱人类的司猫壮壮
Q:先从法务相关工作说起,你接触到的是什么样的问题?
一个很直接的感受是:合同处理、企业上市核查这些非诉法律工作里,有很多繁琐的细节,而这些细节又关系着结果能不能交付。
比如,IPO项目中的核查底稿,需要把核查发现和支持它的证据记录下来。每个主张都要有完整的证据链,不能只形成一份看起来完整的文字。
因此,任务交到手里,首先要理解对方需要什么、结果会怎样使用,再弄清流程、处理材料,最后检查结论有没有依据。
在案牍,从办公协作中使用的飞书机器人,到面向非诉法律任务的Andoo 工作台(案牍上新|Andoo,非诉律师的法律 AI 工作台),这些工具的诞生都来自这些具体需求。它们帮助处理重复步骤、提高效率,让我也有机会独立推动一整个项目的流程,而不只是负责其中的一小环。
但用了工具,仍然需要检查结果。遇到 AI 的错误或报错,要结合业务去分析、纠正。这个过程也会让人发现,原来哪一步容易卡住,哪些需求还没有被很好地解决。
对我来说,参与这些任务的价值,是把「法律工作有什么需求」从一个抽象问题,变成自己需要面对和处理的具体事情。
Q:同时做产品实习,会怎样影响你看待这些任务?
完成一次任务,和思考一个产品怎样帮助大家完成同类任务,关注点会有所不同。
做具体工作时,发现结果不符合要求,我需要把它处理好。从产品的角度,还要继续追问:为什么会出现这个问题?下次遇到类似任务,能不能通过调整工具的处理方式,减少同样的问题?
拿前面说的核查底稿要求来说,如果 AI 给出了结论,却没有留下支持它的材料出处,就不能只说一句「再仔细一点」。还要检查材料有没有提供完整、任务要求有没有表达清楚,以及处理过程中有没有把结论与依据保留下来。
这样去看,产品的改进就有了更具体的方向:不再笼统地要求 AI 表现得更好,而是先弄清哪一个环节需要调整。
我的很多工作都需要与 AI 工具搭档。法务相关工作中遇到的问题,也就成了我理解产品需求的重要来源。
做法务相关任务,让我知道结果要拿来做什么;做产品,让我继续追问,怎样让工具更稳定地帮助人得到这个结果。
Q:你曾经参与了大厂的法律 AI Benchmark项目。这是怎样一项工作?
简单说,就是系统地检查 AI 能不能完成给它的任务,以及哪些地方还做不好。我参与的是其中法律业务相关的一部分。
做法律工作时,我们会检查一份底稿的结论有没有依据、合同里的重要风险有没有遗漏。模型团队也需要这样的检查,但他们面对的任务和输出更多,还要随着模型更新不断比较:这次优化之后,哪些问题解决了,哪些问题依然存在?
只试几个问题、看某一次回答,往往不够。需要选取一组任务,事先明确每项任务要做到什么、哪些错误不能接受,再按照相对一致的要求检查结果。这样才能知道模型在哪些地方可靠,改动前后的表现又有什么差别。
这类有组织的检查,就是评测——把选定的任务、所需材料和评价标准整理成可以反复使用的基准,就形成了我们常说的 Benchmark。
我参与的法律 Benchmark 项目,覆盖合同审查、尽职调查和 IPO 等场景。我主要参与非诉业务与合同板块的部分任务设计:项目团队提供需要检查的方面和参考资料,我负责设计具体题目、撰写参考答案和评分要点,以及整理没有达到要求的案例。
它让我有机会把平时检查工作时需要考虑的问题,放进一个更系统的评价流程里。
Q:这样的岗位,会不会主要是在做数据标注?
里面确实有按规则记录问题、给错误分类、逐条复核这些重复而细致的工作,这些当然很重要:数据或评价有问题,后面的比较就可能失去意义。
但判断一个岗位能带来什么锻炼,还需要看是否有机会进一步理解:为什么这样判断,规则有没有讲清楚,错误发生在哪里,以及怎样让这些工作更高效地完成。
大厂需要处理的数据多、覆盖的场景多,还要随着模型迭代反复检查。如果全靠人工逐条处理,工作量会很大。因此,项目需要尝试把能够明确表达的评分要求,转成可以批量运行的流程。
我参与的一部分工作,就是让 AI 按照规则给其他 AI 的回答评分。这种做法叫 LLM-as-a-judge,可以理解为「让大模型担任评分者」。我们会把具体得分点、常见错误和不能触碰的红线,写进给模型的评分说明,也就是提示词,再运行案例,对比 AI 的评分与人工判断是否一致。
每一轮都不只是改几句话,还需要回到合同场景:核心风险是什么,哪些是一般瑕疵,哪些足以触发红线,规则有没有表达清楚?AI 评分与人工判断不一致时,要检查差异出在哪里;评分标准本身是否合理,也仍然需要结合业务核验。
这个过程要求我同时理解法律场景、评分规则和模型怎样执行指令。
同一处评分差异,既可能来自对风险的理解,也可能来自规则表达不清,需要把这几层问题一起分析。
这段经历让我把法律知识、问题分析和流程搭建联系起来:不仅处理数据,也参与把评测要求变成能够批量执行、能够复核的工作流程。
和亲爱的实习搭子一起捣鼓黑暗料理
Q:这段经历,怎样帮助你理解案牍在做的 Benchmark?
它让我更清楚地分开看两个问题:
AI 大模型本身的能力边界;
AI产品如何基于模型,帮助法律人完成一项具体工作。
在我接触的大厂评测工作里,重点是把大量任务转成能够统一处理、批量评分的数据,帮助模型团队认识不同场景下的表现,为持续改进模型提供依据——这关注的是通用模型如何不断提升整体能力,法律只是其中一个复杂领域。
而在案牍,我面对的是更加深层的交付要求——对于专业律师团队而言,客户信任是100 分或者 0 分的事儿。而非诉项目往往流程长、步骤多、材料勾稽复杂,前后关联多样——这关注的是「最后一公里」:一个专注非诉的法律 AI 产品,如何能真正协助非诉团队「高效、高质」交付。
所以我充分理解案牍为何在做非诉垂类的 Benchmark——因为专业的法律 AI 产品,不仅要考量AI 大模型的通用能力,还要充分理解业务,理解非诉律师真实工作场景。然后在和现实一样高压、紧张、多材料的项目考验中,充分检查这个法律 AI,是否能「端到端」满足专业律师团队要求。
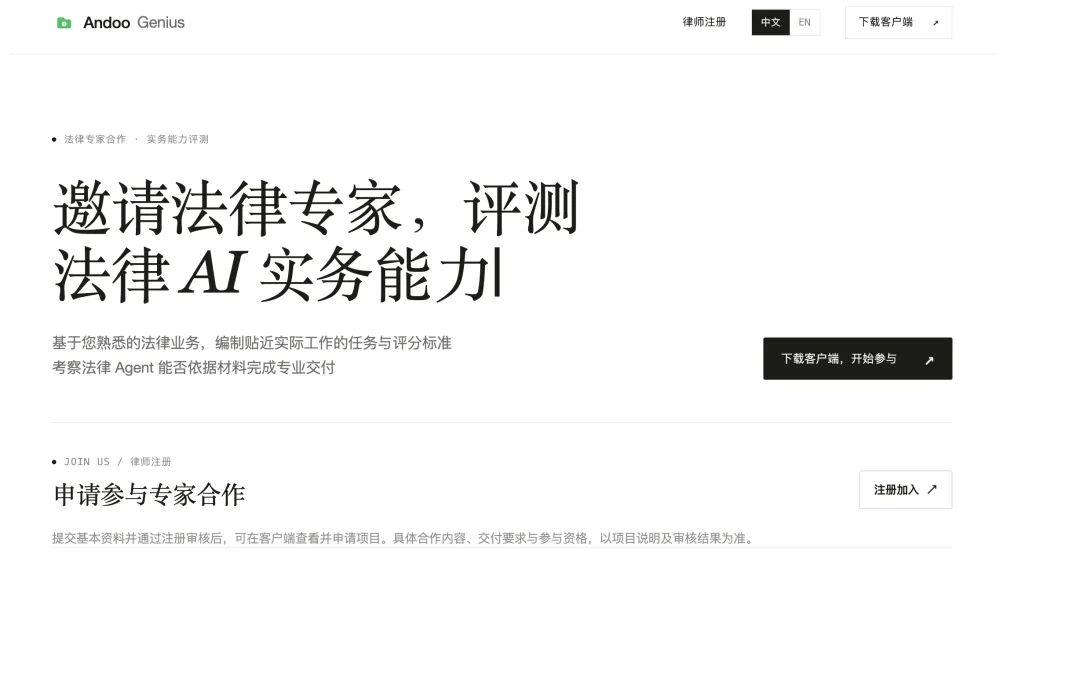
案牍 Benchmark 官网「Andoo Genius」
对我来说,学习这些评测方法的意义,是能带着具体业务问题去理解技术,再把这种理解用来思考产品怎样改进。
Q:如果无法直接提升模型能力,法律 AI 还能怎样做得更好?
大厂会主要围绕基模能力提升进行工作。在案牍我也理解到,在模型能力之外,法律 AI 仍然可以改进产品。
案牍是法律AI 公司——我们在意的,是如何在无法直接调优模型时,根据真实的、垂类的非诉业务痛点,把模型组织进更好的框架,从而「端到端」提升交付效果 。
而案牍在做的Benchmark也会在行业层面的提供独一无二的视角:到底是哪个模型、哪种 AI 产品的框架(Andoo vs Codex vs Claude Code vs Deepseek Harness vs Workbuddy),能够在足够复杂的非诉项目中能拔得头筹?
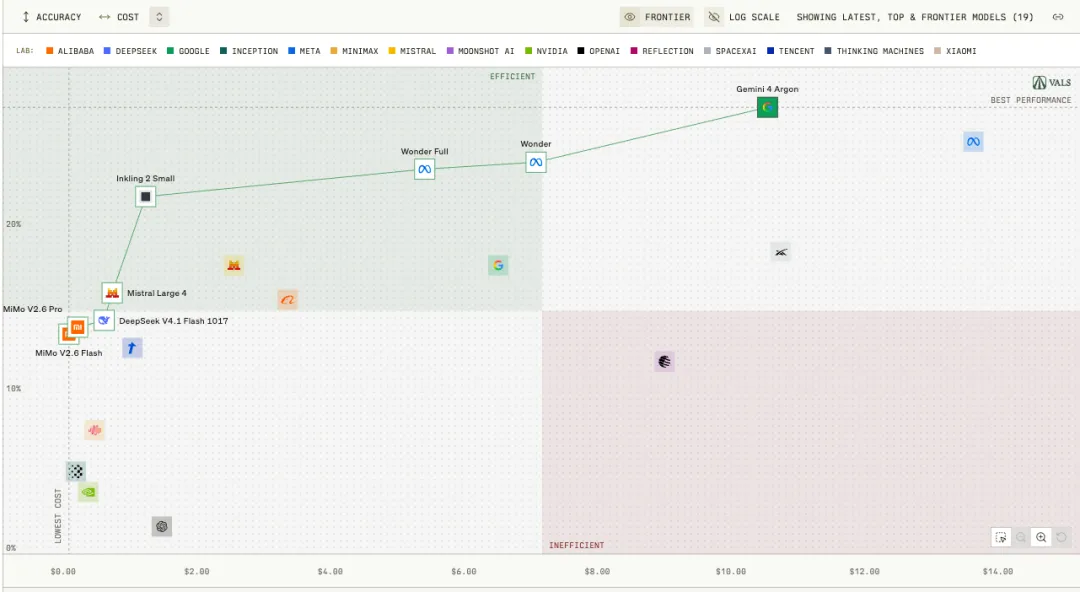
AI 评测机构 Vals AI 基于Harvey LAB开展的评测及榜单
对我来说,法务实习+产品实习的两种工作视角,也正好在这里串起来:法务工作帮助我理解任务要求,产品工作让我思考怎样改进处理方式,而评测则帮助检验这些改进是否真的解决了问题。
Q:这怎样改变了你对自己能做什么的认识?
刚到案牍时,我好奇过:AI 已经这么能干,法学生的价值在哪里?
现在我的答案具体了很多。对我这样的法学生来说,可以先从真实任务入手,认真理解需求、检查结果、发现问题,再参与把这些认识整理成规则和流程。业务理解是在这个过程中积累的,对产品改进的反馈也会变得更具体。
刚开始看着飞书文档,我也会手足无措;后来慢慢能够独立负责项目,还能带新来的实习生,成了「老人」,hhh。
很感谢案牍的小伙伴和老师们,在这个过程中给了我很多帮助和尝试的空间。
实习结束前,我把工作里的具体步骤、指令和注意事项整理成标准操作流程,也就是 SOP,希望下一个接手的伙伴不用从头摸一遍。结尾给自己留了三行字:
干活前先把需求问明白再动手,错误比提问的成本更高(案牍伙伴|姜然:上手做,是法学生对 AI 的祛魅之道,和姜然同学殊途同归hhh)
大胆用 AI 工具搭把手,把法律人从重复劳动里解放出来。
繁忙细碎的工作中也有规律,多一点耐心,多一分细心。
从完成一次任务,到把其中的方法留下来,也是在为下一次做得更好创造条件。
实习搭子+++1
Q:这种习惯,也会延续到学习和生活里吗?
当然!我常用 Codex 完成课程里的编程、搭建网站和评测作业。一边提需求,一边让它解释报错,慢慢也能看懂一些技术问题。
我也会结合笔记工具 Obsidian 搭建法律知识库,或者尝试写小插件,解决上课录音转文字后不好定位对应 PPT 这样的需求。生活里,豆包还会帮我琢磨「这个任务是什么意思」「这句话该怎么回」,对社恐人很有帮助,hhh。
这些尝试都是从具体问题开始:
AI 负责执行,我负责审核。遇到困难,就继续问、继续改。
我也很推荐「组队玩 AI」 —— 比如在清华的计算法学方法课上,同学们会分享自己的需求、工具与遇到的难题。有人研究 AI 记忆,有人分享怎样修改开源项目,也有人交流自己的产品怎样上线、尝试盈利。每个人的经验,都可能帮助另一个人往前走一步。
未来究竟走哪条路,我依然没有完全想清楚。但主动寻找解法、检查结果、把经验留下来的习惯,会继续保留。道阻且长,同袍可渡。
更多相关文章,欢迎查看「案牍伙伴」合集。
北京案牍智能科技有限公司(「案牍」),成立于 2021 年 9 月,总部位于北京,是国内领先的法律 AI 公司,专注于为中国专业法律团队提供 AI 驱动的产品和解决方案。
自 2021 年以来,案牍参与了数百个 IPO 项目,并提供核查自动化服务;2024年,案牍推出的「玛卡 MarkUP」合同全能助手,已服务超过10 万名法律专业用户,以及包括金融机构在内的大型企业。案牍当前股东包括盈动资本、百度战投等,已入选字节跳动火山引擎加速器,与百度达成战略合作,为百度文库等产品提供法律 AI 技术支持。
