先做一件不花钱的事。
打开手机里的豆包,输入一句你客户最常问的话——比如“北京朝阳哪家少儿英语机构靠谱”,或者“两千块的降噪耳机怎么挑”。
看完回答,大部分品牌负责人都要经历同样的三秒钟:先愣一下,再截图,然后问一句“这几个牌子凭什么?”
不是产品不够好,也不是广告投得少。是它们在 AI 的答案里,没有名字。
这样的场面,我们的监测后台每天都在记录。同一个品类被问到一百次,真正露脸的往往只有三五个品牌,其余的一次都没有被提到。
GEO 这个词火了一年,很多品牌还在纠结“要不要做”。更该问的是另一半问题:当 AI 的答案只剩几个位置,你凭什么在里面?
这篇文章不谈概念,只说清三件事:入口到底搬到了哪里、市面上哪些“GEO”是假的、以及一套你现在就能拿去用的判断标准。
01 入口已经搬家:从“翻十页”到“看一段话”
过去找信息是三步:输入关键词、翻链接列表、自己判断。现在是一步:说一句话,AI 直接给答案。
路径变短,对品牌意味着两件事。第一,用户不再路过你的官网、详情页和投放落地页;第二,决定“谁被看到”的,不再是排名,而是 AI 愿不愿意在答案里提你。
用一句人话说清楚:GEO(Generative Engine Optimization,生成式引擎优化),就是让品牌在 AI 的回答里被准确提到、被优先推荐的一套做法。它不是 SEO 的升级版,两者争的东西不一样——SEO 争的是链接的位置,GEO 争的是答案里的名字。
据中国互联网络信息中心《生成式人工智能应用发展报告(2026)》,截至 2026 年上半年,我国生成式人工智能用户规模突破 7 亿,普及率超过 50%。据 QuestMobile 数据,2026 年 9 月豆包月活已达 4.19 亿。
用户在哪里,生意就在哪里。这句话在 PC 时代成立,在移动时代成立,在 AI 时代依然成立——只是“哪里”从搜索框换成了对话框。
更快的变化发生在交易环节。过去一年,几乎每个有电商基因的平台都把 AI 接进了购物链路:
当 AI 能在对话里直接下单,GEO 的目标就不只是“被看到”,而是“被推荐去执行”。这中间隔着一整条链路:AI 得先知道你,才可能推荐你;推荐之后,用户才可能下单。
02 残酷的地方在于:AI 只留3-5个位置
传统搜索时代,排在第十位依然有人往下翻。AI 搜索时代,没有推荐,基本等于不存在。
2026 年 6 月,一篇提交到 arXiv 的论文分析了 10 万多条 AI 回答、覆盖 100 多个品牌,结果是一条清晰的三层阶梯:全球知名品牌出现在 73% 的相关回答里,中端品牌 44%,小众品牌只有 11%。
换成人话:品牌层级每降一级,AI 可见度掉 30 个百分点。你的竞争对手从几百个变成了两三个,但输掉的代价是 0——AI 根本不提你。
消费者这边其实已经先动了。中国青年报社社会调查中心 2026 年 10 月对 1000 人的调查显示,今年双 11 有 66.7% 的受访者会用 AI 辅助购物,其中 27.3% 深度参与决策;比价、算满减、凑单,是他们最常交给 AI 做的事。
用户已经在用 AI 做决定了。品牌还在讨论“要不要做”,这就是差距的来源。
03 GEO 没有门槛,但有对错
GEO 火了,一堆公司跳出来说能做。把交付物摊开看,大部分方案过不了四个问题。
错误一:调 API 模拟提问,也敢叫“品牌监测”?
API 返回的结果,和用户在自己手机上看到的回答,不是一回事:推荐卡片、引用来源、排序方式、口语化程度都不一样。测的不是用户看到的那个答案,后面的结论就没有意义。
错误二:只给一个汇总数字,原始证据在哪里?
“提及率提升 5%”“好感度 82 分”——哪几个问题?哪个平台?AI 原话怎么说?引用了哪篇文章?这四件事说不清,数字就只是数字。
错误三:只监测不优化,报告交完就结束
知道问题在哪,然后呢?AI 偏好什么结构的内容?该往哪发?发完有没有变化?没有闭环,监测就变成一份定期账单。
错误四:只盯一个平台,等于盲人摸象
用户不是只用一个 AI。在豆包里排第一,在 DeepSeek 里可能一次都没出现。
04 我们的 GEO 策略:把标准公开,接受检验
做 GEO 的公司不少,愿意把方法公开的很少。原因不难猜:标准一旦写明白,就等于把自己交给客户逐条检验。
我们的 GEO 策略不复杂,四步,每一步都能被外部验证:
只采用户真实看到的回答:手机端 RPA 采集 App 内的实际回答,不采接口返回值。
每个结论都留证据:看板指标、Query 明细、原始对话、引用信源,一层层能点开。
监测之后一定动内容:信源建模、内容生产、发布、引用追踪,走完整条链路才算交付。
五个平台一起看:豆包、DeepSeek、腾讯元宝、通义千问、Kimi,同一套问题同时问。
这四条策略的验收方式,我们索性交给客户。原本是内部清单,现在变成公开的四个问题:“你们测的是真实 C 端回答,还是 API 返回的?”“看板上的数字,我能不能点开看到原始对话?”“发现问题之后,内容生产和发布你们管到哪一步?”“覆盖几个平台,能不能按平台拆开看?”
公开还意味着三件事已经被我们接受:数据口径必须写清楚,方法必须讲得明白,做不到的事不承诺——我们不会说“保证被推荐”,只会说“每一条都可核对”。
05 这些策略,落在同一套系统里
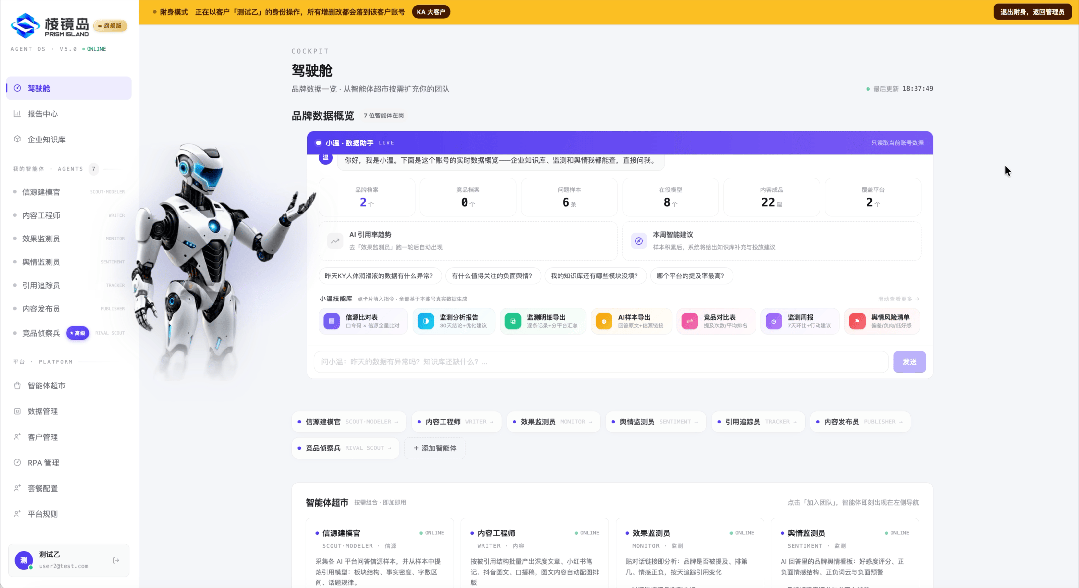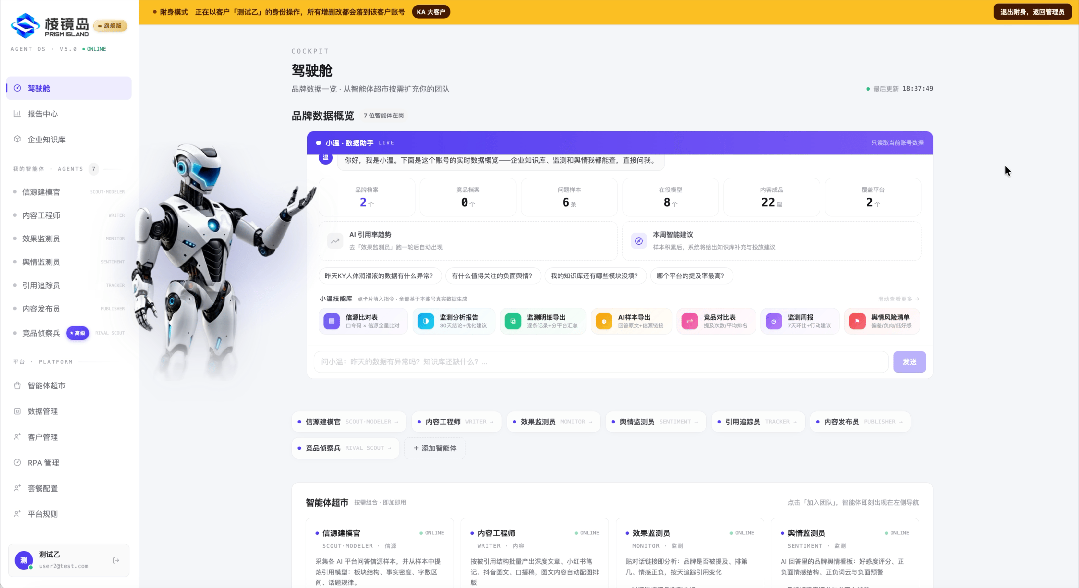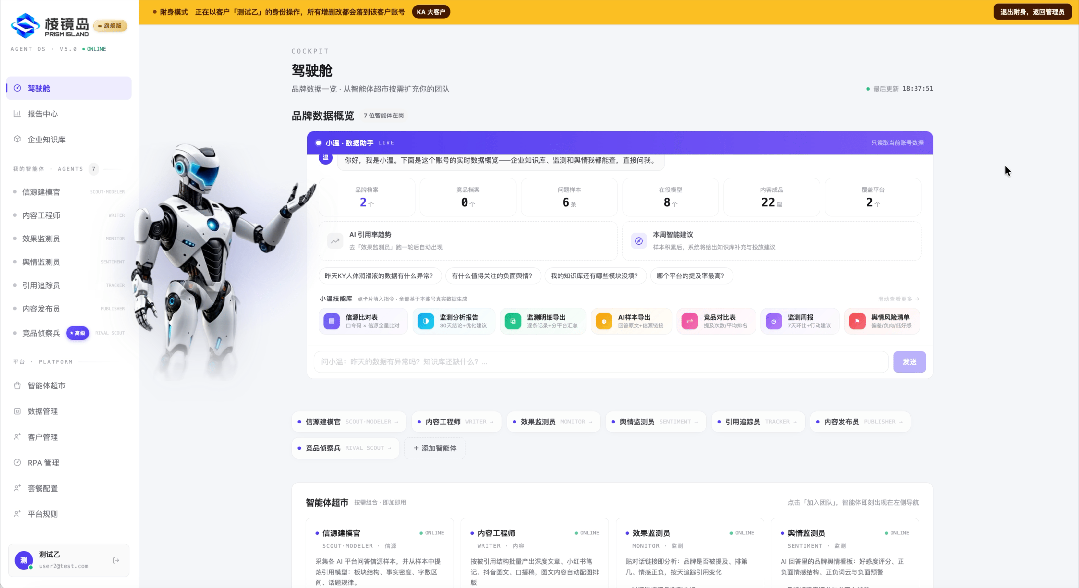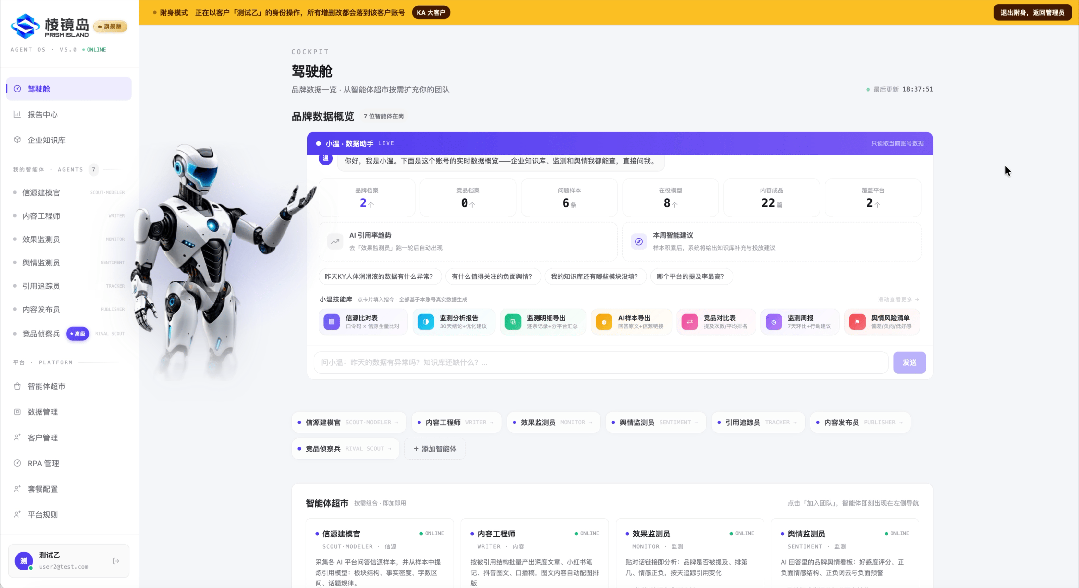
阅客「棱镜岛」不是一个负责“报数字”的工具,而是一支替品牌盯住 AI 答案的团队。四条策略对应的,是四个能直接上手的能力。
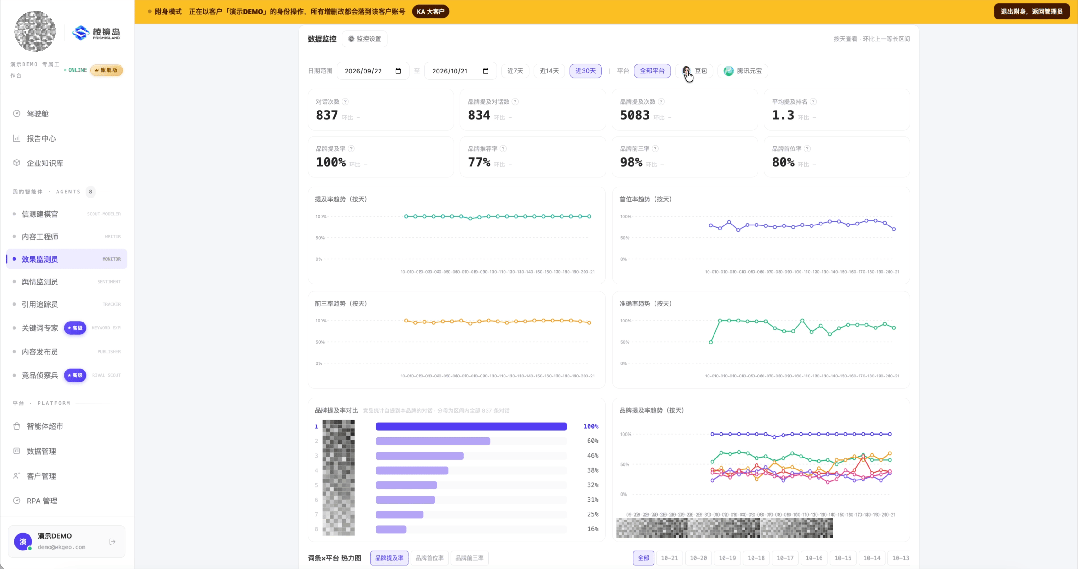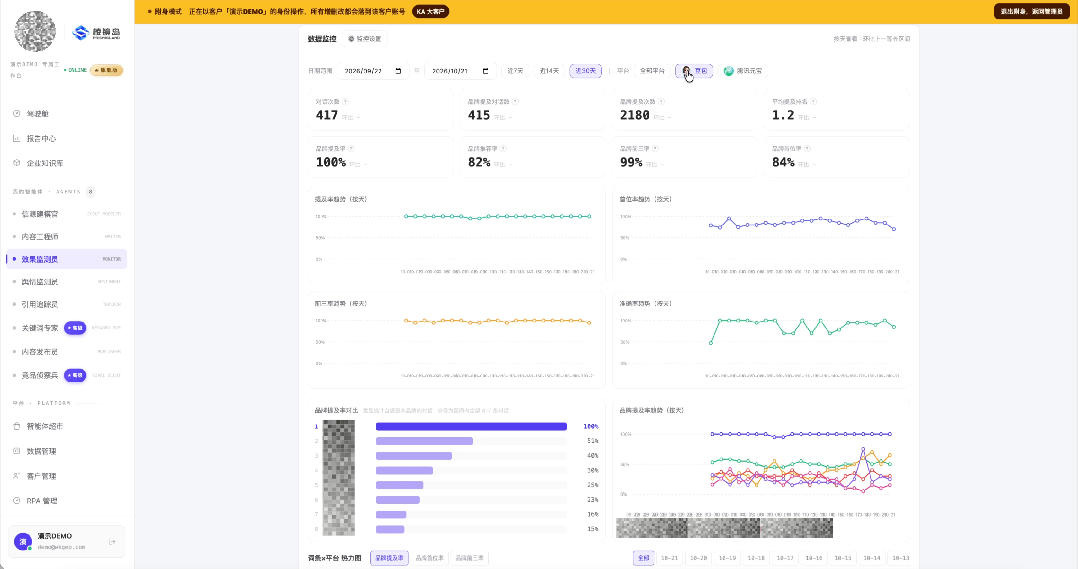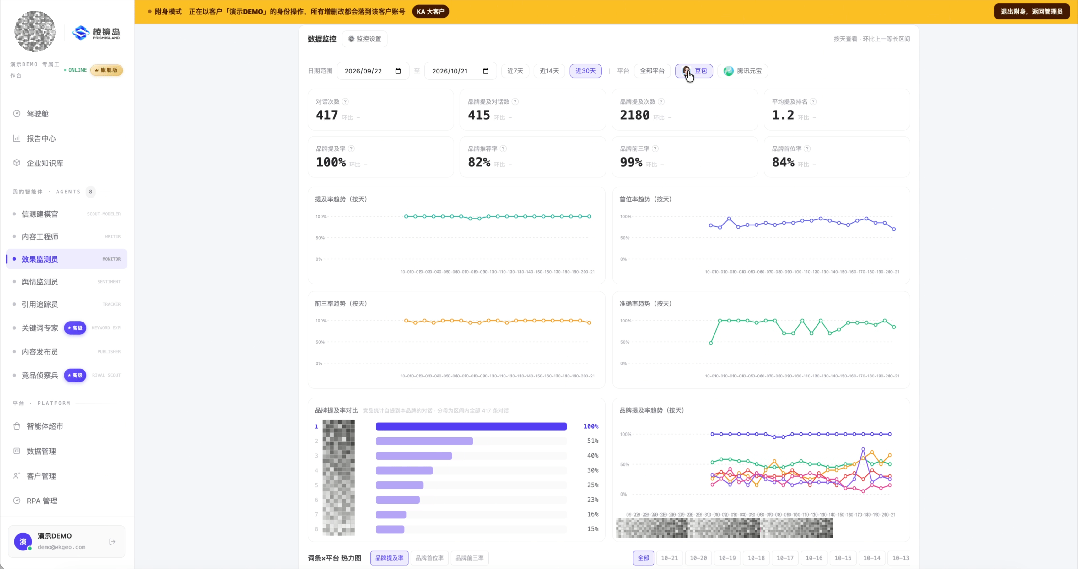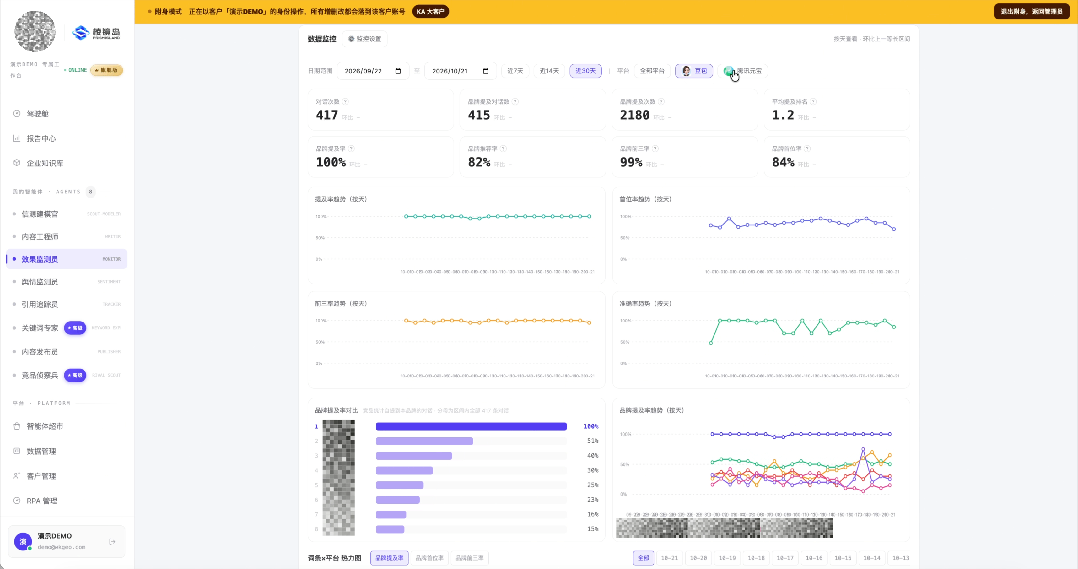
先看全貌:打开驾驶舱,第一屏不是漂亮的增长曲线,而是几个必须先回答的问题——品牌被提到几次、在哪些问题里被提到、推荐顺位排第几、哪些平台的答案是空的。
真实 C 端采样。手机端 RPA 自动采集用户在 App 里实际看到的回答,4 个平台全自动——自动提问、等待回答、生成分享链接、自动回收。不是调接口,是模拟一个真实的人去问。采回来的回答还要被拆开看:AI 引用了哪些站点、哪些内容结构、多长的篇幅,这些才是后续优化真正的依据。
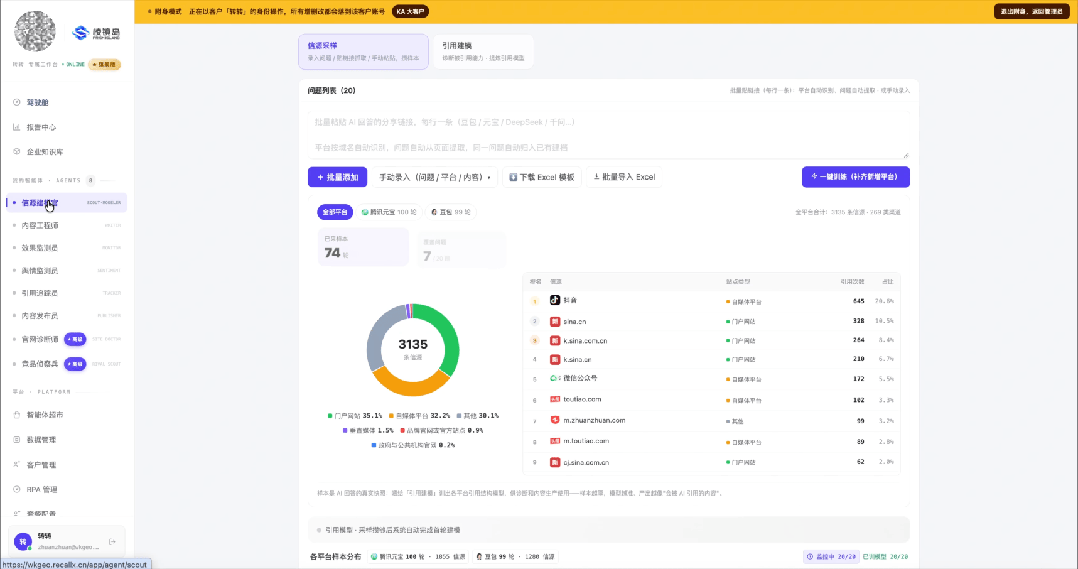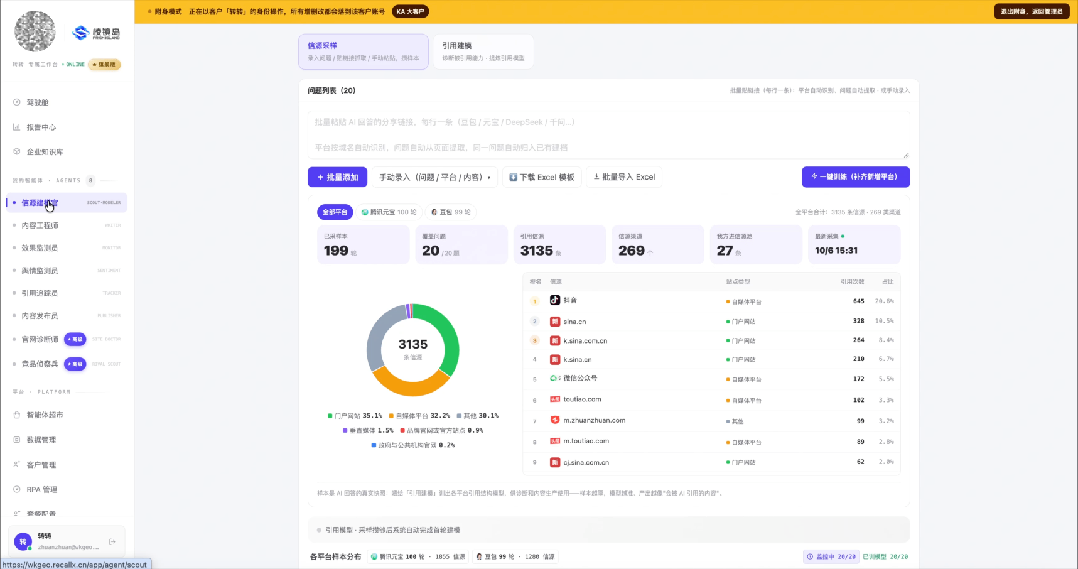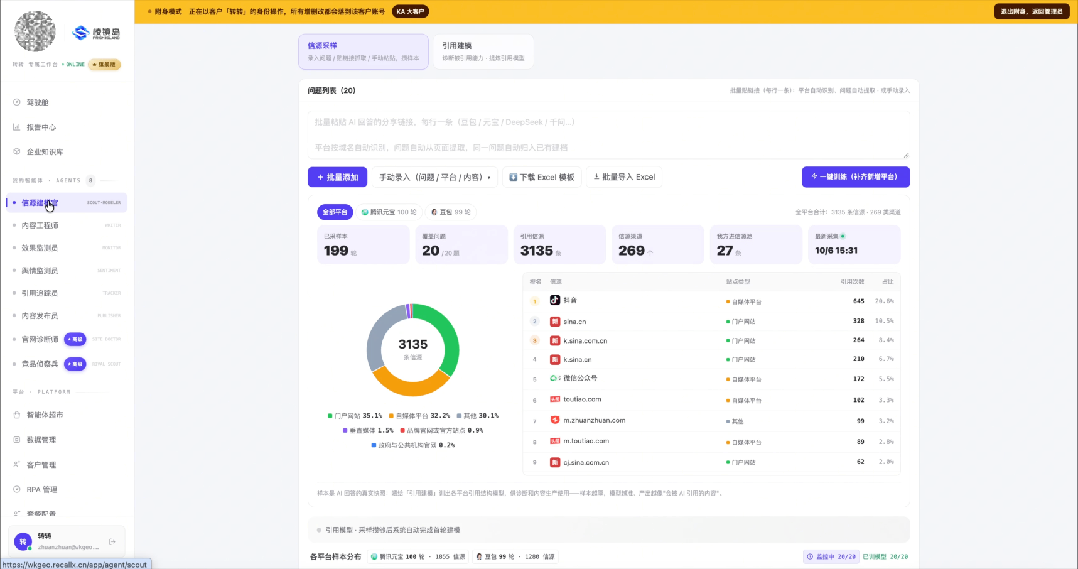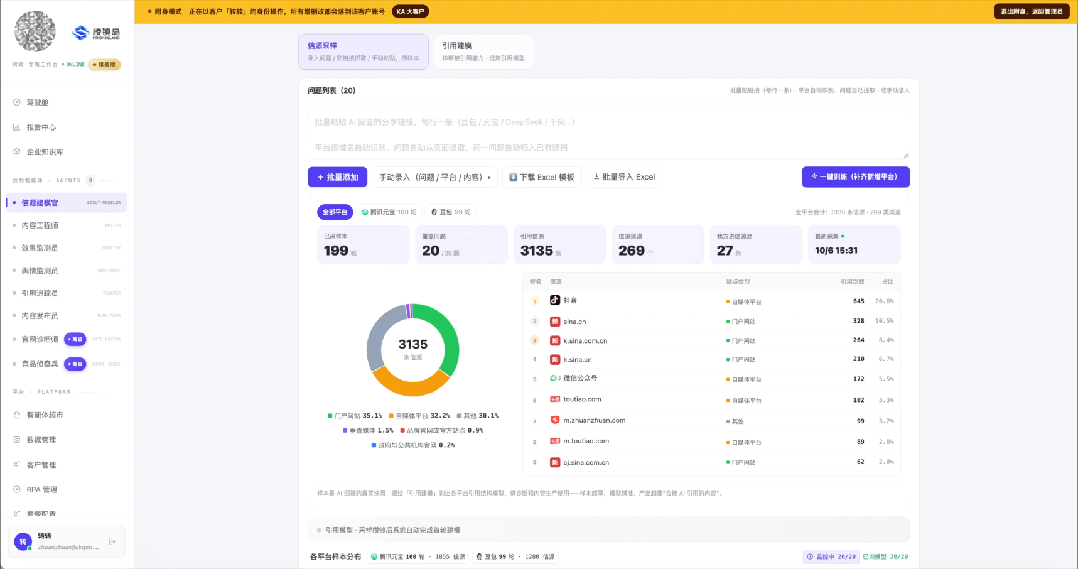
Query 级证据链。每条监测记录都带原始对话链接和结构化引用信源。看板上的任何数字都能点开,看到 AI 的原话、它引用的文章和发布时间,而不是一个无法追溯的百分比。
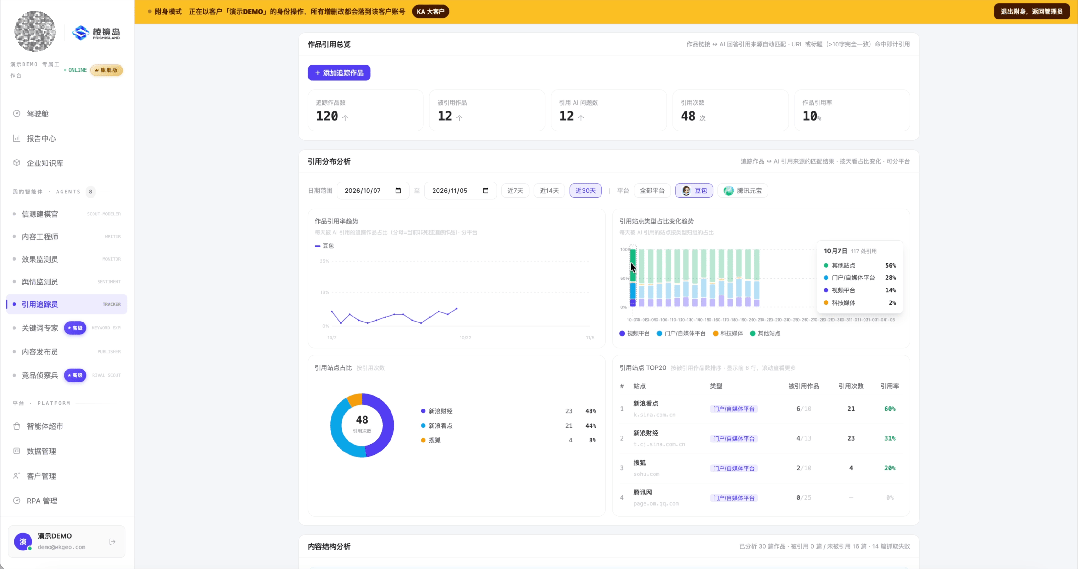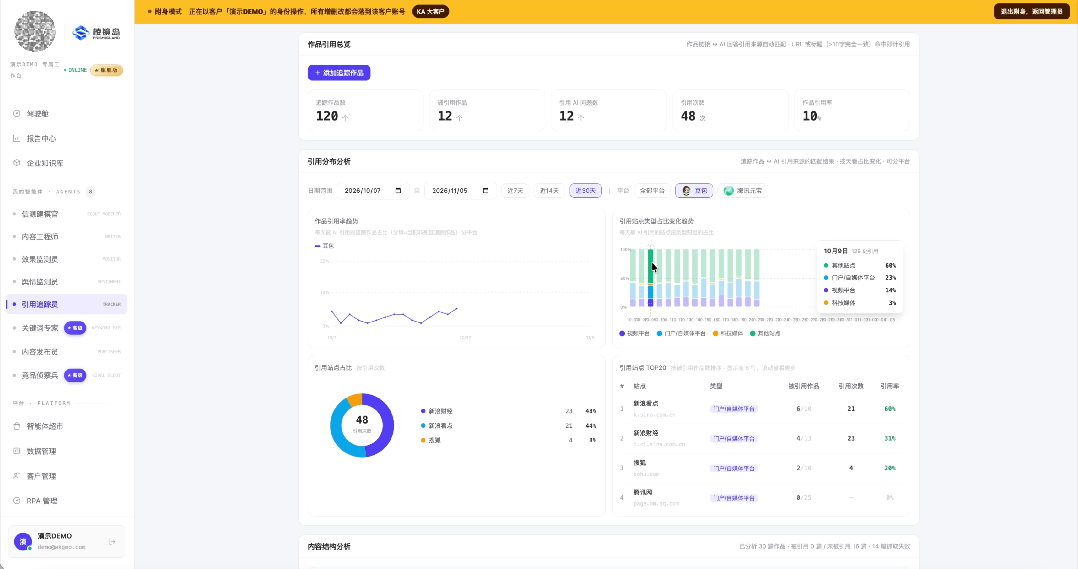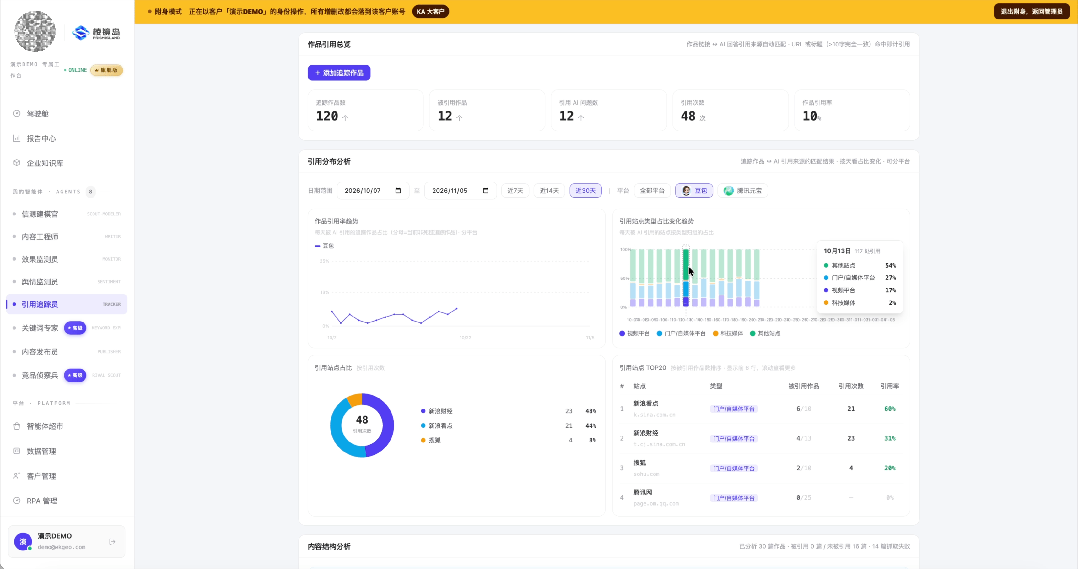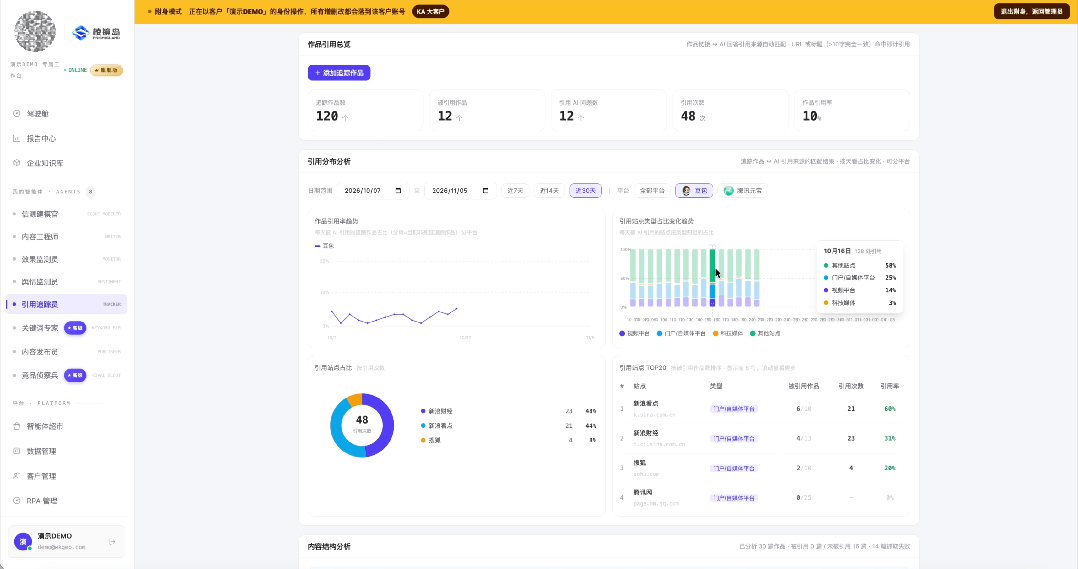
全链路闭环。信源建模、内容生产、内容发布、引用追踪,一个系统跑完。发现问题只是第一步,把问题改掉才是目的。
5大平台统一看板。豆包、DeepSeek、腾讯元宝、通义千问、Kimi,一张表对比品牌在哪个平台强、哪个平台弱,也能看出同一条问题在不同平台上的答案差多远。
06这不是演示数据,是每天在跑的生产记录
截至 2026 年 10 月 29 日,棱镜岛生产环境里跑着的真实数据:
369152 条 Query 级监测记录
4540 个真实用户问题
80+ 品牌客户在用
100% 记录带原始对话链接
86% 记录带结构化引用信源
判断一个 GEO 平台靠不靠谱,有个很土但有效的办法:看它敢不敢把自己的数据摊开。我们摊开了。
AI不会等你准备好,它已经在替你的客户做选择了。
现在就去搜一下你的品牌,看看AI怎么说你。如果答案不理想,别等了。
联系我们,让AI“爱上你”
联系合作