自媒体助手谁更强?六维对比评测豆包、千问和DeepSeek
- 更新时间 2026-11-06 15:24:52
写文章先选题,选题做对比,做自媒体的人总想知道哪款AI更顺手……
从目前主流的国产大模型来看,我主要推荐豆包、千问和DeepSeek三款。
豆包是字节跳动的,依托抖音、剪映、即梦这一整套内容生态,在内容的新颖度强。口语化表达、网感、短视频脚本,几乎是它的主场;图片、海报、短视频也能一站式生成,普通用户上手零门槛。有第三方统计称,豆包去重用户10.29亿,月活达3.82亿,居国内AI应用首位。
短板也清楚:超长专业报告的细节容易疏漏,深度推理不是它的强项。
千问是阿里出品,表达严谨规范,长文本、联网检索、文档与表格处理都没的说,还深度打通了钉钉、夸克、PPT、电商详情页这些办公场景;通义万相负责生图,中文文字渲染尤其稳。Qwen开源生态的开发者活跃度也一直居前。缺点嘛,略显生硬,灵活性与「氛围感」稍弱。
DeepSeek是深度求索出品。逻辑推理和代码能力在国内属于第一梯队,深度思考模式会把每一步推导摆给你看,理工科风格,开源加极致性价比。
缺点同样直白:多模态弱,没有原生图像生成,生活化文案缺少氛围感,纯文字活儿找它准没错。
Deepseek作为国内最热门的大模型之一,用户量和用户活跃也是相当可观的,最近还因为使用量过大崩了好几次。
三家放在一起,很多人会觉得除了界面颜色不同,能干的事大同小异。
在相同点上:
首先,三家都能联网检索、都支持长文本输入、基础功能都免费。
其次,都能写中文、都能模仿指定文风、都能反复改稿,写出来的东西乍一看都挺像样。
第三,都在从「对话框」往「能调用工具的智能体」上走。
在不同点上,差别就藏在「一篇稿子从0到发布」的六个环节里。
01 评测怎么做
评测AI最容易掉进的坑,是急着给一个总分排名。这次我刻意不打分、不排总榜。
原因有两个:
一是版本跑得太快。中国经济网2026年9月9日报道,国产大模型的迭代节奏已经从半年压缩到一两个月,「智能密度」正在取代参数规模成为新的竞争标尺。今天的第一名,下个月可能就换了版本号。
二是口径不统一。不同第三方横评里,Qwen有3.5/3.6/3.7/3.8多种写法,豆包有Seed 2.1、大模型2.0、Seedream 5.0等不同指向,DeepSeek也有V4、V4-Pro之别;上下文窗口、定价、能力梯队的说法互相打架。在这种情况下给「总排名」,既不严谨,也会迅速过期。
统一命题(读者可自行复现)
依据来自三类公开信息:IDC 2026年1—2月多模态大模型实测(测试截至2月28日,对象为公开网页版产品)、中国经济网2026年3月3日与9月9日两篇行业报道、以及2026年多家第三方横评中反复出现的跨来源共识。本文结论是「场景适配建议」,不是本刊实验室统一实测的跑分结果——这一点必须说明白。
02 六个维度,一个个拆
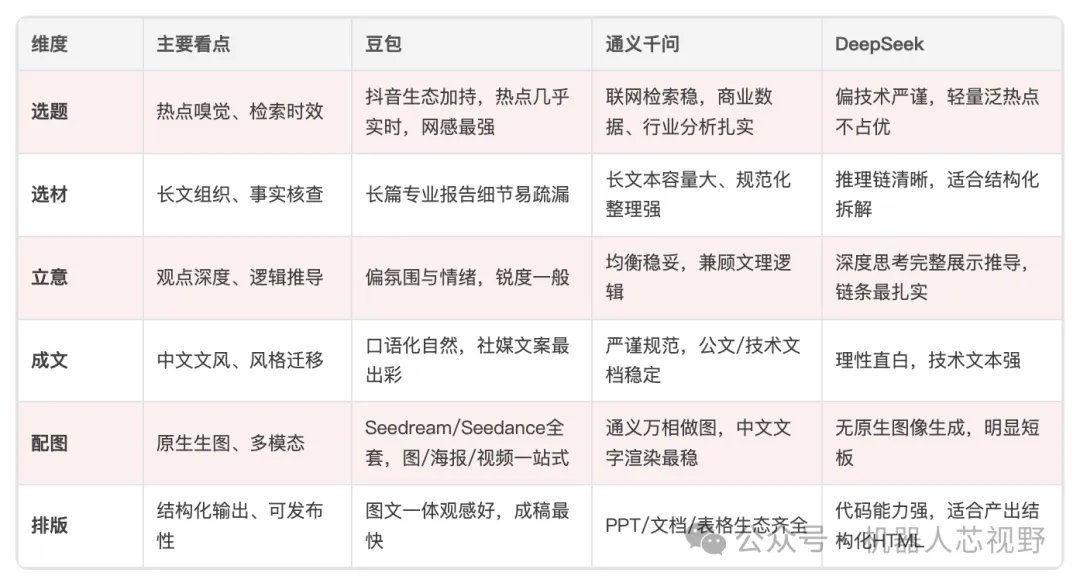
关于「配图」,有一份相对硬的依据值得单独说。
IDC在2026年1—2月对国内主流多模态大模型公开网页版产品做了实测,测试截至2月28日,从指令遵循与幻觉、逻辑性、鲁棒性、质感细节、生成时间与稳定性、内容安全性等维度综合打分。结论是:
图像生成类:字节豆包Seedream 5.0、腾讯元宝Hunyuan Image 3.0、阿里万相2.6位居前列; 图像理解类:豆包大模型2.0、阿里千问3.5、阶跃星辰Step3表现亮眼; 视频生成类:即梦AI Seedance 2.0、快手可灵2.6、生数Vidu Q3为行业标杆。
翻译成自媒体语言:配图这一环,豆包和千问是「能自己干完」的,DeepSeek得另找工具。这不是文笔问题,是产品形态问题。
关于「排版」,有个坑只有真发过公众号才知道。
公众号编辑器会剥离 标签和 class,所以能直接粘贴发布的排版,必须是全行内样式(inline style)的HTML。这一步考的不是文采,是代码与结构化输出的稳定性——恰恰是推理/代码见长的模型的机会。
把六个维度摆开后会发现一件有意思的事:三家没有一家是六项全优,但也没有一家是可有可无。差距不在「谁更聪明」,而在谁离「点发布」更近。
03 从这三款,看大模型接下来往哪走
六个维度的分化,其实是整个行业走势的缩影。有三条线比较清楚。
第一条:从「堆参数」转向「拼智能密度与推理成本」。
中国经济网报道,智谱GLM-5.3在基座不变的情况下,仅靠后训练就实现编程能力五成提升;腾讯混元Hy4让模型参与自身训练方法与数据策略的自动优化,推理吞吐提升超三成。
国家数据局数据显示,2026年6月我国日均词元调用量已增至近175万亿;OpenRouter上开源模型处理的词元占比,从1月的34%升到6月的65%。同期Qwen3.8-Flash把价格压到1元/百万词元。
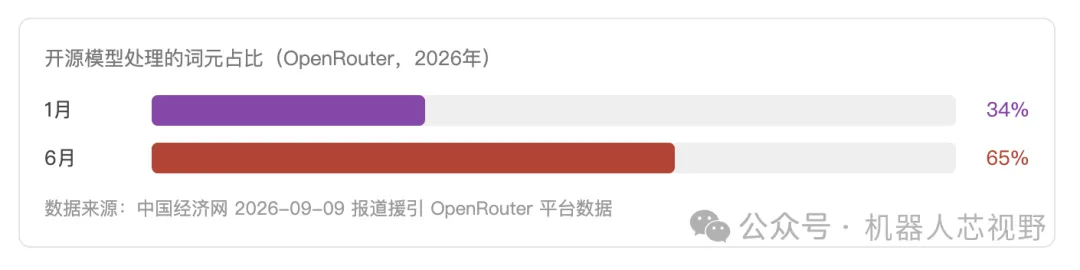
「九成能力、一成价格」——模型正在从展品变成水电。
第二条:从「比模型」转向「比模型+工具+生态」。
赛智产业研究院人工智能研究所所长安赟判断:企业不再盲目追求大参数,而是「够用就好」;竞争焦点从单一文本对话,升级为多模态理解生成与长程任务执行。
华西证券研报也提到,字节凭内容创作与流量生态领跑,阿里依托办事能力与全域生态突围,DeepSeek则以开源与成本优势补位。
第三条:多模态与端侧,正在把「发布链路」整个吞下去。
公开数据显示,2026年除夕豆包AI互动总数达19亿次,Seedance 2.0为央视春晚「AI生成影像+实景舞台扩展」提供了技术支撑。IDC的实测也显示,国产多模态已从「能用」走到「能进生产流程」。
把这三条合起来看,模型之间的差异正在换一种写法:过去比谁答得漂亮,现在比谁能把检索、生图、代码块、分发生态串成一条不换手的流水线。选题靠检索、配图靠生图、排版靠代码、分发靠生态——单点跑分不再直接等于生产力。
这也顺带回答了标题里那个问题:「谁更强」这个问法本身,正在失效。三家都在补短板(豆包补推理、千问补开源生态、DeepSeek补多模态),能力在收敛,差异从「能不能」变成「顺不顺手」。
写在最后
把六个环节重新排一遍,我用法是这样的:
选题和配图交给豆包——热点快、图能自己出;资料整理和规范化表述交给千问——文献、财报、表格稳;立意推敲和排版代码交给DeepSeek——逻辑链清楚、结构化输出可靠。
这三款都是比较优秀的AI工具,我个人不是选一个,是三家混着用。你也可以三个都打开,用同一道题各跑一遍,按自己账号的类型(是追热点的、做深度的、还是做干货的)配出自己的组合。
别把「选哪个AI」当成一次站队。模型一个月一更,你的选题标准和读者画像才是那个不变的东西。
不仅是写公众号,等你今后做短视频、做行业报告、做课程讲义,用这个「按环节分工」的套路,基本上也就完全可以搞定了。
你的自媒体流水线是怎么搭的?欢迎留言聊聊~
