【评测可信度】新突破!乔治梅森联合Palo Alto推出BenchChecker,AUC约0.9揭穿基准污染
- 更新时间 2026-11-05 10:52:16
【评测可信度】新突破!乔治梅森联合Palo Alto推出BenchChecker,AUC约0.9揭穿基准污染
大模型在修 bug 榜单上刷出的高分,有一部分是「考前看过答案」。
论文:BenchChecker: Assessing the Credibility of Bug-Fixing Benchmarks for LLMs
机构:乔治梅森大学、Palo Alto Networks
会议:USENIX Security 2026(已发表)
论文:https://arxiv.org/abs/2610.19447
榜单上的 70% 通过率,有多少是背出来的
自动程序修复(APR)是 LLM 最被看好的落地方向之一,SWE-bench Verified、Multi-SWE-bench 这类榜单也成了各家模型的能力展示墙。但评测界一直悬着一件事:训练集里可能已经包含了测试样本。数据集构建者为了让语料新鲜,倾向于收集接近模型截止日期的仓库快照;而那些早已合并、一直留在仓库里的补丁,就被顺理成章地「顺走」了。
BenchChecker 先把污染的规模量化出来:在六个常用 bug 修复基准上,仓库出现在 The Stack v2 训练集里的比例是 85.2% 到 100.0%,而补丁本身出现在训练集里的比例是 62.4% 到 78.9%。这不是边缘案例。
更刺眼的数字在后面。用 BenchChecker 把污染样本剔掉之后,SWE-bench Verified 与 Multi-SWE-bench 上排名前十的提交,中等难度子集的解题率相对下降超过 20%,Multi-SWE-bench 上最高降幅达到 55.9%。
为什么此前查不出来:相似度既有假阳性也有假阴性
最直觉的办法是:把 bug 样本喂给模型,看它生成的补丁和标准补丁像不像。这条路走得不通。模型完全可以靠上下文(比如 issue 描述)推理出相似的补丁,于是把泛化误判成记忆,产生假阳性;反过来,模型也可能记住了修复逻辑,但输出一个等价却写法不同的补丁,产生假阴性。在越来越流行的智能体式修复系统里,长交互轨迹还会大幅改写最终 diff,「像不像」这个判断就更站不住了。
另一条路是基于 logit 的成员推断。这条路有理论支撑,但黑盒模型只给文本输出,拿不到 logit,直接失效。
作者换了一套取证(forensics)思路:不去问模型「你记不记得」,而是从公开的外部证据里推断。核心观察是——污染样本必须同时满足两个必要条件:
1. 该仓库出现在模型的训练集里;
2. 该补丁在模型截止日期之前就已合并并持续存在。
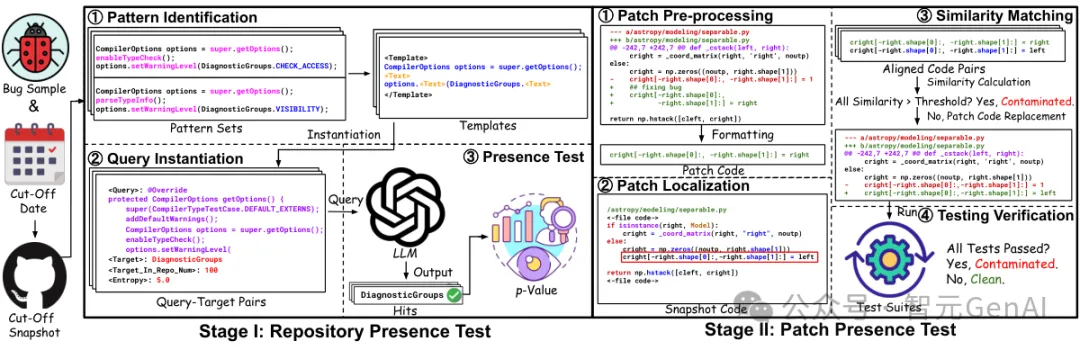
于是原本一个大问题被拆成两个都可操作的子问题:仓库存在性检验,判断仓库是否在训练集里;补丁存在性检验,验证补丁在截止日期之前是否一直留在仓库中。这条路线只需要三样东西:基准的元数据、开源代码历史、模型的截止日期。三者都是公开或可估的,不需要模型权重,也不需要 logit。
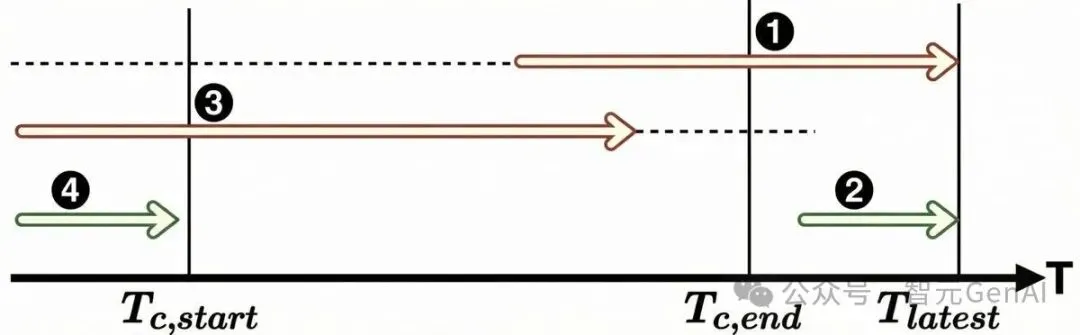
为了让能力边界可描述,作者按补丁生命周期与训练快照采集区间的重叠情况,把样本分成四类。记采集区间为 [ T_{c,start} , T_{c,end} ],T_latest 是截止快照的时间戳,T_{p,intro} 是补丁引入时间,T_{p,persist} 是它在截止前最后存在的时间戳。当补丁的生命周期与采集区间重叠时,样本才算真值污染。这套划分的好处是给「检不出来的那一类」也留了名字,而不是含糊过去。
方法(一):用代码前缀问出仓库在不在
第一阶段的仓库存在性检验绕开了一个陷阱:不去问「你训练时见过这个仓库吗」——模型对自己的训练集没有可靠的自我报告。改成让它续写代码。给它一段来自该仓库的代码前缀,看它补出来的内容是否与该仓库的真实代码高度一致。能续得上,说明这段代码大概率在训练分布里。这个思路把「模型内省」换成「行为取证」,对黑盒模型同样适用。
第二阶段有个效率上的取舍值得单说。理论上要确认「补丁在截止前一直存在」,得把补丁引入到截止日期之间的每一次提交都查一遍。作者没有这么做,而是只验证截止日期前最后一个快照里补丁是否存在。这个简化建立在一个经验观察上:补丁被移除后又被重新引入,是极罕见的边缘情况。所以只要在截止快照里看到它,就可以强力推断它自引入以来一直存在。这是一处典型的设计取舍——用一个小小的假设,把繁琐的历史追踪换成一次快照查询。
方法(二):相似度对齐加测试套件双重验证
第二阶段的补丁存在性检验涉及两个可自动判定的手段,合起来构成证据链。
一个是相似度对齐。把基准里的目标补丁与截止快照中的代码做比对,用一个相似度阈值 θ 来判定:
m.similarity > θ
阈值的选择直接决定 TPR 与 FPR 的平衡。作者专门做了不同相似度阈值下的 AUC 曲线来分析这个权衡,而不是拍一个数就完事。
另一个是测试套件验证。相似度只能说明「代码长得像」,测试套件能说明「行为确实修好了」。两者结合,就把「长得很像但其实是另一处改动」和「写法不同但其实是同一个修复」这两类边界情况分别拦住。
两个子问题合到一个判定上,输出的是该样本是否为污染样本。整个流程只需要模型的文本输出与公开的仓库历史——这一点在工程上很关键:它对闭源模型同样可用,而基于 logit 的方法在闭源模型上直接失效。
作者还交代了假设的可行性:基准元数据与开源代码历史是公开的,模型截止日期通常会被披露,或者可以从发布日期估算。也就是说,这套方法不依赖任何「只有内部人才能拿到」的信息,任何人拿公开数据都能复现一遍。
实验:六个基准、三个模型,AUC 稳定在 0.9 附近
实验环境是 Linux 服务器,AMD EPYC 7742 64 核、500 GB 内存、4 张 A100-80G。评测用 AUC、TPR 与 FPR 三个指标,与既有工作保持一致。模型选 StarCoder-15B、StarCoder2-15B、CodeGen2-16B,三者都在 The Stack v2 上训练过。基准是 SWE-bench Verified、BugsInPy、BugSwarm、Multi-SWE-bench、Defects4J、GrowingBugs 六个。
补丁存在性检验(第二阶段)的结果最直观。BenchChecker 在 SWE-bench Verified、BugsInPy、Multi-SWE-bench 上 AUC 超过 0.9,在全部六个基准 × 三个模型的组合上 AUC 都在 0.863 到 0.938 之间,TPR 0.777 到 0.979,FPR 在 0.051 到 0.115 之间。作为对照,LOSS、Zlib、Min-K%、Ref 这四个基线AUC 普遍在 0.5 附近,也就是接近随机猜测。在完整评测中,BenchChecker 的 FPR 保持在 0.1 及以下。
仓库存在性检验(第一阶段)几乎打满。在 SWE-bench Verified 与 Multi-SWE-bench 上,AUC 与 TPR 都逼近 1.0(0.999 到 1.000),三类模型全部如此。这两个基准里绝大多数仓库本来就在 The Stack v2 中,负样本太少,作者按 Multi-SWE-bench 的标准补充了负样本集:选取 2023 年 9 月之后创建、至少 500 star、并且自带自动化测试配置的 100 个仓库,为 Python 与 Java 两组基准各补一份。Stage I 的假阳性有 90.3% 来自截止日期之后仓库中的代码复用——这些仓库虽然被标为「不在训练集里」,但其中大量片段是从截止前的训练仓库里复制过来的。这恰好说明假阳性的根因是数据本身的复用现象,而不是检验方法失效。
Java 基准上的回落也在论文里被诚实指出。Defects4J 与 GrowingBugs 的 AUC 相对低一些,原因是 Java 生态里代码复用更普遍,导致漏检增加、TPR 下降。这不是方法在某类语言上失灵,而是同一套取证逻辑碰上更严重的复用噪声。
影响分析:难度越高,污染的贡献越大
BenchChecker 真正有冲击力的部分,是把它当作过滤器用之后的数字。作者拿到 SWE-bench Verified 与 Multi-SWE-bench 前十名提交的解题率,对比过滤前后的变化,得到三条结论。
1. 污染的贡献随难度上升。SWE-bench Verified 上,前十名在 1-4 小时子集的相对降幅全部超过 20%,而在 15 分钟以内与 15-60 分钟子集上降幅都低于 10%。Multi-SWE-bench 上,中等难度子集的平均相对降幅约 40%,简单子集约 20%。解读很直接:简单 bug 上的成功更多体现泛化能力,而随着难度上升,模型越来越依赖记忆;
2. 不同基准受影响的程度差异很大。前十名提交的整体解题率在 Multi-SWE-bench 上最高下降 55.9%,而在 SWE-bench Verified 上最高只有 11.8%。原因是 Multi-SWE-bench 的样本本身更难解,且它的提交还没用上 Claude-4、GPT-5 这类更新的模型家族;
3. 同一底座模型、不同智能体框架,受影响程度接近。SWE-bench Verified 前十名里有 7 个使用 Claude-4 系列模型,整体相对降幅在 8% 到 11% 之间。这条结论说明污染的贡献主要来自训练数据与基准的重叠,而不是某个智能体框架的工程技巧。
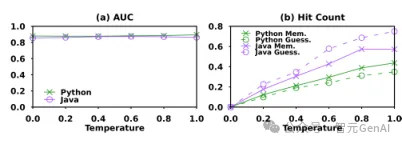
作者还检查了解码温度的影响:温度升高时模型的命中数会下降,但AUC 保持稳定,说明这套检测器不依赖特定的采样参数。这也让它在实际使用时不必为每类模型重新校准。
为什么有效:把不可观测的记忆换成可观测的仓库历史
BenchChecker 有效的原因可以归成一句:它把「模型记不记得」这个不可观测的问题,换成了「仓库里有没有」这个可观测的问题。
• 两阶段必要条件给判定划了一条清晰的线:仓库不在训练集里,或者补丁在截止前已被移除,就不算污染。这条边界避免了「相似度像就算污染」的粗暴判断;
• 只查截止快照用一个小假设换来了可执行的效率,把「追踪每一次提交」压成「查一次快照」。作者明确说这个简化来自「补丁移除后重新引入极罕见」的经验证据,属于有依据的取舍;
• 相似度加测试验证的双证据分别覆盖了「像但不是」和「是但不像」两类边界,这也是它 FPR 能压到 0.1 以下的原因;
• 只用文本输出加公开历史让它天然适配闭源模型,这一点决定了它能不能被榜单维护者真正用起来。
对照基线的差距也说明了路线的选择有多重要。LOSS、Zlib、Min-K% 这些方法是在模型内部信号上做文章,黑盒场景下拿不到足够的信息,AUC 就停在 0.5 附近;而 BenchChecker 走的是外部证据,反而把 AUC 拉到了 0.9 以上。
局限与总结
作者把边界写在明处。方法依赖「补丁一旦合并就长期存在」这个经验假设,虽然作者论证了「移除后再引入」极罕见,但真出现时会导致误判;Java 生态的代码复用更普遍,Defects4J 与 GrowingBugs 上的 TPR 因此偏低,AUC 落到 0.863 与 0.879;方法需要基准元数据、公开代码历史与模型截止日期三样信息,对完全未公开截止日期的模型只能做估算;此外,两阶段检验只能识别满足两个必要条件的污染样本,对于「补丁已从仓库移除但训练语料仍留有旧快照」这类情形不在覆盖范围内。
一句话总结 BenchChecker:想证明榜单分数是不是「考前看过答案」,与其追问模型的记忆,不如去查公开的仓库历史——当两阶段取证把 AUC 拉到 0.9 以上,那些被剔掉污染样本后下降超过 20% 的中等难度分数,才是模型真实的能力刻度。
更多更全的Arxiv论文、直播、求职信息,关注[大模型技术]知识星球
点击小程序链接加入:大模型技术知识星球
欢迎关注我们的公众号【大模型技术】,每日AI相关新闻推送、arxiv论文分享
