选型会上最常被问的问题,不是"哪个模型强",而是"该拿哪个数据集验它"。答的人往往随手甩一个最出名的名字,听的人如获至宝,回去跑了个不错的分数,皆大欢喜。三个月后产线上翻车,回头一查,翻车的原因和模型无关——是那张卷子,从一开始就没考你要考的东西。
结论先说:公开数据集是地图,不是地皮本身。每张地图都只画了它想画的地方:分布单一、条件可控、缺陷类型可枚举。地图没有错,错的是拿地铁线路图去导航盘山公路。这一篇就把公开基准当"地图"来讲:每张图各画了哪块地、图例怎么读、以及怎么判断你的产线到底在不在图上。
一、先划两条轴:你到底在验什么
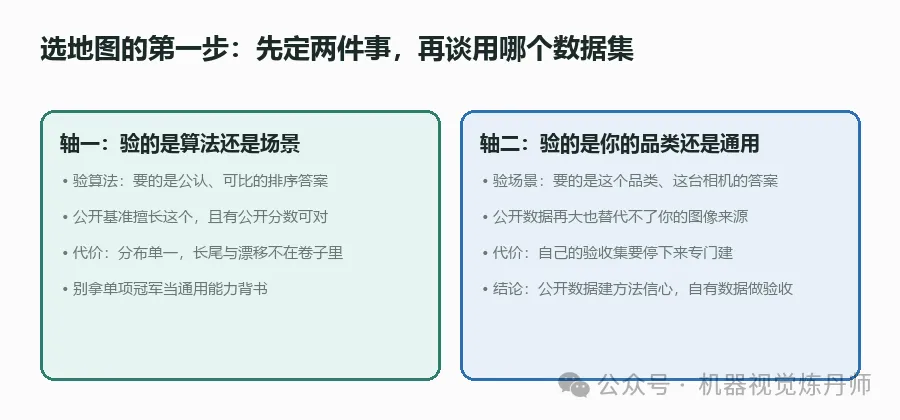
用任何公开数据集之前,先回答两个问题。第一,你验的是算法,还是场景?验算法,要的是公认、可复现、能横向比的排序答案——公开基准擅长这个,而且有公开分数可对;代价是分布单一,长尾和漂移不在卷子里。验场景,要的是"这个品类、这台相机、这条工艺"的答案——公开数据再多也替代不了你自己的图像来源;代价是验收集得自己停下来专门建。
第二,你验的是通用能力,还是你这个品类?公开基准测的是"方法在常见工业品上行不行",不是"方法在你这件东西上行不行"。两条轴一划,用法就清楚了:公开数据建方法信心,自有数据做验收——加起来才是一次完整选型。两头都省的走法也各有两种,都不行:只跑公开榜就签验收,等于拿铅笔当尺子用;反过来骂"公开榜都是学术玩具"、完全不跑公开评测,则连方法靠不靠谱的第一道筛都没有,是另一种裸奔。
二、一张地图的说明书:七个字段
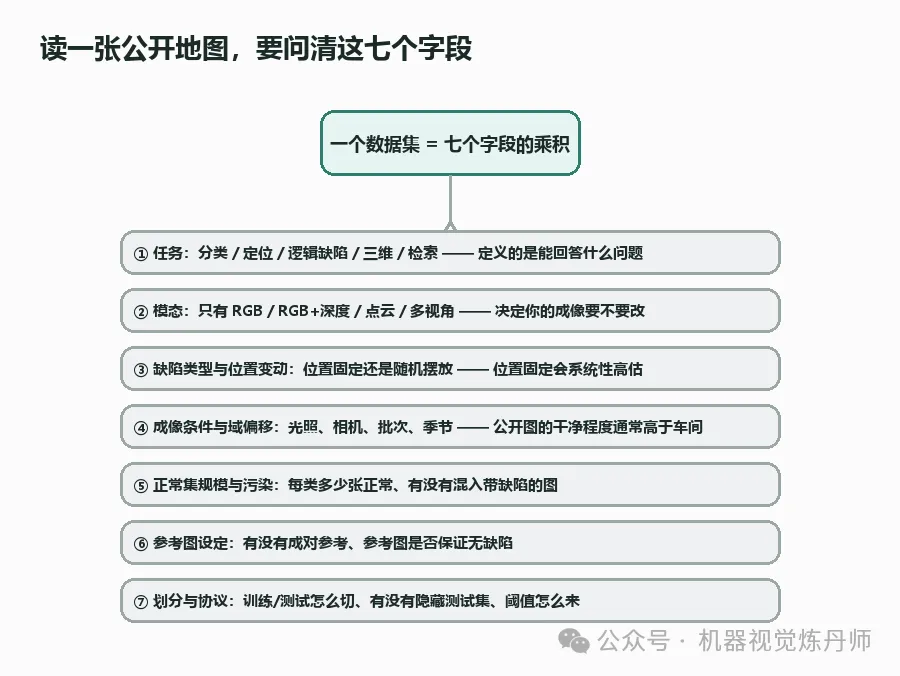
拿到任何公开数据集,别先看榜单,先读说明书。一张地图的可信范围,由七个字段共同决定:
① 任务。分类、定位、逻辑缺陷、三维,定义的是"能回答什么问题"。图级分数答不了"在哪",定位分数答不了"装没装错"。② 模态。只有 RGB,还是 RGB+深度、点云、多视角——决定你的成像要不要跟着改。③ 缺陷类型与位置变动。类型可枚举吗?位置固定还是随机摆放?位置固定的缺陷找起来容易,会系统性高估。④ 成像条件与域偏移。光照、相机、批次、季节——公开图的"干净程度"通常高于车间。⑤ 正常集规模与污染。每类多少张正常图,里面有没有混进带缺陷的。⑥ 参考图设定。有没有成对参考、参考图是否保证无缺陷——这决定复现成本。⑦ 划分与协议。训练测试怎么切、有没有隐藏测试集、阈值从哪来。
七个字段里任何一个和你的场景差得太远,榜上的数字就只是别人的成绩单——跟你无关,也不必自卑。
三、字段怎么救命:三份新公开工作当示范
这套读法不用背,拿本周三份公开工作走一遍就会了(数字均为原来源自报,我们未复现)。
先看字段⑤③怎么用。10 月初发布的 VAND 4.0 挑战赛技术报告,把评测直接建在两个部署场景上:工业制造与零售物流,测试集隐藏、算力当一等指标。结果很说明问题:工业赛道常规设定下,最好的无监督异常分割只拿到约 57% 的像素级 SegF1,零样本方法还要再落后约 15 个点;零售赛道上常见缺陷的监督检测已接近饱和,稀有缺陷却整体崩塌——稀疏泄漏类约 53 AP、缺件类约 27 AP,作者把上限直接归因于数据可用性。读说明书读出来的是:缺陷类型可枚举、每类都有样本时,监督方法是条大路;缺陷稀有可能性无限时,无监督当保险单,别当精度王来吹。
再看字段②。10 月 7 日一篇多模态工作(GRC-Net)的出发点就写在摘要里:纯图像方法能抓外观缺陷,结构性、几何性异常抓不好;而只看局部 patch 的重建,正常区都不稳定。它在 MVTec 3D-AD 等两个公开三维基准上自报全面领先。你的读法:缺陷如果是"不平、不在、变形"这类几何问题,深度相机是地形图,不是奢侈品;缺陷全在表面颜色纹理里,RGB 就够,别为用不上的模态买单。
最后看字段⑦。隔壁医学影像领域 10 月初有一篇评测协议研究(MIRTO),专门查"评测流程本身怎么影响分数":把一张存储的异常图读回内存时,轴序约定错了一次,体素级 AUROC 从自报的 0.873 掉到 0.583——而切片级分数几乎不动,也就是说最常用的汇总指标对这种事故几乎免疫;同一研究还复核出"验证集上显著的 Dice 优势,在同等实际假阳性负担下消失"的阈值迁移现象,并让同一批对比跑过一万五千多条合理评测路径,结论是排名随协议选择重排。教训不分行业:评测流程要当代码管——进版本库、可重跑、改动走变更单。
一句收拢:这三条结论,没有一条需要你自己跑实验才能得出——读说明书就能得出。
四、一页速查表
用法:把这张表贴在验收方案第一页,逐字段打勾——每个勾都对应一个"和你场景的差距",差距大的字段,就是你验收集要补的地方。
五、地图管不到的部分
照例把丑话说在前头:本文不引用任何我们自己的实验数字;上文所有数字均为原来源自报、我们未复现,且各家协议不同,互相之间不可横比。还有三层局限地图本身解决不了:公开基准覆盖的品类有限,你产线上的东西多半不在任何一张图上;地图会过时,基准在进化,几年前的"卷子"今天已有更难的替代版;最关键的图常常不公开——各家真正用于验收的产线数据集,几乎都在保密协议后面。所以这篇给的是读图方法,不是任何一张具体的图。
最后
公开数据集的价值,不是替你证明模型能上线,而是替你省掉从零验证方法的成本——它把"这个思路有没有戏"的验证周期从几周压到几小时,这是地图的意义。至于"我这件产品到底能不能检",那张图不在任何公开数据集里,得你自己画。下次选型会上再听到"我们在某某数据集上分数很高",先别鼓掌,把那七个字段问一遍;问完还稳的,才轮到你的验收集上场。
公开数据集是地图不是地皮:公开数据建方法信心,自有数据做验收,两头都不能省。选图先划两条轴(验算法还是验场景、验通用还是验你的品类),再读七个字段——任务、模态、类型与位置、成像条件、正常集规模与污染、参考图设定、划分与协议。字段和你场景的差距,就是验收集要补的洞;评测流程当代码管,别让一次轴序错误吞掉二十九个点。觉得有用?点个 在看 / 转发 / 收藏,把速查表存下来当选型清单。这一卷正在把"评测与验收"的坑挨个踩完:指标、阈值、口径之后是数据集,都只讲能落地的判断。下一篇:《可复现性:让别人能复算你的数字》——你报了分的那个实验,别人按你写的步骤跑,能不能得到同一个数?复现是工程界的礼貌,更是防自欺的保险。参考(仅转述思想,数字均为原来源自报,我们未复现):Detecting Defects that Matter(VAND 4.0 Challenge 技术报告,arXiv:2610.04392,2026-10);GRC-Net: Global Representation Consistency Network for Unsupervised Multimodal Anomaly Detection(arXiv:2610.09329,2026-10);MIRTO: a registration-gated, multiverse-tested evaluation protocol for unsupervised anomaly segmentation(arXiv:2610.02136,2026-10,脑 MRI 方向,教训取方法学层面)。MVTec 3D-AD 等公开基准仅作名称的描述性引用,未使用任何数据集图片。两张插图均为自绘示意;不引用任何我们自己的实验数字;观点仅代表作者,与任何厂商无关。