做离线项目,卡住落地的常常不是模型不够聪明,是那台机器压根跑不动。
客户机房不许出网,产线工控机没有稳定网络,出差路上要在飞机上看一份合同。这几种情况下云 API 都用不了,数据也不许离开设备。
早两年碰上这种需求,基本只能砍掉,或者硬把 7B 模型塞进笔记本。后者的下场通常是风扇一直转,上下文稍微长一点就爆内存。
2B 这一档真正能用了,是 2025 到 2026 的事。光跑得起来早就不算本事,这几款开始能调工具、读长文档,接进生产流程不至于掉链子。
下面把五款国产型号放在一起对照。能干什么、跑不动什么、命令怎么抄,都写在里面。数字来自各家官方模型卡,口径和日期放在文末。
三件事赶在同一时间成熟,少一件都跑不通。
蒸馏先解决了推理能力。DeepSeek-R1 拿 80 万条推理链样本,把思维链灌进 1.5B 的 Qwen 基座,说明「推理范式」可以脱离参数规模单独迁移。
量化从 PTQ 走到 QAT。训练后量化降到 4bit 基本无损,再往下到 2bit 精度就崩;量化感知训练让模型在训练阶段适应低比特误差,1.8B 的模型才压得进 600MB 内存。
再就是软件栈齐了。GGUF、MLX、GPTQ 首发就给,Ollama、llama.cpp、vLLM、SGLang 直接加载;NPU 那边靠混合量化和投机解码把解码速度推到每秒 60 token 以上。架构标准、格式齐全,意味着不用为某一个模型单独改推理内核。
所以现在要纠结的,已经从「算力够不够」变成「这台设备该配哪款」。
五款,一款一款看
Qwen3.5-2B:能看图,也挑框架
阿里 2026 年初开源。约 2B 的 dense,24 层,Gated DeltaNet 线性注意力与 Gated Attention 按 3:1 交替;带原生视觉编码器,文本、图像、视频做早期融合;原生 262,144 token 上下文,思考与非思考双模式(默认非思考),201 种语言,Apache 2.0。模型卡上写的是 OCRBench 84.5、MMMU 64.2。
GGUF Q4_K_M 约 1.3–1.8GB,MLX 4bit、Ollama、llama.cpp、vLLM、SGLang 都有对应格式。
ollama run hf.co/unsloth/Qwen3.5-2B-GGUF:Q4_K_M
离线票据、截图理解、图表问答、一次读完一整份长材料,交给它比较合适。麻烦也在这儿:混合注意力加视觉编码器是新架构,旧版 llama.cpp / Ollama 可能压根不认识,部署前先查框架版本;图像预处理还要额外吃内存。另外 262K 是上限,日常别按这个数规划容量。
MiniCPM5-2B:长文档和工具调用
面壁智能联合清华 OpenBMB 在 2026 年 9 月 7 日开源。参数 2,516,756,480(去掉嵌入约 19.8 亿),标准 LlamaForCausalLM,42 层,GQA 16 个 Q 头 / 2 个 KV 头,131,072 上下文,Apache 2.0。首发把 BF16、GGUF、MLX、GPTQ、LiteRT 和 DSpark 草稿模型一次给齐,连 UltraData 训练数据、RL 框架和训练配方都开放了,FlagOS 首日适配 9 款芯片。
官方自选 34 项基准平均 53.9,对比集里 Qwen3.5-4B 是 51.1;分项 LiveCodeBench v6 为 69.1、SWE-bench Verified 为 46.4、BFCL v4 为 66.6、τ²-Bench Telecom 为 97.1。第三方 Artificial Analysis 的评测里,4B 以下开源权重模型中它也表现突出。量化后 Q4_K_M 约 1.56GB、Q8_0 约 2.68GB、F16 约 5.04GB。
ollama run hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M# 起长文档服务,顺手把 KV cache 也量化掉llama-server -hf openbmb/MiniCPM5-2B-GGUF:Q4_K_M -c 32768 -ctk q8_0 -ctv q8_0 --port 8080
本地 Agent、工具调用、长文档 RAG、离线代码助手,它是这几款里比较顺手的一个。但 MMLU-Pro 只有 70.8(更大模型是 78.0),世界知识得靠 RAG 补。想跑满 131K 必须开 KV cache 量化,日常设 8K–32K 更舒服。还有一点:官方分数来自自选对比集,换一套基准,排名未必还是这个样子。
混元 HY-1.8B-2Bit:600MB 的代价
腾讯 2026 年 2 月 9 日开源,基于 Hunyuan-1.8B-Instruct 做 2bit 量化感知训练,用「弹性拉伸量化」SEQ 缓解极低比特下有效能级受限的问题。等效参数约 0.3B,模型文件约 300MB,运行内存约 600MB。
官方给的口径:8 个主流数据集上平均比全精度教师模型下降 3.97%,跟 INT4 PTQ 版本只差 0.13%,整体超过同体积的全精度 0.5B 模型。思维链完整继承,还有 Dual-CoT 快慢思考,简单问题走短链,复杂问题走长链,加 /no_think 前缀可以强制快答。MacBook M4 上首字时延相对 FP16 / Q4 有 3–8 倍加速,生成速度稳定提升 2 倍以上。
代价藏在部署条件里。目前只支持带 Arm SME2 指令的设备,Apple M4、天玑 9500、vivo X300 这些可以,M1 / M2 / M3 不行;要从 llama.cpp 的 SME2 分支编译并开 KleidiAI,运行时设 GGML_KLEIDIAI_SME=1。协议是 AngelSlim,不是 Apache / MIT,商用条款和地域限制得逐条看。
git fetch origin pull/19357/head:pr-19357-sme2-int2git checkout pr-19357-sme2-int2cmake -DGGML_CPU_KLEIDIAI=ON -DGGML_METAL=OFF -DGGML_BLAS=OFF ..export GGML_KLEIDIAI_SME=1
手机、耳机、智能家居这类内存卡得很死的离线助手,它是目前少有的选择。普通 x86 PC 想「拉个 GGUF 一键跑」就别试了,2bit 不是通用量化格式,它跟指令集和推理内核绑在一起。
DeepSeek-R1-Distill-Qwen-1.5B:会解题,别让它写代码
2025 年 1 月发布,Qwen2.5 系列基座,用 80 万条 R1 精选样本微调,MIT 协议(基座 Apache 2.0)。官方评测:AIME 2024 pass@1 为 28.9、cons@64 为 52.7、MATH-500 为 83.9、GPQA Diamond 为 33.8、LiveCodeBench 为 16.9、Codeforces rating 954。BF16 约 3GB,Q4_K_M 约 1.2GB,纯 CPU 也跑得动。
ollama run deepseek-r1:1.5b
这个模型的使用建议比参数更影响结果。temperature 设 0.5–0.7(官方推荐 0.6);别加 system prompt,指令全放 user 消息里;数学题要求逐步推理、答案放进 \boxed{};强制输出以换行开头,不然它会跳过思考直接吐一段空思考;评测要多次采样取平均。
离线解数学题、讲题、批量造思维链数据,它够用。LiveCodeBench 只有 16.9,别拿去写业务代码;知识问答和稳定 JSON 结构化输出也不合适。思维链还会明显拉长延迟和 token 消耗。
GLM-Edge-1.5B-Chat / V-2B:有 NPU 才谈得上快
智谱 2024 年 11 月发布。1.5B 对话和 2B 视觉理解面向手机、车机,4B / 5B 面向 PC;全系列给 GGUF,transformers、vLLM、OpenVINO 都能接。
官方 2024 年 11 月 28 日披露的实测:骁龙 8 Elite NPU 上 INT4 混合量化,1.5B-Chat 首字 260ms、65 tok/s、峰值内存 1.2GB;Intel LNL 288V 上 OpenVINO 是 228ms、63 tok/s、2.3GB;V-2B 理解一张 672×672 的图为 70 tok/s、3.4GB,每张图还得算约 1.7s 预处理和约 2GB 额外内存。叠加投机采样后,官方口径能到 100 tok/s 以上峰值。
能调用厂商 NPU 推理方案、又要图像理解的产品化端侧场景,可以走这条路线。但这些数字绑着具体硬件和量化方案,换平台必须重测。系列发布得早,通用能力跟 2026 年这一批 2B 比有差距。
放一张对照表
| | | | |
|---|
| | | | |
| | | | |
| | | | |
| | | | |
| GLM-Edge-1.5B-Chat / V-2B | | | | |
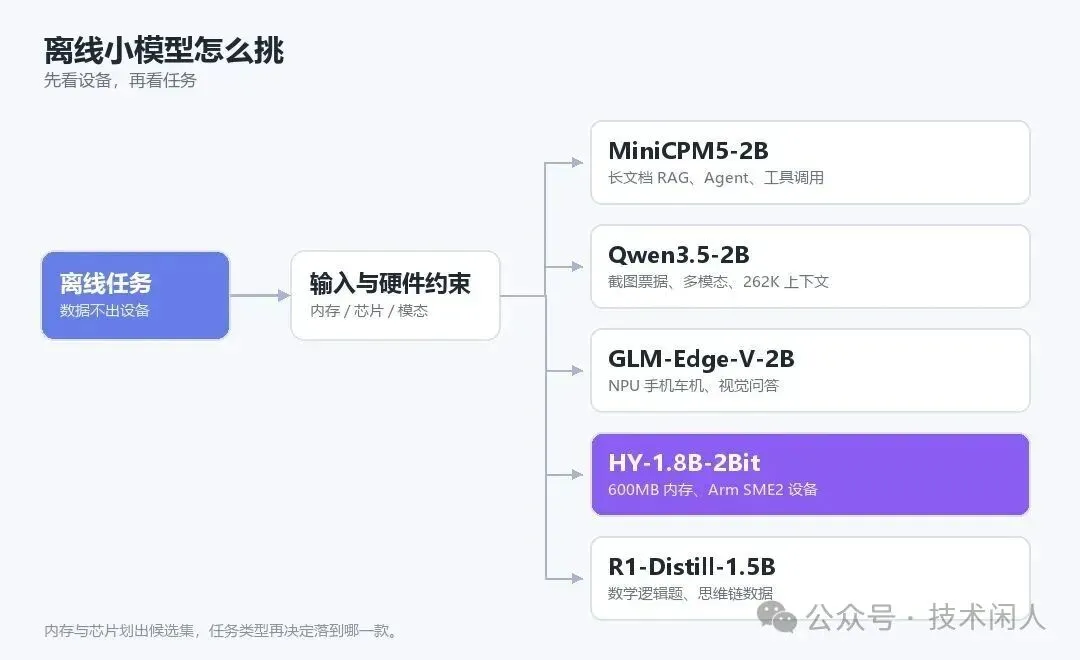
顺序别搞反
先看设备能跑什么,再看任务要什么。
先定约束,再定任务,再挑模型。顺序反了,参数再漂亮也跑不动。
这张图得倒着看:内存和芯片先划出候选集,任务类型才决定落到哪一款。拿普通 x86 笔记本去试 2Bit 混元,或者让 1.5B 蒸馏模型写业务代码,都是把顺序弄反了。
三段能直接抄的代码
内网文档问答
把上面那条 llama-server 起起来,业务侧用 OpenAI 兼容接口接:
from openai import OpenAIclient = OpenAI(base_url="http://127.0.0.1:8080/v1", api_key="local")resp = client.chat.completions.create( model="MiniCPM5-2B", messages=[ {"role": "user", "content": "只根据下面的片段回答问题,找不到就答未提及。\n片段:...\n问题:付款节点是几天?"} ], temperature=0.2,)print(resp.choices[0].message.content)
模型、分词器、嵌入模型、向量库都得预置在内网。提示词里写死「找不到就答未提及」,日志和 KV cache 一起纳入脱敏和清理,本地端口只绑 127.0.0.1。这几处偷懒,离线就只剩口头上的离线。
离线票据与截图理解
图片转 base64 喂给本地多模态端点,要求固定字段的 JSON,再用代码做一次 schema 校验:
import base64, jsonfrom openai import OpenAIclient = OpenAI(base_url="http://127.0.0.1:11434/v1", api_key="local")img = base64.b64encode(open("invoice.png", "rb").read()).decode()resp = client.chat.completions.create( model="qwen3.5-2b", messages=[{"role": "user", "content": [ {"type": "text", "text": "提取金额、日期、开票方,只输出 JSON"}, {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}}, ]}],)data = json.loads(resp.choices[0].message.content)assert {"amount", "date", "seller"} <= data.keys()
图像 token 会额外占上下文,视觉编码器常驻内存也得算进容量规划。小模型输出 JSON 不稳,校验和失败重试别省。
手机端 600MB 助手
按 SME2 分支编译 llama.cpp,运行时开 GGML_KLEIDIAI_SME=1,简单指令加 /no_think 前缀走短链,把首字时延压下来。产品侧记得留降级:检测到设备不支持 SME2 就自动切回 Q4 量化的 1.5B 文本模型,别直接弹报错。
几个容易翻车的地方
几条常踩的:权重体积不等于运行内存,上下文长度是上限,离线也不等于自动合规。
- 1. 容量要按运行内存算,别只盯着权重文件。KV cache、运行时开销、视觉编码器、图像预处理都得加进去,长上下文常常就是压垮设备的那一下。
- 2. 131K / 262K 是上限。真要跑满得开
-ctk / -ctv 量化,日常 8K–32K 更稳。 - 3. 2bit 要 SME2,NPU 高吞吐要 INT4 混合量化加厂商推理库。先确认目标芯片,再选模型。
- 4. 新架构先查推理框架版本。Gated DeltaNet 混合层、原生视觉编码器,旧版 llama.cpp / Ollama 都可能加载失败。
- 5. 推理型小模型得哄着用:temperature 设对、去掉 system prompt、强制思考开头,还得接受多次采样带来的延迟。「会思考」跟「答得对」是两回事。
- 6. 厂商自测和第三方评测分开看,自选对比集的平均分当参考就行,拿自己的业务样本做回归更有意义。协议也别顺手当 MIT 用,AngelSlim 这类自定义许可含额外条款和地域限制,上线前过一遍法务。
- 7. 离线不等于自动合规。模型文件、对话日志、工具权限、本地端口、缓存清理都要收口,否则「数据不出设备」只是句口号。
写下来才发现,这五款彼此不太构成竞争。Qwen3.5-2B 管多模态和长文档,MiniCPM5-2B 管 Agent 和工具调用,HY-1.8B-2Bit 管内存卡死的设备,R1-Distill-1.5B 管推理链,GLM-Edge 管 NPU 上的吞吐和视觉理解。
设备条件先摆出来,真正可选的往往就剩一两款。
文末一屏,懒人版
- • 长文档 RAG 或本地 Agent → MiniCPM5-2B,Q4 约 1.56GB,记得开 KV cache 量化。
- • 看截图、认票据 → Qwen3.5-2B,262K 上下文,先确认推理框架版本。
- • 设备只有几百 MB → HY-1.8B-2Bit,先查芯片支不支持 Arm SME2。
- • 离线解数学题 → R1-Distill-Qwen-1.5B,temperature 0.6,别加 system prompt。
- • 手机车机有 NPU 又要看图 → GLM-Edge-V-2B,性能数字绑硬件,重测一遍。
对照表和这张速查卡,可以直接拿去做团队内部的选型底稿。
数据口径:规格与分数取自各家官方模型卡、GitHub README 及厂商公开资料。GLM-Edge 性能为官方 2024-11-28 披露的特定平台实测值,MiniCPM5-2B 基准来自官方自选对比集,HY-1.8B-2Bit 的部署限制以官方仓库为准。文中命令是通用示例,模型 tag、分支与参数请以官方仓库当前版本为准。