渗透测试的真实开销,很少体现在工具调用本身。一次完整的评估里,更耗时间的是判断:目标暴露了什么、下一步该验证什么、哪条路径值得推进;以及记录:漏洞在哪个端口、用什么载荷、复现条件是什么。工具负责执行,人要负责串起这些判断——这正是自动化长期停在外围的原因。PentAGI 的野心,是把“判断—执行—留痕”这段流程交给一个自主 Agent。本文基于其公开仓库与官方文档,围绕四个问题展开:它要解决什么、用什么架构实现、哪几处工程实现值得看、以及哪些期待应当放下。
01 结论先行
02 项目与定位
PentAGI(Penetration testing Artificial General Intelligence)于 2025 年 1 月开源,主要语言是 Go,采用微服务架构,许可证为 MIT,开发方为迪拜的 VXControl。目前的社区数据是 3.2 万 Star、5000 余 Fork、57 个未解决 Issue。
对社区数据需要保持基本审慎:Star 数量本身说明不了质量。可以交叉验证的是 Issue 存量与提交频率——两者大致相称,说明项目处于有人维护的状态,而非刷量产物。技术选型层面,用 Go 实现安全工具是务实的选择:静态编译、交叉构建方便,交付时无需为用户准备解释器环境。
使用时以自然语言描述范围与目标,任务规划由系统自行完成。需要提前明确的是:真实环境的执行结果与宣传效果存在差距,具体约束在后文列出。
03 架构:五层结构与多 Agent 分工
PentAGI 将一次渗透拆为五层:Flow(任务流)→ Task(任务)→ SubTask(子任务)→ Action(动作)→ Artifact / Memory(产物与记忆)。编排层 Orchestrator 负责拆分任务,交由三个专职 Agent 执行——Researcher 负责侦察、Developer 负责构造、Executor 负责落地,每个 Action 都会留下可追溯的产物和带向量嵌入的记忆记录。
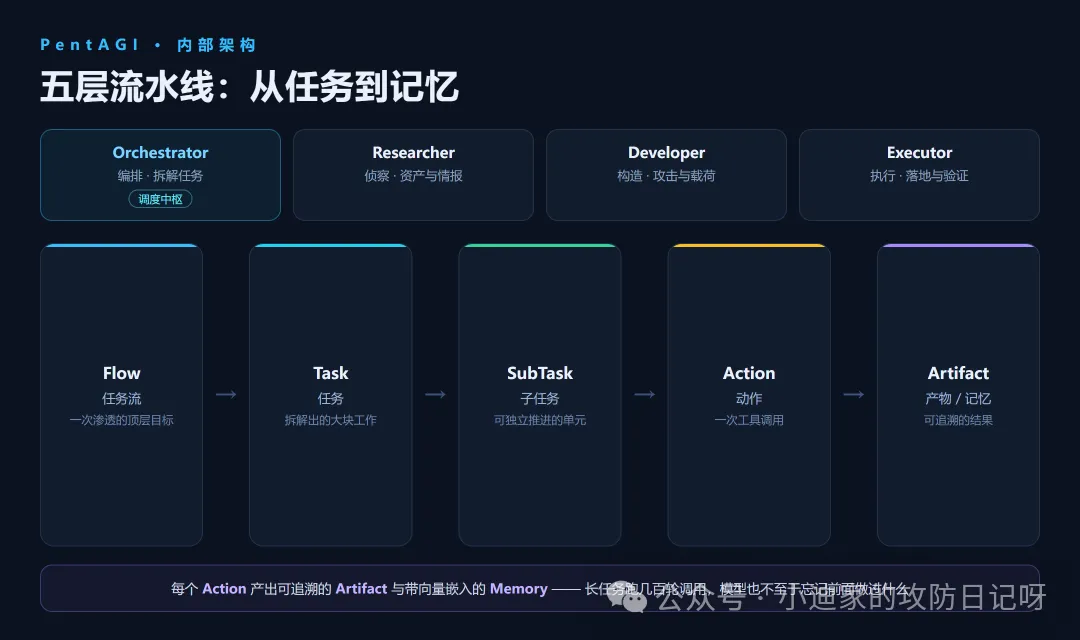
PentAGI 内部五层流水线与多 Agent 分工
分层在短任务里显得多余,在长任务里则是刚需。自主渗透一次运行往往涉及数百次工具调用,模型对早期步骤的记忆会随窗口滚动而衰减。有没有可追溯的中间产物,直接决定长任务能否收敛。
04 三处值得关注的工程实现
其一,对话链的结构化压缩。上下文膨胀是长任务最先暴露的问题。PentAGI 将对话历史转为 ChainAST 结构,保留完整的工具调用与响应配对,再叠加分节摘要、超长 body pair 压缩和 QA 摘要三层处理。实现上有一个细节值得记录:只有当压缩后的新链确实短于原链时,才会执行替换——这是遇到过“越压越长”问题的团队才会写出的判断。相关阈值均通过环境变量暴露,例如 SUMMARIZER_LAST_SEC_BYTES=51200、SUMMARIZER_MAX_QA_SECTIONS=10、ASSISTANT_SUMMARIZER_KEEP_QA_SECTIONS=3。
其二,面向过程的行为监督。自主 Agent 最常见的失效形态不是报错,而是原地空转:同一条命令反复执行,流程看似在推进。PentAGI 设置了两道机制。EXECUTION_MONITOR_ENABLED 规定:同一工具调用超过 5 次或总调用超过 10 次后,唤醒 Adviser 评估当前路径是否偏离子任务,并给出替代方案。AGENT_PLANNING_STEP_ENABLED 则要求每步执行前先产出计划,标注关键动作、风险点与验证方式。对参数量较小的本地模型(Qwen 类,运行于 Ollama 或 vLLM),这两项机制的收益尤为明显——这类模型的知识储备够用,欠缺的是执行前停顿评估的习惯。
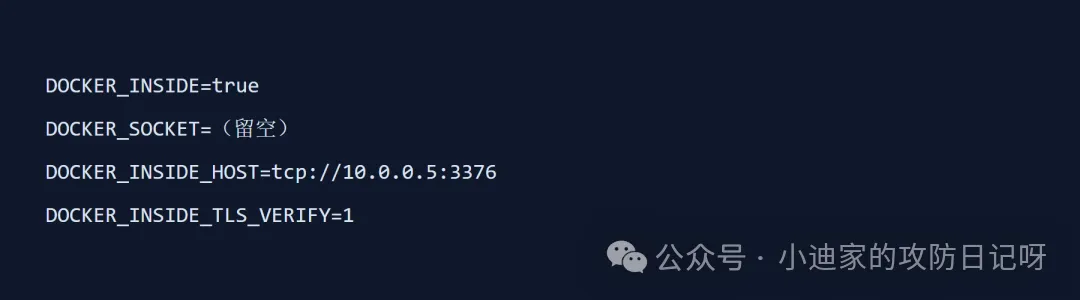
其三,隔离策略的取舍。全部操作运行于 Docker 沙箱,内置 20 余种工具(nmap、Metasploit、sqlmap 等),并依任务类型选择镜像。这里有一个反常规的决定:官方明确反对将宿主的 docker.sock 挂载进沙箱,转而推荐两节点部署配合 dind over TLS。
文档给出的理由相当直接:挂载宿主 socket 意味着将 root 权限交给一个自主 Agent,它具备启动特权容器、挂载根目录、控制整台主机的能力。多数安全产品在文档里只写推荐配置,回避错误配置的后果;这个项目选择把风险写明,这一点值得肯定。
05 记忆与可观测性
长期记忆基于 PostgreSQL 与 pgvector 实现;可选用 Graphiti 配合 Neo4j 建立实体关系图,跟踪主机、服务与漏洞之间的时序关联。默认配置 GRAPHITI_SEARCH_SCOPE=flowid,按 flow 做数据隔离,避免不同项目之间互相污染。
可观测性组件的完整度超出同类项目:OpenTelemetry 负责采集,VictoriaMetrics 存储指标,Jaeger 追踪调用链,Loki 归集日志,Grafana 呈现看板,另有 Langfuse、ClickHouse、Redis、MinIO 支撑 LLM 全链路分析。这套组合的治理能力接近企业级平台,代价同样明确:部署与维护这些组件本身的成本,可能超过 Agent 带来的效率提升,中小团队需要权衡。
06 与既有方案的定位差异
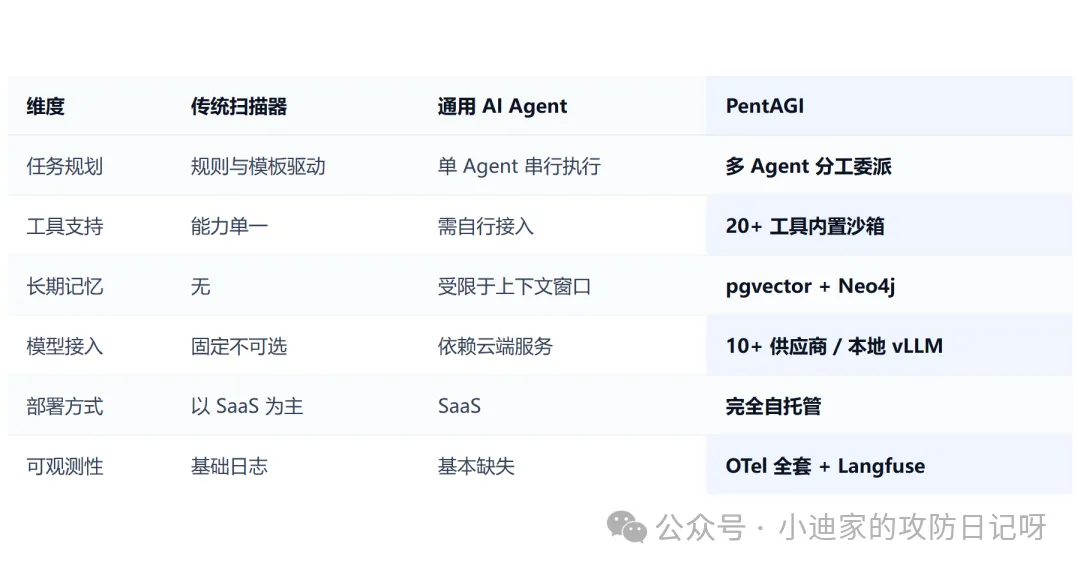
传统扫描器、通用 AI Agent 与 PentAGI 的定位对比
需要说明的是:扫描器输出的是事实清单——存在哪些服务、版本、配置缺陷;PentAGI 试图输出判断链路——先验证什么、如何验证、结果说明了什么。这个差异能否成立,取决于所选模型的能力水平:模型能力不足时,输出的仅是格式完整的推测,不具备参考价值。
07 上线前必须明确的六项约束
1.授权范围:仅限自有资产或已获书面授权的目标。项目 EULA 对此有明确要求,无讨论空间。
2.镜像白名单:通过 DOCKER_ALLOWED_IMAGES 限定可用镜像;模型能力较弱时容易选错运行环境,可进一步设置 DOCKER_IMAGE_SELECTION_MODE=fixed 强制固定。
3.回调端口收敛:每个 flow 占用 28000–29999 区间的回调端口,需在防火墙或 DOCKER-USER 链上做访问控制,避免扫描流量误伤自有资产。
4.多实例隔离:共享 DB、Worker 或 Neo4j 部署时,必须配置 TENANT_ID,用于 schema、容器命名空间与 Cookie 密钥的隔离。
5.上线自检:先用 ctester 验证模型的工具调用能力,再用 etester test 检查 embedding 配置。流程卡死多数源于 embedding 配置错误,而非模型能力问题。
6.成本结构:长任务的计算开销上升较快。合理做法是侦察阶段用小模型、规划阶段用大模型,整体成本显著低于全流程使用大模型,效果差距有限。
08 部署
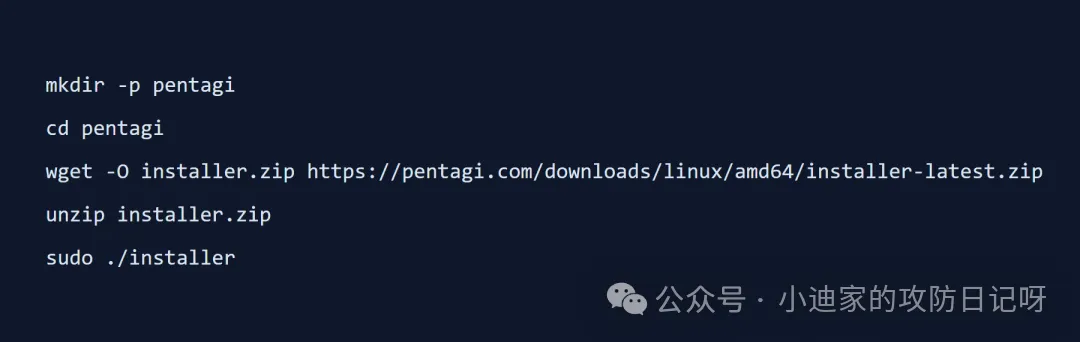
安装器为交互式,依次完成环境检查、LLM 供应商配置、搜索引擎配置与安全加固,最后通过 docker compose 启动全栈。访问地址 https://localhost:8443,默认凭据为 admin@pentagi.com / admin,首次登录应立即修改。
09 适用边界与判断
从工程角度看,PentAGI 的可取之处在于把四项基础能力做成了默认项:上下文治理、执行监督、隔离边界、可观测性。单独实现任何一项都不困难,难的是形成完整、可配置、开箱可用的组合。
落地建议:已有成熟手工流程的团队,不将其作为替代方案;更稳妥的路径是先纳入侦察与报告整理两个环节,验证效果后再扩大到 CI/CD 门禁等场景。至于“行业洗牌”之类的判断,需要更长的时间窗口来验证——工具的长期存活率,从来与 Star 数无关。
本文基于公开资料整理,仅用于技术研究与学习,请勿对未授权目标使用。
